*Source image : justgrims, https://www.flickr.com/photos/notbrucelee/8016192302 *
Note
Roadmap :
- Des exercices.
- Les extensions à la fin.
Sources
- Algorithms Robert Sedgewick, Kevin Wayne
- Éléments d'algorithmique D. Beauquier, J. Berstel, Ph. Chrétienne
- 125 Problems in Text Algorithms with Solutions Maxime Crochemore, Thierry Lecroq, Wojciech Rytter
Recherche dans un texte
Principe de la recherche
On s'intéresse ici au problème suivant :
Problème : RechercheTexte
-
Entrées :
- une chaîne de caractères \(s\) sur l'alphabet \(\Sigma\)
- une autre chaîne de caractères \(m\) sur ce même alphabet, appelée motif, de longueur plus petite que celle de \(s\)
-
Sortie : un résultat partiel correspondant à l'indice de la première occurrence du motif dans la chaîne s'il est présent.
La différence fondamentale entre ce problème et celui de la recherche d'un sous-tableau dans un tableau est le fait qu'on considère un alphabet fini et dont le nombre d'éléments est le plus souvent négligeable par rapport à la taille des chaînes de caractères. Cela permet d'effectuer des optimisations qui ne sont pas sans rappeler les tris linéaires comme le tri par comptage.
On parle alors d'algorithmique du texte pour désigner des algorithmes tirant partie de cette contrainte sur les données. La plupart des algorithmes que l'on présente peuvent ainsi s'adapter aisément au cas de tableaux dont les éléments sont pris dans un ensemble fini de petit cardinal.
Avant d'entamer ce chapitre, remarquons qu'il existe, outre l'alphabet usuel, trois alphabets très importants :
- celui des caractères ASCII usuels
- celui contenant les deux éléments 0 et 1, ce qui permet de travailler sur des recherche en binaire.
- et enfin, très important pour la biologie, l'alphabet à quatre lettres A, T, G et C correspondant aux bases d'un brin d'ADN et qui ouvre la porte à beaucoup d'applications en bio-informatique.
Note
Il y aura sûrement des applications bio-info dans la partie programmation dynamique, faire le lien ici.
Algorithme naïf en force brute
Une solution naïve consiste à parcourir chaque position de \(s\) afin de tester si le motif est présent à partir de cette position.
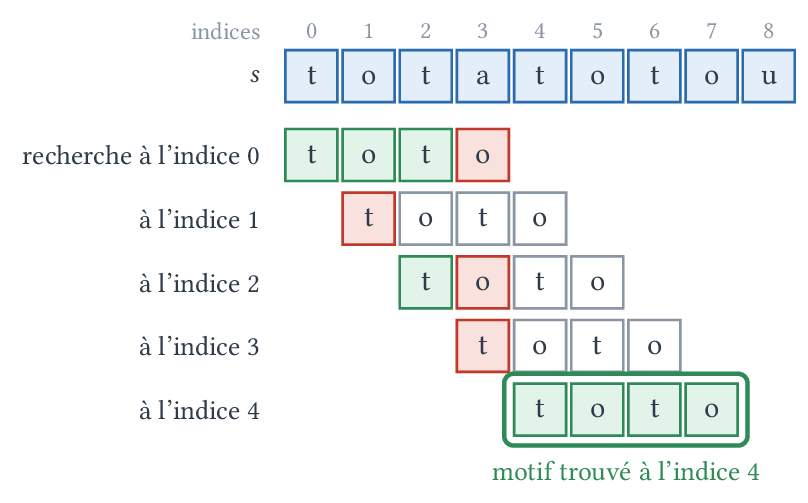
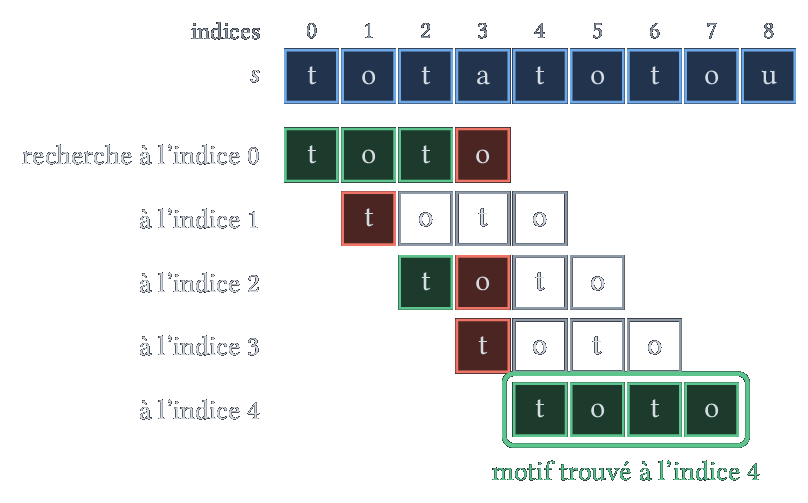
Cela donne l'implémentation assez directe suivante :
exception Trouve of int
exception PasDeMotif

(* renvoie un booléen indiquant si m est présent
 * dans s à l'indice i *)
let cherche_motif (m:string) (s:string) (i:int) : bool =
    let p = String.length m in
    try
        for j = 0 to p-1 do
            if s.[i+j] <> m.[j]
            then raise PasDeMotif
        done;
        true
    with PasDeMotif -> false

let recherche_naive m s =
    let n = String.length s in
    let p = String.length m in
    try
        for i = 0 to n-p do
            if cherche_motif m s i
            then raise (Trouve i)
        done;
        None
    with Trouve i -> Some i
/* recherche_naive(m,s) recherche le motif m dans la chaine
 * s et renvoie l'indice de la première occurrence s'il est présent
 * ou -1 sinon */
int recherche_naive(const char *m, const char *s)
{
    int n = strlen(s);
    int p = strlen(m);

    for (int i = 0; i <= n-p; i++)
    {
        int j;
        for (j = 0; j < p; j++)
        {
            if (s[i+j] != m[j])
                break;
        }
        if (j == p)
            return i;
    }

    return -1;
}
def recherche_naive(motif, chaine):
    '''Recherche le motif dans la chaine et renvoie l'indice de
    la première occurrence du motif s'il est présent ou None sinon.'''
    n, p = len(chaine), len(motif)
    for i in range(n-p+1):
        present = True
        for j in range(p):
            if chaine[i+j] != motif[j]:
                present = False
                break
        if present:
            return i
    return None
Remarque
Ces implémentations se comportent correctement dans les deux cas limites exclus par l'énoncé du problème : si \(p > n\), la boucle sur \(i\) est vide et le motif est déclaré absent ; si \(p = 0\), le motif vide est trouvé dès l'indice \(0\), ce qui est cohérent puisque le mot vide est préfixe de tout mot. Toutes les recherches de ce chapitre suivent cette même convention.
La complexité temporelle en pire cas de cet algorithme correspond au maximum de comparaisons. On peut naturellement en déduire par majoration une borne en \(O(np)\) mais on peut remarquer qu'il est assez difficile d'obtenir un exemple concret, ce qui fait penser que ce pire cas est rare.
Remarque
Considérons la chaîne \(s = a a ... a = a^n\) qui contient \(n\) fois la lettre \(a\) et le motif \(m = a^{p-1} b\) qui contient \(p-1\) a et finit par un \(b\). Dans l'algorithme, on va donc à chaque étape de la première boucle effectuer \(p\) itérations dans la seconde avant de se rendre compte que le motif n'est pas présent en comparant \(b\) et \(a\). On a donc exactement \((n-p+1)p\) comparaisons, ce qui est un \(\Theta(np)\) dès que \(p \le n/2\) par exemple, et on retombe ainsi sur la complexité \(O(np)\) pour ces exemples.
Ce qui va se passer dans une application usuelle de cet algorithme, c'est qu'au bout d'une ou deux comparaisons, on pourra invalider la position et passer à la suivante. On va alors avoir une complexité en \(O(n+p)\) en considérant en plus la validation du motif dans le cas où il est présent. Ici \(p \le n\) donc \(O(n+p) = O(n)\) mais c'est important de garder en tête cette complexité en \(O(n+p)\) qu'on retrouvera car elle s'appliquera à des algorithmes où on effectue un prétraitement sur le motif pour l'appliquer ensuite sur plusieurs chaînes.
Algorithme de Boyer-Moore
Dans un premier temps, on va présenter la variante usuelle de cet algorithme appelée algorithme de Boyer-Moore-Horspool. On présentera ensuite l'algorithme de Boyer-Moore en tant que tel.
Principe de Boyer-Moore-Horspool
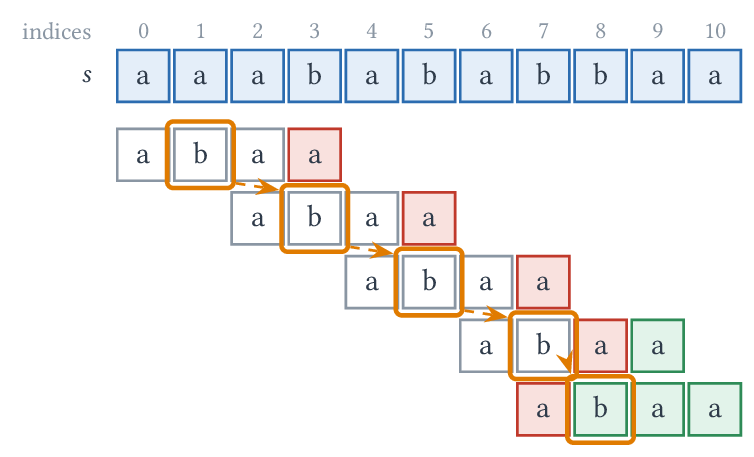
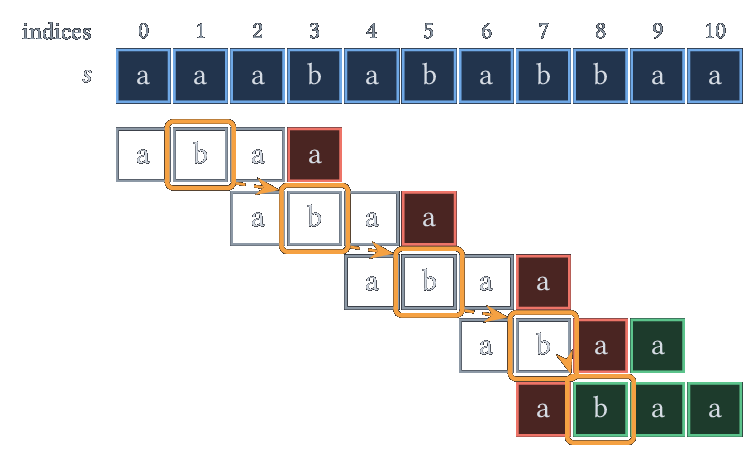
Le principe de l'algorithme de Boyer-Moore-Horspool est d'effectuer une recherche du motif comme précédemment mais en partant de la fin. On va alors tenter de trouver des suffixes de plus en plus grands du motif. Si on trouve ainsi le motif, on renvoie la position. Sinon, c'est qu'on a lu dans \(s\) un mot de la forme \(x m'\) où \(m'\) est un suffixe strict de \(m\) mais \(x m'\) n'en est pas un. Si \(x\) n'est pas présent dans \(m\), alors on peut relancer la recherche juste après \(x\) dans \(s\). Si \(x\) est présent dans \(m\), on peut relancer la recherche en alignant ce caractère avec sa position la plus à droite dans \(m\).
Remarque
Il faut tenir compte différemment du dernier caractère du motif, car il n'est pas utile de le réaligner. On considère alors, quand elle existe, l'occurrence précédente de ce caractère.
On obtient ainsi une stratégie de saut qui en cas d'échec relance la recherche plus loin.
Voici un premier exemple où on effectue une recherche de \(abaa\) dans le mot \(aaabababbaa\). Cette stratégie a permis d'éviter une recherche inutile à partir de l'indice 1.
Implémentation par table de saut
Pour réaliser ces sauts, on construit une table droite indexée par \(\Sigma\)
et telle que droite[c] indique l'indice de l'occurrence la plus à droite dans
le motif \(m\) du caractère \(c\), en ignorant le dernier caractère du motif.
Ainsi, dans l'exemple précédent du motif abaa, on obtient la table suivante :
c |
'a' | 'b' | 'c' | ... |
|---|---|---|---|---|
droite[c] |
2 | 1 | \(\emptyset\) | ... |
On a indiqué ici \(\emptyset\) quand un caractère de \(\Sigma\) n'est pas présent dans le motif, car il peut être présent dans \(s\).
Cette table contient donc de l'ordre de \(|\Sigma|\) éléments. On peut la réaliser par un tableau direct de taille \(|\Sigma|\) étant donné un ordre d'énumération. On peut aussi la réaliser par un dictionnaire, ce qui est plus économe en espace si le motif contient peu de lettres différentes. On a choisi ici, pour des raisons pédagogiques, de considérer la numérotation ASCII naturelle associée aux caractères pour indexer cette table.
let taille_alphabet = 256

let calcule_droite (motif:string) : int option array =
    (* Calcule le tableau droite associé au motif *)
    let droite = Array.make taille_alphabet None in
    let p = String.length motif in
    for i = 0 to p-2 do
        let j = p-2-i in
        let c = motif.[j] in
        if droite.(Char.code c) = None
        then droite.(Char.code c) <- Some j
    done;
    droite
int taille_alphabet = 256; // on pourrait passer par un define

/* Calcule le tableau droite associé au motif
 * le tableau renvoyé a été alloué, il devra être libéré après utilisation */
int *calcule_droite(char *motif)
{
    int *droite = malloc(sizeof(int) * taille_alphabet);
    int p = strlen(motif);

    memset(droite, -1, sizeof(int) * taille_alphabet);

    for (int i = 0; i <= p-2; i++)
    {
        int j = p-2-i;
        unsigned char c = motif[j];
        if (droite[c] < 0)
            droite[c] = j;
    }

    return droite;
}
taille_alphabet = 256
def calcule_droite(motif):
    '''Calcule le tableau droite associé au motif'''
    droite = [ None ] * taille_alphabet
    p = len(motif)
    for i in range(p-1):
        j = p-2-i # indice en partant de la fin
        c = motif[j]
        if droite[ord(c)] is None:
            droite[ord(c)] = j
    return droite
Afin d'implémenter l'algorithme lui-même, il est nécessaire de faire des
calculs élémentaires mais précis pour déterminer le saut à effectuer. Si à la
position \(i+j\) on a un échec après avoir lu le caractère c où droite[c]
contient la valeur \(k\) :
-
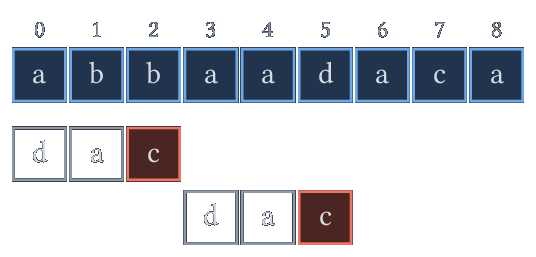
Si \(k = \emptyset\), c'est que le motif ne pourra jamais être trouvé tant que ce caractère
csera dans la zone comparée. On relance donc la recherche juste après, à l'indice \(i+j+1\).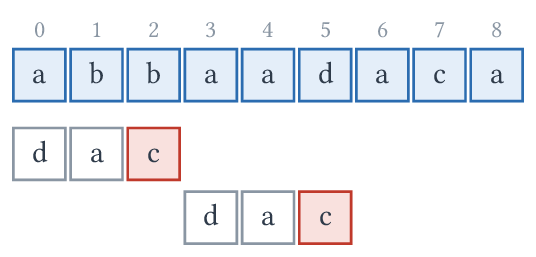
-
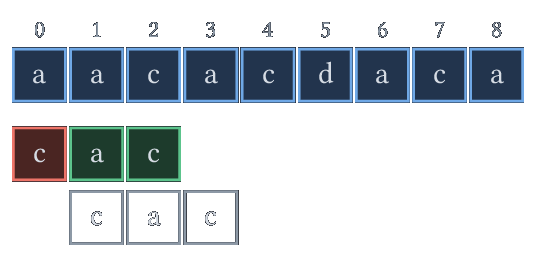
Si \(k \ge j\), cela signifie que
cest présent plus à droite dans le motif, donc aligner cette occurrence ne permettrait pas d'avancer la recherche. Rien ne nous permet de savoir sicest présent ou non ailleurs dans le motif, on relance alors prudemment la recherche en \(i+1\).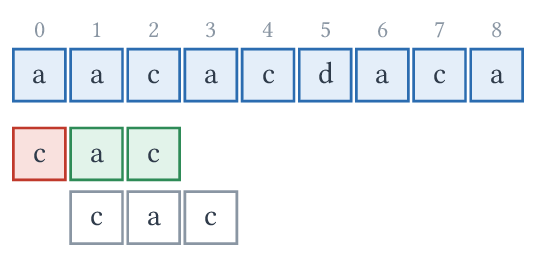
- Sinon, on veut aligner ce
cavec le caractère correspondant du motif, si on relance à l'indice \(i'\), on souhaite ainsi avoir \(i' + k = i + j\) donc \(i ' = i + j - k\).
exception Difference
exception Trouve of int

let recherche_BMH (motif:string) (droite:int option array)
    (chaine:string) : int option =
    let n = String.length chaine in
    let p = String.length motif in
    let i = ref 0 in
    try
        while !i <= n-p do
            try
                for j = p-1 downto 0 do
                    if chaine.[!i+j] <> motif.[j]
                    then begin
                        let dec =  match droite.(Char.code chaine.[!i+j]) with
                                | None -> j+1
                                | Some k when k < j -> j-k
                                | _ -> 1 in
                        i := !i + dec;
                        raise Difference
                    end
                done;
                raise (Trouve !i)
            with Difference -> ()
        done;
        None
    with Trouve k -> Some k
/* cherche motif dans chaine en utilisant la table de saut précalculée
 * droite. Renvoie l'indice de la première occurrence ou -1 s'il n'est pas
 * présent */
int recherche_BMH(char *motif, int *droite, char *chaine)
{
    int n = strlen(chaine);
    int p = strlen(motif);

    for(int i = 0; i <= n-p; )
    {
        bool present = true;
        for (int j = p-1; j >= 0; j--)
        {
            if (chaine[i+j] != motif[j])
            {
                int k = droite[(unsigned char) chaine[i+j]];
                present = false;
                if (k < 0)
                    i = i + j + 1;
                else if (k < j)
                    i = i + j - k;
                else
                    i = i + 1;
                break;
            }
        }
        if (present)
            return i;
    }

    return -1;
}
def recherche_BMH(motif, droite, chaine):
    '''Cherche motif dans chaine en utilisant la table de saut
    précalculée droite'''
    n, p = len(chaine), len(motif)
    i = 0
    while i <= n-p:
        present = True
        for j in reversed(range(p)):
            if chaine[i+j] != motif[j]:
                present = False
                k = droite[ord(chaine[i+j])]
                if k is None:
                    i = i + j + 1
                elif k < j:
                    i = i + j - k
                else:
                    i = i + 1
                break
        if present:
            return i
    return None
Correction
Tout d'abord, remarquons que la terminaison ne pose pas de questions dans la mesure où le nouvel indice auquel on relance la recherche est toujours strictement plus grand que le précédent.
Au sujet de la correction, il suffit de s'assurer que les indices écartés
correspondent nécessairement à des recherches infructueuses. Seuls les sauts
d'au moins deux indices nécessitent une preuve. Notons \(m = m_0 \dots m_{p-1}\)
et supposons qu'à l'indice \(i\), on ait un échec en comparant le caractère
\(c = s_{i+j}\) avec \(m_j\) et que l'on relance la recherche à l'indice
\(i + j - k\) où \(k\) est la valeur de droite[c] si \(k < j\), et \(k = -1\) si
droite[c] \(= \emptyset\) (ce qui correspond bien au saut en \(i+j+1\)).
Soit \(i'\) tel que \(i < i' < i + j - k\). Une occurrence du motif à l'indice
\(i'\) placerait le caractère \(c = s_{i+j}\) en face du caractère \(m_{j'}\) du motif
où \(j' = i + j - i'\) vérifie \(k < j' < j \le p-1\). Or, par définition de
droite, \(c\) n'apparaît pas parmi \(m_{k+1}, \dots, m_{p-2}\), donc
\(m_{j'} \neq c\) et la recherche à l'indice \(i'\) échoue nécessairement.
Complexité
Tout d'abord, on remarque que la table de saut se construit en \(O(\max(|m|,|\Sigma|))\) pour un motif \(m\) sur un alphabet \(\Sigma\).
Sans chercher à rentrer dans les détails, on peut raisonnablement penser si l'alphabet contient assez de caractères que les motifs auront peu de répétitions et qu'ainsi, les sauts seront presque toujours maximaux, ce qui permet d'obtenir de l'ordre de \(\frac{n}{p}\) comparaisons où \(n\) est la longueur de la chaîne et \(p\) la longueur du motif.
Cependant, en pire cas, cet algorithme n'est pas meilleur que le précédent. Pour s'en convaincre, on va considérer un exemple proche de celui introduit pour l'algorithme naïf. Si on cherche \(b a^{p-1}\) dans \(a^n\) à l'indice \(i\), il est nécessaire d'attendre de comparer au caractère \(b\) pour constater un échec et devoir relancer l'algorithme à l'indice \(i+1\). On va donc faire ici aussi \((n-p+1)p\) comparaisons, soit \(\Theta(np)\) dès que \(p \le n/2\).
La complexité temporelle en pire cas de Boyer-Moore-Horspool est donc de \(O(np)\), même si, en pratique, elle est sous-linéaire.
Remarque
Si l'alphabet contient peu de caractères, ce qui est le cas en particulier du binaire, il y a de grandes chances qu'on soit dans ce cas pire cas. Ainsi, Boyer-Moore-Horspool n'est pas adapté pour ce type de texte.
Principe de Boyer-Moore
Considérons le cas suivant de l'algorithme précédent : on cherche abbcabc dans cbacbbcabc.
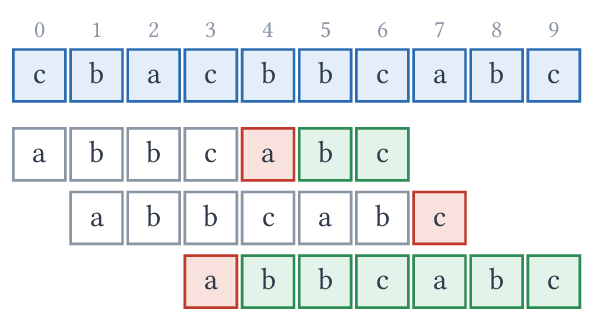
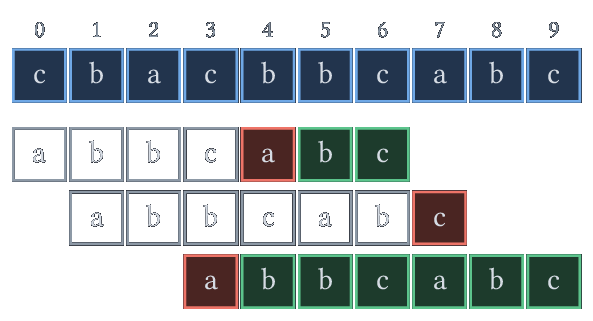
On remarque qu'en raison du fonctionnement de cet algorithme, on est forcé de
faire de tous petits sauts et on est ramené à l'algorithme naïf. Cependant,
après la première étape, on sait qu'on a lu dans la chaîne le suffixe bc du
motif, précédé d'un caractère b en sorte que bbc ne soit pas un suffixe du
motif (dans le motif, bc est précédé de a).
Il y a un autre endroit dans le motif où on peut trouver *bc avec * un
autre caractère que a. On pourrait donc relancer la recherche en alignant
cette occurrence de bc avec celle qu'on vient de lire. Cela revient à sauter
directement à la dernière étape dans cet exemple :
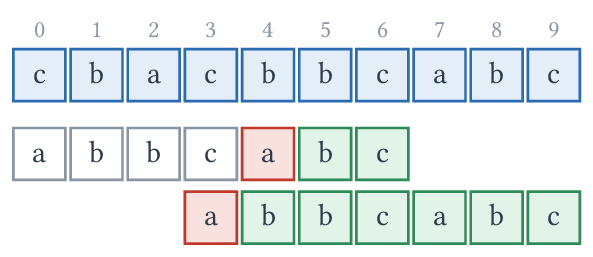
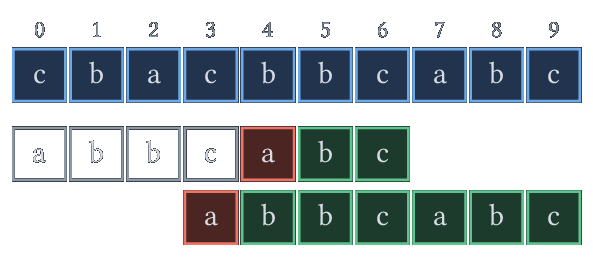
Pour pouvoir réaliser ce décalage, il est nécessaire de calculer une nouvelle table en parcourant le motif pour identifier de telles apparitions de suffixes.
On peut aller plus loin en considérant également le plus long préfixe du motif qui
soit un suffixe du suffixe considéré. Par exemple, pour le motif bcabc on
remarque que bc étant un préfixe, on peut effectuer un saut comme dans
l'exemple suivant :
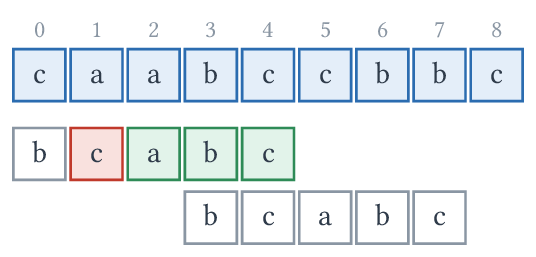
Table des bons suffixes
Note
Tout cela sera redéfini proprement plus tard dans le chapitre sur les langages. Je laisse cette partie en attendant pour que la présentation soit complète.
Il est nécessaire d'introduire des définitions précises pour formaliser la stratégie qu'on vient de présenter. Dans le contexte des langages, on parle plus souvent de mot que de chaîne de caractères, qui sont un type de données permettant de les représenter. Un mot sur l'alphabet \(\Sigma\) est donc une suite finie \(a_1 \dots a_n\) de lettres dans l'alphabet. On note \(\mu\) l'unique mot vide, c'est-à-dire ne contenant aucune lettre. L'ensemble des mots sur \(\Sigma\) est noté \(\Sigma^*\). Si \(u\) et \(v\) sont des mots, \(uv\) est le mot obtenu par concaténation.
Remarque
\(\Sigma^*\) muni de cette loi de composition a une structure proche de l'ensemble des entiers naturels \(\N\) muni de l'addition :
- on a : \(\forall u,v,w \in \Sigma^*, u(vw) = (uv)w = uvw\), on dit que la loi est associative ;
- elle possède un élément neutre \(\mu\) : \(\forall u \in \Sigma^*, \mu u = u \mu = u\).
On dit alors que \(\Sigma^*\) est un monoïde. Cette structure très simple est cruciale en informatique.
Définition
Soit \(u, v \in \Sigma^*\), on dit que \(v\) est :
- un suffixe de \(u\) s'il existe \(w \in \Sigma^*\) tel que \(u = w v\)
- un préfixe de \(u\) s'il existe \(w \in \Sigma^*\) tel que \(u = v w\)
Lorsque \(w \neq \mu\), on parle de suffixe ou de préfixe propre.
On dit que \(v\) est un bord de \(u\) lorsque \(v\) est suffixe et préfixe propre de \(u\).
Exemple
Soit \(u = a b a c a b a\). \(ab a c\) est un préfixe de \(u\), \(c a ba\) un suffixe et \(aba\) un bord.
Définition
Soit \(x = x_1 \dots x_n\) et \(u,v\) deux suffixes distincts de \(x\). On dit que \(u\) et \(v\) sont des suffixes disjoints quand on est dans l'un des cas suivants :
- \(u = x\)
- \(v = x\)
- \(u \neq x, v \neq x\) et \(x_{|x|-|u|} \neq x_{|x|-|v|}\).
Des suffixes disjoints sont donc des suffixes précédés par des lettres différentes dans \(x\). On définit de même la notion de préfixes disjoints.
On considère un motif \(x = x_0 \dots x_{n-1}\) et
on va reprendre, en la précisant, la description précédente. Ce faisant, on va
construire une table bonsuffixe appelée la table des bons suffixes du
motif \(x\) et telle que, pour \(i \in \range{0}{n-1}\), bonsuffixe[i] donne le
nombre de positions dont on doit décaler le motif vers la droite pour relancer
la recherche après la lecture du suffixe \(x_{i+1} \dots x_{n-1}\).
Supposons qu'on vient de lire avec succès un suffixe propre \(u\). Ainsi \(x = x_0 \dots x_i u\) et on vient de lire dans la chaîne où on effectue la recherche \(a u\) avec \(a \neq x_i\).
- Soit il existe un autre suffixe \(b u v\) de \(x\) où \(b \neq x_i\) et alors on
appelle bon suffixe pour \(u\) un tel suffixe de longueur minimale et on pose
alors
bonsuffixe[i]\(=|v|\) - Sinon, on cherche \(v\) de longueur minimale tel que \(x\) soit un suffixe de \(u
v\) et on pose également
bonsuffixe[i]\(=|v|\).
On remarque que si \(x\) est suffixe de \(u v\) et qu'on a également \(b u v'\) suffixe de \(x\), alors \(|uv| = |u|+|v| \ge |x| \ge |buv'| \ge |u|+|v'|\) donc \(|v| \ge |v'|\) ce qui permet de considérer le plus petit \(v\) sur l'ensemble des cas.
Table des suffixes
Afin de calculer efficacement bonsuffixe on va commencer par calculer la
table des suffixes du motif, il s'agit de la table suffixe où suffixe[i] contient
la longueur du plus long suffixe de \(x\) de la forme \(x_j \dots x_i\). Ainsi,
si on note \(S_i\) les suffixes de cette forme, on a :
Nécessairement, suffixe[n-1]=n car \(x\) convient.
Exemple
Pour \(x = bcabc\) on a :
| i | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
suffixe[i] |
0 | 2 | 0 | 0 | 5 |
et pour \(x = abbabba\) :
| i | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
suffixe[i] |
1 | 0 | 0 | 4 | 0 | 0 | 7 |
Il est possible de construire suffixe avec un simple parcours linéaire en tirant
partie de l'information déjà calculée. Pour cela, on va remplir suffixe de
droite à gauche.
À tout moment, on va conserver le meilleur suffixe rencontré, c'est-à-dire
celui pour lequel on est allé le plus loin à gauche avant d'avoir un échec de
comparaison. On note \(s\) la position la plus à droite de ce suffixe et \(k\) sa
longueur,
il s'agit donc de \(u = x_{s-k+1} ... x_s\) et il y a eu un
échec de comparaison en \(x_{s-k}\).
Par définition de suffixe on a suffixe[s]\(=k\).
Le mot \(x\) s'écrit alors :
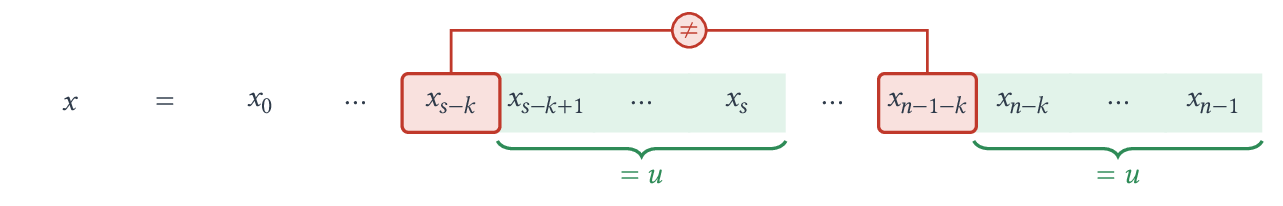
Ce qu'on peut représenter schématiquement ainsi :
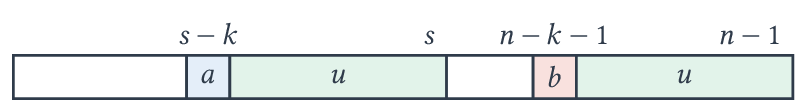
Maintenant, on considère la position \(s-i\) où \(s > s-i > s-k\), c'est-à-dire
\(0 < i < k\), cela signifie qu'on
cherche un suffixe depuis une position interne au mot \(u\) de gauche. Le point
clé permettant d'obtenir un algorithme linéaire est de remarquer que la
situation est la même que dans le mot \(u\) de droite, à la position \(n-1-i\). Or,
comme on procède de droite à gauche, on a déjà calculé la valeur
correspondante suffixe[n-1-i]. Là, on a deux cas :
-
soit quand on a cherché le plus grand suffixe finissant à la position \(n-1-i\), on s'est heurté à une erreur de comparaison à la position \(n-1-k\), celle de \(b\). Dans ce cas, on a
suffixe[n-1-i]\(=k-i\) et on peut regarder, en partant de la position \(s-k\), si on peut prolonger le suffixe finissant à la position \(s-i\).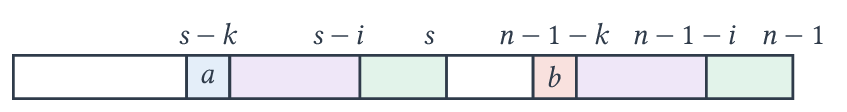
Pour effectuer ce prolongement, il suffit de comparer, caractère par caractère, vers la gauche en partant de la position \(s-k\). On aboutira alors à un nouveau suffixe finissant en \(s-i\), de longueur \(l\), qui devient le suffixe allé le plus loin à gauche.
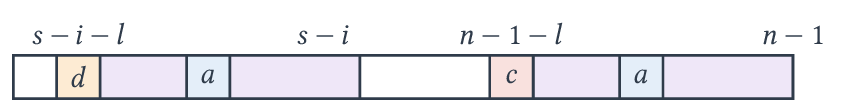
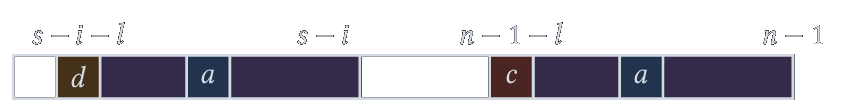
Remarquons qu'il est possible que \(s-i-l = s-k\). C'est-à-dire que même si \(a\) ne permet pas de prolonger le suffixe déduit de la position \(n-1-i\), on considère tout de même que la nouvelle position de référence est \(s-i\). On en déduit également la valeur
suffixe[s-i]\(=l\).
-
soit
suffixe[n-1-i]\(= t \neq k-i\) et alors-
soit \(t < k-i\), on a alors pour ce suffixe un échec à l'intérieur du \(u\) de droite, à la position \(n-1-i-t\), et ce même échec se produit à l'intérieur du \(u\) de gauche, à la position \(s-i-t\) :
suffixe[s-i]\(=t\). -
soit \(t > k-i\), donc le suffixe finissant en \(n-1-i\) se prolonge au-delà de \(u\) et le caractère \(b\) en position \(n-1-k\) est égal à \(x_{n-1-(k-i)}\). Pour prolonger le suffixe finissant en \(s-i\) au-delà de la longueur \(k-i\), il faudrait donc avoir \(x_{s-k} = x_{n-1-(k-i)} = b\), or, c'est impossible car \(x_{s-k} = a \neq b\). Ainsi, le suffixe est limité par \(u\) :
suffixe[s-i]\(=k-i\).
-
Il reste à traiter le cas où \(s - i \le s-k\), ce qui revient à considérer qu'on a dépassé le précédent suffixe pouvant apporter une information. On procède donc naïvement pour trouver le plus grand suffixe depuis cette position.
On en déduit l'implémentation suivante :
let calcule_suffixe (x:string) : int array =
    (* Prend en entrée un mot x et renvoie son tableau de suffixe *)
    let n = String.length x in
    let suffixe = Array.make n (-1) in
    if n > 0 then suffixe.(n-1) <- n;
    let plus_a_gauche = ref (n-1) in
    let depart = ref (-1) in

    for j = n-2 downto 0 do
        if !plus_a_gauche < j
            && suffixe.(n-1- !depart+j) <> j - !plus_a_gauche
        then suffixe.(j) <- min suffixe.(n-1- !depart+j) (j - !plus_a_gauche)
        else begin
            plus_a_gauche := min j !plus_a_gauche;
            depart := j;
            while !plus_a_gauche >= 0
                && x.[!plus_a_gauche] = x.[n-1-j + !plus_a_gauche] do
                plus_a_gauche := !plus_a_gauche - 1
            done;
            suffixe.(j) <- !depart - !plus_a_gauche
        end
    done;
    suffixe
/* Calcule le tableau suffixe associé au mot x
 * le tableau renvoyé a été alloué, il devra être libéré après utilisation */
int *calcule_suffixe(char *x)
{
    int n = strlen(x);
    int *suffixe = malloc(sizeof(int) * n);
    int plus_a_gauche = n-1;
    int depart = -1;

    memset(suffixe, -1, sizeof(int) * n);
    if (n > 0)
        suffixe[n-1] = n;

    for (int j = n-2; j >= 0; j--)
    {
        if (plus_a_gauche < j
            && suffixe[n-1-depart+j] != j-plus_a_gauche)
            suffixe[j] = MIN(suffixe[n-1-depart+j], j-plus_a_gauche);
        else {
            plus_a_gauche = MIN(plus_a_gauche, j);
            depart = j;
            while (plus_a_gauche >=0
                    && x[plus_a_gauche] == x[n-1-j+plus_a_gauche])
                plus_a_gauche--;
            suffixe[j] = depart - plus_a_gauche;
        }
    }

    return suffixe;
}
def calcule_suffixe(x):
    '''Prend en entrée un mot x et renvoie son tableau de suffixe'''
    n = len(x)
    suffixe = [ None ] * n
    if n > 0:
        suffixe[n-1] = n
    plus_a_gauche = n-1
    depart = None

    for j in reversed(range(0,n-1)):
        if plus_a_gauche < j and suffixe[n-1-depart+j] != j-plus_a_gauche:
            suffixe[j] = min(suffixe[n-1-depart+j],j-plus_a_gauche)
        else:
            plus_a_gauche = min(plus_a_gauche, j)
            depart = j
            while plus_a_gauche >= 0 \
                    and x[plus_a_gauche] == x[n-1-j+plus_a_gauche]:
                plus_a_gauche = plus_a_gauche - 1
            suffixe[j] = depart - plus_a_gauche

    return suffixe
Remarque
Cette implémentation est optimisée par rapport à la description précédente en calculant directement sans introduire \(i\) ou \(k\), et en fusionnant deux cas qui reviennent à dupliquer du code.
On donne ici le code maladroit qui correspond à la traduction exacte de la description précédente :
let calcule_suffixe_rep (x:string) : int array =
    (* Prend en entrée un mot x et renvoie son tableau de suffixe *)
    let n = String.length x in
    let suffixe = Array.make n 0 in
    if n > 0 then suffixe.(n-1) <- n;
    let plus_a_gauche = ref (n-1) in
    let depart = ref (-1) in

    for j = n-2 downto 0 do
        if !plus_a_gauche < j
        then begin
            (* on a j = depart - i avec *)
            let i = !depart - j in
            (* et plus_a_gauche = depart - k avec *)
            let k = !depart - !plus_a_gauche in
            if suffixe.(n-1-i) <> k-i
            then suffixe.(j) <- min suffixe.(n-1-i) (k-i)
            else begin
                depart := j;
                while !plus_a_gauche >= 0
                    && x.[!plus_a_gauche] = x.[n-1-j + !plus_a_gauche] do
                    plus_a_gauche := !plus_a_gauche - 1
                done;
                suffixe.(j) <- !depart - !plus_a_gauche
            end
        end else begin
            plus_a_gauche := j;
            depart := j;
            while !plus_a_gauche >= 0
                && x.[!plus_a_gauche] = x.[n-1-j + !plus_a_gauche] do
                plus_a_gauche := !plus_a_gauche - 1
            done;
            suffixe.(j) <- !depart - !plus_a_gauche
        end
    done;
    suffixe
/* Calcule le tableau suffixe associé au mot x
 * le tableau renvoyé a été alloué, il devra être libéré après utilisation */
int *calcule_suffixe_rep(char *x)
{
    int n = strlen(x);
    int *suffixe = malloc(sizeof(int) * n);
    int plus_a_gauche = n-1;
    int depart = -1;

    memset(suffixe, -1, sizeof(int) * n);
    if (n > 0)
        suffixe[n-1] = n;

    for (int j = n-2; j >= 0; j--)
    {
        if (plus_a_gauche < j)
        {
            // on a j = depart - i avec
            int i = depart - j;
            // et plus_a_gauche = depart -k avec
            int k = depart - plus_a_gauche;

            if (suffixe[n-1-i] != k-i)
                suffixe[j] = MIN(suffixe[n-1-i], k-i);
            else {
                depart = j;
                while (plus_a_gauche >=0
                        && x[plus_a_gauche] == x[n-1-j+plus_a_gauche])
                    plus_a_gauche--;
                suffixe[j] = depart - plus_a_gauche;
            }
        } else {
            plus_a_gauche = depart = j;
            while (plus_a_gauche >=0
                    && x[plus_a_gauche] == x[n-1-j+plus_a_gauche])
                plus_a_gauche--;
            suffixe[j] = depart - plus_a_gauche;
        }
    }

    return suffixe;
}
def calcule_suffixe_rep(x):
    '''Prend en entrée un mot x et renvoie son tableau de suffixe'''
    n = len(x)
    suffixe = [ None ] * n
    if n > 0:
        suffixe[n-1] = n
    plus_a_gauche = n-1
    depart = None

    for j in reversed(range(0,n-1)):
        if plus_a_gauche < j:
            # on a j = depart - i avec
            i = depart - j
            # et plus_a_gauche = depart - k avec
            k = depart - plus_a_gauche
            if suffixe[n-1-i] != k-i:
                suffixe[j] = min(suffixe[n-1-i],k-i)
            else:
                depart = j
                while plus_a_gauche >= 0 \
                        and x[plus_a_gauche] == x[n-1-j+plus_a_gauche]:
                    plus_a_gauche = plus_a_gauche - 1
                suffixe[j] = depart - plus_a_gauche
        else:
            plus_a_gauche = depart = j
            while plus_a_gauche >= 0 \
                    and x[plus_a_gauche] == x[n-1-j+plus_a_gauche]:
                plus_a_gauche = plus_a_gauche - 1
            suffixe[j] = depart - plus_a_gauche

    return suffixe
On remarque que dans ce code, plus_a_gauche ne peut que diminuer, on effectue
donc au plus \(n\) itérations dans la boucle while pour tout l'algorithme.
Donc, en considérant la boucle for, on effectue au plus \(2n\) comparaisons de
caractères : au plus une pour chaque itération de la boucle for pour voir si
on entre dans le while, puis en tout au plus \(n\) avant de sortir du while.
L'algorithme qu'on a obtenu est bien linéaire en \(|x|\).
Obtention de bonsuffixe à partir de suffixe
On reprend maintenant le calcul de bonsuffixe[i] dans le mot \(x = x_0 \dots
x_{n-1}\).
On cherche à obtenir
des suffixes de la forme \(b u v\) de \(x\) où \(b \neq x_i\) et \(u = x_{i+1} \dots
x_{n-1}\) est un suffixe de \(x\), de longueur \(n-1-i\). Mais si, pour \(k < n-1\),
suffixe[k]\(=n-1-i\), cela signifie que le facteur de \(x\) de longueur \(n-1-i\)
finissant en position \(k\) est exactement \(u\) et qu'il est soit préfixe, soit
précédé d'une lettre différente de \(x_i\), sinon \(n-1-i\) ne serait pas maximal.
Le mot \(v\) correspondant est alors \(x_{k+1} \dots x_{n-1}\), de longueur \(n-1-k\).
On a donc, quand cet ensemble n'est pas vide,
On remarque qu'on peut ainsi faire croître \(k\) de \(0\) à \(n-2\) et poser :
On aura alors naturellement, à la fin de la boucle, la valeur minimale placée en dernier.
Reste à considérer les valeurs non remplies ainsi dans le tableau bonsuffixe.
Elles correspondent aux positions \(i\) telles qu'il n'existe pas de suffixe de
la forme \(b u v\). On doit donc chercher un mot \(uv\) de longueur minimale
dont \(x\) est suffixe. Mais \(u\) étant un suffixe de \(x\), cela revient à
considérer les bords de \(x\). La table suffixe permet également de détecter
les bords : si \(x_0 ... x_k\) est un bord c'est que suffixe[k]\(=k+1\).
Soit \(k < n-1\) maximal vérifiant cette condition.
Pour tout \(u = x_{i+1} \dots x_{n-1}\) suffixe de \(x\), pour qu'il ait \(x_0 \dots
x_k\) comme suffixe, il faut qu'il soit au moins aussi long que ce bord,
donc que \(n-1-i \ge k+1 \iff
i < n-1-k\). Dans ce cas, \(x\) est alors suffixe de \(u v\) où \(v = x_{k+1} \dots
x_{n-1}\) donc \(|v|=n-1-k\). Les \(k\) plus petits ne pourront alors que faire
augmenter \(|v|\), on peut ainsi poser bonsuffixe[i]\(=n-1-k\).
On en déduit un remplissage en parcourant
les \(k\) dans l'ordre décroissant de \(n-2\) à \(0\), tout en maintenant l'indice
\(i\) de la prochaine valeur à remplir dans bonsuffixe. Dès qu'on détecte un
bord, on place \(n-1-k\) jusqu'à ce que \(i \ge n-1-k\).
En sortie de boucle, il est possible que \(i < n\) donc qu'il reste des valeurs à
remplir. On remarque dans ce cas là que pour que \(x\) soit un suffixe de \(u v\)
il faut que \(v = x\). On a donc pour ces valeurs restantes bonsuffixe[i]\(=n\).
Comme ce second cas est toujours plus long que le premier quand les deux se produisent en \(i\), on implémente successivement les remplissages de sorte à obtenir la valeur minimum. On en déduit le programme suivant :
let calcule_bonsuffixe (x:string) : int array =
    (* Prend en entrée un mot x et renvoie son tableau de suffixe *)
    let n = String.length x in
    let suffixe = calcule_suffixe x in
    let bonsuffixe = Array.make n n in

    let suivant = ref 0 in
    for k = n-2 downto 0 do
        if suffixe.(k) = k+1 (* c'est un bord *)
        then begin
            for i = !suivant to n-2-k do
                bonsuffixe.(i) <- n-1-k
            done;
            suivant := n-1-k
        end
    done;

    for k = 0 to n-2 do
        bonsuffixe.(n-1-suffixe.(k)) <- n-1-k
    done;

    bonsuffixe
/* Calcule le tableau suffixe associé au mot x
 * le tableau renvoyé a été alloué, il devra être libéré après utilisation */
int *calcule_bonsuffixe(char *x)
{
    int n = strlen(x);
    int *suffixe = calcule_suffixe(x);
    int *bonsuffixe = malloc(sizeof(int) * n);
    int suivant = 0;

    for (int i = 0; i < n; i++)
        bonsuffixe[i] = n;

    for (int k = n-2; k >= 0; k--)
    {
        if (suffixe[k] == k+1) // bord
        {
            for (int i = suivant; i < n-1-k; i++)
                bonsuffixe[i] = n-1-k;
            suivant = n-1-k;
        }
    }

    for (int k = 0; k < n-1; k++)
        bonsuffixe[n-1-suffixe[k]] = n-1-k;

    free(suffixe);

    return bonsuffixe;
}
def calcule_bonsuffixe(x):
    '''Prend en entrée un mot x et renvoie son tableau de suffixe'''
    n = len(x)
    suffixe = calcule_suffixe(x)
    bonsuffixe = [ n ] * n

    suivant = 0
    for k in reversed(range(0,n-1)):
        if suffixe[k] == k+1: # c'est un bord
            for i in range(suivant,n-1-k):
                bonsuffixe[i] = n-1-k
            suivant = n-1-k

    for k in range(0,n-1):
        bonsuffixe[n-1-suffixe[k]] = n-1-k

    return bonsuffixe
Il est facile de constater que cet algorithme est de complexité temporelle linéaire en \(|x|\).
Algorithme de Boyer-Moore
On incorpore naturellement la table précédente à l'algorithme de Boyer-Moore en choisissant le meilleur décalage entre cette table et la stratégie précédente.
let recherche_BM (motif:string)
    (droite:int option array) (bonsuffixe:int array)
    (chaine:string) : int option =
    let n = String.length chaine in
    let p = String.length motif in
    let i = ref 0 in
    try
        while !i <= n-p do
            try
                for j = p-1 downto 0 do
                    if chaine.[!i+j] <> motif.[j]
                    then begin
                        let dec =  match droite.(Char.code chaine.[!i+j]) with
                                | None -> j+1
                                | Some k when k < j -> j-k
                                | _ -> 1 in
                        i := !i + max dec bonsuffixe.(j);
                        raise Difference
                    end
                done;
                raise (Trouve !i)
            with Difference -> ()
        done;
        None
    with Trouve k -> Some k
/* cherche motif dans chaine en utilisant les tables de saut précalculées
 * droite et bonsuffixe. Renvoie l'indice de la première occurrence ou -1 s'il n'est pas
 * présent */
int recherche_BM(char *motif, int *droite, int *bonsuffixe, char *chaine)
{
    int n = strlen(chaine);
    int p = strlen(motif);

    for(int i = 0; i <= n-p; )
    {
        bool present = true;
        for (int j = p-1; j >= 0; j--)
        {
            if (chaine[i+j] != motif[j])
            {
                int k = droite[(unsigned char) chaine[i+j]];
                int dec = 1;
                present = false;
                if (k < 0)
                    dec = j + 1;
                else if (k < j)
                    dec = j - k;
                i = i + MAX(dec, bonsuffixe[j]);
                break;
            }
        }
        if (present)
            return i;
    }

    return -1;
}
def recherche_BM(motif, droite, bonsuffixe, chaine):
    '''Cherche motif dans chaine en utilisant les tables de sauts
    droite et bonsuffixe'''
    n, p = len(chaine), len(motif)
    i = 0
    while i <= n-p:
        present = True
        for j in reversed(range(p)):
            if chaine[i+j] != motif[j]:
                present = False
                k = droite[ord(chaine[i+j])]
                if k is None:
                    dec = j + 1
                elif k < j:
                    dec = j - k
                else:
                    dec = 1
                dec = max(dec, bonsuffixe[j])
                i = i + dec
                break
        if present:
            return i
    return None
Supposons que le motif est de longueur \(p\), que la chaîne dans laquelle on recherche est de longueur \(n\) et que la taille de l'alphabet est une constante indépendante des entrées. La première partie de l'algorithme consiste à construire les tables de sauts, comme on l'a vu, elle est en complexité en temps et en espace en pire cas en \(O(p)\).
On admet que l'algorithme Boyer-Moore complet, étant donné les deux tables de saut et d'autres modifications mineures non présentées ici, est en complexité temporelle en pire cas en \(O(n)\).
Il est assez raisonnable de penser que soit \(p \le n\) quand on effectue une recherche, soit on compte chercher un même motif dans plusieurs textes et on réutilise ainsi les tables de sauts. Il n'est donc pas forcément très pertinent de parler de la complexité globale de l'algorithme, mais lorsqu'on le fait, on dit qu'elle est en \(O(p+n)\). On rappelle ici le rôle de l'addition dans les complexités qui fait référence à la succession de deux traitements, un en \(O(p)\) suivi d'un en \(O(n)\).
Algorithme de Rabin-Karp
Principe
L'algorithme de Rabin-Karp est un algorithme de recherche d'un motif dans un texte qui utilise une notion d'empreinte pour déterminer, en temps constant, si il est probable que la position actuelle corresponde à une occurrence du motif.
Pour cela, si on cherche un motif de longueur \(p\) sur l'alphabet \(\Sigma\), on considère une fonction de hachage \(h : \Sigma^p \rightarrow X\). Les éléments de l'ensemble \(X\) sont appelés des empreintes et on suppose que l'égalité entre deux empreintes se vérifie en temps constant contrairement à l'égalité dans \(\Sigma^p\) qui se vérifie en \(O(p)\) dans le pire des cas. Le plus souvent, on choisit pour \(X\) un type entier machine.
Note
Sûrement mettre ici des renvois vers la partie portant le plus sur la notion de fonction de hachage pour la définition la plus complète.
Bien qu'il soit normalement aussi coûteux de calculer l'image par \(h\) d'une sous-chaîne de longueur \(p\) que de tester l'égalité entre cette sous-chaîne et le motif, le point essentiel de l'algorithme de Rabin-Karp est d'utiliser une fonction de hachage permettant un calcul incrémental en temps constant :
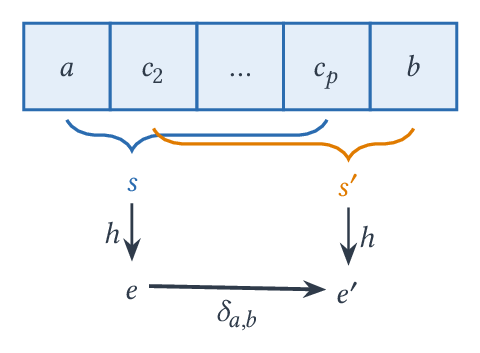
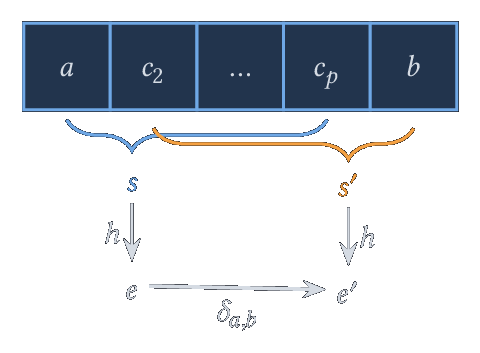
Ici, on considère donc, pour \(a, b \in \Sigma\), une fonction de mise à jour \(\delta_{a,b} : X \rightarrow X\) telle que pour tout \(c_2,\dots,c_p \in \Sigma\) on ait \(\delta_{a,b}(h(ac_2 \dots c_p)) = h(c_2\dots c_p b)\).
L'algorithme de Rabin-Karp procède alors ainsi pour chercher \(m\) de longueur \(p\) dans la chaîne \(s = c_0 \dots c_{n-1}\) où \(n \ge p\) :
- calcul de \(e_m = h(m)\) et \(e = h(c_0..c_{p-1})\).
-
Pour \(i\) allant de \(0\) à \(n-p\) :
- Si \(e_m = e\), on renvoie un succès pour la recherche à la position \(i\) si \(m = c_i \dots c_{i+p-1}\)
- si \(i<n-p\) on met à jour l'empreinte \(e \leftarrow \delta_{c_i,c_{i+p}}(e)\).
La complexité temporelle liée à la gestion des empreintes est donc en \(O(n+p) = O(n)\) car \(n \ge p\). Par contre, pour calculer la complexité liée à la recherche \(m = c_i \dots c_{i+p-1}\), il est nécessaire d'estimer la proportion de faux positifs, c'est-à-dire de positions \(i\) telles que \(e_m = e\) mais \(m \neq c_i \dots c_{i+p-1}\). On va voir dans la partie suivante qu'on peut supposer qu'elle est négligeable, ce qui permet de considérer que l'algorithme de Rabin-Karp est linéaire.
Choix d'une fonction de hachage
Réaliser une bonne fonction de hachage est une question très complexe qui dépasse le cadre du cours d'informatique de MPI. Cependant, il est possible de réaliser ici une fonction de hachage répondant aux contraintes de Rabin-Karp assez facilement.
Pour cela, on considère que les caractères sont des entiers compris entre 0 et 255, ce qui correspond au type des caractères non signés sur un octet. On peut alors identifier une chaîne de longueur \(p\) avec un nombre entre \(0\) et \(r^{p} - 1\) où \(r =2^8\), on note ainsi
On considère de plus un entier premier \(q\) et on pose \(h(s) = P(s) \mod q\) c'est-à-dire le reste de \(P(s)\) dans la division euclidienne par \(q\). On peut ainsi définir \(\delta_{a,b}(e) = (r (e - a r^{p-1}) + b) \mod q\).
Si on précalcule \(r^{p-1} \mod q\), il suffit d'un nombre d'opérations constant, et indépendant de \(p\), pour calculer la nouvelle empreinte à l'aide de \(\delta_{a,b}\).
Le point essentiel est alors de déterminer un nombre premier \(q\) tel qu'il soit peu probable d'obtenir des faux positifs. Une analyse mathématique permet d'affirmer que chaque élément de \(\range{0}{q-1}\) a de l'ordre de \(\frac{r^p}{q}\) antécédents par \(h\). Ainsi, si on choisit deux chaînes aléatoirement dans \(\Sigma^p\), il y aura collision avec probabilité proche de \(\frac{1}{q}\). En considérant \(q\) proche de la taille maximale pour le type entier considéré, on minimise donc cette probabilité.
Remarque
On peut également s'intéresser à des nombres \(q\) pour lesquels le modulo soit rapide à calculer. Un exemple classique est \(q = 2^{31} - 1\) car on peut déduire le reste de \(a\) modulo \(q\) de l'écriture de \(a\) en base \(2^{31}\). En effet, si \(a = \sum_{k=0}^n a_k 2^{31k}\) avec \(0 \le a_k < 2^{31}\), comme \(2^{31}-1 \mid 2^{31k} - 1\) pour \(k \ge 1\), on a \(2^{31k} \equiv 1 ~[q]\) et ainsi \(a \equiv \sum_{k=0}^n a_k ~[q]\). On remarque que chaque chiffre s'obtient par un simple décalage et un masquage sur 31 bits : \(a_k = (a >> 31k) \& q\) car \(q = 2^{31}-1\) s'écrit avec 31 bits à 1. La somme \(s = \sum_{k=0}^n a_k\) est congrue à \(a\) modulo \(q\) et strictement plus petite que \(a\) dès que \(a \ge 2^{31}\) : on recommence donc avec \(s\) tant que \(s > q\). Enfin, si \(s \le q\), on a \(s \mod q = s\) quand \(s < q\) et \(s \mod q = 0\) quand \(s = q\).
On obtient alors le programme suivant :
let rec fastmod a =
    let s = ref 0 in
    let x = ref a in
    let q = 0x7fffffff in
    while !x > 0 do
        s := !s + (!x land q);
        x := !x lsr 31
    done;
    if !s > q
    then fastmod !s
    else if !s = q
    then 0
    else !s
int64_t fastmod(int64_t a)
{
    int64_t s = 0;
    const int64_t q = 0x7fffffff;

    while (a > 0)
    {
        s = s + (a & q);
        a = a >> 31;
    }

    if (s > q)
        return fastmod(s);
    if (s == q)
        return 0;
    return s;
}
def fastmod(a):
    s = 0
    q = 0x7fffffff
    while a > 0:
        s = s + (a & q)
        a = a >> 31
    if s > q:
        return fastmod(s)
    elif s == q:
        return 0

    return s
Le programme suivant implémente naïvement les calculs de \(h\) et de
\(\delta_{a,b}\), ainsi que celui de \(r^{k} \mod q\) par exponentiation rapide.
Attention : en OCaml et en C, le reste mod (ou %) d'un entier négatif est
négatif, or \(e - a r^{p-1}\) peut l'être. Il faut donc ramener le résultat dans
\(\range{0}{q-1}\), ce qui n'est pas nécessaire en Python où % renvoie
toujours un résultat positif quand \(q > 0\).
let hash r q s =
    let p = ref 1 in
    let e = ref 0 in
    for i = String.length s - 1 downto 0 do
        e := (!p * (Char.code s.[i]) + !e) mod q;
        p := (r * !p) mod q
    done;
    !e

let rec pow r k q = (* r^k mod q *)
    if k = 0 then 1
    else let x = pow ((r * r) mod q) (k / 2) q in
        if k mod 2 = 0 then x else (r * x) mod q

let delta r q rp a b e = (* rp est r^(p-1) mod q *)
    let x = (r * (e - rp * (Char.code a)) + Char.code b) mod q in
    if x < 0 then x + q else x
int64_t hash(int64_t r, int64_t q, char *s, int n)
{
    int64_t p = 1;
    int64_t e = 0;

    for (int i = n-1; i >= 0; i--)
    {
        e = (p * (unsigned char) s[i] + e) % q;
        p = (r * p) % q;
    }

    return e;
}


int64_t powmod(int64_t r, int k, int64_t q) // r^k mod q
{
    if (k == 0)
        return 1;
    int64_t x = powmod((r * r) % q, k / 2, q);
    return k % 2 == 0 ? x : (r * x) % q;
}

int64_t delta(int64_t r, int64_t q, int64_t rp,
        unsigned char a, unsigned char b, int64_t e)
{
    int64_t x = (r * (e - rp * a) + b) % q;
    return x < 0 ? x + q : x;
}
def hash(r,q,s):
    e = 0
    p = 1
    for c in reversed(s):
        e = (ord(c) * p + e) % q
        p = (r * p) % q
    return e

def delta(r,q,rp,a,b,e):
    return (r * (e - rp * ord(a)) + ord(b)) % q
Implémentation
Une implémentation directe de l'algorithme de Rabin-Karp est donnée dans le
programme qui suit. On se sert ici du caractère paresseux du && pour
n'effectuer le test coûteux d'égalité des chaînes qu'en cas d'égalité des
empreintes.
exception Trouve of int

let rabin_karp m s =
    let n = String.length s in
    let p = String.length m in
    if p = 0 then Some 0 (* le mot vide est présent en 0 *)
    else if p > n then None
    else begin
        let r = 256 in
        let q = 0x7fffffff in (* 2^(31)-1 *)
        let rp = pow r (p-1) q in
        let me = hash r q m in
        let e = ref (hash r q (String.sub s 0 p)) in
        try
            for i = 0 to n-p do
                if me = !e && m = String.sub s i p
                then raise (Trouve i);
                if i+p < n then e := delta r q rp s.[i] s.[i+p] !e
            done; None
        with Trouve k -> Some k
    end
int rabin_karp(char *m, char *s)
{
    const int64_t r = 256;
    const int64_t q = 0x7fffffff;
    const int p = strlen(m);
    const int n = strlen(s);
    if (p == 0)
        return 0; // le mot vide est présent en 0
    if (p > n)
        return -1; // sinon hash lirait au-delà de la fin de s
    const int64_t rp = powmod(r,p-1,q);
    const int64_t me = hash(r,q,m,p);
    int64_t e = hash(r,q,s,p);
    for (int i=0; i <n-p+1; i++)
    {
        if (me == e && strncmp(m,(s+i),p) == 0)
            return i;
        if (i+p < n)
            e = delta(r,q,rp,s[i],s[i+p],e);
    }
    return -1;
}
def rabin_karp(m, s):
    p, n = len(m), len(s)
    if p == 0:
        return 0 # le mot vide est présent en 0
    if p > n:
        return None
    r, q = 256, 0x7fffffff
    rp = pow(r, p-1, q) # r^(p-1) mod q par exponentiation rapide
    me, e = hash(r,q,m), hash(r,q,s[:p])
    for i in range(0,n-p+1):
        if me == e and m == s[i:i+p]:
            return i
        if i+p < n:
            e = delta(r,q,rp,s[i],s[i+p],e)
    return None
Si on suppose qu'il est improbable d'obtenir un faux positif, il est possible de renvoyer un succès dès que les empreintes sont égales. L'avantage d'une telle version est alors d'être un algorithme sans retour sur les données. C'est-à-dire qu'il n'est pas nécessaire de garder en mémoire ou de réaccéder à un caractère.
L'algorithme originel de Rabin et Karp
Si on regarde l'article originel de Rabin et Karp décrivant cette méthode, on peut être étonné du fait que la méthode précédemment décrite était considérée comme déjà connue dans la littérature par les auteurs. En fait, ce qu'ils décrivent et annoncent comme étant novateur est l'utilisation d'un algorithme probabiliste en choisissant aléatoirement une fonction de hachage à chaque lancement de l'algorithme. En pratique, il s'agit de choisir aléatoirement un nombre premier \(q\) parmi un ensemble précalculé de nombres premiers.
L'algorithme que l'on vient de décrire a un pire cas qui est très improbable car on considère que la probabilité d'un faux positif est à peu près de \(1/q\), donc moins de \(5 \cdot 10^{-10}\) pour \(q = 2^{31}-1\). Le problème ici est la notion de probabilité sur les entrées : est-on certain que l'algorithme recevra une entrée choisie uniformément ? Rabin et Karp parlent d'un adversaire intelligent qui aurait connaissance de la fonction de hachage choisie pour produire des entrées en pire cas. On pourrait ainsi imaginer une attaque sur serveur effectuant une recherche avec Rabin-Karp suite à l'entrée d'un utilisateur. Un adversaire pourrait construire une entrée en pire cas et tenter de surcharger le serveur en l'effectuant de manière répétée.
Pour bien mettre en lumière ce phénomène, nous allons ici construire, dans un
cas très simple de fonction de hachage, une telle chaîne problématique. Pour
cela, considérons la fonction de hachage précédemment décrite dans le cas de
motif de taille 2, avec \(\Sigma\) contenant les lettres de a à z, \(r
= 26\) et \(q = 17\). On considère une recherche du motif aa dont
l'empreinte est 0, la même que celle des chaînes ar et ra. On peut donc
considérer la chaîne arar...ar qui produira un faux positif à
chaque étape.
Remarque
Détail des calculs. Ici on associe à a la valeur \(0\), ..., à z la
valeur \(25\). On a donc
L'empreinte reste ainsi nulle tout au long de l'algorithme de Rabin-Karp et on a un faux positif à chaque itération.
Compression
Principe
On s'intéresse ici à la compression parfaite d'un texte, c'est-à-dire, étant donné un alphabet fixé \(\Sigma\), qu'on cherche à réaliser un couple de fonctions \(\mathop{comp}, \mathop{dec} : \Sigma^* \rightarrow \Sigma^*\) telles que :
- pour tout mot \(m \in \Sigma^*\), \(\mathop{dec} (\mathop{comp}(m)) = m\)
- pour la plupart des mots \(m\) qui correspondent aux données qu'on cherche à compresser, \(|\mathop{comp}(m)| < |m|\).
Remarque
Le fait que \(\mathop{dec} \circ \mathop{comp} = \mathop{id}_{\Sigma^*}\) implique, comme on a pu le voir dans le cours de mathématique, que \(\mathop{comp}\) est injective : deux mots différents ont nécessairement des images distinctes.
Si \(A\) et \(B\) sont deux ensembles finis tels que \(|A| < |B|\), il n'existe pas de fonction injective de \(A\) dans \(B\). Ainsi, si on note \(L_n\) les mots de \(\Sigma^*\) de longueur au plus \(n\), il ne peut exister de fonction injective de \(L_n\) dans \(L_m\) où \(m < n\) (si \(|\Sigma| \ge 2\), on a \(|L_m| < |L_n|\)).
Autrement dit : il est impossible d'espérer pouvoir compresser toutes les données de \(L_n\). Si certains mots vont diminuer de longueur après compression, d'autres vont nécessairement augmenter.
Tout l'enjeu des algorithmes de compression
parfaite est alors de diminuer les longueurs des mots qui nous intéressent.
Par exemple, si on s'intéresse à des mots issus de textes en français, il est
plus important d'arriver à compresser une phrase comme "ceci est un texte"
plutôt qu'une suite de caractères non signifiante comme "c2#$%1ajdn //@#3d!fn".
Algorithme d'Huffman
La définition et la construction de l'arbre de Huffman ont été présentées au paragraphe Construction de l'arbre de Huffman du chapitre sur les algorithmes gloutons. On va s'intéresser ici au processus complet permettant de compresser et décompresser des fichiers avec cet algorithme.
Calcul de la table d'occurrences
Par souci d'efficacité, on calcule une table d'occurrences pour l'ensemble des valeurs d'octets entre 0 et 255. Il suffit alors de parcourir le fichier pour incrémenter les valeurs correspondant aux octets lus.
let table_occurrences nomdefichier =
    let fichier = open_in_bin nomdefichier in
    let occurrences = Array.make 256 0 in
    begin
     try
        while true do
            let c = input_byte fichier in
            occurrences.(c) <- occurrences.(c) + 1;
        done
      with End_of_file -> ()
    end;
    close_in fichier;
    occurrences
/* remplit occurrences[c] avec le nombre d'occurrences de l'octet c
 * dans le fichier nomdefichier */
void table_occurrences(const char *nomdefichier, int occurrences[256])
{
    FILE *fichier = fopen(nomdefichier, "rb");
    int c;

    assert(fichier != NULL);
    for (int i = 0; i < 256; i++)
        occurrences[i] = 0;

    while ((c = fgetc(fichier)) != EOF)
        occurrences[c]++;

    fclose(fichier);
}
def table_occurrences(nomdefichier):
    occurrences = [ 0 ] * 256
    with open(nomdefichier, 'rb') as fichier:
        for c in fichier.read(): # les éléments d'un bytes sont des int
            occurrences[c] += 1
    return occurrences
On construit ensuite l'arbre de Huffman avec la fonction construit_arbre du
chapitre sur les algorithmes gloutons.
Construction de l'arbre en C et en Python
Le chapitre sur les algorithmes gloutons ne donne que la version OCaml. Voici
des versions C et Python de construit_arbre, qui fixent aussi la
représentation des arbres utilisée dans la suite.
En C, plutôt que d'implémenter un tas, on cherche à chaque étape les deux
plus petites fréquences dans un tableau d'au plus 256 arbres : le coût
\(O(|\Sigma|^2)\) est négligeable devant la lecture du fichier. En Python, on
utilise le module heapq de la bibliothèque standard.
/* Un arbre de Huffman : une feuille a deux fils NULL et une
 * étiquette c entre 0 et 255, un nœud interne a l'étiquette -1 */
struct arbre {
    int c;
    struct arbre *g;
    struct arbre *d;
};
typedef struct arbre arbre;

arbre *cree_arbre(int c, arbre *g, arbre *d)
{
    arbre *a = malloc(sizeof(arbre));
    a->c = c;
    a->g = g;
    a->d = d;
    return a;
}

arbre *feuille(int c)
{
    return cree_arbre(c, NULL, NULL);
}

arbre *noeud(arbre *g, arbre *d)
{
    return cree_arbre(-1, g, d);
}

bool est_feuille(arbre *a)
{
    return a->g == NULL;
}

void libere_arbre(arbre *a)
{
    if (!est_feuille(a))
    {
        libere_arbre(a->g);
        libere_arbre(a->d);
    }
    free(a);
}

/* construit l'arbre de Huffman associé à la table occ,
 * renvoie NULL si toutes les occurrences sont nulles */
arbre *construit_arbre(int occ[256])
{
    arbre *arbres[256];
    int freq[256];
    int n = 0;

    for (int i = 0; i < 256; i++)
    {
        if (occ[i] > 0) // on ignore les occurrences nulles
        {
            arbres[n] = feuille(i);
            freq[n] = occ[i];
            n++;
        }
    }
    if (n == 0)
        return NULL;

    while (n > 1)
    {
        /* on place la plus petite fréquence en n-1
         * puis la suivante en n-2 */
        for (int k = 1; k <= 2; k++)
        {
            int imin = 0;
            for (int i = 1; i <= n-k; i++)
                if (freq[i] < freq[imin])
                    imin = i;
            arbre *ta = arbres[imin];
            int tf = freq[imin];
            arbres[imin] = arbres[n-k];
            freq[imin] = freq[n-k];
            arbres[n-k] = ta;
            freq[n-k] = tf;
        }
        arbres[n-2] = noeud(arbres[n-1], arbres[n-2]);
        freq[n-2] = freq[n-1] + freq[n-2];
        n--;
    }

    return arbres[0];
}
import heapq

# Une feuille est représentée par son étiquette, un entier
# entre 0 et 255, et un nœud par le couple (g, d) de ses fils.

def construit_arbre(occ):
    '''Construit l'arbre de Huffman associé à la table occ,
    lève ValueError si toutes les occurrences sont nulles.'''
    # le deuxième champ, tous distincts, évite d'avoir à
    # comparer des arbres en cas d'égalité des fréquences
    arbres = [ (occ[c], c, c) for c in range(256) if occ[c] > 0 ]
    if arbres == []:
        raise ValueError("texte vide")
    heapq.heapify(arbres)
    compteur = 256
    while len(arbres) > 1:
        fx, _, x = heapq.heappop(arbres)
        fy, _, y = heapq.heappop(arbres)
        heapq.heappush(arbres, (fx+fy, compteur, (x, y)))
        compteur += 1
    return arbres[0][2]
Sérialisation de l'arbre de Huffman
Afin de décompresser, il est nécessaire de connaître l'arbre de Huffman donnant le code préfixe. Pour cela, il faut stocker cet arbre dans le fichier comme une série d'octets, on parle de sérialisation. Cette notion sera prolongée dans le chapitre FIXME.
On choisit ici la représentation récursive repr(a) de l'arbre a définie
ainsi :
- Si
a = Noeud(g,d),repr(a) = 0 repr(g) repr(d) - Si
a = Feuille(c),repr(a) = 1 c.
Exemple
Si a = Noeud(Feuille 42, Noeud(Feuille 16, Feuille 64)), on obtient la suite
d'octets : 0 1 42 0 1 16 1 64.
La lecture et l'écriture de la sérialisation s'effectuent alors simplement par récurrence :
let rec output_arbre f a =
    match a with
    | Noeud (x, y) -> begin
        output_byte f 0;
        output_arbre f x;
        output_arbre f y
    end
    | Feuille c -> begin
        output_byte f 1;
        output_byte f c
    end

let rec input_arbre f =
    let code = input_byte f in
    match code with
    | 0 -> let g = input_arbre f in
        let d = input_arbre f in
        Noeud(g,d)
    | _ -> Feuille (input_byte f)
void output_arbre(FILE *f, arbre *a)
{
    if (est_feuille(a))
    {
        fputc(1, f);
        fputc(a->c, f);
    } else {
        fputc(0, f);
        output_arbre(f, a->g);
        output_arbre(f, a->d);
    }
}

arbre *input_arbre(FILE *f)
{
    int code = fgetc(f);
    assert(code != EOF);
    if (code == 0)
    {
        arbre *g = input_arbre(f);
        arbre *d = input_arbre(f);
        return noeud(g, d);
    }
    int c = fgetc(f);
    assert(c != EOF);
    return feuille(c);
}
def output_arbre(f, a):
    if isinstance(a, int): # feuille
        f.write(bytes([1, a]))
    else:
        g, d = a
        f.write(bytes([0]))
        output_arbre(f, g)
        output_arbre(f, d)

def input_arbre(f):
    code = f.read(1)[0]
    if code == 0:
        g = input_arbre(f)
        d = input_arbre(f)
        return (g, d)
    return f.read(1)[0]
Écriture dans un fichier un bit à la fois
Note
À déplacer éventuellement dans une partie spécifique sur la gestion de fichiers.
Le propre de l'algorithme de Huffman est d'associer à chaque caractère un codage binaire de longueur variable. Afin de pouvoir écrire ce codage dans un fichier, il est nécessaire de grouper les bits par paquet de huit (octet en français, byte en anglais).
Ainsi, par exemple, si on a le codage suivant :
| c | 'a' |
'b' |
'c' |
|---|---|---|---|
| code(c) | 0 | 100 | 101 |
et qu'on doit encoder "abbaca", on obtient le mot binaire 010010001010
qu'on complète avec des 0 à la fin et qu'on sépare en octets :
01001000 10100000. On obtient donc les deux octets, convertis en décimal,
72 et 160. Ce sont eux qu'on va écrire dans un fichier.
Une technique usuelle pour cela est de garder un accumulateur qui correspond à l'octet en train d'être construit ainsi que le nombre de bits qui ont été accumulés. Dès qu'on a accumulé 8 bits, on peut construire l'octet, l'écrire dans le fichier, puis réinitialiser ces variables.
Quand on rajoute un bit \(b\) à l'accumulateur, on veut passer de \(acc = b_1 \dots b_k\) à \(b_1 \dots b_k b = 2 acc + b\).
On en déduit l'implémentation assez directe suivante :
type out_channel_bits = {
    o_fichier : out_channel;
    mutable o_accumulateur : int;
    mutable o_bits_accumules : int
}

let open_out_bits fn =
    { o_fichier = open_out_bin fn; o_accumulateur = 0; o_bits_accumules = 0 }

let output_bit f b =
    if f.o_bits_accumules = 8
    then begin
        output_byte f.o_fichier f.o_accumulateur;
        f.o_accumulateur <- 0;
        f.o_bits_accumules <- 0
    end;
    f.o_accumulateur <- 2 * f.o_accumulateur + (if b then 1 else 0);
    f.o_bits_accumules <- 1 + f.o_bits_accumules
struct out_channel_bits {
    FILE *fichier;
    int accumulateur;
    int bits_accumules;
};
typedef struct out_channel_bits out_channel_bits;

/* la structure renvoyée est libérée par close_out_bits */
out_channel_bits *open_out_bits(const char *fn)
{
    out_channel_bits *f = malloc(sizeof(out_channel_bits));
    f->fichier = fopen(fn, "wb");
    assert(f->fichier != NULL);
    f->accumulateur = 0;
    f->bits_accumules = 0;
    return f;
}

void output_bit(out_channel_bits *f, bool b)
{
    if (f->bits_accumules == 8)
    {
        fputc(f->accumulateur, f->fichier);
        f->accumulateur = 0;
        f->bits_accumules = 0;
    }
    f->accumulateur = 2 * f->accumulateur + (b ? 1 : 0);
    f->bits_accumules++;
}
import os

class Bitpacking:
    '''La classe Bitpacking se comporte comme un fichier Python
    tout en fournissant des méthodes spécifiques à la lecture
    et à l'écriture de bits.'''

    def __init__(self, filename, mode):
        self.file = open(filename, mode)
        self.accumulateur = 0
        self.bits_accumules = 0

        self.input = mode[0] == 'r'
        if self.input:
            self.init_input()

    def write_bit(self, b):
        if self.bits_accumules == 8:
            self.file.write(bytes([self.accumulateur]))
            self.accumulateur = 0
            self.bits_accumules = 0
        self.accumulateur = 2 * self.accumulateur \
                + (1 if b else 0)
        self.bits_accumules += 1
Il reste à traiter la question des zéros finaux, si l'accumulateur contient \(k\) bits au moment de la fermeture du fichier, où \(0 < k < 8\), il faut ajouter \(8-k\) zéros. On appelle cela du padding de l'anglais pour rembourrage. Ici, cela correspond à faire un décalage binaire vers la gauche d'autant (shift left en anglais). Comme il sera nécessaire de se souvenir que ces zéros ne sont pas signifiants à la lecture, on rajoute un octet final contenant leur nombre \(8-k\).
On obtient alors la fonction de fermeture de fichier suivante :
let close_out_bits f =
    if f.o_bits_accumules = 0
    then output_byte f.o_fichier 0
    else begin
        let padding = 8 - f.o_bits_accumules in
        output_byte f.o_fichier (Int.shift_left f.o_accumulateur padding);
        output_byte f.o_fichier padding
    end;
    close_out f.o_fichier
/* écrit le padding, ferme le fichier et libère la structure */
void close_out_bits(out_channel_bits *f)
{
    if (f->bits_accumules == 0)
        fputc(0, f->fichier);
    else {
        int padding = 8 - f->bits_accumules;
        fputc(f->accumulateur << padding, f->fichier);
        fputc(padding, f->fichier);
    }
    fclose(f->fichier);
    free(f);
}
def close(self):
    if not self.input:
        self.close_output()
    self.file.close()

def close_output(self):
    if self.bits_accumules == 0:
        self.file.write(b'\x00')
    else:
        padding = 8 - self.bits_accumules
        self.file.write(bytes([
            self.accumulateur << padding,
            padding ]))

# pour pouvoir écrire with Bitpacking(...) as f:
# la fermeture est alors automatique en sortie de bloc
def __enter__(self):
    return self

def __exit__(self, type, value, tb):
    self.close()
Remarque
Une autre possibilité consiste à ajouter un entier décrivant la taille des données non compressées. C'est d'ailleurs parfois un problème avec les formats car si la taille est stockée sur 4 octets cela limite la taille d'un fichier pouvant être compressé.
Pour la lecture, on procède de même en faisant attention à deux points :
- on va lire les bits dans l'octet de la gauche vers la droite, c'est-à-dire du
bit de poids le plus fort au bit de poids le plus faible. Ainsi, si
l'accumulateur contient \(acc = b_1 \dots b_8\), il suffit de faire un et bit
à bit avec
0b10000000 = 0x80 = 128pour obtenir \(acc \,\&\, \texttt{0x80} = b_1 0 \dots 0\) donc un nombre qui vaut \(0\) si et seulement si \(b_1 = 0\). Après avoir effectué cette lecture, il suffit de décaler vers la gauche en multipliant l'accumulateur par 2 : \(2 acc = b_2 \dots b_8 0\). - on doit tenir compte des zéros finaux, pour ça, on a besoin de savoir qu'on est en train de lire le dernier caractère du fichier. On calcule donc la taille du fichier à son ouverture et on teste si l'octet lu est l'avant-dernier, auquel cas on lit le dernier octet et on diminue d'autant le nombre de bits signifiants dans l'accumulateur. Symétriquement, si l'octet à lire est le dernier du fichier, c'est qu'il ne reste que l'octet de padding et donc plus aucune donnée : on signale alors la fin du fichier. Ce cas se produit à la fin de la lecture, mais aussi d'emblée quand aucun bit n'a été écrit.
On obtient alors le programme suivant pour la lecture :
type in_channel_bits = {
    i_fichier : in_channel;
    mutable i_accumulateur : int;
    mutable i_bits_accumules : int;
    i_taille : int
}

let open_in_bits fn =
    let fichier = open_in_bin fn in
    { i_fichier = fichier;
      i_accumulateur = 0; i_bits_accumules = 0; i_taille = in_channel_length fichier }

let input_bit f =
    if f.i_bits_accumules = 0
    then begin
        (* s'il ne reste que l'octet de padding, il n'y a plus de données *)
        if pos_in f.i_fichier >= f.i_taille - 1
        then raise End_of_file;
        f.i_accumulateur <- input_byte f.i_fichier;
        f.i_bits_accumules <- 8;
        if pos_in f.i_fichier = f.i_taille - 1
        then begin
            let pad = input_byte f.i_fichier in
            f.i_bits_accumules <- f.i_bits_accumules - pad
        end
    end;
    let bit = f.i_accumulateur land 0x80 <> 0 in
    f.i_accumulateur <- 2 * f.i_accumulateur;
    f.i_bits_accumules <- f.i_bits_accumules - 1;
    bit

let close_in_bits f = close_in f.i_fichier
struct in_channel_bits {
    FILE *fichier;
    int accumulateur;
    int bits_accumules;
    long taille;
};
typedef struct in_channel_bits in_channel_bits;

/* la structure renvoyée est libérée par close_in_bits */
in_channel_bits *open_in_bits(const char *fn)
{
    in_channel_bits *f = malloc(sizeof(in_channel_bits));
    f->fichier = fopen(fn, "rb");
    assert(f->fichier != NULL);
    fseek(f->fichier, 0, SEEK_END);
    f->taille = ftell(f->fichier);
    fseek(f->fichier, 0, SEEK_SET);
    f->accumulateur = 0;
    f->bits_accumules = 0;
    return f;
}

/* renvoie le bit lu (0 ou 1), ou -1 s'il n'y a plus de données */
int input_bit(in_channel_bits *f)
{
    if (f->bits_accumules == 0)
    {
        // s'il ne reste que l'octet de padding, il n'y a plus de données
        if (ftell(f->fichier) >= f->taille - 1)
            return -1;
        f->accumulateur = fgetc(f->fichier);
        f->bits_accumules = 8;
        if (ftell(f->fichier) == f->taille - 1)
        {
            int pad = fgetc(f->fichier);
            f->bits_accumules = f->bits_accumules - pad;
        }
    }
    int bit = (f->accumulateur & 0x80) != 0;
    f->accumulateur = 2 * f->accumulateur;
    f->bits_accumules--;
    return bit;
}

void close_in_bits(in_channel_bits *f)
{
    fclose(f->fichier);
    free(f);
}
def init_input(self):
    self.file.seek(0, os.SEEK_END)
    self.taille = self.file.tell()
    self.file.seek(0, os.SEEK_SET)

def read_bit(self):
    if self.bits_accumules == 0:
        # s'il ne reste que l'octet de padding, il n'y a plus de données
        if self.file.tell() >= self.taille - 1:
            return b''
        c = self.file.read(1)
        self.accumulateur = ord(c)
        self.bits_accumules = 8
        if self.file.tell() == self.taille - 1:
            pad = ord(self.file.read(1))
            self.bits_accumules -= pad
    bit = (self.accumulateur & 0x80) != 0
    self.accumulateur *= 2
    self.bits_accumules -= 1
    return bit
Compression d'un octet
Pour pouvoir compresser un octet, il est nécessaire d'obtenir le chemin qui mène jusqu'à la feuille dont il est l'étiquette dans l'arbre de Huffman. Pour cela, on commence par calculer l'ensemble des chemins de l'arbre de Huffman sous forme d'une table à 256 entrées qui contient le chemin associé à un octet s'il est présent dans l'arbre ou un chemin vide sinon. On parlera de représentation plate de l'arbre de Huffman.
Il suffit de faire un parcours exhaustif de l'arbre (FIXME référence aux parcours d'arbres) pour réaliser cette table :
let chemins a =
    let a_plat = Array.make 256 [] in
    let rec parcours a chemin =
        match a with
        | Noeud (g, d) ->
            parcours g (false::chemin);
            parcours d (true::chemin)
        | Feuille c -> a_plat.(c) <- List.rev chemin
    in
    begin match a with
    | Feuille c -> a_plat.(c) <- [false] (* feuille unique : code 0 *)
    | Noeud _ -> parcours a []
    end;
    a_plat
/* parcours de a, où chemin[0..profondeur-1] est le chemin depuis la racine */
void parcours(arbre *a, char *chemin, int profondeur, char *a_plat[256])
{
    if (est_feuille(a))
    {
        chemin[profondeur] = '\0';
        a_plat[a->c] = malloc(profondeur + 1);
        strcpy(a_plat[a->c], chemin);
    } else {
        chemin[profondeur] = '0';
        parcours(a->g, chemin, profondeur + 1, a_plat);
        chemin[profondeur] = '1';
        parcours(a->d, chemin, profondeur + 1, a_plat);
    }
}

/* remplit a_plat[c] avec le chemin menant à la feuille c, sous la forme
 * d'une chaîne de '0' (gauche) et de '1' (droite), ou NULL si c est absent.
 * Les chaînes sont allouées et devront être libérées. */
void chemins(arbre *a, char *a_plat[256])
{
    // au plus 256 feuilles donc une hauteur au plus 255
    char chemin[257];

    for (int c = 0; c < 256; c++)
        a_plat[c] = NULL;

    if (est_feuille(a)) // feuille unique : code 0
    {
        chemin[0] = '0';
        parcours(a, chemin, 1, a_plat);
    } else
        parcours(a, chemin, 0, a_plat);
}
def chemins(a):
    a_plat = [ [] ] * 256
    def parcours(a, chemin):
        if isinstance(a, int): # feuille
            a_plat[a] = chemin
        else:
            g, d = a
            parcours(g, chemin + [False])
            parcours(d, chemin + [True])
    if isinstance(a, int): # feuille unique : code 0
        a_plat[a] = [False]
    else:
        parcours(a, [])
    return a_plat
Afin de compresser un octet, on va donc aller lire le chemin dans cette table puis écrire le mot binaire correspondant grâce aux fonctions d'écriture bit à bit :
let compresse_byte f a_plat c =
    let rec output_bool_list l =
        match l with
        | t::q -> Bitpacking.output_bit f t; output_bool_list q
        | [] -> ()
    in output_bool_list a_plat.(c)
void compresse_byte(out_channel_bits *f, char *a_plat[256], int c)
{
    for (char *b = a_plat[c]; *b != '\0'; b++)
        output_bit(f, *b == '1');
}
def compresse_byte(f, a_plat, c):
    for b in a_plat[c]:
        f.write_bit(b)
Remarque
À chaque fois qu'on va compresser un octet, on va parcourir la liste correspondant à son chemin. Comme les chemins les plus longs sont les moins fréquents, cela ne pose pas vraiment de problèmes.
Cependant, il est possible d'optimiser cela en ne stockant pas le chemin mais
la fonction d'écriture elle-même. Ainsi, on ne va plus stocker des listes de
booléens mais des fonctions du type Bitpacking.out_channel_bit -> unit qui
vont réaliser l'écriture compressée de l'octet correspondant.
Au cours du parcours de l'arbre, on maintient une fonction correspondant à
l'écriture du préfixe du chemin chemin. Si l'appel est effectué sur un nœud,
on remplace chemin par la fonction qui appelle chemin puis écrit le bit
correspondant au côté gauche ou droit.
Cela correspond au programme suivant :
let chemins_continuation a =
    let a_plat = Array.make 256 (fun _ -> ()) in
    let rec parcours a chemin =
        match a with
        | Noeud (g, d) ->
            parcours g (fun f -> chemin f; Bitpacking.output_bit f false);
            parcours d (fun f -> chemin f; Bitpacking.output_bit f true)
        | Feuille c -> a_plat.(c) <- chemin
    in
    begin match a with
    | Feuille c -> (* feuille unique : code 0 *)
        a_plat.(c) <- (fun f -> Bitpacking.output_bit f false)
    | Noeud _ -> parcours a (fun _ -> ())
    end;
    a_plat

let compresse_byte_continuation f a_plat c =
    a_plat.(c) f
Cette représentation des chemins partiels par des fonctions est très classique dans le style de programmation fonctionnelle par passage de continuations.
Décompression d'un octet
Pour décompresser un octet, il suffit de parcourir l'arbre de Huffman en lisant bit à bit le fichier compressé en descendant à gauche ou à droite selon que le bit lu soit 0 ou non. Dès qu'on arrive sur une feuille, on écrit dans le nouveau fichier le caractère correspondant.
let decompresse_byte f a =
    let rec descend a =
        match a with
        | Feuille c -> c
        | Noeud(g,d) ->
            descend (if Bitpacking.input_bit f then d else g)
    in
    match a with
    | Feuille c -> (* feuille unique : on consomme son code 0 *)
        ignore (Bitpacking.input_bit f); c
    | Noeud _ -> descend a
/* renvoie l'octet décompressé, ou -1 s'il n'y a plus de données */
int decompresse_byte(in_channel_bits *f, arbre *a)
{
    if (est_feuille(a)) // feuille unique : on consomme son code 0
        return input_bit(f) < 0 ? -1 : a->c;

    while (!est_feuille(a))
    {
        int b = input_bit(f);
        if (b < 0)
            return -1;
        a = b ? a->d : a->g;
    }
    return a->c;
}
def decompresse_byte(f, a):
    '''Renvoie l'octet décompressé ou None s'il n'y a plus de données'''
    if isinstance(a, int): # feuille unique : on consomme son code 0
        return None if f.read_bit() == b'' else a
    while not isinstance(a, int):
        b = f.read_bit()
        if b == b'':
            return None
        g, d = a
        a = d if b else g
    return a
Remarque
Quand le fichier ne contient qu'un seul octet distinct, l'arbre de Huffman
est réduit à une feuille et le chemin qui y mène est le mot vide. Comme le
rappelle le chapitre sur les algorithmes gloutons,
ce code vide est optimal à condition de connaître le nombre de caractères à
décoder : c'est la convention retenue dans le TP Huffman, qui mémorise la
longueur du texte. Ici, le format de fichier ne stocke pas cette longueur,
la fin des données n'est connue qu'à travers le padding : avec des codes
vides, la décompression produirait indéfiniment le même octet sans jamais
lire de bit. On convient donc d'associer le code 0 à une feuille unique,
ce qui coûte un bit par octet, et decompresse_byte lit ce bit avant de
renvoyer l'étiquette. Cela concerne aussi chemins et sa variante par
continuations.
Compression et décompression de fichiers
En mettant bout à bout l'ensemble des fonctions, on obtient la fonction suivante qui réalise la compression complète d'un fichier :
let compresse_fichier nom_in nom_out =
    let occ = table_occurrences nom_in in
    let a = if Array.for_all (fun x -> x = 0) occ
        then Feuille 0 (* fichier vide : arbre arbitraire *)
        else construit_arbre occ in
    let f_out = Bitpacking.open_out_bits nom_out in
    output_arbre f_out.o_fichier a;
    let a_plat = chemins a in
    let f_in = open_in_bin nom_in in
    begin
      try
        while true do
            let c = input_byte f_in in
            compresse_byte f_out a_plat c
        done
      with End_of_file -> ()
    end;
    close_in f_in;
    Bitpacking.close_out_bits f_out
void compresse_fichier(const char *nom_in, const char *nom_out)
{
    int occ[256];
    char *a_plat[256];
    int c;

    table_occurrences(nom_in, occ);
    arbre *a = construit_arbre(occ);
    if (a == NULL) // fichier vide : arbre arbitraire
        a = feuille(0);

    out_channel_bits *f_out = open_out_bits(nom_out);
    output_arbre(f_out->fichier, a);
    chemins(a, a_plat);

    FILE *f_in = fopen(nom_in, "rb");
    assert(f_in != NULL);
    while ((c = fgetc(f_in)) != EOF)
        compresse_byte(f_out, a_plat, c);
    fclose(f_in);
    close_out_bits(f_out);

    for (int i = 0; i < 256; i++)
        free(a_plat[i]);
    libere_arbre(a);
}
def compresse_fichier(nom_in, nom_out):
    occ = table_occurrences(nom_in)
    if sum(occ) == 0:
        a = 0 # fichier vide : arbre arbitraire
    else:
        a = construit_arbre(occ)
    a_plat = chemins(a)
    with open(nom_in, 'rb') as f_in, \
            Bitpacking(nom_out, 'wb') as f_out:
        output_arbre(f_out.file, a)
        for c in f_in.read():
            compresse_byte(f_out, a_plat, c)
On obtient de même la fonction de décompression suivante :
let decompresse_fichier nom_in nom_out =
    let f_in = Bitpacking.open_in_bits nom_in in
    let a = input_arbre f_in.i_fichier in
    let f_out = open_out_bin nom_out in
    begin
      try
          while true do
              let c = decompresse_byte f_in a in
              output_byte f_out c
          done
      with End_of_file -> ()
    end;
    Bitpacking.close_in_bits f_in;
    close_out f_out
void decompresse_fichier(const char *nom_in, const char *nom_out)
{
    in_channel_bits *f_in = open_in_bits(nom_in);
    arbre *a = input_arbre(f_in->fichier);
    FILE *f_out = fopen(nom_out, "wb");
    int c;

    assert(f_out != NULL);
    while ((c = decompresse_byte(f_in, a)) >= 0)
        fputc(c, f_out);

    close_in_bits(f_in);
    fclose(f_out);
    libere_arbre(a);
}
def decompresse_fichier(nom_in, nom_out):
    with Bitpacking(nom_in, 'rb') as f_in, \
            open(nom_out, 'wb') as f_out:
        a = input_arbre(f_in.file)
        while True:
            c = decompresse_byte(f_in, a)
            if c is None:
                break
            f_out.write(bytes([c]))
Remarque
Pour un fichier vide, il n'y a pas d'arbre de Huffman : construit_arbre
échoue. On écrit alors un arbre arbitraire réduit à une feuille, suivi
d'aucun bit. Le fichier compressé fait trois octets : 1 0 pour l'arbre et
l'octet final 0 indiquant l'absence de padding. À la décompression, après
lecture de l'arbre, il ne reste que l'octet final, donc la première lecture
de bit signale la fin du fichier et on obtient bien un fichier vide, sans
cas particulier.
Exemple
En compressant ainsi l'intégrale de Proust, on passe de 7543767 octets à
4249758 octets. A titre de comparaison, l'outil unix zip permet d'obtenir un
fichier de 2724213 octets.
Remarque
Le format de fichier présenté ici est rudimentaire. Les formats usuels sont en général plus complexes pour gérer
- l'identification : c'est-à-dire pouvoir déterminer qu'un fichier est un
fichier compressé par un certain programme. Les fichiers
zipcommencent ainsi par les deux lettresPK. - l'extensibilité : il est possible qu'on souhaite changer le format de sérialisation de l'arbre, ou même l'algorithme. En rajoutant un système de version sur les différentes parties, on peut permettre de faire évoluer un type de fichier en préservant la compatibilité avec les versions précédentes.
Algorithme de Lempel-Ziv-Welch
L'algorithme d'Huffman est efficace, mais il présente un désavantage majeur : il nécessite de lire le contenu d'un fichier dans son intégralité pour pouvoir déterminer un code préfixe optimal. Il est toutefois possible de modifier l'algorithme pour lever cette limitation. Dans ce paragraphe, nous allons plutôt étudier une autre technique de compression qui se programme assez facilement, qui se révèle même plus efficace que Huffman sur de gros textes (voir les mesures à la fin de ce paragraphe) et permet de compresser des flux plutôt que des fichiers. C'est-à-dire qu'on peut compresser et décompresser des données au fur et à mesure qu'elles sont transmises.
Il s'agit de l'algorithme de Lempel-Ziv-Welch, appelé communément compression LZW, et qui est une modification faite en 1984 par Welch de l'algorithme de LZ78 de Lempel et Ziv.
Principe de la compression
L'idée de l'algorithme LZW est de faire avancer une fenêtre sur le texte en maintenant une table des motifs déjà rencontrés. Quand on rencontre un motif déjà vu, on le code avec une référence vers la table et quand on rencontre un nouveau motif, on le code tel quel en rajoutant une entrée dans la table.
Pour la table, on peut utiliser un tableau dynamique de motifs (ref FIXME) dont la taille ne pourra pas dépasser \(2^d\) éléments ou directement un tableau de \(2^d\) valeurs optionnelles, dans la mesure où \(d\) est en général petit. Ainsi, on pourra référencer chaque motif avec un mot de d bits. Afin de pouvoir retrouver efficacement l'indice associé à un motif, on utilise une table de hachage (ref FIXME) réalisant l'inverse de la table.
L'algorithme procède alors ainsi pour compresser :
- on initialise la table avec une entrée pour chaque caractère, donc chaque octet, en considérant des caractères sur 8 bits.
- on maintient une variable contenant un suffixe \(m\) du texte lu, appelé motif courant, qui est toujours présent dans la table ; il est initialisé avec la première lettre du texte.
- on lit alors chaque caractère \(x\) :
- Soit \(mx\) est dans la table, et alors on remplace le motif courant par \(m \leftarrow mx\).
- Soit \(mx\) n'est pas dans la table, par construction \(m\) y est nécessairement, on produit alors le code correspondant à \(m\), on rajoute une entrée dans la table pour \(mx\) si elle contient moins de \(2^d\) éléments et on repart de \(m \leftarrow x\).
- quand tous les caractères ont été lus, on produit le code correspondant à \(m\).
Voici les différentes étapes pour la compression de la chaîne
AABABAAAB qui produit la suite d'entiers 65,65,66,257,256,257
qui seront alors codés dans un fichier sur d bits.
Les 256 premières entrées de la table ont été volontairement ignorées. On
remarque juste que A correspond à l'index 65 et B à l'index 66.
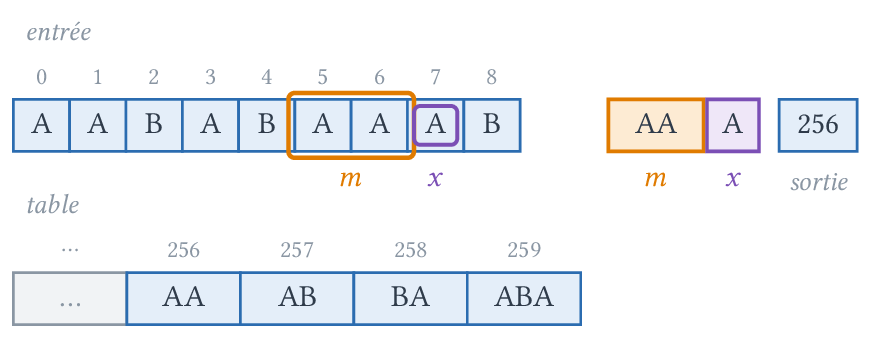
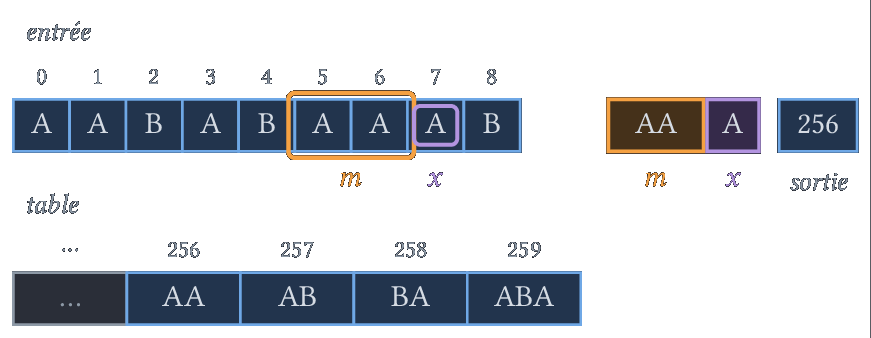
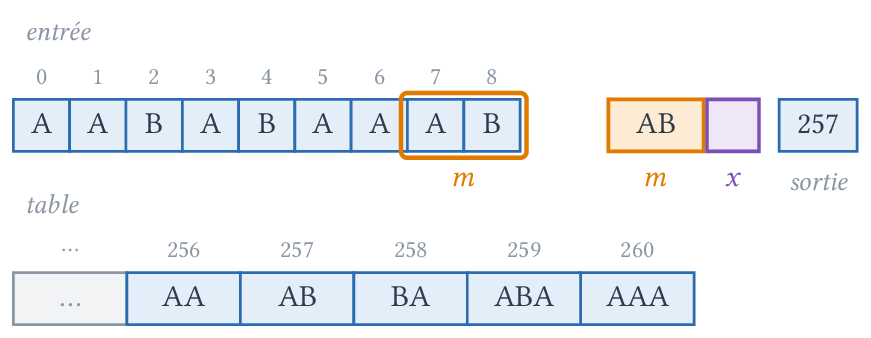
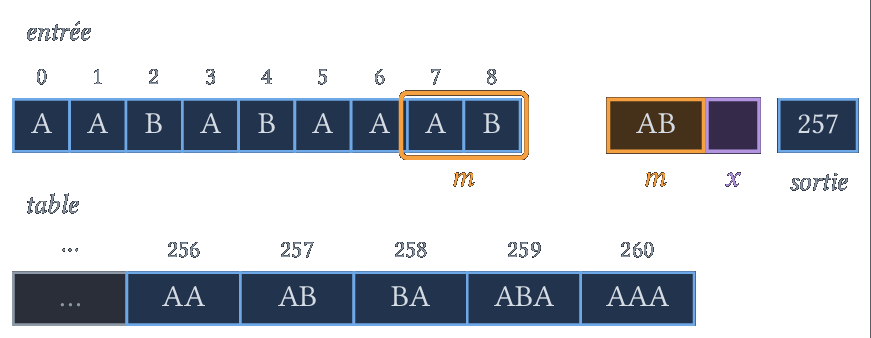
Principe de la décompression
Pour décompresser, on effectue la procédure précédente en sens inverse. Cependant, il faut reconstruire la table en même temps qu'on lit le fichier compressé. Dans la majorité des cas, c'est assez immédiat. Pour le premier code lu, il s'agit forcément d'une référence à un des 256 caractères, donc on le reproduit. À partir du second code lu :
- on lit un code \(n\) où \(n < |\textsf{table}|\) et \(\textsf{table}[n] = x m'\), \(x\) est un caractère et \(m'\) un mot.
- on écrit \(x m'\) dans le fichier de sortie.
- on rajoute ensuite \(m x\) dans la table où \(c\) est le précédent code lu et \(\textsf{table}[c] = m\).
En faisant ainsi, on reproduit le processus de compression mais en remplissant la table avec un temps de retard. En effet, si on reprend le principe exposé plus haut, une entrée pour \(mx\) est ajoutée dans la table quand on lit le caractère \(x\) et que le motif lu précédemment est \(m\), on repart alors avec \(x\) pour motif lu. C'est exactement ce qu'on fait ici en tenant compte du premier caractère de \(\textsf{table}[n]\). Contrairement à la compression, il est inutile ici de retrouver l'indice associé à un motif. On peut donc ignorer la table de hachage utilisée par la compression.
Voici les étapes de décompression de l'exemple précédent :
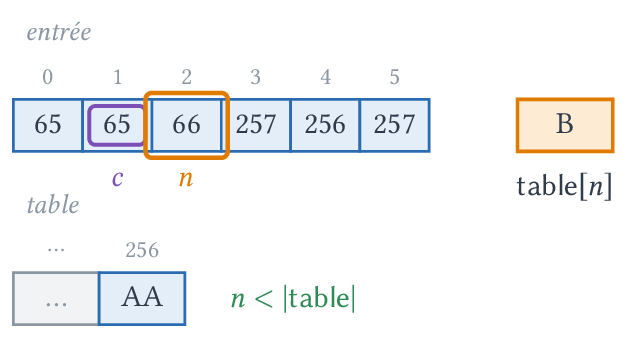
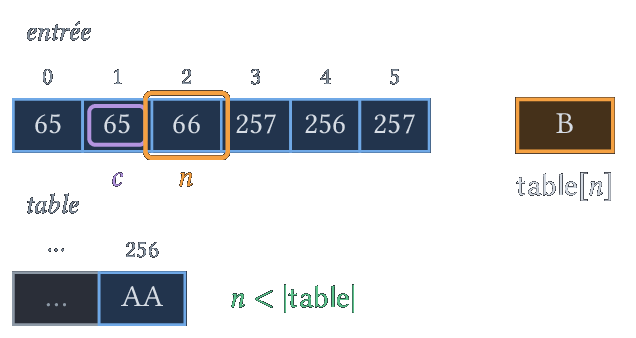
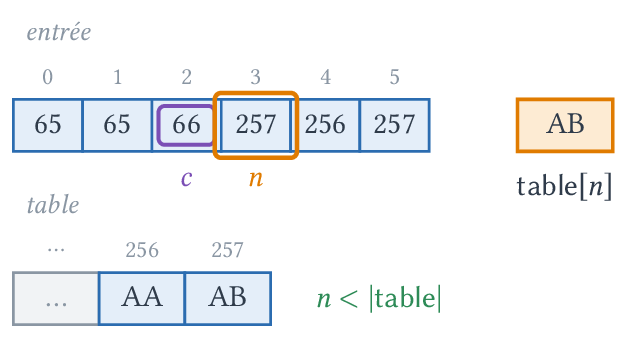
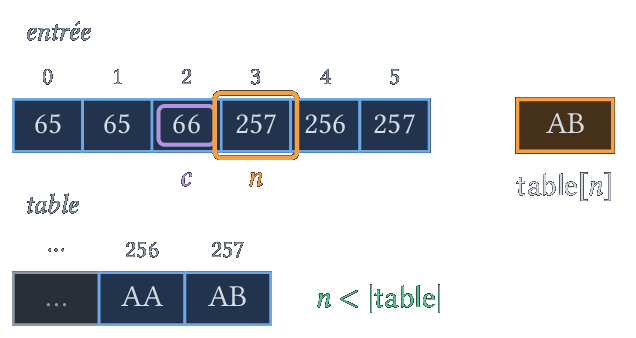
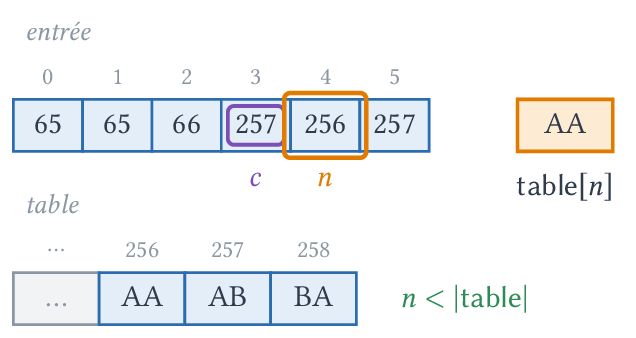
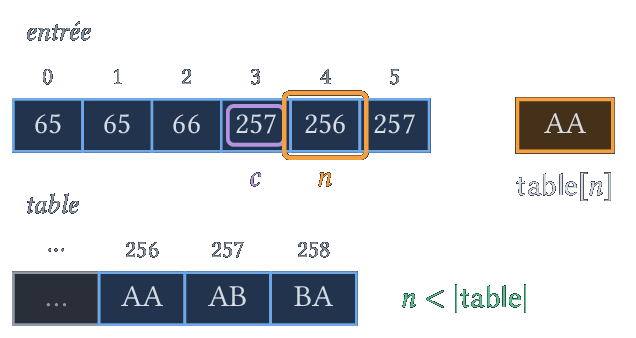
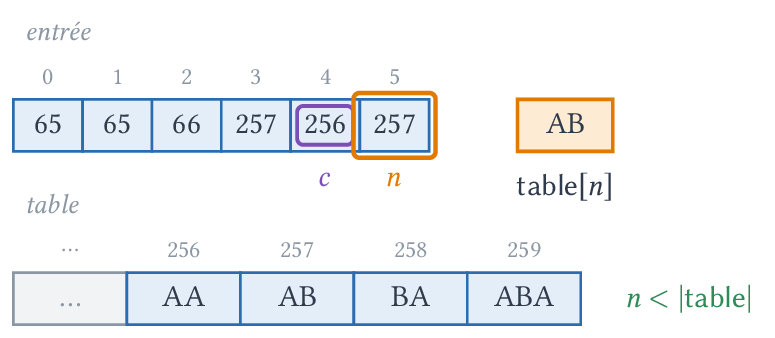
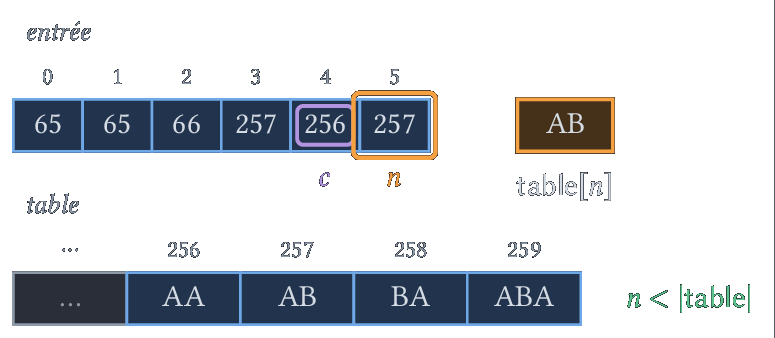
Il reste toutefois un cas à traiter, celui où \(n = |\textsf{table}|\), c'est-à-dire quand on lit un code qui n'est pas encore présent dans la table. Pour comprendre ce cas, il est important d'identifier précisément quand il se produit dans le processus de compression. Comme on vient de le voir, on rajoute une entrée pour \(m x\) après avoir produit le code \(c\) correspondant à \(m\). Pour que le code \(n\) ne soit pas présent dans la table, il faut donc que \(n\) corresponde à cette entrée \(m x\). Or, quand on a compressé, on est reparti du motif \(x\) à ce moment là, donc nécessairement \(m\) commence par \(x\). Cela signifie qu'on peut reconstruire \(\textsf{table}[n]\) en décompressant avec \(m x\) où \(x\) est la première lettre de \(\textsf{table}[c] = m\).
On en déduit alors la procédure complète suivante :
- on initialise la table avec une entrée pour chaque caractère, donc chaque octet, en considérant des caractères sur 8 bits.
- on maintient une variable \(c\) contenant le dernier code lu qu'on initialise avec le premier code en produisant le caractère correspondant.
- pour chaque code \(n\) :
- Soit \(n < |\textsf{table}|\) et \(\textsf{table}[n] = xm'\) où \(x\) est un caractère, alors on écrit \(xm'\) en sortie
- Soit \(n = |\textsf{table}|\) et alors on écrit en sortie \(\textsf{table}[c] x\) où \(x\) est le premier caractère de \(\textsf{table}[c]\)
- Dans tous les cas, on ajoute \(\textsf{table}[c] x\) à la table (si elle contient moins de \(2^d\) éléments), puis on remplace \(c \leftarrow n\).
Il y a un exemple classique où on a besoin de traiter ce cas : celui où le même
caractère est présent plusieurs fois en début de fichier. Comme LZW est utilisé
pour compresser des formats d'images où les pixels sont des indices dans une palette de
256 couleurs avec une couleur pour la transparence, le cas où la même couleur est présente
au début du fichier est fréquent. Voici ici un exemple de compression et de
décompression pour AAA :
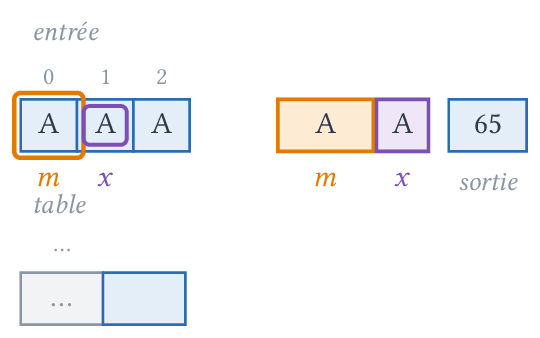
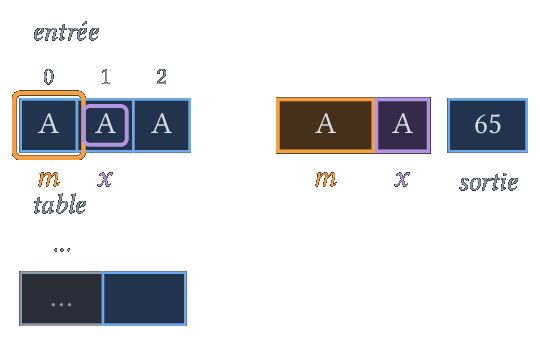
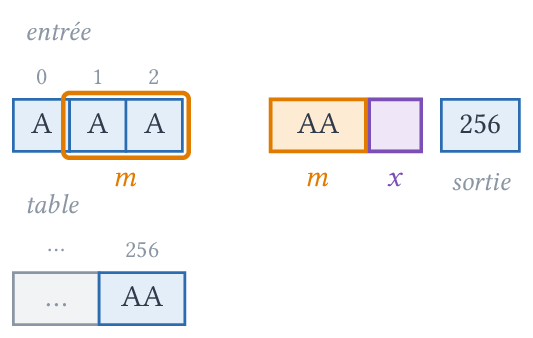
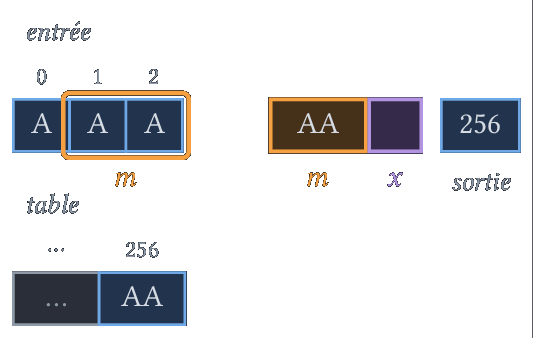
Remarque
On peut pousser un peu plus l'analyse précédente afin d'identifier précisément les situations menant à ces cas problématiques. Comme on vient de le voir, il est nécessaire que le texte à compresser contienne un motif de la forme \(x w x w x\) où \(w\) est un mot et \(x\) une lettre. Mais pour que le motif lu contienne \(x w\) au moment où on ajoute l'entrée \(x w x\) il faut que \(x w\) lui même soit dans la table, ce qui signifie que chaque préfixe de \(x w\) est également dans la table au moment où on commence à le lire, mais que si le motif précédent est \(w'\) alors \(w' x\) n'était pas dans la table.
On considère un mot \(w = a_1 \dots a_n\) où toutes les lettres sont distinctes, et on va essayer de construire un mot \(p\) tel que la compression de \(p\) permettra d'avoir \(a_1\), \(a_1 a_2\), \(a_1 a_2 a_3\), ..., \(a_1 \dots a_n\) dans la table.
Si on lit \(a_1 a_2\), on va ajouter \(a_1 a_2\) dans la table (\(a_1\) y étant déjà). On continue alors en partant de \(a_2\) comme motif, pour pouvoir ajouter \(a_1 a_2 a_3\) à la table, il faut lire \(a_1 a_2 a_3\) ensuite car à la lecture de \(a_1\), comme \(a_2 a_1\) n'est pas dans la table on l'ajoute et \(m\) devient \(a_1\), puis \(a_1 a_2\). Ainsi \(a_1 a_2 a_1 a_2 a_3\) va ajouter \(a_1, a_1 a_2, a_1 a_2 a_3\) dans la table. En continuant ainsi avec \(a_1 a_2 a_3 a_4\), comme \(a_3 a_1\) n'est pas dans la table, on va procéder de même.
Le mot \(p = a_1 a_2 a_1 a_2 a_3 a_1 a_2 a_3 a_4 \dots a_1 a_2 \dots a_n\) va donc permettre d'ajouter tous les préfixes de \(w\) dans la table.
Maintenant, pour obtenir le cas précédent, il suffit de lire le texte \(p w w a_1 x = p a_1 w_0 a_1 w_0 a_1 x\) où \(w_0 = a_2 \dots a_n\) et \(x\) n'est pas l'un des \(a_i\). En effet, on lit d'abord \(p\) ce qui permet d'ajouter tous les préfixes. Comme \(a_n a_1\) n'est pas dans la table, on continue avec \(a_1\) comme motif, on l'augmente jusqu'à lire \(a_1 w_0\) puis on ajoute une entrée pour \(a_1 w_0 a_1\) en ayant \(a_1\) comme motif, et là on va lire \(a_1 w_0 a_1 x\) et à la lecture de \(x\), produire le code de \(a_1 w_0 a_1\) qui est le dernier saisi dans la table.
Remarquons qu'on peut aussi ne considérer que \(p w w a_1\) dans la mesure où la fin du fichier provoquera aussi l'écriture du code.
Si on considère \(w=\)ABCD, on a \(p=\)ABABCABCD et on pourra ainsi compresser le texte
Après lecture de \(p\) on est dans la configuration suivante :
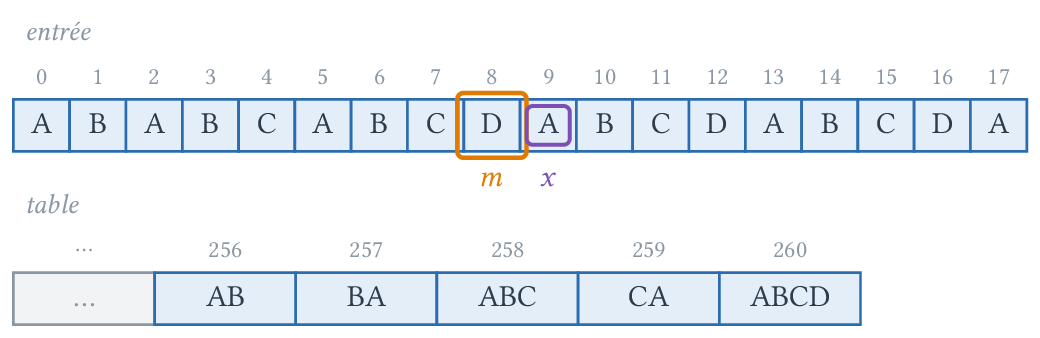
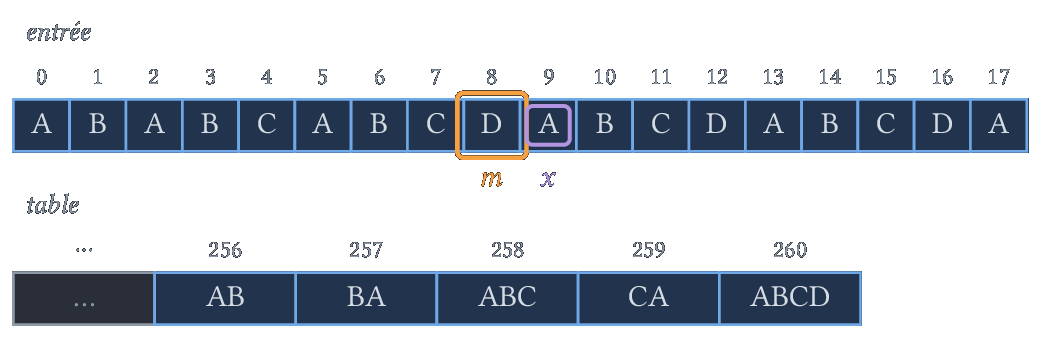
Puis après lecture de \(w A = A w_0 A\) :
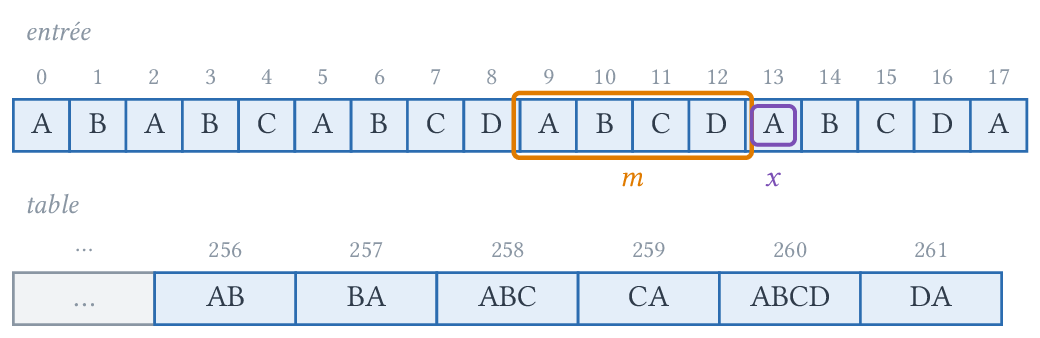
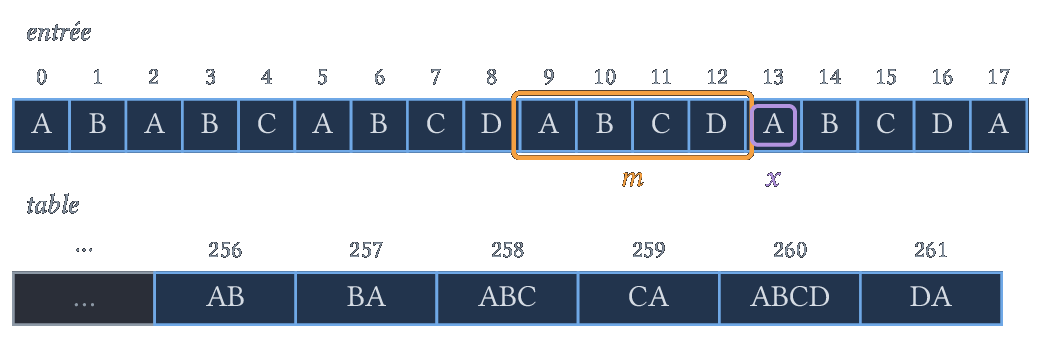
Enfin, la lecture du reste du texte va déclencher l'ajout de ABCDA dans la
table et l'écriture de son code.
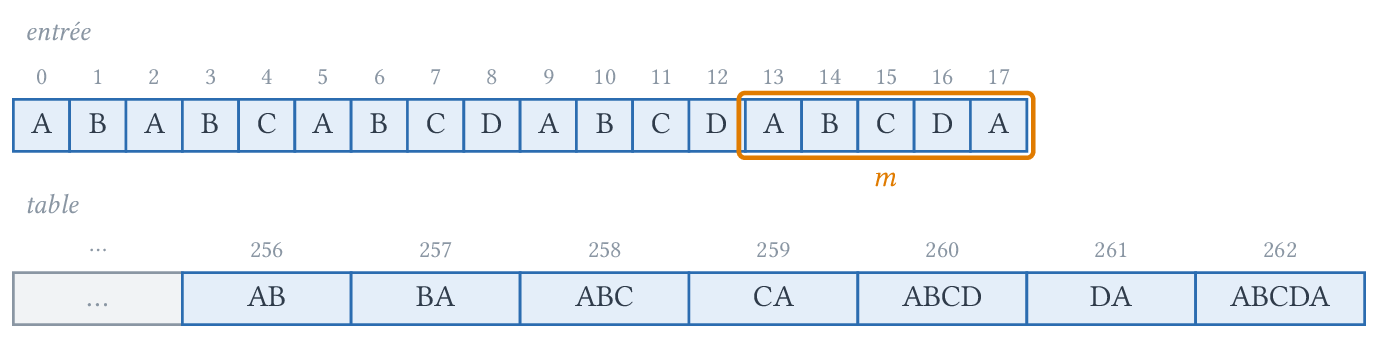
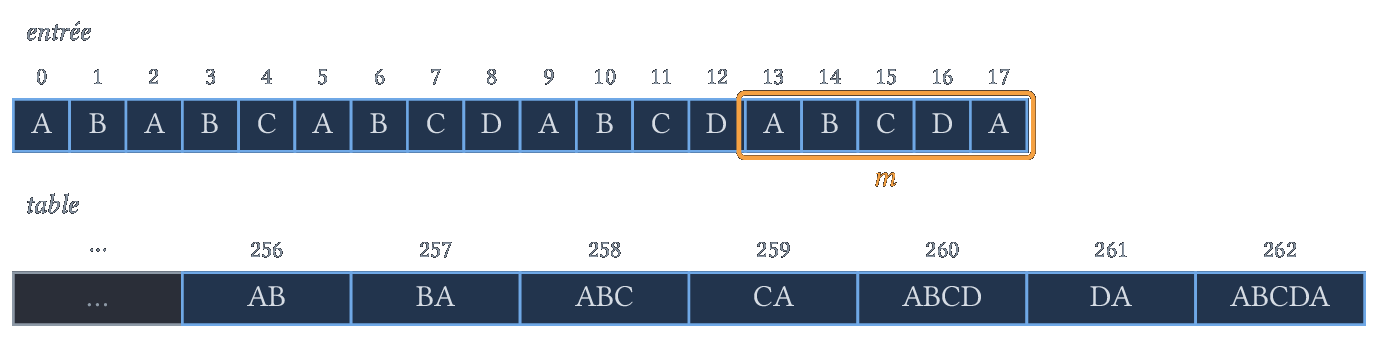
À la décompression, on produira bien le texte correspondant avec le principe présenté plus haut :
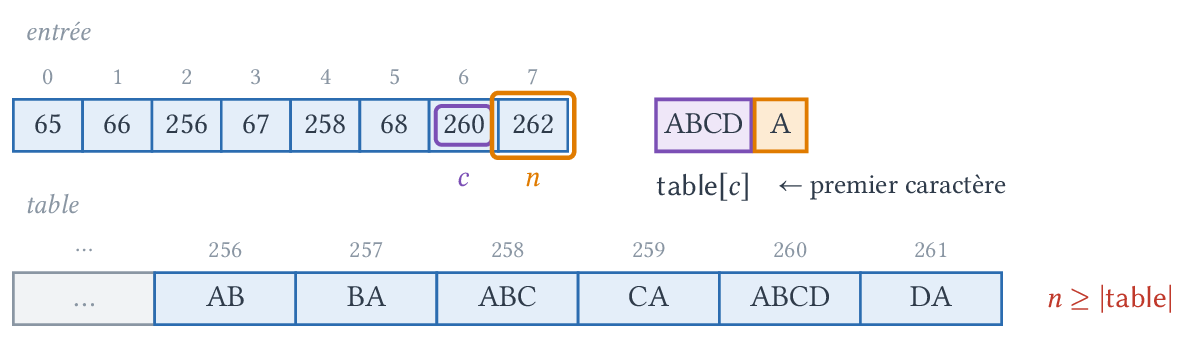
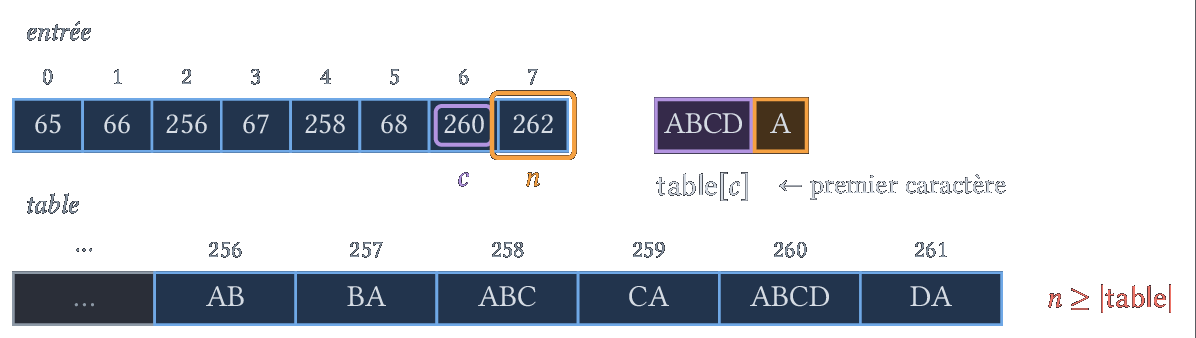
Implémentation
Avant de commencer à implémenter l'algorithme, il est nécessaire de définir des fonctions de manipulation des entiers sur d bits et de lecture/écriture dans un fichier.
Tout d'abord, on définit des fonctions d'écriture d'entiers sous forme codée sur d bits à l'aide des fonctions vues précédemment :
let input_code f longueur_code =
    let acc = ref 0 in
    for i = 0 to longueur_code - 1 do
        let b = input_bit f in
        if b
        then acc := !acc + (1 lsl i)
    done;
    !acc

let output_code f code longueur_code =
    assert (code < 1 lsl longueur_code);

    let acc = ref code in
    for i = 0 to longueur_code - 1 do
        output_bit f (!acc mod 2 = 1);
        acc := !acc / 2
    done
/* renvoie le code lu, ou -1 s'il n'y a plus de données */
int input_code(in_channel_bits *f, int longueur_code)
{
    int acc = 0;
    for (int i = 0; i < longueur_code; i++)
    {
        int b = input_bit(f);
        if (b < 0)
        {
            assert(i == 0); // pas au milieu d'un code
            return -1;
        }
        if (b)
            acc = acc + (1 << i);
    }
    return acc;
}

void output_code(out_channel_bits *f, int code, int longueur_code)
{
    assert(code < 1 << longueur_code);
    for (int i = 0; i < longueur_code; i++)
    {
        output_bit(f, code % 2 == 1);
        code = code / 2;
    }
}
def read_code(self, longueur_code):
    acc = 0
    for i in range(longueur_code):
        b = self.read_bit()
        if b == b'':
            assert(i == 0) # pas au milieu d'un code
            return None
        if b:
            acc += 1 << i
    return acc
def write_code(self, code, longueur_code):
    assert(code < 1 << longueur_code)
    for i in range(longueur_code):
        self.write_bit( code % 2 == 1 )
        code //= 2
On implémente alors assez directement la compression :
type table_bidir = {
    elements : string array;
    indices : (string, int) Hashtbl.t;
    mutable n_elements : int
}

let string_of_byte b = String.make 1 (Char.chr b)

let cree_table longueur_code =
    let taille_table = 1 lsl longueur_code in
    let elements = Array.make taille_table "" in
    let indices = Hashtbl.create taille_table in
    for i = 0 to 255 do
        let s = string_of_byte i in
        elements.(i) <- s;
        Hashtbl.add indices s i
    done;
    { elements = elements; indices =  indices; n_elements = 256 }

let ajoute_entree table s =
    table.elements.(table.n_elements) <- s;
    Hashtbl.add table.indices s table.n_elements;
    table.n_elements <- table.n_elements + 1

let compresse_fichier nom_in nom_out longueur_code =
    let table = cree_table longueur_code in
    let taille_table = 1 lsl longueur_code in
    let f_out = Bitpacking.open_out_bits nom_out in
    let f_in = open_in_bin nom_in in
    if in_channel_length f_in > 0 (* rien à écrire pour un fichier vide *)
    then begin
        let m = ref (string_of_byte (input_byte f_in)) in
        begin
          try
            while true do
                let c = string_of_byte (input_byte f_in) in
                let mc = !m ^ c in
                match Hashtbl.find_opt table.indices mc with
                | Some _ -> m := mc
                | None -> begin
                    let i = Hashtbl.find table.indices !m in
                    Bitpacking.output_code f_out i longueur_code;
                    if table.n_elements < taille_table
                    then ajoute_entree table mc;
                    m := c
                end
            done
          with End_of_file -> ()
        end;
        (* code final *)
        let i = Hashtbl.find table.indices !m in
        Bitpacking.output_code f_out i longueur_code
    end;
    close_in f_in;
    Bitpacking.close_out_bits f_out
def compresse_(nom_in, nom_out, longueur_code=12):
    table = [ bytes([c]) for c in range(256) ]
    indices = { bytes([c]) : c for c in range(256) }

    with open(nom_in, 'rb') as fin, \
            Bitpacking(nom_out, 'wb') as fout:
        m = fin.read(1)
        if m == b'': # fichier vide : rien à écrire
            return
        while True:
            c = fin.read(1)
            if c == b'': break
            if m+c in indices:
                m = m+c
            else:
                fout.write_code(indices[m], longueur_code)
                if len(table) < 1 << longueur_code:
                    indices[m+c] = len(table)
                    table.append(m+c)
                m = c

        # code final
        fout.write_code(indices[m], longueur_code)
/* En C, l'entrée mx de la table est représentée par le couple
 * (code de m, x) : prefixe[i] est le code de m (-1 pour les 256
 * premières entrées) et octet[i] le caractère x. La table de hachage
 * indices, à adressage ouvert, associe à un couple son code. */
struct table_lzw {
    int *prefixe;
    int *octet;
    int n_elements;
    int taille_table;  // 2^longueur_code
    int *indices;      // de taille 2 * taille_table, -1 si case vide
};
typedef struct table_lzw table_lzw;

table_lzw *cree_table(int longueur_code)
{
    table_lzw *t = malloc(sizeof(table_lzw));
    t->taille_table = 1 << longueur_code;
    t->prefixe = malloc(sizeof(int) * t->taille_table);
    t->octet = malloc(sizeof(int) * t->taille_table);
    t->indices = malloc(sizeof(int) * 2 * t->taille_table);
    for (int h = 0; h < 2 * t->taille_table; h++)
        t->indices[h] = -1;
    for (int i = 0; i < 256; i++)
    {
        t->prefixe[i] = -1;
        t->octet[i] = i;
    }
    t->n_elements = 256;
    return t;
}

void libere_table(table_lzw *t)
{
    free(t->prefixe);
    free(t->octet);
    free(t->indices);
    free(t);
}

/* case de indices où se trouve, ou devrait se trouver, le couple (m,x) */
int case_hachage(table_lzw *t, int m, int x)
{
    int h = (m * 256 + x) % (2 * t->taille_table);
    while (t->indices[h] >= 0
            && (t->prefixe[t->indices[h]] != m || t->octet[t->indices[h]] != x))
        h = (h + 1) % (2 * t->taille_table);
    return h;
}

/* code de l'entrée mx, ou -1 si elle est absente */
int cherche(table_lzw *t, int m, int x)
{
    return t->indices[case_hachage(t, m, x)];
}

void ajoute_entree(table_lzw *t, int m, int x)
{
    int i = t->n_elements;
    t->prefixe[i] = m;
    t->octet[i] = x;
    t->indices[case_hachage(t, m, x)] = i;
    t->n_elements++;
}

void compresse_fichier(const char *nom_in, const char *nom_out, int longueur_code)
{
    table_lzw *table = cree_table(longueur_code);
    out_channel_bits *f_out = open_out_bits(nom_out);
    FILE *f_in = fopen(nom_in, "rb");
    assert(f_in != NULL);
    int m = fgetc(f_in); // code du motif courant

    if (m != EOF) // rien à écrire pour un fichier vide
    {
        int c;
        while ((c = fgetc(f_in)) != EOF)
        {
            int mc = cherche(table, m, c);
            if (mc >= 0)
                m = mc;
            else {
                output_code(f_out, m, longueur_code);
                if (table->n_elements < table->taille_table)
                    ajoute_entree(table, m, c);
                m = c;
            }
        }
        output_code(f_out, m, longueur_code); // code final
    }

    fclose(f_in);
    close_out_bits(f_out);
    libere_table(table);
}
Et on procède de même pour la décompression :
let decompresse_fichier nom_in nom_out longueur_code =
    let table = cree_table longueur_code in
    let taille_table = 1 lsl longueur_code in
    let f_in = Bitpacking.open_in_bits nom_in in
    let f_out = open_out_bin nom_out in
    begin
       try (* End_of_file dès ici pour un fichier vide *)
          let code = ref (Bitpacking.input_code f_in longueur_code) in
          output_string f_out table.elements.(!code);
          while true do
              let nouveau = Bitpacking.input_code f_in longueur_code in
              let s_code = table.elements.(!code) in
              let s =
                  if nouveau = table.n_elements
                  then let x = String.sub s_code 0 1
                       in s_code ^ x
                  else table.elements.(nouveau) in
              let x = String.sub s 0 1 in
              output_string f_out s;
              if table.n_elements < taille_table
              then ajoute_entree table (s_code ^ x);
              code := nouveau
        done
      with End_of_file -> ()
    end;
    Bitpacking.close_in_bits f_in;
    close_out f_out
def decompresse_(nom_in, nom_out, longueur_code=12):
    table = [ bytes([c]) for c in range(256) ]

    with Bitpacking(nom_in, 'rb') as fin, \
            open(nom_out, 'wb') as fout:

        code = fin.read_code(longueur_code)
        if code is None: # fichier vide
            return
        fout.write(table[code])

        while True:
            nouveau = fin.read_code(longueur_code)
            if nouveau is None:
                break

            if len(table) == nouveau:
                x = table[code][0:1] # car bytes
                s = table[code]+x
            else:
                s = table[nouveau]
                x = s[0:1] # car bytes
            fout.write(s)
            if len(table) < 1 << longueur_code:
               table.append(table[code]+x)
            code = nouveau
/* écrit dans f le motif d'indice i et renvoie son premier caractère.
 * tampon, de taille taille_table, contient au moins la longueur du motif */
int ecrit_entree(FILE *f, table_lzw *t, int i, unsigned char *tampon)
{
    int k = t->taille_table;
    // on remonte les préfixes en remplissant le tampon par la fin
    while (i >= 0)
    {
        k--;
        tampon[k] = t->octet[i];
        i = t->prefixe[i];
    }
    fwrite(tampon + k, 1, t->taille_table - k, f);
    return tampon[k];
}

void decompresse_fichier(const char *nom_in, const char *nom_out, int longueur_code)
{
    table_lzw *table = cree_table(longueur_code);
    unsigned char *tampon = malloc(table->taille_table);
    in_channel_bits *f_in = open_in_bits(nom_in);
    FILE *f_out = fopen(nom_out, "wb");
    assert(f_out != NULL);
    int code = input_code(f_in, longueur_code);

    if (code >= 0) // sinon fichier vide
    {
        ecrit_entree(f_out, table, code, tampon);
        int nouveau;
        while ((nouveau = input_code(f_in, longueur_code)) >= 0)
        {
            int x;
            if (nouveau == table->n_elements)
            {   // on écrit table[code] suivi de son premier caractère
                x = ecrit_entree(f_out, table, code, tampon);
                fputc(x, f_out);
            } else
                x = ecrit_entree(f_out, table, nouveau, tampon);
            if (table->n_elements < table->taille_table)
                ajoute_entree(table, code, x);
            code = nouveau;
        }
    }

    close_in_bits(f_in);
    fclose(f_out);
    free(tampon);
    libere_table(table);
}
Remarque
Pour un fichier vide, il n'y a pas de motif courant initial : la compression n'écrit aucun code et le fichier compressé se réduit à l'octet final de padding. La décompression détecte alors la fin des données dès la lecture du premier code et produit un fichier vide.
Dans la version C, un motif n'est pas stocké comme une chaîne mais comme le couple formé du code de son préfixe et de son dernier caractère. Cela évite de recopier des chaînes et de devoir hacher des chaînes de longueur quelconque ; en contrepartie, la décompression doit remonter la chaîne des préfixes pour écrire un motif. On remarque qu'un motif de la table d'indice \(i \ge 256\) est de longueur au plus \(i - 254\), ce qui justifie la taille du tampon.
Impact de la longueur du code
Afin d'étudier l'impact de la longueur du code sur la taille des fichiers compressés, on considère deux fichiers :
proust.txtcontenant, en 7543768 octets, l'intégrale de à la recherche du temps perdu de Marcel Proustcode.pycontenant 8566 octets de code source Python
On note np la taille en nombre d'octets après compression du fichier
proust.txt et tp le nombre d'entrées dans la table à la fin du processus.
De même, on note nc et tc les valeurs respectives pour le fichier code.py.
On obtient alors les valeurs suivantes en fonction du nombre d de bits du code :
| d | np | nc | tp | tc |
|---|---|---|---|---|
| 8 | 7543768 | 8566 | 256 | 256 |
| 9 | 5056398 | 5709 | 512 | 512 |
| 10 | 4195124 | 4431 | 1024 | 1024 |
| 11 | 3864174 | 3948 | 2048 | 2048 |
| 12 | 3612505 | 4039 | 4096 | 2947 |
| 13 | 3434424 | 4376 | 8192 | 2947 |
| 14 | 3262145 | 4712 | 16384 | 2947 |
| 15 | 3131790 | 5049 | 32768 | 2947 |
| 16 | 2998639 | 5385 | 65536 | 2947 |
| 17 | 2682264 | 5722 | 131072 | 2947 |
| 18 | 2554323 | 6058 | 262144 | 2947 |
| 19 | 2500314 | 6395 | 524288 | 2947 |
| 20 | 2557656 | 6731 | 1023317 | 2947 |
On constate qu'il est nécessaire d'avoir un texte riche pour bénéficier d'une
grande longueur de code. Le fichier code.py ne contenant pas plus que 2947
motifs. Même si le fichier proust.txt en contient plus que les tailles
considérées ici, il y a un compromis qui s'établit entre la richesse de la
table et la taille du code. Ainsi, il semble que le fichier proust.txt soit
compressé de manière optimale avec un code de longueur 19.
Problèmes supplémentaires
Transformation de Burrows-Wheeler
La transformation de Burrows-Wheeler (1994) ne compresse pas : elle permute
les lettres d'un texte de façon réversible, en sorte que le résultat contienne
de longues plages de lettres identiques, qu'il est ensuite facile de
compresser. C'est la première étape de l'outil bzip2.
On considère un mot \(u\) de longueur \(n\) qui se termine par un caractère
spécial $, présent une seule fois et plus petit que toutes les autres
lettres. On écrit les \(n\) rotations de \(u\), c'est-à-dire les mots \(vw\) tels que
\(u = wv\), et on les trie dans l'ordre lexicographique. La transformée
\(\textsf{BWT}(u)\) est le mot formé des dernières lettres de ces rotations
triées.
Exemple
Pour \(u\) = ananas$, on obtient les rotations triées suivantes, où l'on
note \(F\) la première colonne et \(L\) la dernière :
| ligne | rotation | \(F\) | \(L\) |
|---|---|---|---|
| 0 | $ananas |
$ |
s |
| 1 | ananas$ |
a |
$ |
| 2 | anas$an |
a |
n |
| 3 | as$anan |
a |
n |
| 4 | nanas$a |
n |
a |
| 5 | nas$ana |
n |
a |
| 6 | s$anana |
s |
a |
On a donc \(\textsf{BWT}(u)\) = s$nnaaa. Les lettres égales ont été
regroupées : la dernière lettre d'une ligne est celle qui précède, dans
\(u\), le début de la ligne. Les lignes étant triées selon ce qui suit, des
contextes semblables, comme an ou as dans un texte en français, se
retrouvent côte à côte et sont souvent précédés de la même lettre.
Une fois cette transformation effectuée, on applique typiquement le codage move to front présenté au paragraphe suivant, qui transforme les plages de lettres identiques en suites de petits entiers, puis un codage de Huffman.
Le point remarquable est que l'on peut retrouver \(u\) à partir de \(L\) seul. Tout d'abord, \(F\) s'obtient en triant les lettres de \(L\). Ensuite, chaque ligne est une rotation : \(L_i\) est la lettre qui précède \(F_i\) dans \(u\), vu de manière circulaire. Il reste à savoir, pour une lettre \(L_i\), sur quelle ligne elle se trouve en première position.
Propriété
Pour toute lettre \(c\), la \(k\)-ième occurrence de \(c\) dans \(L\) et la \(k\)-ième occurrence de \(c\) dans \(F\) correspondent à la même position dans \(u\).
Preuve
Les lignes qui se terminent par \(c\) sont de la forme \(xc\) et les faire
tourner d'un cran donne les lignes \(cx\) qui commencent par \(c\). Or, pour
deux mots \(x \neq y\) de même longueur, \(xc < yc \iff x < y \iff cx < cy\).
Les lignes \(xc\) sont distinctes, car la lettre $ n'apparaît qu'une fois,
donc les deux familles de lignes sont rangées dans le même ordre.
On en déduit la fonction \(\textsf{LF}\) qui à la ligne \(i\) associe la ligne
commençant par la lettre \(L_i\) considérée. Comme $ est minimal, la ligne
\(0\) commence par $ : \(L_0\) est donc la dernière lettre de \(u\) avant $. La
lettre précédente est \(L_{\textsf{LF}(0)}\), puis
\(L_{\textsf{LF}(\textsf{LF}(0))}\), et ainsi de suite : on reconstruit \(u\) de
droite à gauche.
Exemple
Avec \(L\) = s$nnaaa, on part de la ligne \(0\) : \(L_0\) = s, première
occurrence de s dans \(L\), donc on passe à la ligne de la première
occurrence de s dans \(F\), la ligne \(6\). Ensuite \(L_6\) = a, troisième
a de \(L\), d'où la ligne \(3\), puis \(L_3\) = n, deuxième n, d'où la
ligne \(5\), et ainsi de suite. On lit successivement s, a, n, a,
n, a et on retrouve ananas$.
Un tri stable des indices de \(L\) selon leur lettre donne directement la correspondance entre les occurrences de \(L\) et celles de \(F\). Les implémentations suivantes sont volontairement naïves pour la transformation, qui trie explicitement les \(n\) rotations :
let bwt (u:string) : string =
    (* u doit finir par un unique caractère '$' plus petit que les autres *)
    let n = String.length u in
    let rotation i = String.sub u i (n-i) ^ String.sub u 0 i in
    let rotations = Array.init n rotation in
    Array.sort compare rotations;
    String.init n (fun r -> rotations.(r).[n-1])

let inverse_bwt (l:string) : string =
    let n = String.length l in
    (* ordre.(r) : indice dans l de la lettre en position r de la première
       colonne, le tri stable conservant l'ordre des lettres égales *)
    let ordre = Array.init n (fun i -> i) in
    Array.stable_sort (fun i j -> compare l.[i] l.[j]) ordre;
    let lf = Array.make n 0 in
    Array.iteri (fun r i -> lf.(i) <- r) ordre;
    let lettres = Bytes.make n '$' in
    let i = ref 0 in (* la ligne 0 commence par '$' *)
    for k = n-2 downto 0 do
        Bytes.set lettres k l.[!i]; (* lettre qui précède la ligne i *)
        i := lf.(!i)
    done;
    Bytes.to_string lettres
def bwt(u):
    '''Transformée de Burrows-Wheeler de u, qui doit finir par
    un unique caractère $ plus petit que les autres'''
    n = len(u)
    rotations = sorted(u[i:] + u[:i] for i in range(n))
    return ''.join(r[n-1] for r in rotations)

def inverse_bwt(l):
    n = len(l)
    # ordre[r] : indice dans l de la lettre en position r de la
    # première colonne, le tri étant stable
    ordre = sorted(range(n), key=lambda i: l[i])
    lf = [ 0 ] * n
    for r in range(n):
        lf[ordre[r]] = r
    lettres = []
    i = 0 # la ligne 0 commence par $
    for _ in range(n-1):
        lettres.append(l[i]) # lettre qui précède la première de la ligne i
        i = lf[i]
    return ''.join(reversed(lettres)) + '$'
Remarque
Trier explicitement les rotations coûte \(O(n^2 \log n)\) comparaisons de caractères dans le pire cas. En pratique, on obtient l'ordre des rotations en temps linéaire à l'aide d'une table des suffixes, ce qui dépasse le cadre de ce cours. L'inversion, elle, se fait ici en \(O(n \log n)\), et même en \(O(n)\) avec un tri par comptage puisque l'alphabet est fini.
Move to front
La structure de données corde
L'algorithme de Knuth-Morris-Pratt
L'algorithme naïf oublie tout ce qu'il a lu dès qu'une comparaison échoue et recommence à la position suivante. L'algorithme de Knuth-Morris-Pratt (1977) lit la chaîne de gauche à droite, sans jamais revenir en arrière dans la chaîne, en exploitant ce qu'on sait déjà : après avoir reconnu un préfixe du motif, la seule information utile est la structure de ce préfixe, qu'on précalcule. On obtient ainsi une complexité en pire cas en \(O(n+p)\), ce qu'on avait seulement admis pour Boyer-Moore.
Cette partie reprend les notations du TP Knuth-Morris-Pratt, où l'on programme en OCaml le calcul des bords présenté ci-dessous.
Bords maximaux
On rappelle qu'un bord d'un mot \(u\) est un mot qui est à la fois préfixe et suffixe propre de \(u\). Le mot vide \(\mu\) est un bord de tout mot non vide.
Définition
Le bord maximal d'un mot non vide \(u\) est son bord de longueur maximale, on le note \(\beta(u)\).
Pour un motif \(m = m_0 \dots m_{p-1}\) et \(i \in \range{1}{p}\), on note \(\ell_i = |\beta(m_0 \dots m_{i-1})|\) la longueur du bord maximal du préfixe de longueur \(i\), et on pose par convention \(\ell_0 = 0\).
Un bord de \(u\) étant un préfixe de \(u\), il est caractérisé par sa longueur : c'est pour cela qu'on ne manipule que des longueurs.
Exemple
Pour \(m = abacabab\), on obtient :
| \(i\) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| \(\ell_i\) | 0 | 0 | 0 | 1 | 0 | 1 | 2 | 3 | 2 |
Par exemple, \(\beta(abacaba) = aba\) et \(\beta(abacabab) = ab\).
Lemme
Soit \(u\) un mot non vide. Les bords de \(u\) sont exactement les mots \(\beta(u), \beta^2(u), \dots, \beta^r(u) = \mu\) où \(r\) est le premier entier tel que \(\beta^r(u) = \mu\).
Preuve
La suite des longueurs \(|\beta^k(u)|\) est strictement décroissante tant que \(\beta^k(u) \neq \mu\), donc \(r\) existe.
Si \(v\) est un bord de \(u\) et \(w\) un mot plus court que \(v\), alors \(w\) est un bord de \(u\) si et seulement si \(w\) est un bord de \(v\). En effet, \(w\) et \(v\) sont tous deux préfixes de \(u\), donc \(w\) est préfixe de \(u\) si et seulement si il est préfixe de \(v\). De même pour les suffixes.
Par récurrence, chaque \(\beta^k(u)\) est un bord de \(u\) : c'est un bord de \(\beta^{k-1}(u)\), plus court, donc un bord de \(u\). Réciproquement, soit \(w\) un bord de \(u\) et \(k\) maximal tel que \(|w| \le |\beta^k(u)|\) (on a \(|w| \le |\beta(u)|\) par maximalité de \(\beta(u)\)). Si \(w \neq \beta^k(u)\), alors \(w\) est plus court que \(\beta^k(u)\) donc est un bord de \(\beta^k(u)\), d'où \(|w| \le |\beta^{k+1}(u)|\), ce qui contredit la maximalité de \(k\). Donc \(w = \beta^k(u)\).
Ainsi, les longueurs des bords du préfixe \(m_0 \dots m_{i-1}\) sont \(\ell_i, \ell_{\ell_i}, \ell_{\ell_{\ell_i}}, \dots, 0\) : le tableau des \(\ell_i\) contient toute l'information sur les bords de tous les préfixes.
Théorème
Soit \(i \in \range{1}{p-1}\) et \(v = m_0 \dots m_{i-1}\). Les bords non vides de \(v m_i\) sont exactement les mots \(w m_i\) où \(w\) est un bord de \(v\) tel que \(m_{|w|} = m_i\).
Ainsi, \(\ell_{i+1} = 1 + k\) où \(k\) est le plus grand élément de \(\{ \ell_i, \ell_{\ell_i}, \dots, 0 \}\) tel que \(m_k = m_i\), et \(\ell_{i+1} = 0\) s'il n'en existe pas.
Preuve
Soit \(z\) un bord non vide de \(v m_i\). Comme \(z\) est un suffixe non vide, il s'écrit \(z = w m_i\) avec \(w\) suffixe de \(v\). Comme \(z\) est un préfixe propre de \(v m_i\), on a \(|z| \le |v|\) donc \(z\) est un préfixe de \(v\) : on a \(w = m_0 \dots m_{|w|-1}\) et \(m_{|w|} = m_i\). Enfin \(|w| < |z| \le |v|\) donc \(w\) est un préfixe et un suffixe propre de \(v\), c'est-à-dire un bord.
Réciproquement, si \(w\) est un bord de \(v\) avec \(m_{|w|} = m_i\), alors \(w m_i = m_0 \dots m_{|w|}\) est un préfixe de \(v m_i\), c'est un suffixe de \(v m_i\) car \(w\) est suffixe de \(v\), et il est propre car \(|w| < |v|\).
La formule s'en déduit avec le lemme précédent, qui énumère les longueurs des bords de \(v\) par ordre décroissant.
On en déduit le calcul du tableau \([\ell_0, \dots, \ell_p]\) par la fonction
bords_maximaux_prefixes : pour chaque \(i\), on essaie les longueurs de bords
\(k = \ell_i, \ell_{\ell_i}, \dots\) jusqu'à trouver \(m_k = m_i\) ou atteindre
\(0\). L'implémentation OCaml fait l'objet du TP ; on donne ici les versions C et
Python (cette dernière est celle de l'énoncé du TP) :
/* renvoie le tableau [l_0, ..., l_n] des longueurs des bords maximaux
 * des préfixes de mot ; il a été alloué et devra être libéré */
int *bords_maximaux_prefixes(char *mot)
{
    int n = strlen(mot);
    int *longueurs = malloc(sizeof(int) * (n + 1));

    for (int i = 0; i <= n; i++)
        longueurs[i] = 0;

    for (int i = 1; i < n; i++)
    {
        int k = longueurs[i];
        while (mot[k] != mot[i] && k > 0)
            k = longueurs[k];
        if (mot[k] == mot[i])
            longueurs[i+1] = k + 1;
    }

    return longueurs;
}
def bords_maximaux_prefixes(mot):
    """Calcule la liste des longueurs des bords maximaux
    des préfixes d'un mot."""
    n = len(mot)
    longueurs = [0] * (n + 1)
    for i in range(1, n):
        k = longueurs[i]
        while mot[k] != mot[i] and k > 0:
            k = longueurs[k]
        if mot[k] == mot[i]:
            longueurs[i + 1] = k + 1
    return longueurs
Propriété
bords_maximaux_prefixes effectue \(O(p)\) opérations sur un mot de
longueur \(p\).
Preuve
On utilise une analyse amortie en suivant la valeur de \(k\). Au début de
l'itération \(i\), on a \(k = \ell_i\). Chaque passage dans la boucle while
diminue strictement \(k\), car \(\ell_k < k\), et à la fin de l'itération
\(\ell_{i+1} \le k + 1\). En notant \(t_i\) le nombre de passages dans la
boucle while lors de l'itération \(i\), on a donc
\(\ell_{i+1} \le \ell_i - t_i + 1\), soit \(t_i \le \ell_i - \ell_{i+1} + 1\).
En sommant, le nombre total de passages est majoré par
car la somme est télescopique et \(\ell_1 = 0\). Chaque itération de la
boucle for effectue par ailleurs un nombre constant d'opérations.
Recherche
La recherche procède exactement de la même manière, en lisant la chaîne \(s = s_0 \dots s_{n-1}\) de gauche à droite. On maintient la longueur \(k\) du plus long préfixe du motif qui soit suffixe de la partie lue \(s_0 \dots s_{j-1}\). À la lecture de \(s_j\), on cherche à prolonger ce préfixe : si \(m_k \neq s_j\), on essaie le bord maximal de \(m_0 \dots m_{k-1}\), de longueur \(\ell_k\), et ainsi de suite. Si on atteint \(k = p\), le motif est trouvé à l'indice \(j - p + 1\).
exception Trouve of int

let recherche_KMP (motif:string) (bords:int array)
    (chaine:string) : int option =
    let n = String.length chaine in
    let p = String.length motif in
    let k = ref 0 in (* longueur du préfixe du motif reconnu *)
    try
        if p = 0 then raise (Trouve 0);
        for j = 0 to n-1 do
            while !k > 0 && motif.[!k] <> chaine.[j] do
                k := bords.(!k)
            done;
            if motif.[!k] = chaine.[j] then incr k;
            if !k = p then raise (Trouve (j-p+1))
        done;
        None
    with Trouve i -> Some i
/* cherche motif dans chaine en utilisant le tableau bords renvoyé par
 * bords_maximaux_prefixes(motif). Renvoie l'indice de la première
 * occurrence ou -1 s'il n'est pas présent */
int recherche_KMP(char *motif, int *bords, char *chaine)
{
    int n = strlen(chaine);
    int p = strlen(motif);
    int k = 0; // longueur du préfixe du motif reconnu

    if (p == 0)
        return 0;

    for (int j = 0; j < n; j++)
    {
        while (k > 0 && motif[k] != chaine[j])
            k = bords[k];
        if (motif[k] == chaine[j])
            k++;
        if (k == p)
            return j - p + 1;
    }

    return -1;
}
def recherche_KMP(motif, bords, chaine):
    '''Cherche motif dans chaine en utilisant le tableau bords
    renvoyé par bords_maximaux_prefixes(motif)'''
    n, p = len(chaine), len(motif)
    if p == 0:
        return 0
    k = 0 # longueur du préfixe du motif reconnu
    for j in range(n):
        while k > 0 and motif[k] != chaine[j]:
            k = bords[k]
        if motif[k] == chaine[j]:
            k = k + 1
        if k == p:
            return j - p + 1
    return None
La correction repose sur le même raisonnement que le théorème précédent : les préfixes du motif qui sont suffixes de \(s_0 \dots s_{j-1}\) sont exactement \(m_0 \dots m_{k-1}\) et ses bords, car deux suffixes d'un même mot dont l'un est plus court sont suffixes l'un de l'autre. Le plus long préfixe du motif suffixe de \(s_0 \dots s_j\) est alors de la forme \(w s_j\) où \(w\) est le plus long de ces mots tel que \(m_{|w|} = s_j\), et c'est bien celui que l'on trouve en essayant les bords par longueur décroissante.
L'analyse amortie est identique : \(k\) augmente d'au plus \(1\) à chaque
itération de la boucle for et diminue strictement à chaque passage dans la
boucle while, il y a donc au plus \(n\) passages dans celle-ci au total. La
recherche est en \(O(n)\), et en comptant le prétraitement du motif,
l'algorithme de Knuth-Morris-Pratt est en \(O(n+p)\) dans le pire cas.
Remarque
- Contrairement à Boyer-Moore, Knuth-Morris-Pratt n'effectue jamais de saut dans la chaîne : chaque caractère de \(s\) est lu une seule fois, au sens où on ne revient jamais en arrière. Comme pour la variante de Rabin-Karp sans vérification, on peut donc l'appliquer à un flux de données. En revanche, sur un texte usuel, Boyer-Moore est souvent plus rapide car il ne lit qu'une partie des caractères.
- Le TP Knuth-Morris-Pratt propose une autre façon d'utiliser le tableau des bords pour la recherche, ainsi que d'autres applications (mots primitifs, préfixes palindromes).
- La valeur \(k\) maintenue pendant la recherche est l'état d'un automate déterministe reconnaissant les mots qui se terminent par le motif, d'ensemble d'états \(\range{0}{p}\). Les transitions sont calculées à la volée à l'aide du tableau des bords plutôt que stockées dans une table de taille \((p+1)|\Sigma|\) (voir le chapitre Langages réguliers et automates).