Note
Une grande partie est issue verbatim de mon ancien poly. À affiner.
Graphes orientés
Définition
Définition
Un graphe orienté est un couple \(G = (S, A)\) où \(S\) est un ensemble fini et \(A\) est une relation irréflexive sur \(S\), c'est-à-dire \(A \subset \{ (x,y) ~|~ x,y \in S, x \neq y\}\).
Les éléments de \(S\) sont appelés les sommets du graphe \(G\) et les éléments de \(A\) les arêtes. Si \((x,y) \in A\), on dit que \(x\) est la source de l'arête et \(y\) est son but. Quand le contexte n'est pas ambigu, on notera \(x \rightarrow y\).
Exemple
- \(G = ( \{ a, b, c \}, \{ (a, b), (b, c), (c, b) \} )\)
- \(D_n = ( \range{1}{n}, \{ (a,b) ~|~ a \text{ divise } b, a \neq b \} )\)
Remarque
Ici, on a exclu les graphes infinis ainsi que les graphes avec des boucles ou des arêtes parallèles. On est dans le contexte des graphes finis simples.
On représente graphiquement un graphe sous la forme d'un diagramme sagittaire où les sommets sont des points et où une arête \((a,b)\) est une flèche allant du point \(a\) au point \(b\).
Exemple
-
\(G\) est représenté par
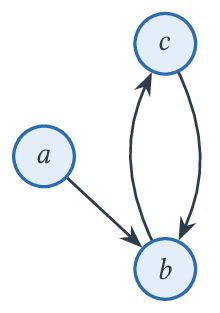
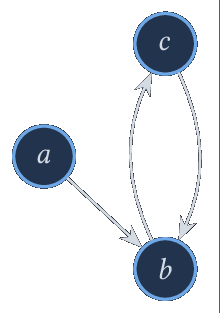
Diagramme sagittaire du graphe \(G\) : arêtes \(a \rightarrow b\), \(b \rightarrow c\) et \(c \rightarrow b\). -
\(D_{10}\) est représenté par
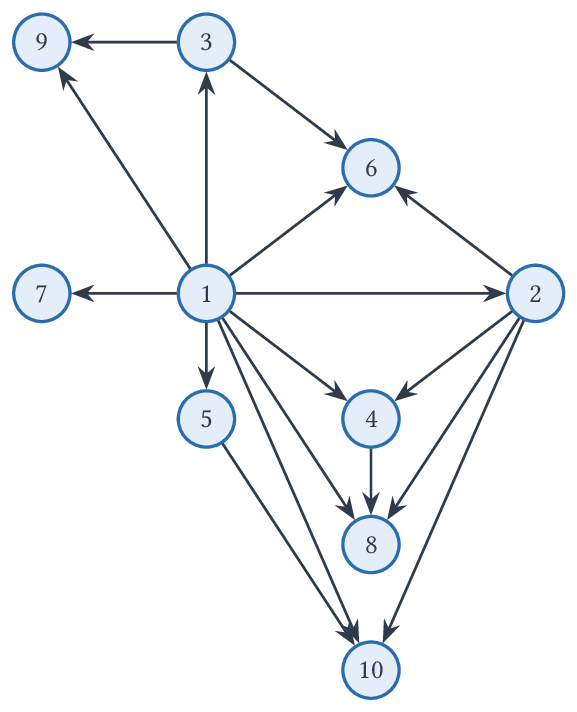
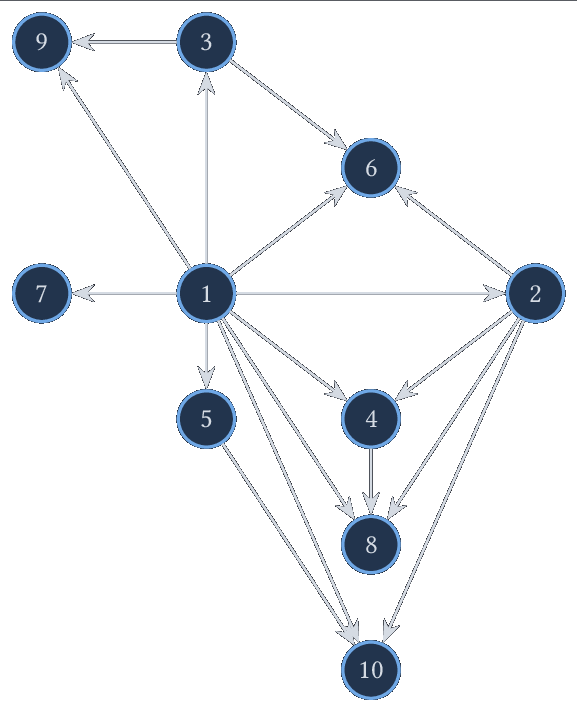
Graphe \(D_{10}\) : une flèche \(x \rightarrow y\) quand \(x\) divise strictement \(y\).
Voisins et degrés
Définition
Soit \(G = (S, A)\) un graphe orienté et \(x \in S\).
On appelle voisins sortants, ou successeurs, de \(x\) les éléments de
et on appelle degré sortant de \(x\) le cardinal de cet ensemble \(d_+(x) = |v_+(x)|\).
De même, on parle de voisins entrants, ou prédécesseurs pour les éléments de
et on parle de degré entrant pour \(d_-(x) = |v_-(x)|\).
Théorème
Soit \(G = (S, A)\) un graphe, on a \(\sum_{x \in S} d_+(x) = \sum_{x \in S} d_-(x) = |A|\)
Preuve
On peut partitionner \(A\) en regroupant les arêtes de même source, on a ainsi :
Cette réunion étant disjointe, en prenant le cardinal de cette égalité, on obtient directement \(|A| = \sum_{x \in S} d_+(x)\). L'autre égalité est symétrique en considérant les arêtes de même but.
Chemin
Définition
Soit \(G = (S,A)\) un graphe orienté et \(x, y \in S\).
Une suite finie \(\varphi = (s_0, s_1, \dots, s_p)\) où \(p \in \N, s_0 = x, s_p = y\) et
est appelée un chemin, de longueur \(p\), de \(x\) vers \(y\). On a donc
On notera \(\varphi : x \leadsto y\) pour signifier que \(\varphi\) est un tel chemin et \(x \leadsto y\) pour signifier qu'il existe un chemin de \(x\) vers \(y\). On dit alors que \(y\) est accessible depuis \(x\).
Théorème
\(\leadsto\) est la plus petite relation sur \(S\) contenant \(\rightarrow\) et qui soit réflexive et transitive.
Preuve
Montrons d'abord que \(\leadsto\) convient. Le chemin \((x)\) de longueur \(0\) donne \(x \leadsto x\), donc \(\leadsto\) est réflexive. Si \(x \rightarrow y\), le chemin \((x, y)\) donne \(x \leadsto y\), donc \(\rightarrow \subset \leadsto\). Enfin, si \(\varphi : x \leadsto y\) et \(\psi : y \leadsto z\), la concaténation de \(\varphi\) et \(\psi\) (en ne répétant pas \(y\)) est un chemin de \(x\) à \(z\), donc \(\leadsto\) est transitive.
Réciproquement, on considère \(\rightarrow \subset R \subset S^2\) telle que \(R\) soit réflexive et transitive.
Soient \(x, y \in S\) et \(\varphi = (s_0, \dots, s_p) : x \leadsto y\).
Si \(p = 0\), \(x = y\) et \(x R y\) par réflexivité. Sinon, comme \(s_{i-1} \rightarrow s_i\) on a \(s_{i-1} R s_i\) pour tout \(i \in \range{1}{p}\) et, par transitivité, \(x = s_0 R s_p = y\). Donc \(x \leadsto y \Rightarrow x R y\).
Ainsi \(\leadsto \subset R\).
On dit que \(\leadsto\) est la fermeture réflexive et transitive de \(\rightarrow\).
Remarque
Vocabulaire additionnel :
- Si tous les sommets sont distincts, sauf éventuellement le premier et le dernier, on dit que le chemin est élémentaire.
- Si toutes les arêtes sont distinctes, on dit que le chemin est simple.
- Si \(x = y\), on dit que le chemin est fermé.
- Un chemin simple dont tous les sommets sont distincts est appelé une chaîne.
- Un chemin élémentaire fermé simple de longueur au moins 1 est appelé un cycle. Comme le chemin vide issu de \(x\) est fermé, il est nécessaire de considérer des chemins non vides.
- Un graphe contenant au moins un cycle est dit cyclique. Dans le cas contraire, on dit qu'il est acyclique.
Remarque
Si \(\varphi : x \leadsto y\) et \(\psi : y \leadsto z\) on note \(\varphi \psi :x \leadsto z\) la concaténée des deux chemins.
Définition
On note \(\leftrightarrow\) la plus grande relation d'équivalence incluse dans \(\leadsto\).
Plus précisément, on a
Les classes d'équivalence pour \(\leftrightarrow\) sont appelées les composantes fortement connexes du graphe. S'il n'y a qu'une classe, on dit que le graphe est fortement connexe.
Sous-graphe
Définition
Soit \(G = (S,A)\) et \(X \subset S\). On appelle sous-graphe induit par \(X\) le graphe \((X, A_X)\) où
Un graphe \(G'\) est un sous-graphe de \(G\) quand c'est le sous-graphe de \(G\) induit par les sommets de \(G'\) (ils sont alors nécessairement des sommets de \(G\)).
Remarque
Les composantes fortement connexes sont les sous-graphes fortement connexes maximaux pour l'inclusion.
Implémentation
Énumération de sommets
Si on considère un graphe \(G = (S,A)\), il est assez naturel de représenter ses sommets dans un tableau. Pour cela, on fixe naturellement un ordre sur ces sommets et on va associer à chaque sommet son indice dans le tableau.
Par exemple, si \(S = \{ a, b, c, d\}\) on va pouvoir considérer [ a, b, c, d ]
et ainsi associer à a son indice 0 dans le tableau. L'ordre est arbitraire,
on aurait pu considérer [ b, c, a, d ] et l'indice de a aurait alors été 2.
Ce qui compte, c'est de pouvoir travailler directement sur les indices et pas sur les éléments. Une manière de s'en convaincre est d'imaginer le graphe d'un réseau social où un sommet correspond au profil d'une personne, et contient donc beaucoup (trop) d'informations. Il est bien plus raisonnable de lui associer un identifiant unique et d'utiliser cet identifiant ensuite.
Quand on va implémenter des graphes, on peut donc supposer que les sommets sont
les entiers de 0 à n-1 où \(|S| = n\). Il sera toujours possible de
retrouver la correspondance avec les sommets eux-mêmes.
Remarque
Si on est bloqué par le coût de l'opération permettant d'obtenir l'indice d'un sommet, qui est en \(O(|S|)\) par une recherche linéaire, on peut très bien définir un dictionnaire associant à chaque sommet son indice en \(O(1)\).
Il se trouve qu'on ne va pas forcément s'intéresser à ces questions mais plus aux raisonnements sur la structure du graphe.
Matrice d'adjacence
Définition
Soit \(G = (S,A)\) un graphe et \(S = \{ s_1, \dots, s_n \}\) une énumération sans répétition des sommets de \(G\). La matrice \(M_G = \left( m_{ij} \right)_{1 \le i, j \le n} \in \mathcal{M}_n(\R)\) définie par
est appelée une matrice d'adjacence de \(G\).
Remarque
Il s'agit bien d'une matrice d'adjacence et pas de la matrice car elle dépend de l'énumération des sommets.
Exemple
Si on considère le graphe
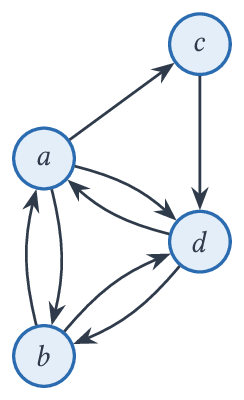
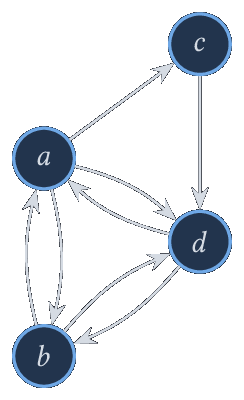
On aura pour l'énumération \(a,b,c,d\) la matrice :
En fait, la ième ligne correspond au ième sommet de l'énumération. Ici, la dernière ligne \(1 1 0 0\) correspond au sommet d et donne dans l'ordre \(a,b,c,d\) la présence ou non d'une arête \(d \rightarrow *\).
Si on considère l'énumération \(b,a,d,c\) on aura la matrice :
On en déduit ainsi une implémentation directe d'un graphe en représentant la matrice d'adjacence par un tableau de tableaux.
m = [ [ 0, 1, 1, 1 ],
      [ 1, 0, 0, 1 ],
      [ 0, 0, 0, 1 ],
      [ 1, 1, 0, 0 ] ]
let m = [| [| 0; 1; 1; 1 |];
           [| 1; 0; 0; 1 |];
           [| 0; 0; 0; 1 |];
           [| 1; 1; 0; 0 |] |]
int m[4][4] = { { 0, 1, 1, 1 },
                { 1, 0, 0, 1 },
                { 0, 0, 0, 1 },
                { 1, 1, 0, 0 } };
Remarque
Il y a le même lien entre les différentes matrices d'adjacence d'un graphe donné et la matrice d'un endomorphisme dans les différentes permutations d'une même base, à chaque fois on obtient la nouvelle matrice en permutant de même ses lignes et ses colonnes.
Cette représentation permet d'accéder, en lecture comme en écriture, à une arête en temps constant. Cependant, pour récupérer les voisins d'un sommet, il est nécessaire de parcourir toute la ligne correspondante, donc en \(O(|S|)\).
Remarque
Dans la majorité des cas, \(|A|\) est petit par rapport à \(|S|^2\). Ainsi, la matrice contient très peu de 1 et beaucoup de 0, on dit qu'elle est creuse. Une telle matrice creuse peut être efficacement représentée par l'ensemble fini des arêtes \((i,j)\). Par exemple, avec une table de hachage. Cependant, dans le cas des graphes, il est possible d'avoir une structure creuse plus efficace.
À titre d'exemple, un graphe issu d'un réseau social contenant \(300\,000\) arêtes pour \(8\,000\) sommets a un rapport \(|A|/|S|^2\) est de 4 pour 1000 !
Listes d'adjacences
La donnée de \(v_+(x)\) pour chaque sommet \(x \in S\) suffit à reconstruire \(A\).
Exemple
Si on reprend le graphe précédent,
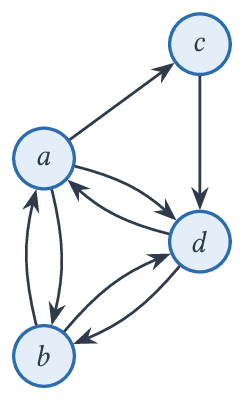
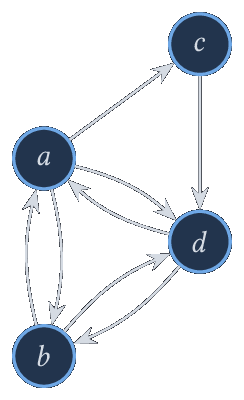
on a \(S = \{ a,b,c,d\}\) et \(A = \{ (a, b), (a, c), (a,d), (b,a), (b, d) , (c,d), (d, a), (d, b) \}\).
Or \(v_+(a) = \{ b, c, d \}, v_+(b) = \{ a, d \}, v_+(c) = \{ d \}\) et \(v_+(d) = \{ a, b \}\).
Si on pose \(V_+(x) = \enscomp{ (x,y) }{ y \in v_+(x) }\) on a directement \(A = \bigcup_{x \in S} V_+(x)\).
On en déduit ainsi une représentation d'un graphe où on place dans un tableau chaque \(v_+(x)\) représenté par une liste chaînée ou un tableau dynamique.
Remarque
Pour représenter \(v_+(x)\) on a plusieurs choix : on peut utiliser directement les valeurs des sommets ou utiliser des indices dans une énumération. C'est le second choix qu'on fera en général car il est plus simple. Cependant, en cas de suppression d'un sommet, les indices changent, et il faut renuméroter dans les listes.
Pour le graphe précédent, on pourra donc considérer une énumération [ a, b, c, d ]
et la représentation sous forme de liste d'adjacence pourra être :
l = [ [ 1, 2, 3 ], [ 0, 3 ], [ 3 ], [ 0, 1 ] ]
let l = [|
    [ 1; 2; 3 ]; [ 0; 3 ]; [ 3 ]; [ 0; 1 ]
    |]
struct graphe {
    int n;         // nombre de sommets
    int *degre;    // degre[x] = d_+(x)
    int **voisins; // voisins[x][0], ..., voisins[x][degre[x] - 1]
};
typedef struct graphe graphe;

int v0[] = { 1, 2, 3 };
int v1[] = { 0, 3 };
int v2[] = { 3 };
int v3[] = { 0, 1 };
int *voisins[] = { v0, v1, v2, v3 };
int degre[] = { 3, 2, 1, 2 };
graphe l = { 4, degre, voisins };
En C, on stocke chaque \(v_+(x)\) dans un tableau de taille \(d_+(x)\), ce qui
impose de mémoriser aussi les degrés. Ici, les tableaux sont alloués
statiquement ; pour un graphe construit à l'exécution, on les allouerait avec
malloc.
L'accès en lecture ou en écriture à une arête \(x \rightarrow y\) est alors en \(O(|A|)\), plus précisément en \(O(d_+(x))\), et on peut parcourir les voisins sortants de \(x\) en \(O(d_+(x))\) également. Accéder à la liste elle-même se fait en \(O(1)\).
Pour obtenir les voisins entrants, il est par contre nécessaire de tester la présence de \(x\) dans chacune des autres listes, on obtient donc un algorithme en \(O(|S| + |A|)\) : on parcourt chaque case du tableau des listes puis chaque maillon de listes d'adjacence.
Il est possible d'améliorer cela en utilisant une structure plus efficace pour stocker les ensembles. Cela peut être un dictionnaire reposant sur une table de hachage. L'avantage de cela est que pour tester l'appartenance \(y \in v_+(x)\) on sera en \(O(1)\) avec un dictionnaire alors qu'on sera en \(O(d_+(x))\) avec une liste.
Comparaison
| opération | Matrice | Listes | Dictionnaire |
|---|---|---|---|
| complexité spatiale | \(O(\vert S\vert^2)\) | \(O(\vert S\vert+\vert A\vert)\) | \(O(\vert S\vert+\vert A\vert)\) |
| arête test | \(O(1)\) | \(O(\vert A\vert)\) | \(O(1)\) |
| arête ajout | \(O(1)\) | \(O(1)\) | \(O(1)\) |
| arête suppression | \(O(1)\) | \(O(\vert A\vert)\) | \(O(1)\) |
| sommet ajout | \(O(\vert S\vert^2)\) | \(O(\vert S\vert)\) | \(O(\vert S\vert)\) |
| sommet suppression | \(O(\vert S\vert^2)\) | \(O(\vert S\vert+\vert A\vert)\) | \(O(\vert S\vert)\) |
| voisins/degré + | \(O(\vert S\vert)\) | \(O(1)\) | \(O(1)\) |
| voisins/degré - | \(O(\vert S\vert)\) | \(O(\vert S\vert+\vert A\vert)\) | \(O(\vert S\vert)\) |
Notons qu'il est possible d'améliorer certaines complexités en utilisant des tableaux dynamiques, notamment les ajouts et suppressions de sommets.
Remarque
Il semble a priori clair qu'on devrait utiliser des dictionnaires pour manipuler des graphes en voyant ce tableau. Pourtant, on utilisera presque exclusivement des listes d'adjacence. Pourquoi ? En grande partie parce que les opérations rendues efficaces sont rares et ne justifient pas la difficulté accrue de manipulation. En effet, l'opération la plus importante est de pouvoir énumérer les voisins, et une liste chaînée le permet facilement et efficacement.
Graphes non orientés
Définition et adaptation du vocabulaire
Définition
Un graphe non orienté est un couple \(G = (S, A)\) où \(S\) est un ensemble fini et \(A\) est un ensemble de paires d'éléments de \(S\), c'est-à-dire d'ensembles à deux éléments \(\{x,y\}\) où \(x, y \in S\).
Les éléments de \(S\) sont appelés les sommets du graphe \(G\) et les éléments de \(A\) les arêtes. Si \(\{ x,y \} \in A\), on note \(x \smile y\).
Remarque
Si \(G = (S,A)\) est un graphe orienté, on peut en déduire deux graphes non orientés :
- un graphe par défaut \(G^- = (S, A^-)\) où \(\forall x, y \in S, x \smile y \iff (x \rightarrow y \wedge y \rightarrow x)\) ;
- un graphe par excès \(G^+ = (S, A^+)\) où \(\forall x, y \in S, x \smile y \iff (x \rightarrow y \vee y \rightarrow x)\).
On a également \(A\) symétrique \(\iff G^+ = G^-\). Cela correspond à un graphe où chaque arête est dans les deux sens (\(x \rightarrow y\) et \(y \rightarrow x\)) et, donc, on peut oublier l'orientation.
De la même manière, on peut associer à un graphe non orienté \(G\) son graphe orienté symétrique obtenu en doublant chaque arête. C'est-à-dire en posant \(x \rightarrow y\) si \(x \smile y\). On a donc \(\forall x, y \in S, x \rightarrow y \iff y \rightarrow x\) et le graphe est bien symétrique.
On reprend directement l'essentiel du vocabulaire des graphes orientés symétriques avec des simplifications :
Définition
Soit \(G= (S,A)\) un graphe et \(x \in S\).
-
On appelle voisins de \(x\) les éléments de
\[ v(x) = \enscomp{y \in S}{x \smile y} \] -
On appelle degré de \(x\) l'entier \(d(x) = | v(x)|\).
Théorème
\(\sum_{x \in S} d(x) = 2 |A|\)
Preuve
Il suffit d'appliquer le théorème analogue au graphe orienté symétrique associé : chaque sommet y a \(d(x)\) voisins sortants et chaque arête \(\{x,y\}\) donne exactement deux arêtes \((x,y)\) et \((y,x)\).
On étend directement la notion de chemin mais il faut faire attention au fait que simple n'a pas le même sens entre un graphe orienté symétrique et un graphe non orienté. En effet, \(x \rightarrow y \rightarrow x\) est simple pour un graphe orienté alors que \(x \smile y \smile x\) ne l'est pas vu qu'il s'agit de la même arête.
Connexité
Définition
On définit \(\smile^*\) comme étant la fermeture réflexive et transitive de \(\smile\).
Théorème
- \(\smile^*\) est une relation d'équivalence dont les classes sont appelées les composantes connexes du graphe.
- \(x \smile^* y \iff\) il existe un chemin de \(x\) à \(y\).
Définition
Un graphe n'ayant qu'une classe d'équivalence pour \(\smile^*\) est dit connexe. Cela signifie qu'il existe un chemin entre toute paire de sommets.
Graphe acyclique connexe
Définition
On appelle arbre un graphe acyclique connexe. Quand on a distingué un sommet, on parle d'arbre enraciné.
Graphe biparti
Définition
Soit \(G = (S,A)\) un graphe, on dit que le graphe est biparti lorsqu'il existe une partition \(S = S_1 \cup S_2\) telle que
Par exemple, le graphe suivant est biparti avec \(S_1 = \{a,e,f,g\}\) et \(S_2 = \{b,c,d\}\).
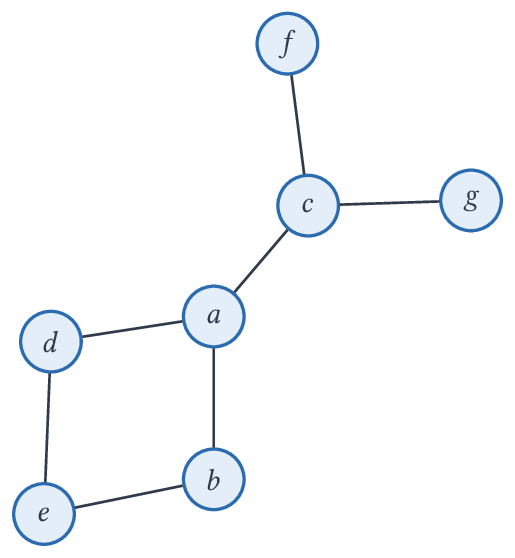
On peut s'en rendre compte en coloriant les sommets.
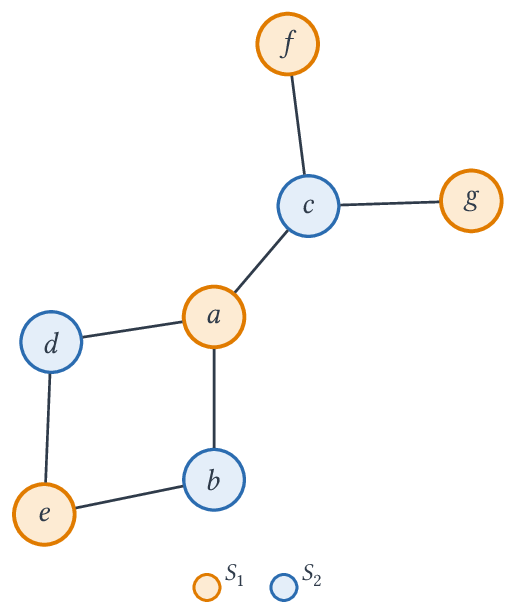
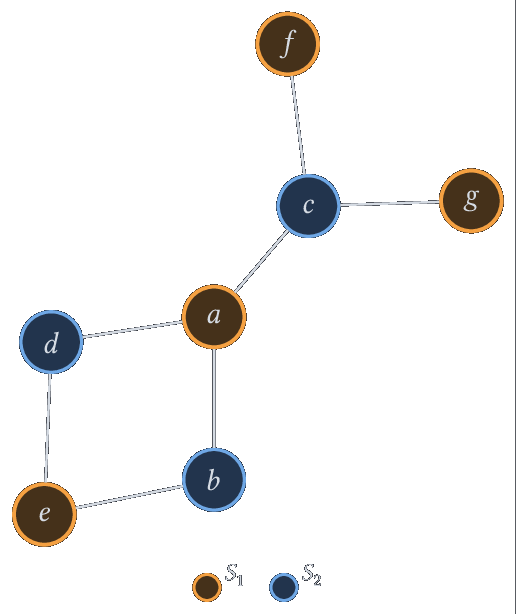
En fait, être biparti est équivalent à pouvoir être colorié en deux couleurs de sorte que deux sommets reliés soient de couleurs différentes.
Graphes classiques
On présente ici brièvement des graphes ou des familles de graphes classiques qui serviront, notamment pour les exemples.
Graphes complets
Définition
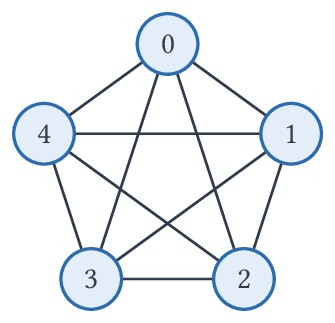
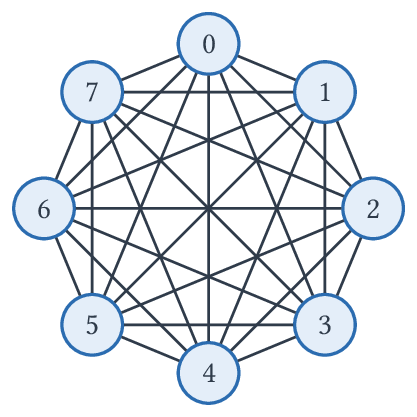
Soit \(n \in \N^*\), on appelle graphe complet à \(n\) sommets le graphe non orienté \(K_n\) de sommets \(\range{0}{n-1}\) et tel que
\(K_5\) :
\(K_8\) :
Définition
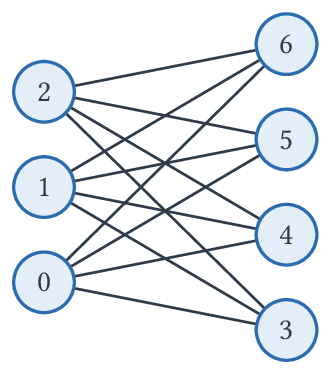
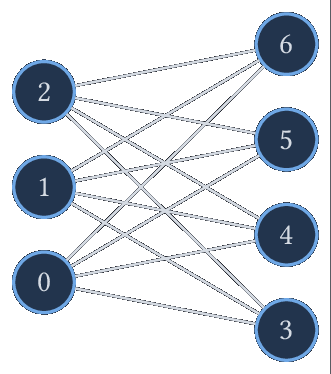
Soit \(n, p \in \N^*\), on appelle graphe biparti complet à \((n,p)\) sommets le graphe non orienté \(K_{n,p}\) de sommets \(\range{0}{n+p-1}\) et tel que
\(K_{3,4}\) :
Cycles
Définition
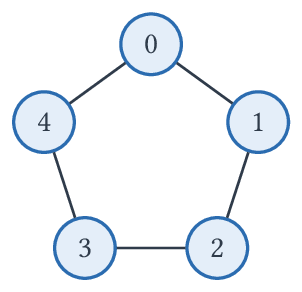
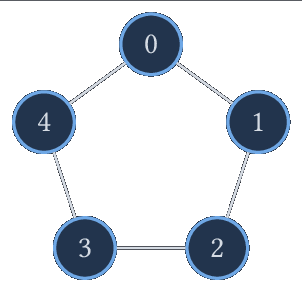
Soit \(n \ge 3\), on appelle cycle de longueur \(n\) le graphe non orienté \(C_n\) de sommets \(\range{0}{n-1}\) et tel que
\(C_5\) :
\(C_8\) :
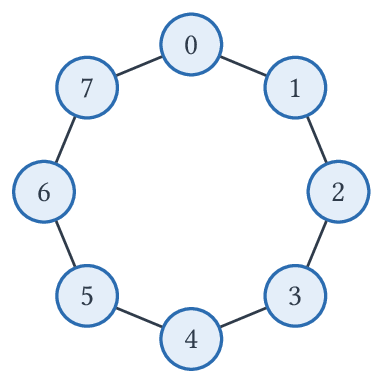
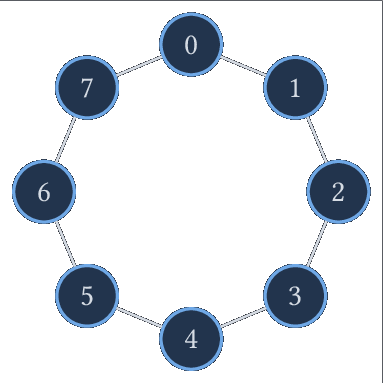
Définition
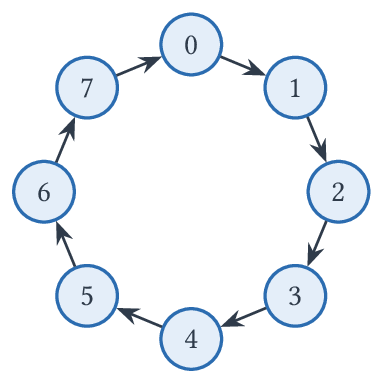
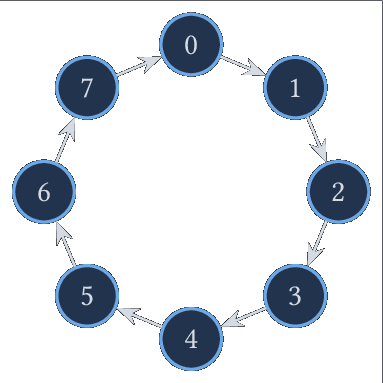
Soit \(n \ge 2\), on appelle cycle orienté de longueur \(n\) le graphe orienté \(C^o_n\) de sommets \(\range{0}{n-1}\) et tel que
\(C^o_5\) :
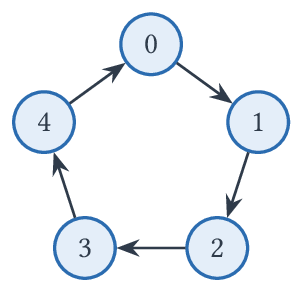
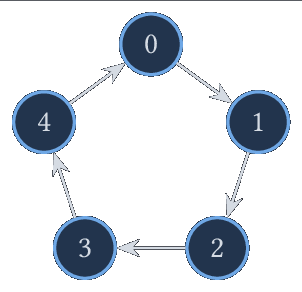
\(C^o_8\) :
Grilles et hypercubes
On va manipuler ici des vecteurs de dimension \(d\) à coordonnées entières dans \(\range{0}{n-1}\).
On sait que \(\range{0}{n-1}^d\) est en bijection avec \(\range{0}{n^d-1}\) et on considère la bijection explicite suivante :
Soit \(x = (x_0, \dots, x_{d-1})\) et \(y = (y_0, \dots, y_{d-1}) \in \range{0}{n-1}^d\), on note \(d_1(x,y) = \sum_{i=0}^{d-1} |x_i-y_i|\) qui compte la somme des différences de coordonnées. Ainsi \(d_1( (1,2,3), (3,2,2) ) = |1-3| + |2-2| + |3-2| = 3\). Comme les coordonnées sont entières, on a le théorème suivant qui indique que les vecteurs à distance 1 sont ceux qui diffèrent exactement de 1 dans une unique coordonnée :
Théorème
Soient \(x, y \in \range{0}{n-1}^d\), on a
On en déduit un graphe de grille des vecteurs à distance 1 :
Définition
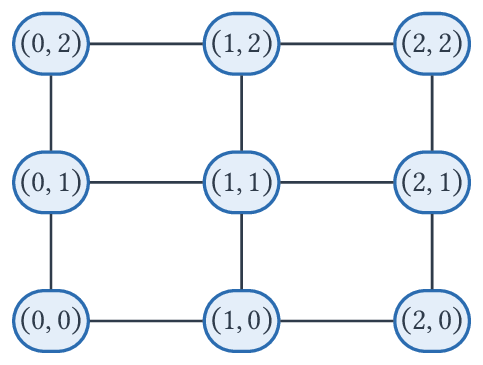
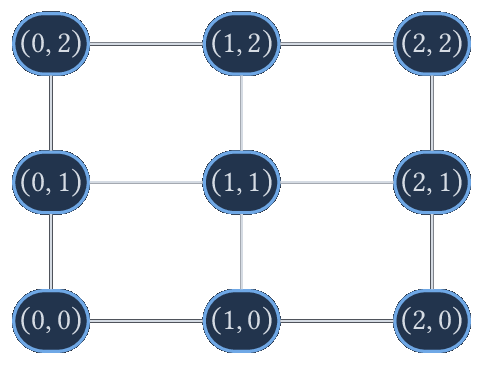
Soient \(n, d \in \N^*\), on appelle grille de dimension \(d\) et de taille \(n\) le graphe \(G_n^d\) dont les sommets sont dans \(\range{0}{n-1}^d\) et où
\(G_3^2\) :
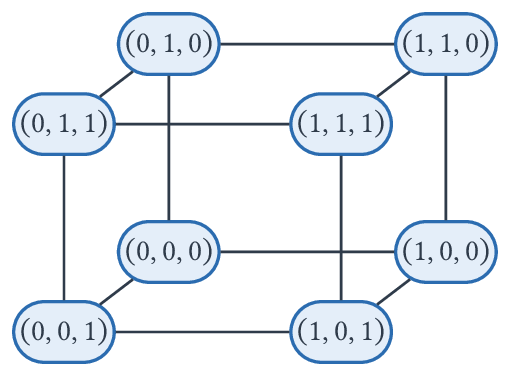
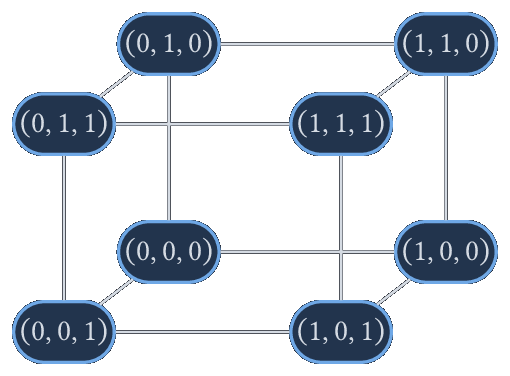
\(G_2^3\) :
Définition
Soit \(n \in \N^*\), on appelle hypercube de dimension \(n\) le graphe \(H_n = G_2^n\).
On vient de voir l'hypercube de dimension 3 (\(G_2^3\)) dans l'exemple précédent.
Remarque
L'hypercube de dimension \(n\) est intéressant car il permet de représenter chaque nombre de \(\range{0}{2^n-1}\) comme un sommet du graphe (via la bijection \(\varphi\) : les coordonnées sont les bits). Par exemple, toute chaîne hamiltonienne, c'est-à-dire qui contient chaque sommet du graphe, correspond à un ordre d'énumération des nombres qui vérifie qu'un nombre et son successeur ne diffèrent que sur un bit.
Parcours
Principe
La grande majorité des algorithmes sur les graphes consistent à parcourir les sommets de voisins en voisins pour effectuer des traitements, la manière dont on les parcourt pouvant changer selon les différentes applications.
Citons, par exemple, le fait de déterminer les composantes connexes d'un graphe ou de trouver le plus court chemin entre deux sommets.
On va se placer dans le cadre d'un graphe orienté représenté par listes d'adjacence et en supposant que les sommets sont identifiés par leur indice. Dans ce cadre, si on a, en fait, un graphe non orienté, il sera représenté par son graphe orienté symétrique comme on l'a vu plus haut.
On va également considérer qu'on veut effectuer un traitement, ou une visite, pour ces sommets ou les arêtes empruntées.
Parcours en profondeur récursif
On présente ici une première manière élémentaire de les parcourir en tirant
parti de la récursivité : on considère une fonction parcours
et l'appel à parcours pour le sommet x va effectuer des appels récursifs à
parcours pour chaque sommet \(y\) de \(v_+(x)\).
Le problème est qu'on ne veut pas traiter deux fois un sommet et on veut que les appels terminent. Pour cela, on introduit une notion d'état associé à chaque sommet. Un sommet peut être
- Inconnu, cela correspond au fait qu'il n'est pas encore apparu en tant que voisin.
- Découvert, il est apparu mais n'a pas encore été traité complètement.
- Traité (ou Visité), il a non seulement été traité, mais également tous les sommets parcourus grâce à lui.
Pour maintenir cet état dans le code, le plus simple est de considérer
un tableau d'entiers etat où etat[i] donne l'état du sommet i.
Définition
Ce parcours est appelé un parcours en profondeur récursif. En anglais, on parle de depth-first search et on utilise couramment l'acronyme DFS.
Première version
On adapte directement le principe précédent en un programme.
INCONNU = 0
DECOUVERT = 1
TRAITE = 2

def parcours(ladj, x, etat):
    if etat[x] != TRAITE:
        print(x)
        for y in ladj[x]:
            if etat[y] == INCONNU:
                etat[y] = DECOUVERT
                parcours(ladj, y, etat)
        etat[x] = TRAITE

def lance_parcours(ladj, x):
    # État initial inconnu pour tous
    etat = [ INCONNU ] * len(ladj)
    etat[x] = DECOUVERT
    parcours(ladj, x, etat)
type etat = Inconnu | Decouvert | Traite

let rec parcours ladj x etat =
    if etat.(x) <> Traite
    then begin
        Printf.printf "%d\n" x;
        List.iter (fun y ->
            if etat.(y) = Inconnu
            then begin
                etat.(y) <- Decouvert;
                parcours ladj y etat
            end
        ) ladj.(x);
        etat.(x) <- Traite
    end

let lance_parcours ladj x =
    (* État initial inconnu pour tous *)
    let etat = Array.make (Array.length ladj) Inconnu in
    etat.(x) <- Decouvert;
    parcours ladj x etat
#include <stdio.h>
#include <stdlib.h>

enum etat { INCONNU, DECOUVERT, TRAITE };

void parcours(graphe g, int x, int *etat) {
    if (etat[x] != TRAITE) {
        printf("%d\n", x);
        for (int i = 0; i < g.degre[x]; i++) {
            int y = g.voisins[x][i];
            if (etat[y] == INCONNU) {
                etat[y] = DECOUVERT;
                parcours(g, y, etat);
            }
        }
        etat[x] = TRAITE;
    }
}

void lance_parcours(graphe g, int x) {
    // État initial inconnu pour tous
    int *etat = malloc(g.n * sizeof(int));
    for (int i = 0; i < g.n; i++) {
        etat[i] = INCONNU;
    }
    etat[x] = DECOUVERT;
    parcours(g, x, etat);
    free(etat);
}
Ici, on se contente d'afficher les sommets rencontrés. En OCaml, on utilise un type
somme pour les trois états ; en C, une énumération et le type graphe défini
plus haut.
Exemple
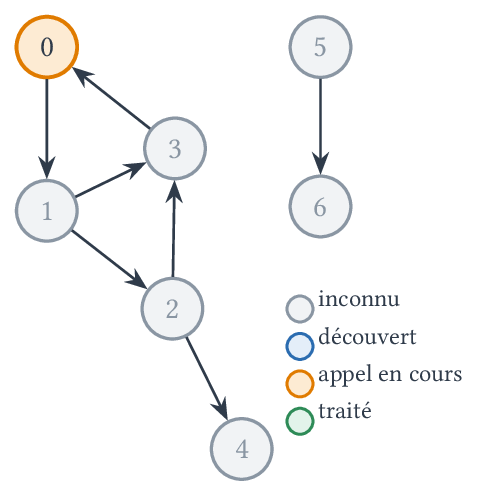
On va réaliser un parcours en profondeur du graphe suivant en partant du sommet 0 :
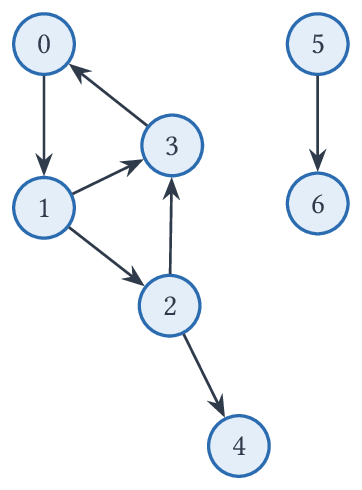
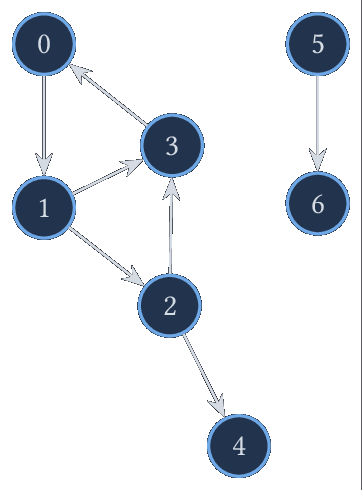
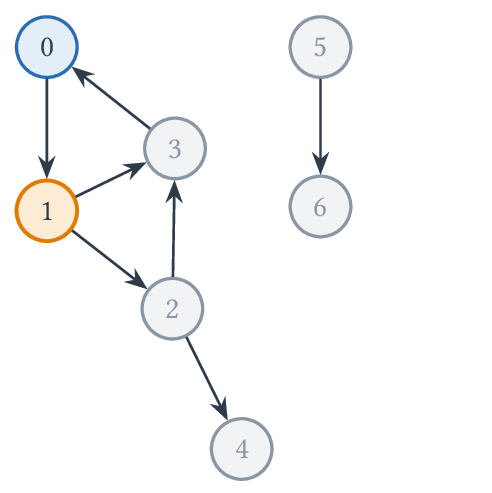
On indique les sommets inconnus en gris, les sommets découverts en bleu (en orange celui dont l'appel est en cours) et les sommets traités en vert.
On affiche 0 et on relance le parcours du voisin 1.
On affiche 1 et on relance le parcours du voisin 2.
On affiche 2 et on relance le parcours de son voisin 4 (on suppose ici que 4 apparaît avant 3 dans la liste d'adjacence de 2).
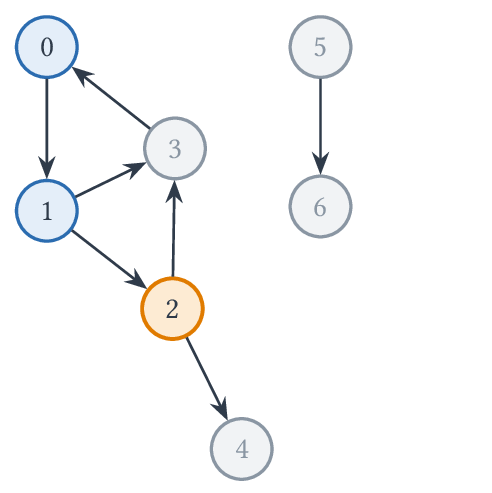
On affiche 4 et comme il n'a pas de voisins, on marque 4 comme traité et on sort de l'appel.
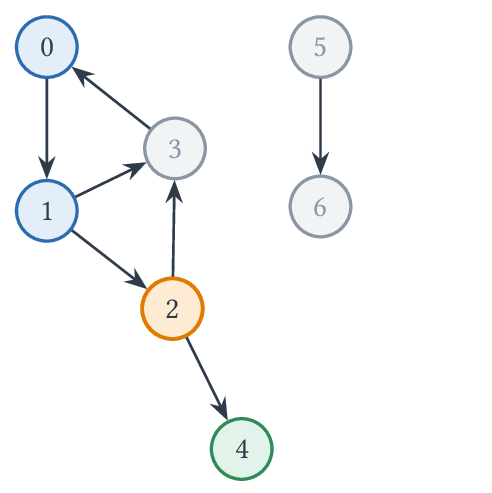
On revient à 2 et on relance le parcours du voisin 3. On affiche 3, et on le marque comme traité car son unique voisin 0 est déjà découvert.
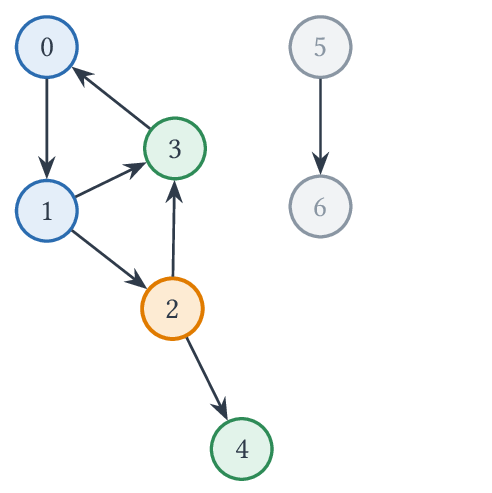
On revient à 2 et cette fois-ci il n'y a plus de voisins, on peut marquer 2 comme étant traité.
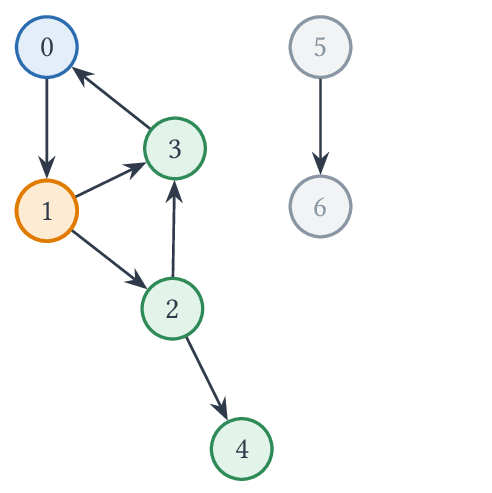
On revient à 1, son autre voisin 3 est déjà traité, on peut marquer 1 comme étant traité.
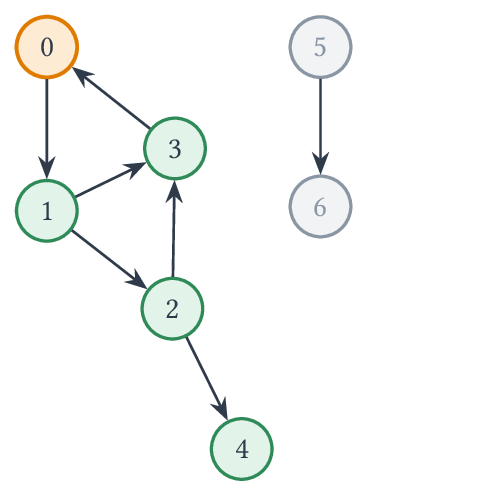
On revient à 0 et on peut marquer 0 comme étant traité.
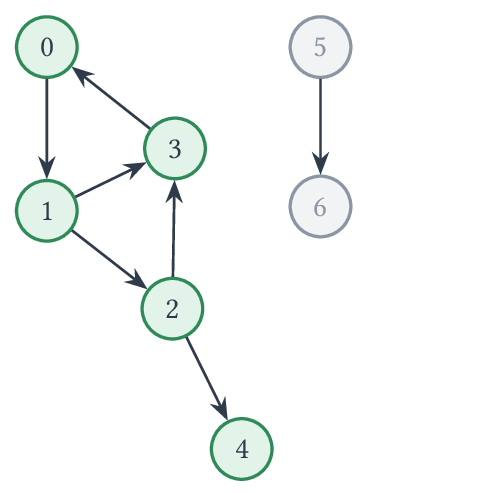
On a donc une vague de descente dans le graphe qui marque les sommets comme découverts et ensuite on remonte la pile d'appels récursifs en marquant les sommets comme étant traités.
Les sommets sont ici affichés dans l'ordre 0 1 2 4 3. On remarque que les sommets 5 et 6 sont inaccessibles, ils restent ainsi inconnus tout le long du parcours.
Arbre de parcours
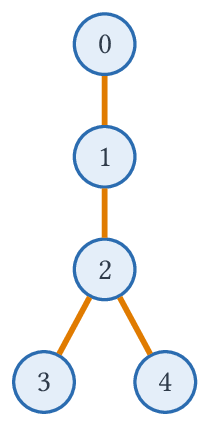
On peut noter les arêtes empruntées lors du parcours précédent pour découvrir un nouveau sommet, et donc relancer un appel récursif. On obtient alors une structure arborescente qui est appelée l'arbre du parcours en profondeur.
Exemple
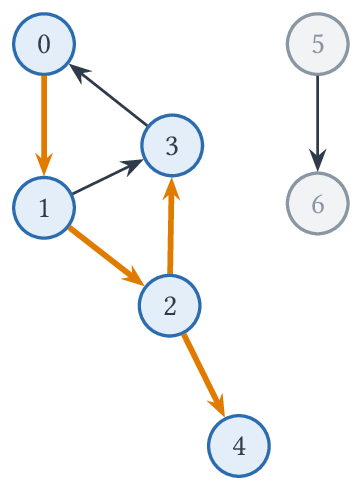
Dans le parcours précédent, on obtient l'arbre suivant :
Pour obtenir cet arbre, on va construire un tableau parent pendant le
parcours. Lorsqu'on emprunte une arête \(x \rightarrow y\) pour découvrir \(y\),
on note \(parent[y] = x\). Par défaut, \(parent[y]\) est indéfini (None
ou une valeur d'indice invalide comme \(-1\)).
Théorème
Si \(parent[y]\) est défini à l'issue du parcours depuis \(x\), alors il existe un chemin \(\varphi : x \leadsto y\) où les arêtes \(s \rightarrow s'\) empruntées lors du chemin vérifient toutes \(parent[s'] = s\).
Preuve
Quand on pose \(parent[y] = s\), le sommet \(s\) est en cours de traitement, donc découvert avant \(y\). Ainsi, en remontant les parents depuis \(y\), on obtient des sommets découverts de plus en plus tôt : la remontée ne boucle pas et s'arrête sur le seul sommet découvert sans parent, à savoir \(x\). En renversant cette suite, on obtient le chemin voulu, puisque \(parent[y] = s\) n'est posé que si \(s \rightarrow y\).
Comme \(parent[y]\) est défini pour tous les sommets découverts autres que \(x\) et que les sommets découverts finissent tous par être traités, on en déduit que les sommets traités sont accessibles depuis \(x\). La réciproque fait l'objet du théorème suivant :
Théorème
À l'issue du parcours depuis \(x\), les sommets traités sont les sommets accessibles depuis \(x\), c'est-à-dire les éléments de
Preuve
On vient de voir que les sommets traités sont accessibles depuis \(x\). Réciproquement, montrons par récurrence sur \(p\) que si \(\varphi : x \leadsto y\) est de longueur \(p\), alors \(y\) est traité. Pour \(p = 0\), \(y = x\) est traité à la fin de l'appel initial. Si \(p \ge 1\), on écrit \(\varphi = \psi\, (z \rightarrow y)\) où \(\psi\) est de longueur \(p - 1\) : par hypothèse de récurrence, \(z\) est traité, donc l'appel sur \(z\) a parcouru tous ses voisins. Au moment où l'on examine \(y\) dans cet appel, soit \(y\) est inconnu et on lance un appel sur \(y\) qui se termine en le marquant traité, soit \(y\) est déjà découvert ou traité. Or tout sommet découvert est découvert juste avant l'appel sur lui et est traité à la fin de cet appel, qui termine avant la fin du parcours. Dans tous les cas, \(y\) est traité.
On présente le calcul de ces chemins dans le programme suivant :
INCONNU = 0
DECOUVERT = 1
TRAITE = 2

def parcours(ladj, x, etat, parent):
    if etat[x] != TRAITE:
        print(x)
        for y in ladj[x]:
            if etat[y] == INCONNU:
                parent[y] = x
                etat[y] = DECOUVERT
                parcours(ladj, y, etat, parent)
        etat[x] = TRAITE

def arbre_parcours(ladj, x):
    etat = [ INCONNU ] * len(ladj)
    parent = [ None ] * len(ladj)
    etat[x] = DECOUVERT
    parcours(ladj, x, etat, parent)
    return parent

def chemin(parent, y):
    # Renvoie le chemin x -> ... -> y
    # en sens inverse
    p = [ y ]
    while parent[y] != None:
        y = parent[y]
        p.append(y)
    return p
type etat = Inconnu | Decouvert | Traite

let rec parcours ladj x etat parent =
    if etat.(x) <> Traite
    then begin
        Printf.printf "%d\n" x;
        List.iter (fun y ->
            if etat.(y) = Inconnu
            then begin
                parent.(y) <- x;
                etat.(y) <- Decouvert;
                parcours ladj y etat parent
            end
        ) ladj.(x);
        etat.(x) <- Traite
    end

(* -1 signifie que le parent est indéfini *)
let arbre_parcours ladj x =
    let n = Array.length ladj in
    let etat = Array.make n Inconnu in
    let parent = Array.make n (-1) in
    etat.(x) <- Decouvert;
    parcours ladj x etat parent;
    parent

(* Renvoie le chemin x -> ... -> y, cette fois dans le bon sens *)
let chemin parent y =
    let rec remonte y acc =
        if parent.(y) = -1
        then y :: acc
        else remonte parent.(y) (y :: acc)
    in
    remonte y []
#include <stdio.h>
#include <stdlib.h>

enum etat { INCONNU, DECOUVERT, TRAITE };

void parcours(graphe g, int x, int *etat, int *parent) {
    if (etat[x] != TRAITE) {
        printf("%d\n", x);
        for (int i = 0; i < g.degre[x]; i++) {
            int y = g.voisins[x][i];
            if (etat[y] == INCONNU) {
                parent[y] = x;
                etat[y] = DECOUVERT;
                parcours(g, y, etat, parent);
            }
        }
        etat[x] = TRAITE;
    }
}

// Renvoie un tableau parent alloué, -1 signifiant indéfini
int *arbre_parcours(graphe g, int x) {
    int *etat = malloc(g.n * sizeof(int));
    int *parent = malloc(g.n * sizeof(int));
    for (int i = 0; i < g.n; i++) {
        etat[i] = INCONNU;
        parent[i] = -1;
    }
    etat[x] = DECOUVERT;
    parcours(g, x, etat, parent);
    free(etat);
    return parent;
}

// Écrit dans p le chemin x -> ... -> y en sens inverse
// et renvoie sa longueur (p doit pouvoir contenir n sommets)
int chemin(int *parent, int y, int *p) {
    int k = 0;
    p[k++] = y;
    while (parent[y] != -1) {
        y = parent[y];
        p[k++] = y;
    }
    return k;
}
Composantes connexes
On peut déduire directement du théorème précédent, le corollaire suivant dans le cas non orienté (représenté par son graphe orienté symétrique, dans lequel \(x \leadsto y \iff x \smile^* y\)) :
Théorème
Dans un graphe non orienté, les sommets traités depuis un parcours en profondeur issu d'un sommet sont exactement les sommets de sa composante connexe.
On en déduit alors un algorithme pour obtenir les composantes connexes d'un graphe non orienté :
Algorithme : Composantes connexes
Entrées :
Un graphe non orienté \(G = (S,A)\)
Déroulement :
- Tant qu'il y a des sommets non traités
- On choisit un sommet non traité \(x\)
- On effectue un parcours récursif depuis \(x\) (sans réinitialiser les états)
- Tous les sommets nouvellement traités par ce parcours forment une composante connexe
On va en déduire le programme suivant :
INCONNU = 0
DECOUVERT = 1
TRAITE = 2

def parcours(ladj, x, etat, composante):
    if etat[x] != TRAITE:
        composante.append(x)
        for y in ladj[x]:
            if etat[y] == INCONNU:
                etat[y] = DECOUVERT
                parcours(ladj, y, etat, composante)
        etat[x] = TRAITE

def composantes_connexes(ladj):
    composantes = []
    etat = [ INCONNU ] * len(ladj)
    for i in range(len(ladj)):
        if etat[i] == INCONNU:
            composante = [ ]
            etat[i] = DECOUVERT
            parcours(ladj, i, etat, composante)
            composantes.append( composante )
    return composantes
type etat = Inconnu | Decouvert | Traite

let rec parcours ladj x etat composante =
    if etat.(x) <> Traite
    then begin
        composante := x :: !composante;
        List.iter (fun y ->
            if etat.(y) = Inconnu
            then begin
                etat.(y) <- Decouvert;
                parcours ladj y etat composante
            end
        ) ladj.(x);
        etat.(x) <- Traite
    end

let composantes_connexes ladj =
    let n = Array.length ladj in
    let composantes = ref [] in
    let etat = Array.make n Inconnu in
    for i = 0 to n - 1 do
        if etat.(i) = Inconnu
        then begin
            let composante = ref [] in
            etat.(i) <- Decouvert;
            parcours ladj i etat composante;
            composantes := List.rev !composante :: !composantes
        end
    done;
    List.rev !composantes
#include <stdlib.h>

enum etat { INCONNU, DECOUVERT, TRAITE };

void parcours(graphe g, int x, int *etat, int *composante, int num) {
    if (etat[x] != TRAITE) {
        composante[x] = num;
        for (int i = 0; i < g.degre[x]; i++) {
            int y = g.voisins[x][i];
            if (etat[y] == INCONNU) {
                etat[y] = DECOUVERT;
                parcours(g, y, etat, composante, num);
            }
        }
        etat[x] = TRAITE;
    }
}

// Remplit composante[x] avec le numéro de la composante de x
// et renvoie le nombre de composantes
int composantes_connexes(graphe g, int *composante) {
    int nb = 0;
    int *etat = malloc(g.n * sizeof(int));
    for (int i = 0; i < g.n; i++) {
        etat[i] = INCONNU;
    }
    for (int i = 0; i < g.n; i++) {
        if (etat[i] == INCONNU) {
            etat[i] = DECOUVERT;
            parcours(g, i, etat, composante, nb);
            nb++;
        }
    }
    free(etat);
    return nb;
}
En C, plutôt que de construire une liste de listes, on numérote les composantes dans un tableau : deux sommets sont dans la même composante si et seulement s'ils ont le même numéro.
Détection de cycles
Si on est en train de traiter le sommet \(x\) et qu'on rencontre une arête \(x \rightarrow y\) où \(y\) est découvert mais non traité, c'est qu'on est dans l'appel récursif de \(y\) et donc que \(x\) est un de ses descendants : \(y \leadsto x\). En rajoutant la nouvelle arête, \(y \leadsto x \rightarrow y\), on en déduit un cycle dans le cas d'un graphe orienté.
Pour un graphe non orienté représenté par un graphe orienté symétrique, il faut faire attention à ne pas prendre un aller-retour \(x \rightarrow y \rightarrow x\) pour un cycle. On demande donc à avoir la condition :
etat[y] == DECOUVERT and parent[x] != y
On en déduit le programme suivant :
INCONNU = 0
DECOUVERT = 1
TRAITE = 2

def parcours(ladj, x, etat, parent, est_oriente):
    if etat[x] != TRAITE:

        for y in ladj[x]:
            if etat[y] == INCONNU:
                parent[y] = x
                etat[y] = DECOUVERT
                cycle = parcours(ladj, y, etat, parent, est_oriente)
                if cycle != None:
                    return cycle
            elif etat[y] == DECOUVERT and (est_oriente or parent[x] != y):
                # y est un ancêtre de x : on renvoie le cycle y -> ... -> x -> y
                cycle = [ y ]
                z = x
                while z != y:
                    cycle.append(z)
                    z = parent[z]
                cycle.append(y)
                cycle.reverse()
                return cycle

        etat[x] = TRAITE
    return None

def detecte_cycle(ladj, x, est_oriente):
    etat = [ INCONNU ] * len(ladj)
    parent = [ None ] * len(ladj)
    etat[x] = DECOUVERT
    cycle = parcours(ladj, x, etat, parent, est_oriente)
    if cycle != None:
        print('Cyclique : ', cycle)
    else:
        print('Acyclique')
type etat = Inconnu | Decouvert | Traite

exception Cycle of int list

let rec parcours ladj x etat parent est_oriente =
    if etat.(x) <> Traite
    then begin
        List.iter (fun y ->
            if etat.(y) = Inconnu
            then begin
                parent.(y) <- x;
                etat.(y) <- Decouvert;
                parcours ladj y etat parent est_oriente
            end
            else if etat.(y) = Decouvert && (est_oriente || parent.(x) <> y)
            then begin
                (* y est un ancêtre de x : on construit le cycle
                   y -> ... -> x -> y en remontant depuis x *)
                let rec remonte z acc =
                    if z = y
                    then y :: acc
                    else remonte parent.(z) (z :: acc)
                in
                raise (Cycle (remonte x [y]))
            end
        ) ladj.(x);
        etat.(x) <- Traite
    end

let detecte_cycle ladj x est_oriente =
    let n = Array.length ladj in
    let etat = Array.make n Inconnu in
    let parent = Array.make n (-1) in
    etat.(x) <- Decouvert;
    try
        parcours ladj x etat parent est_oriente;
        print_endline "Acyclique"
    with Cycle c ->
        print_string "Cyclique :";
        List.iter (Printf.printf " %d") c;
        print_newline ()
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h>

enum etat { INCONNU, DECOUVERT, TRAITE };

// Renvoie la longueur du cycle écrit dans le tableau cycle
// (de taille n + 1), ou 0 si aucun cycle n'est trouvé
int parcours(graphe g, int x, int *etat, int *parent, bool est_oriente,
             int *cycle) {
    if (etat[x] != TRAITE) {
        for (int i = 0; i < g.degre[x]; i++) {
            int y = g.voisins[x][i];
            if (etat[y] == INCONNU) {
                parent[y] = x;
                etat[y] = DECOUVERT;
                int k = parcours(g, y, etat, parent, est_oriente, cycle);
                if (k != 0) {
                    return k;
                }
            } else if (etat[y] == DECOUVERT
                       && (est_oriente || parent[x] != y)) {
                // y est un ancêtre de x : on écrit le cycle y -> ... -> x -> y
                // à l'envers puis on le retourne
                int k = 0;
                cycle[k++] = y;
                for (int z = x; z != y; z = parent[z]) {
                    cycle[k++] = z;
                }
                cycle[k++] = y;
                for (int a = 0, b = k - 1; a < b; a++, b--) {
                    int tmp = cycle[a];
                    cycle[a] = cycle[b];
                    cycle[b] = tmp;
                }
                return k;
            }
        }
        etat[x] = TRAITE;
    }
    return 0;
}

void detecte_cycle(graphe g, int x, bool est_oriente) {
    int *etat = malloc(g.n * sizeof(int));
    int *parent = malloc(g.n * sizeof(int));
    int *cycle = malloc((g.n + 1) * sizeof(int));
    for (int i = 0; i < g.n; i++) {
        etat[i] = INCONNU;
        parent[i] = -1;
    }
    etat[x] = DECOUVERT;
    int k = parcours(g, x, etat, parent, est_oriente, cycle);
    if (k != 0) {
        printf("Cyclique :");
        for (int i = 0; i < k; i++) {
            printf(" %d", cycle[i]);
        }
        printf("\n");
    } else {
        printf("Acyclique\n");
    }
    free(etat);
    free(parent);
    free(cycle);
}
En OCaml, on interrompt le parcours avec une exception dès qu'un cycle est
trouvé, List.iter ne permettant pas de sortir de la boucle.
Classification des arêtes
On considère ici un parcours complet d'un graphe orienté \(G\) : comme pour les composantes connexes, tant qu'il reste des sommets inconnus, on en choisit un et on lance un parcours depuis celui-ci, sans réinitialiser les états. À la fin, tous les sommets sont traités.
Les arêtes de découverte \(parent[y] \rightarrow y\) forment alors une forêt, la forêt du parcours : chaque sommet a au plus un parent et, en remontant les parents, on aboutit à une racine, c'est-à-dire un sommet depuis lequel on a lancé un parcours. On parle d'ancêtre et de descendant dans cette forêt, en convenant qu'un sommet est ancêtre et descendant de lui-même.
Lors du parcours, chaque arête \(x \rightarrow y\) est examinée exactement une fois, par l'appel sur \(x\). On classe les arêtes selon la position de \(y\) par rapport à \(x\) dans la forêt.
Définition
Soit \(x \rightarrow y\) une arête de \(G\). On dit que c'est une arête :
- de liaison si \(parent[y] = x\), c'est-à-dire si elle a servi à découvrir \(y\) ;
- arrière si \(y\) est un ancêtre de \(x\) ;
- avant si \(y\) est un descendant de \(x\) et que ce n'est pas une arête de liaison ;
- transverse sinon, c'est-à-dire quand aucun des deux sommets n'est un ancêtre de l'autre.
Comme \(x \neq y\), \(y\) ne peut pas être à la fois un ancêtre et un descendant de \(x\) : ces quatre cas sont exclusifs.
Exemple
On reprend le graphe de l'exemple du parcours en profondeur
avec les listes d'adjacence [1], [2, 3], [4, 3], [0], [], [6],
[], et on effectue un parcours complet en lançant des parcours depuis 0
puis depuis 5.
- Les arêtes de liaison sont \(0 \rightarrow 1\), \(1 \rightarrow 2\), \(2 \rightarrow 4\), \(2 \rightarrow 3\) et \(5 \rightarrow 6\).
- \(3 \rightarrow 0\) est une arête arrière : 0 est un ancêtre de 3.
- \(1 \rightarrow 3\) est une arête avant : 3 est un descendant de 1, mais il a été découvert depuis 2.
- Il n'y a pas d'arête transverse.
Si la liste d'adjacence de 1 était [3, 2], on découvrirait 3 depuis 1, puis
2 depuis 1 : l'arête \(2 \rightarrow 3\) deviendrait transverse et
\(1 \rightarrow 3\) une arête de liaison. La classification dépend donc de
l'ordre des listes d'adjacence et pas seulement du graphe.
Pour relier cette classification au déroulement du parcours, on utilise la pile des appels récursifs.
Lemme
À tout moment d'un parcours complet :
- les sommets découverts non traités sont exactement ceux dont l'appel est en cours, et, dans l'ordre de leur découverte, ils forment une branche \(s_0, s_1, \dots, s_k\) de la forêt : \(s_0\) est une racine et \(parent[s_i] = s_{i-1}\) pour \(i \in \range{1}{k}\) ;
- \(y\) est un descendant de \(x\) si et seulement si \(y = x\) ou \(y\) est découvert à un moment où \(x\) est découvert non traité.
Preuve
Un sommet est marqué découvert juste avant l'appel sur lui et traité à la fin de cet appel, d'où la première affirmation. Les appels en cours forment la pile d'appels : le plus ancien a été lancé sur une racine par la boucle du parcours complet, et chacun des autres a été lancé par l'appel situé juste en dessous dans la pile, lors de l'examen d'une arête \(s_{i-1} \rightarrow s_i\), ce qui a posé \(parent[s_i] = s_{i-1}\).
Si \(y \neq x\) est découvert alors que \(x\) est découvert non traité, \(x\) est dans la pile \(s_0, \dots, s_k\) et \(y\) est découvert par l'appel au sommet de la pile : \(parent[y] = s_k\) et \(y\) prolonge la branche, donc \(x\) est un ancêtre de \(y\).
Réciproquement, on raisonne par récurrence sur le nombre de remontées de parents nécessaires pour aller de \(y\) à \(x\). Si \(y = x\), il n'y a rien à montrer. Sinon, \(z = parent[y]\) est un descendant de \(x\) et \(y\) est découvert par l'appel sur \(z\), donc alors que \(z\) est découvert non traité. Si \(z = x\), c'est terminé. Sinon, par hypothèse de récurrence, \(z\) a été découvert alors que \(x\) était dans la pile : \(x\) est en dessous de \(z\) dans la pile et y reste tant que l'appel sur \(z\) n'est pas terminé. Ainsi \(x\) est découvert non traité quand \(y\) est découvert.
Propriété
Au moment où l'appel sur \(x\) examine l'arête \(x \rightarrow y\) :
- \(y\) est inconnu si et seulement si l'arête est de liaison ;
- \(y\) est découvert non traité si et seulement si l'arête est arrière ;
- \(y\) est traité si et seulement si l'arête est avant ou transverse.
Preuve
Les trois cas de gauche recouvrent toutes les possibilités et ceux de droite sont exclusifs : il suffit donc de montrer les implications de gauche à droite.
- Si \(y\) est inconnu, on pose \(parent[y] = x\) : l'arête est de liaison.
- Si \(y\) est découvert non traité, \(y\) est dans la pile d'appels, dont \(x\) est le sommet. D'après le lemme, \(y\) est un ancêtre de \(x\) : l'arête est arrière.
- Si \(y\) est traité, il n'est pas dans la pile, donc ce n'est pas un ancêtre de \(x\). De plus, \(parent[y] = x\) ne peut être posé que lors de l'examen de l'arête \(x \rightarrow y\), qui n'a lieu qu'une fois, maintenant, et ne le pose pas puisque \(y\) n'est pas inconnu. L'arête est donc avant ou transverse.
Remarque
Le programme de détection de cycles vu plus haut s'arrête exactement à la première arête arrière rencontrée, et le cycle qu'il renvoie est formé de cette arête et de la branche de la forêt qui va de \(y\) à \(x\). On va voir qu'un graphe orienté est cyclique si et seulement si un parcours complet rencontre une arête arrière : pour détecter un cycle n'importe où dans le graphe, et pas seulement parmi les sommets accessibles depuis \(x\), il suffit donc de relancer ce parcours depuis chaque sommet encore inconnu.
Temps d'entrée et de sortie
On ajoute au parcours complet une horloge : un compteur, initialement nul, qu'on incrémente à chaque fois qu'un sommet est découvert et à chaque fois qu'un sommet devient traité.
Définition
Le temps d'entrée \(t_e(x)\) d'un sommet \(x\) est la valeur de l'horloge juste après son incrémentation lors de la découverte de \(x\). Le temps de sortie \(t_s(x)\) est sa valeur juste après son incrémentation quand \(x\) devient traité.
Chaque sommet est découvert une fois et traité une fois : les temps d'entrée et de sortie sont les entiers de \(1\) à \(2|S|\), deux à deux distincts, et \(t_e(x) < t_s(x)\) pour tout sommet \(x\).
On calcule ces temps lors d'un parcours complet. Ici, c'est parcours qui
marque le sommet comme découvert, au moment où on note son temps d'entrée.
INCONNU = 0
DECOUVERT = 1
TRAITE = 2

def parcours(ladj, x, etat, horloge, entree, sortie):
    # renvoie la valeur de l'horloge à la fin du traitement de x
    etat[x] = DECOUVERT
    horloge += 1
    entree[x] = horloge
    for y in ladj[x]:
        if etat[y] == INCONNU:
            horloge = parcours(ladj, y, etat, horloge, entree, sortie)
    etat[x] = TRAITE
    horloge += 1
    sortie[x] = horloge
    return horloge

def dates(ladj):
    # parcours complet
    n = len(ladj)
    etat = [ INCONNU ] * n
    entree = [ None ] * n
    sortie = [ None ] * n
    horloge = 0
    for x in range(n):
        if etat[x] == INCONNU:
            horloge = parcours(ladj, x, etat, horloge, entree, sortie)
    return entree, sortie
type etat = Inconnu | Decouvert | Traite

let rec parcours ladj x etat horloge entree sortie =
    etat.(x) <- Decouvert;
    incr horloge;
    entree.(x) <- !horloge;
    List.iter (fun y ->
        if etat.(y) = Inconnu
        then parcours ladj y etat horloge entree sortie
    ) ladj.(x);
    etat.(x) <- Traite;
    incr horloge;
    sortie.(x) <- !horloge

(* Parcours complet : renvoie les tableaux des dates d'entrée et de sortie *)
let dates ladj =
    let n = Array.length ladj in
    let etat = Array.make n Inconnu in
    let entree = Array.make n 0 in
    let sortie = Array.make n 0 in
    let horloge = ref 0 in
    for x = 0 to n - 1 do
        if etat.(x) = Inconnu
        then parcours ladj x etat horloge entree sortie
    done;
    entree, sortie
#include <stdlib.h>

enum etat { INCONNU, DECOUVERT, TRAITE };

void parcours(graphe g, int x, int *etat, int *horloge,
              int *entree, int *sortie) {
    etat[x] = DECOUVERT;
    *horloge += 1;
    entree[x] = *horloge;
    for (int i = 0; i < g.degre[x]; i++) {
        int y = g.voisins[x][i];
        if (etat[y] == INCONNU) {
            parcours(g, y, etat, horloge, entree, sortie);
        }
    }
    etat[x] = TRAITE;
    *horloge += 1;
    sortie[x] = *horloge;
}

// Parcours complet : remplit les tableaux entree et sortie (de taille n)
void dates(graphe g, int *entree, int *sortie) {
    int *etat = malloc(g.n * sizeof(int));
    for (int i = 0; i < g.n; i++) {
        etat[i] = INCONNU;
    }
    int horloge = 0;
    for (int x = 0; x < g.n; x++) {
        if (etat[x] == INCONNU) {
            parcours(g, x, etat, &horloge, entree, sortie);
        }
    }
    free(etat);
}
Exemple
Sur le graphe de l'exemple précédent, avec les listes d'adjacence
[1], [2, 3], [4, 3], [0], [], [6], [], on obtient :
| sommet | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| \(t_e\) | 1 | 2 | 3 | 6 | 4 | 11 | 12 |
| \(t_s\) | 10 | 9 | 8 | 7 | 5 | 14 | 13 |
Si on écrit une parenthèse ouvrante étiquetée par \(x\) au temps \(t_e(x)\) et une parenthèse fermante au temps \(t_s(x)\), on obtient le mot bien parenthésé
qui reflète exactement la forêt du parcours. C'est un fait général :
Théorème (des parenthèses)
Soient \(x \neq y\) deux sommets. Après un parcours complet, on est dans un et un seul des trois cas suivants :
- les intervalles \([t_e(x), t_s(x)]\) et \([t_e(y), t_s(y)]\) sont disjoints, et aucun des deux sommets n'est un descendant de l'autre ;
- \(t_e(x) < t_e(y) < t_s(y) < t_s(x)\) et \(y\) est un descendant de \(x\) ;
- \(t_e(y) < t_e(x) < t_s(x) < t_s(y)\) et \(x\) est un descendant de \(y\).
Preuve
Les trois cas sont clairement exclusifs. Quitte à échanger \(x\) et \(y\), on suppose \(t_e(x) < t_e(y)\). Comme \(x\) est découvert avant \(y\), \(x\) n'est pas un descendant de \(y\) d'après le lemme.
- Si \(t_s(x) < t_e(y)\), les intervalles sont disjoints et \(y\) est découvert après que \(x\) est traité : d'après le lemme, \(y\) n'est pas un descendant de \(x\).
- Sinon, \(t_e(x) < t_e(y) < t_s(x)\) : \(y\) est découvert alors que \(x\) est découvert non traité, donc \(y\) est un descendant de \(x\) d'après le lemme. De plus, \(x\) est alors dans la pile d'appels, en dessous de \(y\), et y reste jusqu'à la fin de l'appel sur \(y\) : on a donc \(t_s(y) < t_s(x)\).
On en déduit une caractérisation de la classification des arêtes à l'aide des temps d'entrée et de sortie.
Corollaire
Soit \(x \rightarrow y\) une arête. Après un parcours complet :
- elle est de liaison ou avant si et seulement si \(t_e(x) < t_e(y) < t_s(y) < t_s(x)\) ;
- elle est arrière si et seulement si \(t_e(y) < t_e(x) < t_s(x) < t_s(y)\) ;
- elle est transverse si et seulement si \(t_s(y) < t_e(x)\).
En particulier, l'arête est arrière si et seulement si \(t_s(x) < t_s(y)\).
Preuve
Les deux premiers points découlent directement du théorème des parenthèses. Si l'arête est transverse, les intervalles sont disjoints d'après ce même théorème. Or, d'après la propriété précédente, \(y\) est déjà traité quand l'appel sur \(x\) examine l'arête, donc \(t_s(y) < t_s(x)\) et ainsi \(t_s(y) < t_e(x)\).
Les quatre types d'arêtes recouvrant tous les cas et les trois conditions de droite étant exclusives, on a bien des équivalences. Enfin, dans les trois cas autres que celui d'une arête arrière, on a \(t_s(y) < t_s(x)\).
Théorème
Un graphe orienté \(G\) est acyclique si et seulement si un parcours complet de \(G\) ne rencontre aucune arête arrière, et ceci quels que soient l'ordre dans lequel on choisit les sommets de départ et l'ordre des listes d'adjacence.
Preuve
Si \(x \rightarrow y\) est une arête arrière, \(y\) est un ancêtre de \(x\) : les arêtes de liaison donnent un chemin \(y \leadsto x\) le long d'une branche de la forêt, dont les sommets sont distincts. En le complétant avec l'arête \(x \rightarrow y\), on obtient un cycle.
Réciproquement, s'il n'y a aucune arête arrière, le corollaire donne \(t_s(y) < t_s(x)\) pour toute arête \(x \rightarrow y\). Si \(s_0 \rightarrow s_1 \rightarrow \dots \rightarrow s_p = s_0\) était un cycle, on aurait \(t_s(s_0) > t_s(s_1) > \dots > t_s(s_p) = t_s(s_0)\), ce qui est absurde.
Corollaire
Si \(G\) est un graphe orienté acyclique, les sommets triés dans l'ordre décroissant de leurs temps de sortie lors d'un parcours complet forment un tri topologique de \(G\).
Preuve
D'après le théorème précédent, il n'y a pas d'arête arrière, donc \(t_s(y) < t_s(x)\) pour toute arête \(x \rightarrow y\).
On retrouve ainsi le théorème de la partie Tri topologique, sans avoir à lancer les parcours depuis les sommets de degré entrant nul.
Remarque
Pour un graphe non orienté, représenté par son graphe orienté symétrique, il n'y a pas d'arête transverse. En effet, si \(x \rightarrow y\) était transverse, on aurait \(t_s(y) < t_e(x)\) ; mais l'arête \(y \rightarrow x\) est examinée par l'appel sur \(y\), donc avant \(t_s(y)\), à un moment où \(x\) est encore inconnu : \(x\) deviendrait un descendant de \(y\), ce qui est contradictoire. De plus, \(x \rightarrow y\) est une arête avant si et seulement si \(y \rightarrow x\) est une arête arrière qui n'est pas le retour d'une arête de liaison : c'est pour cela que la détection de cycles dans le cas non orienté exclut seulement le cas \(parent[x] = y\).
Parcours quelconque
On va considérer ici que l'on dispose d'une structure de données sac dans
laquelle on peut placer des éléments et en sortir.
On considère aussi qu'on a un
moyen de marquer les sommets. Par défaut, ils sont non marqués.
On considère alors l'algorithme suivant décrit en pseudo-code et auquel on fera référence comme étant le parcours quelconque dans la suite :
Algorithme : parcours quelconque
Entrées :
- Un graphe \(G = (S,A)\)
- Un sommet \(s \in S\) source du parcours
Déroulement :
- On crée un sac ne contenant que \(s\)
- Tant que le sac est non vide
- On tire un sommet \(x\) du sac
- Si \(x\) n'est pas marqué
- On marque \(x\)
- pour chaque \(x \rightarrow y \in A\)
- On ajoute y dans le sac
On remarque que les sommets marqués sont exactement les sommets accessibles depuis \(s\), on retrouve ainsi le théorème vu pour le parcours récursif. En effet, un sommet n'est placé dans le sac que s'il est \(s\) ou le successeur d'un sommet marqué, donc par récurrence tout sommet marqué est accessible. Réciproquement, si \(s = s_0 \rightarrow \dots \rightarrow s_p\), on montre par récurrence sur \(i\) que \(s_i\) est marqué : quand \(s_{i-1}\) est marqué, on ajoute \(s_i\) dans le sac, et l'algorithme ne termine que lorsque le sac est vide, donc après avoir tiré \(s_i\), qui est alors marqué s'il ne l'était pas déjà.
En fait, le parcours quelconque ne permet pas de déduire plus d'information que cela, mais dans un graphe non orienté c'est déjà suffisant pour en déduire les composantes connexes.
La question qui se pose alors est celle de la stratégie d'ajout/tirage dans le sac. Selon ce que l'on considère, l'ordre de visite des sommets va changer. On va considérer trois stratégies :
- LIFO : Last In First Out, le prochain sommet tiré est le dernier ajouté
- FIFO : First In First Out, le prochain sommet tiré est le sommet le plus anciennement ajouté
- aléatoire : on tire aléatoirement et uniformément un sommet du sac
Définition
Un sac avec une stratégie LIFO est appelé une pile.
Un sac avec une stratégie FIFO est appelé une file.
Exemple
Si on considère le graphe suivant :
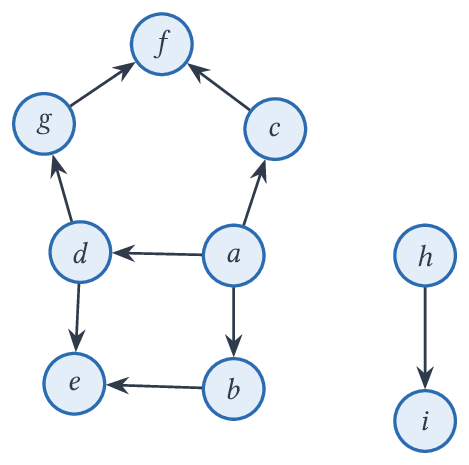
En effectuant un parcours quelconque issu de \(a\) :
- en stratégie LIFO, on va voir les sommets dans l'ordre \(a, b, e, c, f, d, g\) (si on ajoute les voisins dans le sac en commençant par le dernier de la liste d'adjacence, sinon on obtient \(a, d, g, f, e, c, b\)).
- en stratégie FIFO, on va voir les sommets dans l'ordre \(a, b, c, d, e, f, g\)
- en stratégie aléatoire, on pourrait avoir \(a, b, c, e, d, f, g\)
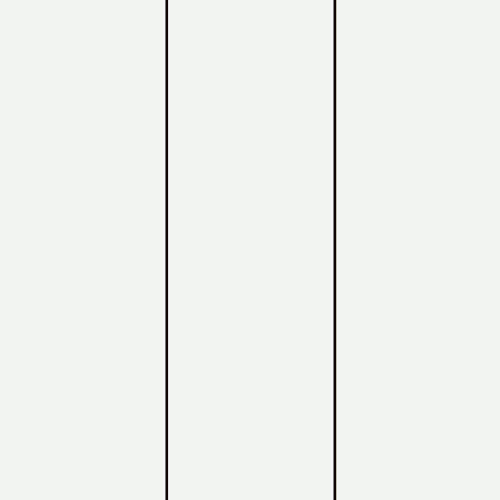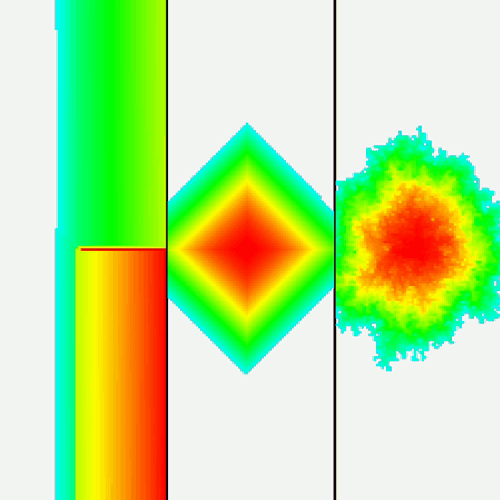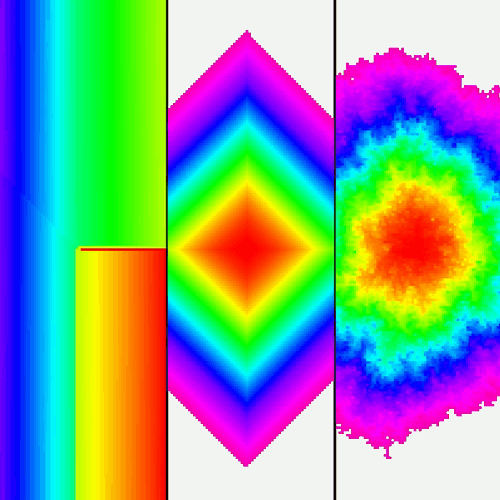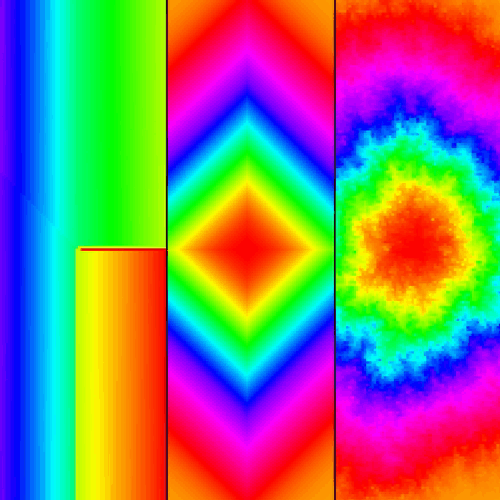
Une manière de voir ces trois différentes stratégies est de considérer une grille et de colorer les sommets marqués avec une couleur changeant à chaque marquage. On peut voir dans l'ordre LIFO, FIFO, aléatoire l'effet de ces trois stratégies en partant du même point sur l'animation suivante :
Remarque
La stratégie LIFO semble bornée : elle choisit un cap et elle s'y tient tant que c'est possible. La stratégie FIFO va elle s'étendre comme une onde partant du point de départ. De manière assez étonnante, la stratégie aléatoire semble être une bonne approximation de la stratégie FIFO, ce qui montre le caractère exceptionnel du LIFO.
Le parcours quelconque en stratégie FIFO s'appelle un parcours en largeur. Comme on va le voir, le parcours avec stratégie LIFO est exactement le parcours en profondeur précédent.
Implémentation en Python
On va supposer qu'on dispose de quatre fonctions manipulant des sacs :
sac_vide()qui renvoie un nouveau sac videajoute(sac, x)qui ajoutexdans le sacsacretire(sac)qui retire un élément du sacsacet le renvoieest_vide(sac)qui renvoie un booléen indiquant si lesacest vide
Le programme du parcours quelconque s'écrit alors
def parcours_sac(ladj, source):
    a_traiter = sac_vide()
    ajoute(a_traiter, source)
    marque = [ False ] * len(ladj)

    while not est_vide(a_traiter):
        x = retire(a_traiter)
        if not marque[x]:
            marque[x] = True
            for y in ladj[x]:
                ajoute(a_traiter, y)
Remarque
Pour utiliser ce parcours, on peut rajouter des instructions au moment où on marque un sommet ou au moment où on traite une arête.
Pour implémenter un sac, on va d'abord utiliser le type list de Python :
- Pour créer un sac vide, on utilise la valeur
[]:
def sac_vide():
    return []
- Pour tester si le sac est vide, on utilise donc le test à
[]:
def est_vide(sac):
    return sac == []
- Pour ajouter un élément
xdans le sacsdans tous les cas :
def ajoute(sac, x):
    sac.append(x)
- (LIFO) Pour retirer le dernier élément ajouté, on peut utiliser directement
pop:
def retire(sac):
    return sac.pop()
- (FIFO) Pour retirer l'élément le plus anciennement ajouté, on peut utiliser
la fonction de suppression
del l[0]qui retire le premier élément
def retire(sac):
    x = sac[0]
    del sac[0]
    return x
- C'est anecdotique, mais pour retirer un élément au hasard, il faut choisir
un indice
i, renvoyer l'élément qui s'y trouve en le supprimant du sac avecdel s[i]:
from random import randint
def retire(sac):
    i = randint(0, len(sac) - 1)
    x = sac[i]
    del sac[i]
    return x
Si on peut supposer que les quatre premières opérations sont en temps constant, les deux dernières sont linéaires en le nombre d'éléments dans le sac, ce qui est assez coûteux.
En effet, le parcours quelconque va accéder en pire cas à chaque sommet et à chaque liste d'adjacence, et ajouter un élément dans le sac pour chaque arête parcourue, soit au plus \(|A| + 1\) ajouts et donc au plus \(|A| + 1\) retraits dans un sac de taille au plus \(|A| + 1\). Donc, une complexité en \(O(|S| + |A| + |A| f(|A|))\) où \(f(n)\) est la complexité du retrait dans un sac de taille \(n\).
On obtient donc \(O(|S| + |A|)\) en LIFO mais \(O(|S| + |A|^2)\) en FIFO avec cette implémentation.
En Python, il est possible d'avoir une file (queue en anglais) permettant
de réaliser le retrait FIFO en \(O(1)\) :
- On importe le type
deque:from collections import deque - On crée une file vide avec
s = deque() - On ajoute un élément
xavecs.append(x) - Mais on dispose d'une fonction efficace
s.popleft()pour retirer le premier élément.
En fait, on dispose également d'un appendleft et du pop. Toutes
ces opérations étant en \(O(1)\).
Dans l'implémentation précédente, il suffit donc de remplacer les fonctions par les suivantes :
from collections import deque

def sac_vide():
    return deque()

def est_vide(sac):
    return len(sac) == 0

def ajoute(sac, x):
    sac.append(x)

def retire(sac):
    return sac.popleft()
Remarque
La structure de données deque est une liste doublement chaînée (de blocs).
Elle permet de remonter dans la chaîne d'un maillon vers le maillon
dont il est le suivant.
En pratique, on pourra définir des fonctions de parcours utilisant directement les bonnes structures :
def parcours_profondeur(ladj, source):
    a_traiter = [ source ]
    marque = [ False ] * len(ladj)

    while a_traiter != []:
        x = a_traiter.pop()
        if not marque[x]:
            marque[x] = True
            for y in ladj[x]:
                a_traiter.append(y)

# à placer en début du programme :
from collections import deque

def parcours_largeur(ladj, source):
    a_traiter = deque([ source ])
    marque = [ False ] * len(ladj)

    while len(a_traiter) != 0:
        x = a_traiter.popleft()
        if not marque[x]:
            marque[x] = True
            for y in ladj[x]:
                a_traiter.append(y)
Parcours en largeur
On a vu que le parcours quelconque en FIFO s'appelait le parcours en largeur. Il permet de parcourir les sommets d'un graphe en rayonnant à partir du sommet source. En effet on traite d'abord :
- le sommet source \(src\)
- les voisins de \(src\)
- les voisins des voisins de \(src\)
- \(\dots\)
Pour pouvoir parler de chemins, il est nécessaire d'introduire une notion de parenté. Pour cela, on a deux possibilités.
- Soit on n'ajoute plus des sommets dans le sac mais des couples (sommet, parent) qui correspondent à une arête de découverte :
Algorithme : parcours quelconque avec couples
Entrées :
- Un graphe \(G = (S,A)\)
- Un sommet \(s \in S\) source du parcours
Déroulement :
- On crée un sac ne contenant que \((s, s)\)
- Tant que le sac est non vide
- On tire un couple \((x, p)\) du sac
- Si \(x\) est non marqué
- On marque \(x\)
- On indique que \(parent[x] = p\)
- pour chaque \(x \rightarrow y \in A\)
- On ajoute \((y, x)\) dans le sac
- Soit on modifie le parcours quelconque pour en déduire un parcours quelconque qui a l'air a priori d'être optimisé.
Algorithme : parcours quelconque optimisé
Entrées :
- Un graphe \(G = (S,A)\)
- Un sommet \(s \in S\) source du parcours
Déroulement :
- On crée un sac ne contenant que \(s\) et on marque \(s\)
- Tant que le sac est non vide
- On tire un sommet \(x\) du sac
- pour chaque \(x \rightarrow y \in A\)
- Si \(y\) est non marqué
- On indique que \(parent[y] = x\)
- On ajoute \(y\) dans le sac
- On marque \(y\)
- Si \(y\) est non marqué
Exemple
On va reprendre l'exemple précédent
On obtient avec un parcours en largeur le schéma suivant :
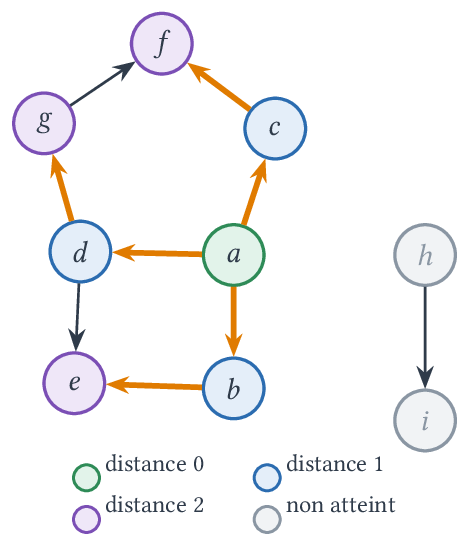
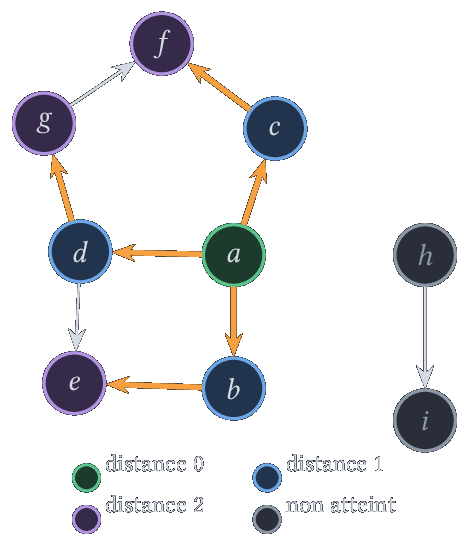
où on a noté les arêtes de parenté ainsi que d'une même couleur les éléments à égale distance de \(a\) dans le parcours en largeur.
On remarque qu'on a obtenu le chemin \(a \rightarrow c \rightarrow f\) là où un parcours en profondeur aurait pu donner le chemin plus long \(a \rightarrow d \rightarrow g \rightarrow f\).
Comme semble le suggérer l'exemple précédent, on peut démontrer le théorème suivant :
Théorème
Les chemins donnés par un parcours en largeur depuis \(x\) sont de plus petite longueur :
Si \(\varphi : x\leadsto y\) est donné par le parcours, alors \(\forall \psi : x \leadsto y\), \(|\psi| \ge |\varphi|\).
Preuve
On raisonne sur le parcours optimisé avec une file, issu de \(x\). Pour un sommet marqué \(y\), on note \(n(y)\) la longueur du chemin donné par le parcours : \(n(x) = 0\) et \(n(y) = n(parent[y]) + 1\). On note \(\delta(y)\) la longueur minimale d'un chemin de \(x\) à \(y\). Comme le chemin donné par le parcours est un chemin, on a toujours \(\delta(y) \le n(y)\).
Invariant. Si la file contient \(y_1, \dots, y_r\) (de la tête à la queue), alors \(n(y_1) \le n(y_2) \le \dots \le n(y_r) \le n(y_1) + 1\). C'est vrai initialement pour la file \([x]\). Si on retire \(y_1\) et qu'on ajoute en queue des sommets \(z\) avec \(n(z) = n(y_1) + 1\), on a bien \(n(y_r) \le n(y_1) + 1 = n(z) \le n(y_2) + 1\), et l'invariant est préservé. On en déduit que les valeurs de \(n\) des sommets retirés successivement de la file forment une suite croissante.
Supposons par l'absurde qu'il existe un sommet \(y\) accessible avec \(\delta(y) < n(y)\) et choisissons-le avec \(\delta(y)\) minimal. On a \(y \neq x\). Soit \(z\) le prédécesseur de \(y\) sur un chemin de longueur \(\delta(y)\) : on a \(\delta(z) = \delta(y) - 1\), donc par minimalité \(n(z) = \delta(z)\). Au moment où l'on retire \(z\) de la file :
- soit \(y\) n'est pas encore marqué, et alors \(parent[y] = z\) et \(n(y) = n(z) + 1\) ;
- soit \(y\) a déjà été marqué lors du retrait d'un sommet \(w\) retiré avant \(z\), donc \(n(y) = n(w) + 1 \le n(z) + 1\) par croissance.
Dans les deux cas \(n(y) \le n(z) + 1 = \delta(z) + 1 = \delta(y)\), ce qui est absurde.
Pseudo-parcours en profondeur
On peut se poser la question de la nature du parcours quelconque optimisé effectué avec une stratégie LIFO. Naïvement, on peut penser qu'il s'agit d'un parcours en profondeur. Cependant, si on considère le graphe :
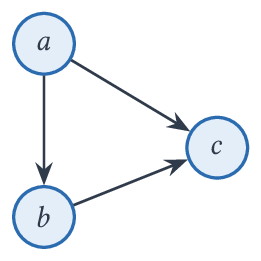
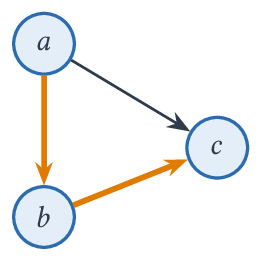
On va avoir les deux arbres différents suivants :
Avec un parcours en profondeur :
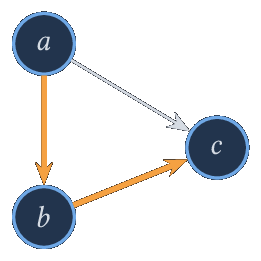
Avec un pseudo-parcours en profondeur :
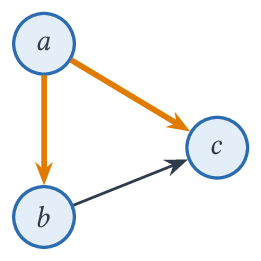
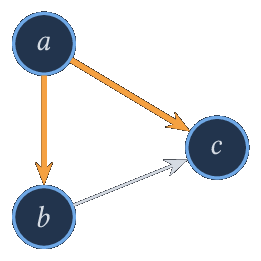
On perd une propriété fondamentale du parcours en profondeur qui est qu'un parent ne peut empêcher un de ses enfants de découvrir un sommet. Ici, dans le pseudo-parcours, \(a\) bloque la découverte de \(c\) par \(b\).
Exercice
On fixe un graphe, l'ordre de ses listes d'adjacence et un sommet de
départ, et on compare l'arbre (le tableau parent) obtenu par le parcours
quelconque optimisé à celui du parcours en profondeur récursif utilisant
les mêmes listes d'adjacence.
- Pour le graphe ci-dessus, parcouru depuis \(a\) avec la liste d'adjacence
[b, c]pour \(a\), montrer qu'aucune stratégie de tirage dans le sac ne permet au parcours optimisé d'obtenir l'arbre du parcours en profondeur. - Montrer qu'avec la liste d'adjacence
[c, b]pour \(a\), les deux arbres coïncident, quelle que soit la stratégie. L'énoncé « aucune stratégie ne convient » n'a donc de sens qu'à ordre des listes d'adjacence fixé. - Trouver un graphe et un sommet de départ pour lesquels, quel que soit l'ordre des listes d'adjacence, aucune stratégie ne permet au parcours optimisé d'obtenir l'arbre d'un parcours en profondeur.
Tri topologique
Un cas très important de graphes orientés est celui de graphes de dépendances :
- les sommets sont des tâches à réaliser
- une arête \(x \rightarrow y\) indique que la tâche \(x\) doit être réalisée avant la tâche \(y\).
Citons, par exemple, les dépendances entre chapitres dans un cours, entre unités de programme lors d'une compilation, entre produits dans un procédé industriel...
Ces graphes ont tous la particularité d'être orientés et acycliques. En effet, si on a un cycle, cela signifie qu'il y a une dépendance inextricable.
Remarque
On parle en anglais de DAG pour directed acyclic graph.
Définition
Soit \(G = (S, A)\) un graphe orienté acyclique. Une énumération \((x_1, \dots, x_n)\) des sommets de \(S\) est appelée un tri topologique lorsque pour toute arête \(x_i \rightarrow x_j\) on a \(i < j\).
Autrement dit, un tri topologique est un ordre linéaire de traitement des tâches respectant les dépendances.
Théorème
Soit \(G\) un graphe orienté acyclique et \(x_1, \dots, x_p\) les sommets de degré entrant nuls de \(G\).
Si on effectue successivement des parcours en profondeur récursifs depuis chacun des \(x_i\), en conservant les états d'un parcours à l'autre et avec la même horloge, alors les sommets triés dans l'ordre décroissant des temps de sortie constituent un tri topologique de \(G\).
Ici, l'horloge est un compteur incrémenté à chaque fois qu'un sommet devient traité, et le temps de sortie \(t_s(x)\) de \(x\) est la valeur de l'horloge à ce moment-là.
Preuve
Tous les sommets sont traités. Soit \(y \in S\). En remontant les prédécesseurs depuis \(y\), on obtient un chemin qui ne peut pas répéter de sommet puisque \(G\) est acyclique : il est donc de longueur au plus \(|S| - 1\) et se termine sur un sommet sans prédécesseur, c'est-à-dire un \(x_i\). Ainsi \(y\) est accessible depuis un \(x_i\), il est donc traité par le parcours issu de \(x_i\) (ou par un parcours antérieur).
Ordre. Il suffit de montrer que pour toute arête \(x \rightarrow y\), on a \(t_s(x) > t_s(y)\). Au moment où l'appel sur \(x\) examine l'arête \(x \rightarrow y\) :
- si \(y\) est inconnu, l'appel sur \(y\) est lancé et se termine avant celui sur \(x\), donc \(t_s(y) < t_s(x)\) ;
- si \(y\) est traité, \(t_s(y)\) est déjà fixé alors que \(x\) n'est pas encore traité, donc \(t_s(y) < t_s(x)\) ;
- si \(y\) est découvert mais non traité, l'appel sur \(y\) est en cours et \(x\) est un de ses descendants : \(y \leadsto x \rightarrow y\) est un cycle, ce qui est impossible.
Remarque
Dans le vocabulaire de la classification des arêtes, les trois cas de cette preuve sont ceux d'une arête de liaison, d'une arête avant ou transverse, et d'une arête arrière : la preuve revient à dire qu'un graphe acyclique n'a pas d'arête arrière et que seules ces arêtes vérifient \(t_s(x) < t_s(y)\). L'horloge utilisée ici ne compte que les sorties alors que celle des temps d'entrée et de sortie compte aussi les entrées, mais l'ordre des temps de sortie est le même et c'est le seul qui intervient. Enfin, on y a vu qu'on peut lancer les parcours depuis tous les sommets, dans n'importe quel ordre, sans calculer les degrés entrants.
Pour programmer le tri topologique, plutôt que de calculer les temps de sortie puis de trier, on ajoute chaque sommet à une liste au moment où il devient traité : cette liste est dans l'ordre croissant des temps de sortie et il suffit de la renverser. En OCaml, on ajoute en tête et on obtient directement le bon ordre ; en C, on remplit le tableau en partant de la fin.
INCONNU = 0
DECOUVERT = 1
TRAITE = 2

def parcours(ladj, x, etat, ordre):
    for y in ladj[x]:
        if etat[y] == INCONNU:
            etat[y] = DECOUVERT
            parcours(ladj, y, etat, ordre)
    etat[x] = TRAITE
    ordre.append(x) # ordre croissant des temps de sortie

def tri_topologique(ladj):
    etat = [ INCONNU ] * len(ladj)
    ordre = []
    for x in range(len(ladj)):
        if etat[x] == INCONNU:
            etat[x] = DECOUVERT
            parcours(ladj, x, etat, ordre)
    ordre.reverse() # ordre décroissant des temps de sortie
    return ordre
type etat = Inconnu | Decouvert | Traite

let rec parcours ladj x etat ordre =
    List.iter (fun y ->
        if etat.(y) = Inconnu
        then begin
            etat.(y) <- Decouvert;
            parcours ladj y etat ordre
        end
    ) ladj.(x);
    etat.(x) <- Traite;
    (* x est traité : on le place devant les sommets déjà traités *)
    ordre := x :: !ordre

let tri_topologique ladj =
    let n = Array.length ladj in
    let etat = Array.make n Inconnu in
    let ordre = ref [] in
    for x = 0 to n - 1 do
        if etat.(x) = Inconnu
        then begin
            etat.(x) <- Decouvert;
            parcours ladj x etat ordre
        end
    done;
    !ordre
#include <stdlib.h>

enum etat { INCONNU, DECOUVERT, TRAITE };

void parcours(graphe g, int x, int *etat, int *ordre, int *k) {
    for (int i = 0; i < g.degre[x]; i++) {
        int y = g.voisins[x][i];
        if (etat[y] == INCONNU) {
            etat[y] = DECOUVERT;
            parcours(g, y, etat, ordre, k);
        }
    }
    etat[x] = TRAITE;
    // x est traité : on le place juste avant les sommets déjà traités
    *k -= 1;
    ordre[*k] = x;
}

// Remplit ordre (de taille n) avec un tri topologique de g supposé acyclique
void tri_topologique(graphe g, int *ordre) {
    int *etat = malloc(g.n * sizeof(int));
    for (int i = 0; i < g.n; i++) {
        etat[i] = INCONNU;
    }
    int k = g.n;
    for (int x = 0; x < g.n; x++) {
        if (etat[x] == INCONNU) {
            etat[x] = DECOUVERT;
            parcours(g, x, etat, ordre, &k);
        }
    }
    free(etat);
}
Plus courts chemins
Graphes pondérés et définition du problème
Définition
Un graphe pondéré est la donnée d'un graphe, orienté ou non, \(G = (S,A)\) et d'une fonction de pondération \(\pi : A \rightarrow \R\) qui associe à chaque arête un nombre réel, son poids.
Remarque
En informatique pratique, \(\R\) n'existe pas vraiment. Les poids seront donc le plus souvent des entiers ou des flottants. Cependant, les problèmes possiblement rencontrés par des poids réels sont pertinents et le cadre unifié rend les définitions plus simples.
Définition
On définit le poids d'un chemin \(\varphi\) comme la somme des poids de ses arêtes.
Exemple
Dans le graphe suivant :
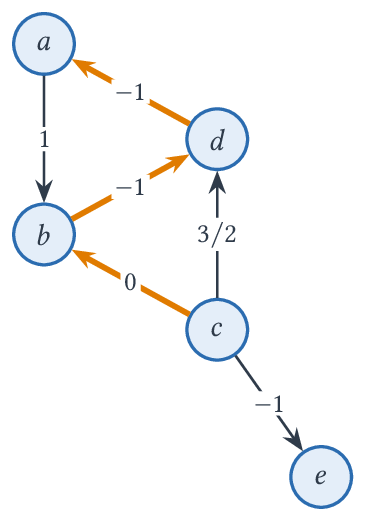
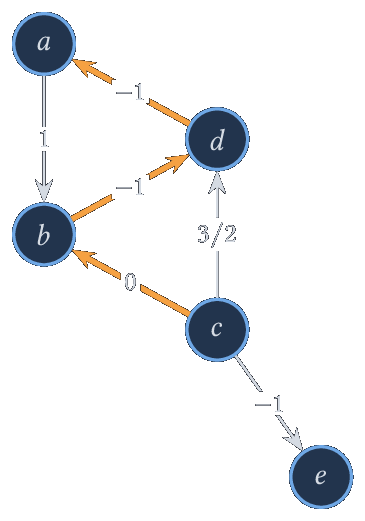
le chemin \(\varphi = c \rightarrow b \rightarrow d \rightarrow a\) est de poids \(\pi(\varphi) = 0 - 1 -1 = -2\).
On remarque que \(b \rightarrow d \rightarrow a \rightarrow b\) est un cycle de poids \(-1\), on peut donc l'emprunter autant de fois qu'on le souhaite sur un chemin passant par \(a,b\) ou \(d\) et faire diminuer son poids autant qu'on le souhaite. On parle de cycle de poids négatif et leur présence est problématique.
Théorème
Si \(G\) est un graphe pondéré sans cycles de poids négatif, \(\varphi\) est un chemin et \(\psi\) est un sous-chemin de \(\varphi\) obtenu en enlevant un cycle, alors \(\pi(\varphi) \ge \pi(\psi)\).
Preuve
Si \(\varphi = \varphi_1 c\, \varphi_2\) où \(c\) est un cycle et \(\psi = \varphi_1 \varphi_2\), alors \(\pi(\varphi) = \pi(\psi) + \pi(c) \ge \pi(\psi)\) car \(\pi(c) \ge 0\).
Du théorème précédent, on en déduit que pour obtenir un chemin de poids minimum, on peut supposer que le chemin est élémentaire. En effet, si un chemin \((s_0, \dots, s_p)\) d'un graphe orienté n'est pas élémentaire, on choisit \(i < j\) avec \(s_i = s_j\) et \(j - i\) minimal (et \((i,j) \neq (0,p)\)) : la portion \((s_i, \dots, s_j)\) est alors un cycle (ses sommets sont distincts, sauf les extrémités, et elle est de longueur au moins 2 car il n'y a pas de boucle). On l'enlève, ce qui ne fait pas augmenter le poids, et on recommence ; la longueur diminuant strictement, ce procédé termine sur un chemin élémentaire. Or, comme il existe un nombre fini de chemins élémentaires entre deux sommets, on peut en déduire la définition suivante :
Remarque
Pour un graphe non orienté, on raisonne sur le graphe orienté symétrique associé. Une arête \(\{x, y\}\) de poids négatif y donne le cycle \(x \rightarrow y \rightarrow x\) de poids négatif : on peut faire des allers-retours sur cette arête pour faire diminuer le poids d'un chemin autant qu'on le souhaite. Pour un graphe non orienté, l'hypothèse « sans cycle de poids négatif » impose donc en pratique des poids positifs.
Définition
Soit \(G = (S,A,\pi)\) un graphe pondéré sans cycles de poids négatifs et \(x, y \in S\) tels que \(x \leadsto y\), on appelle plus court chemin de \(x\) à \(y\), un chemin \(\varphi : x \leadsto y\) tel que
Il est possible de travailler avec la complétion d'un graphe pondéré en considérant toutes les arêtes possibles mais en spécifiant que si \(x \rightarrow y\) n'est pas une arête du graphe initial, alors \(\pi(x \rightarrow y) = \infty\). On peut alors poser pour tout couple \((x,y) \in S^2\), \(dist(x,y) = \min \enscomp{\pi(\psi)}{\psi : x \leadsto y}\) sachant que cette distance vaut \(\infty\) lorsque \(y\) n'est pas accessible depuis \(x\).
On va s'intéresser à deux problèmes :
Problème : PlusCourtCheminSource
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\)
- Un sommet source \(s \in S\)
Sortie :
- La donnée pour chaque \(x \in S\), de la valeur \(dist(s,x)\).
- Éventuellement, un chemin \(\varphi : s \leadsto x\) réalisant cette distance.
Problème : PlusCourtCheminToutCouple
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\)
Sortie :
- La donnée pour chaque couple \(x, y \in S\), de la valeur \(dist(x,y)\).
- Éventuellement, un chemin \(\varphi : x \leadsto y\) réalisant cette distance.
Le premier problème est naturellement inclus dans le second.
Cas des poids rationnels
Il se trouve qu'on a déjà trouvé un algorithme permettant de résoudre le problème quand \(\forall e \in A, \pi(e) = 1\) : le parcours en largeur.
Si les poids sont dans \(\Q_+^*\), on peut se ramener à des poids dans \(\N^*\) en multipliant chaque poids par le ppcm des dénominateurs des poids. Cela ne change pas la relation d'ordre entre les poids de chemins, et donc les plus courts chemins sont les mêmes.
Si \(\pi(x \rightarrow y) = k > 1\), on peut rajouter \(k-1\) sommets artificiels \(z_1, \dots, z_{k-1}\) et des arêtes de poids unitaire \(x \rightarrow z_1 \rightarrow z_2 \rightarrow \dots \rightarrow z_{k-1} \rightarrow y\) à la place de l'arête \(x \rightarrow y\). En procédant ainsi, on se ramène donc à un graphe dont les poids sont unitaires et on peut résoudre le problème avec un parcours en largeur.
Si on considère que la longueur des poids en mémoire fait partie de l'entrée, alors cette réduction est très coûteuse (le nombre de sommets ajoutés est de l'ordre de la somme des poids, donc exponentiel en la taille de leur écriture), mais si on considère que les poids sont bornés par une constante, alors toute cette réduction ne fait que grossir la constante du \(O(|S|+|A|)\) !
Remarque
On pourrait être tenté de supprimer les poids négatifs en ajoutant une constante à chaque poids, cependant, en faisant cela, on pénalise les chemins en fonction de leur longueur et on ne préserve pas la notion de plus court chemin.
Considérons par exemple le graphe :
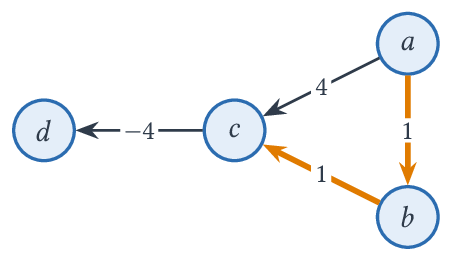
Le chemin le plus court entre \(a\) et \(c\) est de poids \(2\) et est le chemin \(a \rightarrow b \rightarrow c\).
Si on ajoute 5 à chaque poids pour qu'ils soient \(>0\), on obtient le graphe :
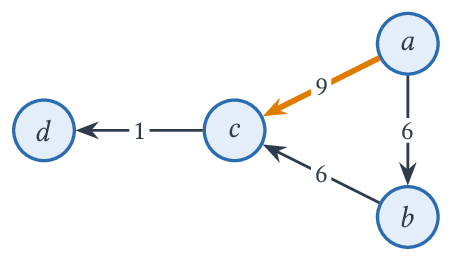
Et ici, le chemin le plus court devient \(a \rightarrow c\) de poids \(9\) et non plus \(a \rightarrow b \rightarrow c\) qui devient de poids \(12\).
Plus généralement, si on ajoute \(\eta\) à chaque poids, alors le poids de \(\varphi\) devient \(\pi(\varphi) + \eta |\varphi|\) : l'ordre entre les poids de deux chemins de longueurs différentes n'est pas préservé.
Algorithme de Dijkstra
On se concentre ici sur le problème PlusCourtCheminSource dans le cas
de poids positifs.
Si \(G = (S,A,\pi)\) est un graphe pondéré et \(s \in S\), on considère un étiquetage \(d : S \rightarrow \R \cup \{ \infty \}\) qu'on va faire évoluer dans un algorithme et tel que \(d(x)\) représente le plus petit poids trouvé jusqu'ici d'un chemin entre \(s\) et \(x\). En l'absence de cycle négatif, on sait qu'un tel chemin peut être supposé élémentaire.
Au départ, on pose \(d(s) = 0\) et \(\forall x \in S \backslash \{ s \}, d(x) = \infty\).
L'idée est d'emprunter les raccourcis, c'est-à-dire les arêtes \(y \rightarrow x\) telles que \(d(y) + \pi(y \rightarrow x) < d(x)\) :
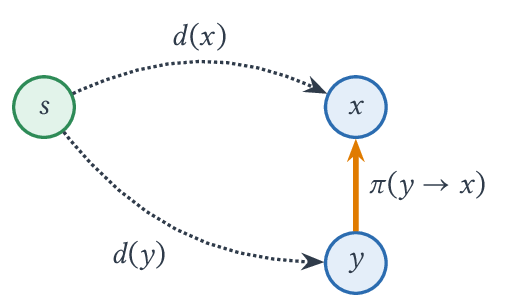
Algorithme : Dijkstra
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\) où \(\pi : A \rightarrow \R_+\)
- Un sommet \(s \in S\)
Déroulement :
- On crée un tableau
davec \(d(s) = 0\) et \(d(x) = \infty\) pour \(x \neq s\). - On crée un tableau
a_traiteret on ajoutes - Les sommets sont initialement non marqués
- Tant que
a_traiterest non vide- On retire le sommet
xdea_traiterde valeur \(d(x)\) minimale - Si
xest non marqué- On marque
x - Pour chaque arête \(x \rightarrow y\) où \(d(x) + \pi(x \rightarrow y) < d(y)\)
- On pose \(d(y) = d(x) + \pi(x \rightarrow y)\)
- On ajoute \(y\) dans
a_traiter
- On marque
- On retire le sommet
Exemple
On considère le graphe non orienté suivant (vu comme un graphe orienté symétrique)
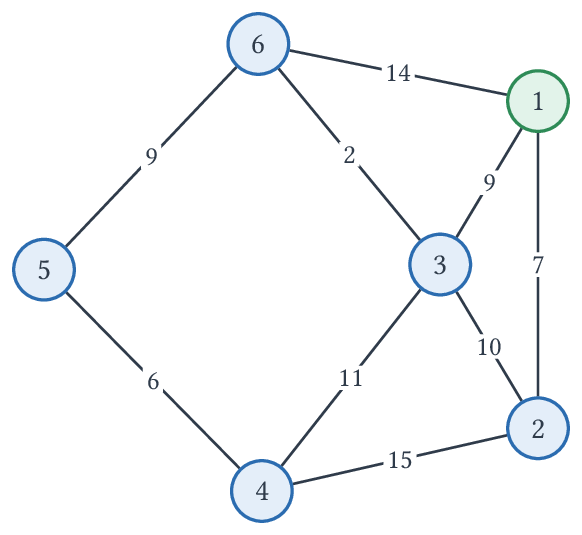
pour \(s = 1\) où les sommets dans a_traiter sont
indiqués en bleu, les sommets marqués sont indiqués en vert (en orange
celui qui vient d'être retiré), les sommets non atteints en gris
et où la valeur de \(d\) est donnée dans le cadre à côté du
sommet :
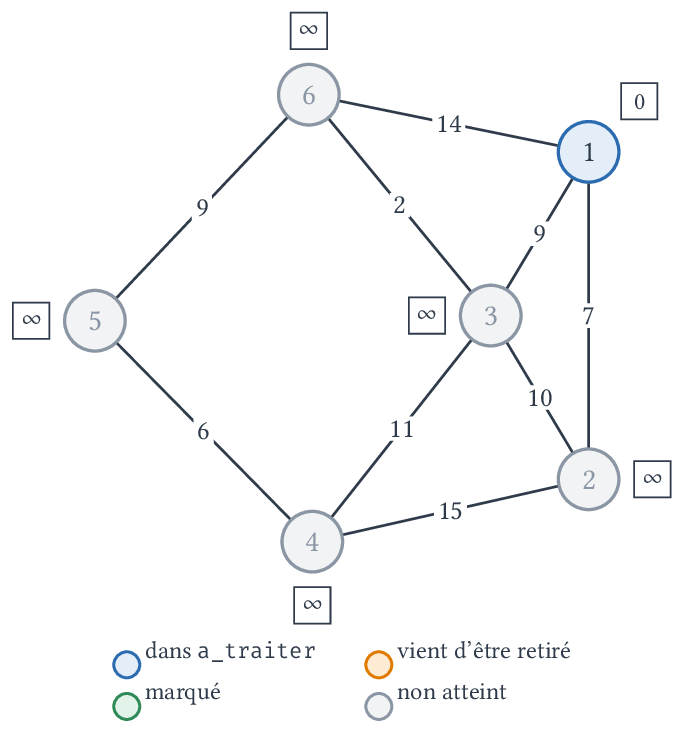
On commence par retirer 1 qui est seul dans a_traiter avec \(d(1) = 0\). On peut
alors ajouter les sommets \(2, 3\) et \(6\) :
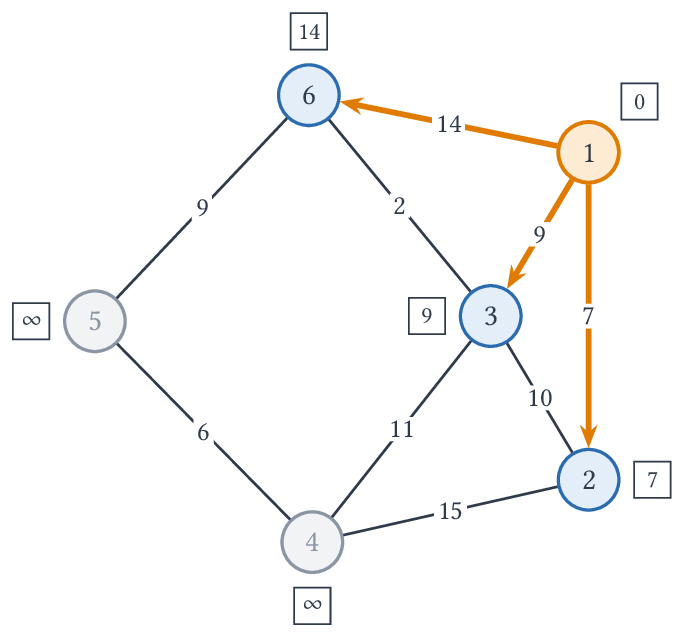
On retire alors le sommet 2 qui a la plus petite valeur de \(d\). L'arête \(2 \rightarrow 4\) vérifie la condition mais pas l'arête \(2 \rightarrow 3\) (car \(7 + 10 \ge 9\)). On ajoute donc 4 dans les sommets à traiter :
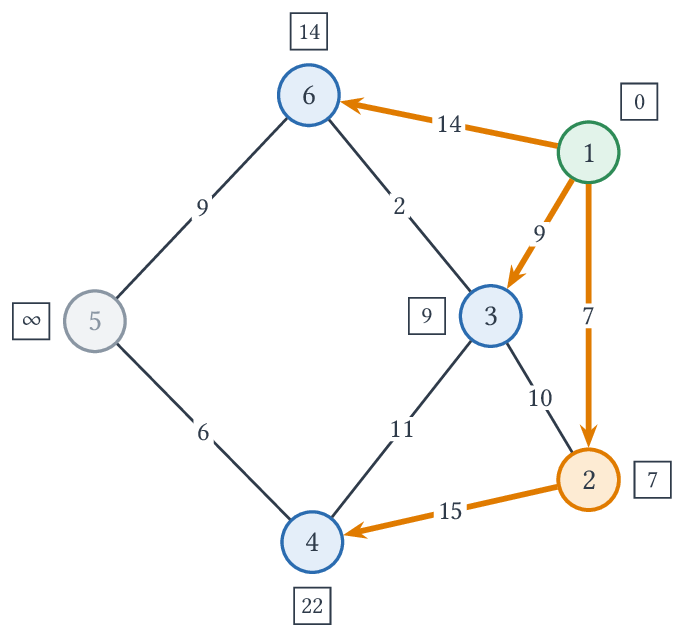
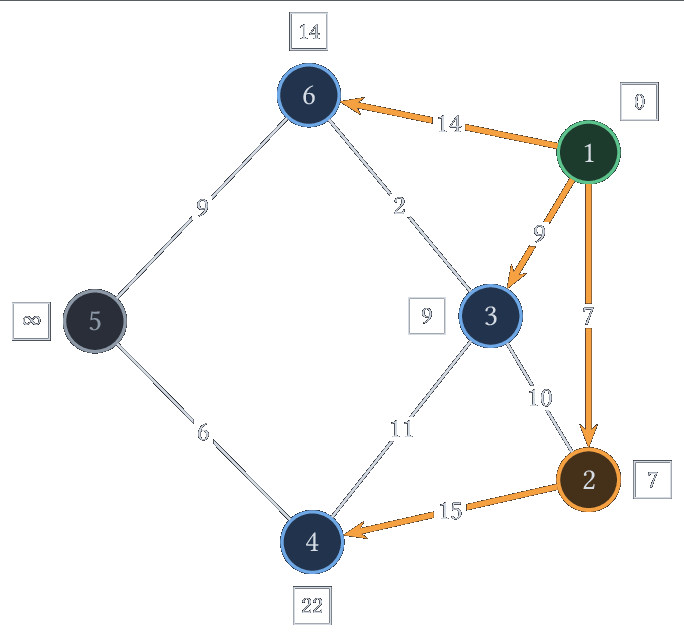
On retire alors 3 et on voit que les deux arêtes \(3 \rightarrow 6\)
et \(3 \rightarrow 4\) permettent d'améliorer \(d\) (\(9 + 2 < 14\) et
\(9 + 11 < 22\)). On rajoute donc \(4\) et \(6\)
dans a_traiter :
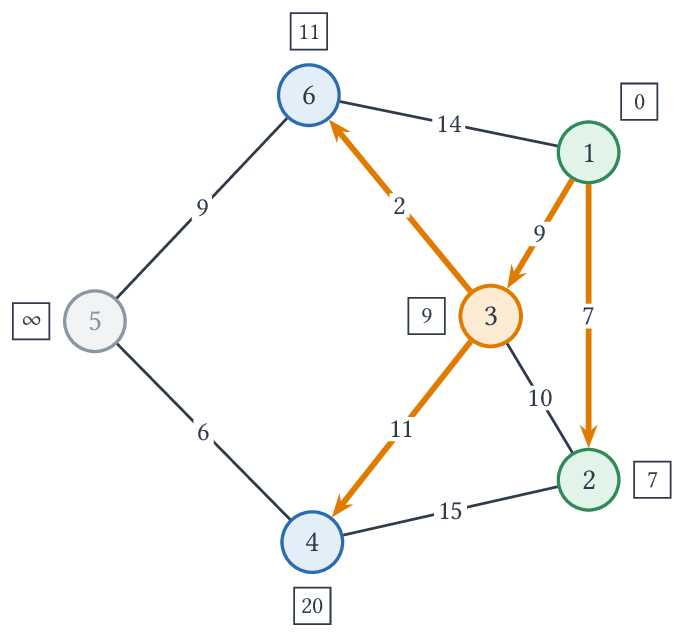
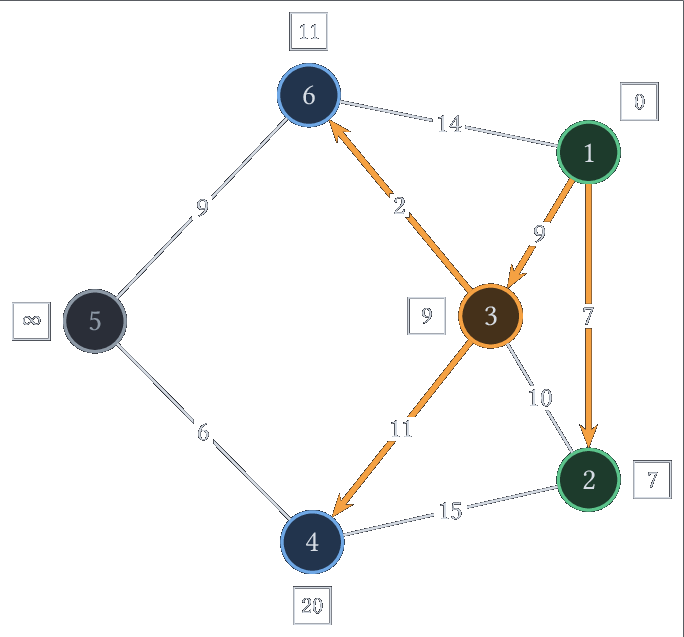
On retire alors le sommet 6 qui permet d'emprunter \(6 \rightarrow 5\) et
qui rajoute ainsi 5 à a_traiter :
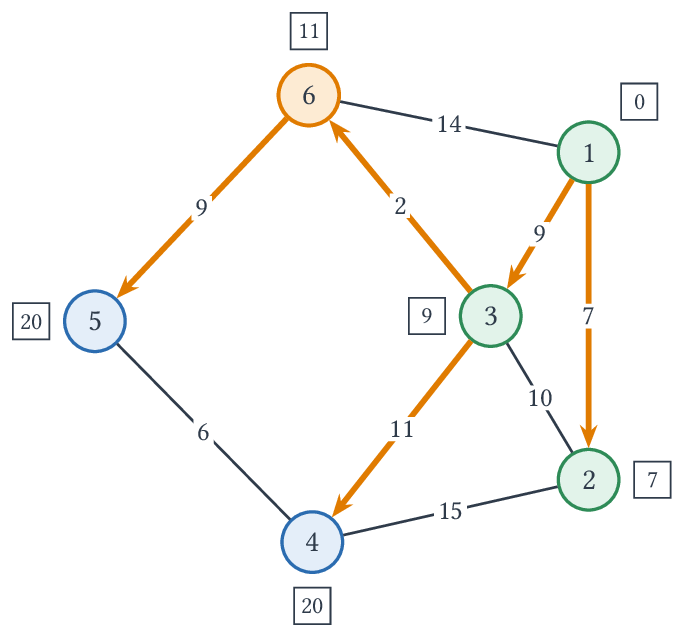
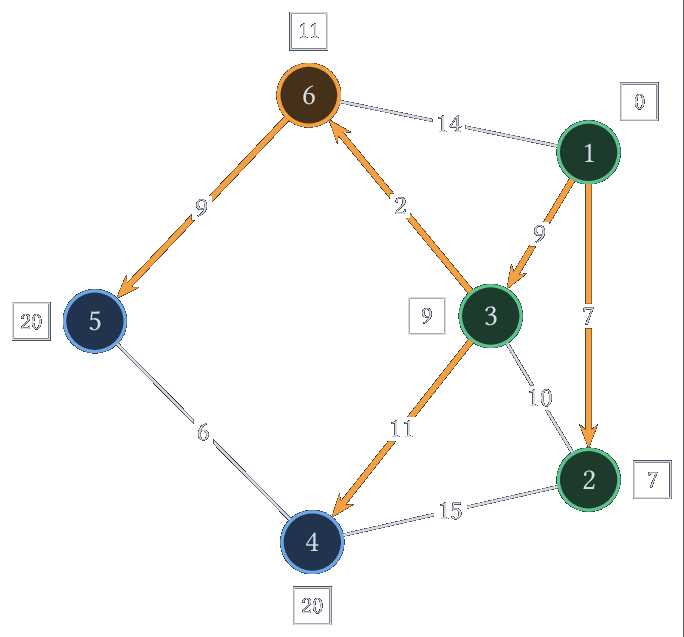
On traite les deux derniers sommets, 4 et 5 (tous deux avec \(d = 20\)), en les retirant : aucune arête ne vérifie plus la condition.
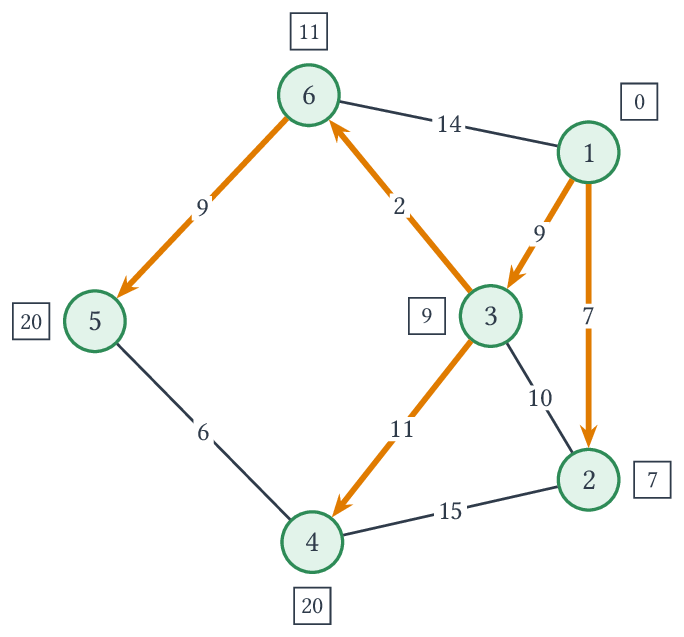
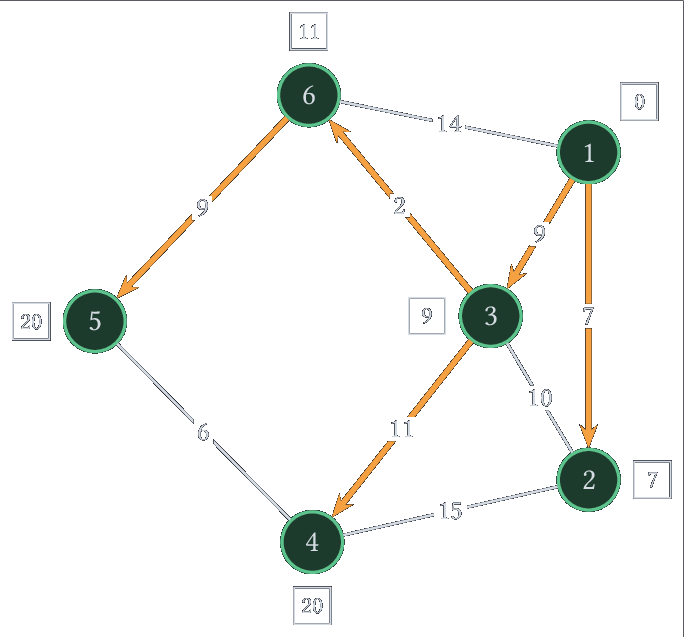
Cet algorithme est essentiellement un parcours quelconque où la stratégie de sortie du sac est de retirer le sommet de plus petite valeur de \(d\) (un successeur \(y\) d'un sommet marqué qui n'est pas ajouté vérifie \(d(y) < \infty\), il a donc déjà été ajouté). On sait donc déjà qu'il termine et qu'il explore \(acc(s) = \enscomp{ x \in S }{ s \leadsto x }\).
Comme on ne modifie \(d\) que pour mettre des nombres \(\neq \infty\), on est assuré qu'à la fin de l'algorithme les sommets dans \(acc(s)\) ont une valeur dans \(\R_+\) dans le tableau \(d\) et que les autres ont \(\infty\). La force de l'algorithme de Dijkstra découle du contenu final de \(d\) qui répond à la question voulue :
Théorème
À la fin de l'algorithme, si \(s \leadsto x\), \(d(x) = dist(s, x)\).
Preuve
Une récurrence immédiate montre qu'à tout moment, si \(d(x) < \infty\), alors \(d(x)\) est le poids d'un chemin de \(s\) à \(x\), donc \(d(x) \ge dist(s, x)\).
Montrons que lorsqu'un sommet \(x\) est marqué, on a \(d(x) = dist(s,x)\). Comme \(d(x)\) ne peut ensuite que diminuer et reste minoré par \(dist(s,x)\), cette valeur ne changera plus, ce qui prouve le théorème puisque tous les sommets accessibles sont marqués.
Le premier sommet marqué est \(s\) avec \(d(s) = 0 = dist(s,s)\) (les poids
étant positifs). Supposons par l'absurde qu'un sommet \(x\) soit marqué avec
\(d(x) > dist(s,x)\), et considérons le premier tel sommet. Soit \(\varphi\) un plus
court chemin de \(s\) à \(x\). Comme \(s\) est marqué et que \(x\) ne l'est pas
encore au moment où on le retire, il existe une première arête
\(u \rightarrow v\) de \(\varphi\) avec \(u\) marqué et \(v\) non marqué. Lors du
marquage de \(u\), on avait \(d(u) = dist(s,u)\) par minimalité de \(x\), et
l'arête \(u \rightarrow v\) a été examinée : on a donc ensuite
\(d(v) \le dist(s,u) + \pi(u \rightarrow v) = dist(s,v)\), la portion de
\(\varphi\) allant de \(s\) à \(v\) étant un plus court chemin. De plus, \(v\) est
alors dans a_traiter : il y a été ajouté lors de la dernière diminution
de \(d(v)\) et n'en a pas été retiré puisqu'il n'est pas marqué.
Comme les poids sont positifs, \(dist(s, v) \le dist(s, x)\), donc
\(d(v) \le dist(s,x) < d(x)\). Ceci contredit le choix de \(x\) comme sommet de
a_traiter de valeur \(d\) minimale (si \(v = x\), c'est directement
\(d(x) \le dist(s,x)\) qui est contredit).
C'est la positivité des poids qui permet d'affirmer \(dist(s,v) \le dist(s,x)\) : avec des poids négatifs, ce raisonnement tombe en défaut.
On peut implémenter directement cet algorithme :
let rec extrait_plus_petit l d =
    match l with
    | [] -> failwith "impossible"
    | [x] -> (x, [])
    | x::q ->
        let (y, q') = extrait_plus_petit q d in
        if d.(y) < d.(x)
        then (y, x :: q')
        else (x, q)

let dijkstra g src =
    let n = Array.length g in
    let inf = max_int in
    let d = Array.make n inf in
    d.(src) <- 0;
    let marques = Array.make n false in
    let a_traiter = ref [ src ] in
    while !a_traiter <> [] do
        let x, q = extrait_plus_petit !a_traiter d in
        a_traiter := q;
        if not marques.(x)
        then begin
            marques.(x) <- true;
            List.iter (fun (y, poids) ->
                let n_d = d.(x) + poids in
                if n_d < d.(y)
                then begin
                    d.(y) <- n_d;
                    a_traiter := y :: !a_traiter
                end
            ) g.(x)
        end
    done;
    d
def extrait_plus_petit(t, d):
    x = t[0] # recherche du d[x] min dans t
    for i in t[1:]:
        if d[i] < d[x]:
            x = i
    t.remove(x) # on le retire
    return x # on le renvoie

def dijkstra(g, src):
    n = len(g)
    inf = float('inf')
    d = [ inf ] * n
    d[src] = 0
    a_traiter = [ src ]
    marques = [ False ] * n
    while a_traiter != []:
        x = extrait_plus_petit(a_traiter, d)
        if not marques[x]:
            marques[x] = True
            for y, poids in g[x]:
                n_d = d[x] + poids
                if n_d < d[y]:
                    d[y] = n_d
                    a_traiter.append(y)
    return d # distances finales
#include <stdlib.h>
#include <stdbool.h>
#include <limits.h>
#include <assert.h>

#define INF INT_MAX

struct arete {
    int but;
    int poids;
};
typedef struct arete arete;

struct graphe_pondere {
    int n;
    int *degre;
    arete **voisins; // voisins[x][i] : i-ème arête issue de x
};
typedef struct graphe_pondere graphe_pondere;

// Retire de a_traiter (de taille *taille) un sommet x
// de d[x] minimal et le renvoie
int extrait_plus_petit(int *a_traiter, int *taille, int *d) {
    int i_min = 0; // recherche du d[x] min dans a_traiter
    for (int i = 1; i < *taille; i++) {
        if (d[a_traiter[i]] < d[a_traiter[i_min]]) {
            i_min = i;
        }
    }
    int x = a_traiter[i_min];
    // on le retire en le remplaçant par le dernier élément
    *taille -= 1;
    a_traiter[i_min] = a_traiter[*taille];
    return x;
}

// Renvoie le tableau des distances (à libérer par l'appelant)
int *dijkstra(graphe_pondere g, int src) {
    int *d = malloc(g.n * sizeof(int));
    bool *marques = malloc(g.n * sizeof(bool));
    int nb_aretes = 0;
    for (int x = 0; x < g.n; x++) {
        d[x] = INF;
        marques[x] = false;
        nb_aretes += g.degre[x];
    }
    d[src] = 0;
    // au plus |A| + 1 ajouts dans a_traiter
    int capacite = nb_aretes + 1;
    int *a_traiter = malloc(capacite * sizeof(int));
    int taille = 0;
    a_traiter[taille++] = src;
    while (taille > 0) {
        int x = extrait_plus_petit(a_traiter, &taille, d);
        if (!marques[x]) {
            marques[x] = true;
            for (int i = 0; i < g.degre[x]; i++) {
                int y = g.voisins[x][i].but;
                int n_d = d[x] + g.voisins[x][i].poids;
                if (n_d < d[y]) {
                    d[y] = n_d;
                    assert(taille < capacite);
                    a_traiter[taille++] = y;
                }
            }
        }
    }
    free(a_traiter);
    free(marques);
    return d; // distances finales
}
Dans les trois versions, le graphe est donné par listes d'adjacence où chaque
voisin est accompagné du poids de l'arête, et a_traiter est une simple liste
(un tableau en C) dans laquelle on cherche linéairement le minimum. En C, un
sommet peut figurer plusieurs fois dans a_traiter, comme dans les deux autres
versions : on dimensionne donc le tableau avec le nombre maximal d'ajouts
\(|A| + 1\) justifié dans la remarque suivante. Les poids étant des entiers, on
représente \(\infty\) par INT_MAX (et par max_int en OCaml) : on ne lui ajoute
jamais rien car seuls des sommets marqués, donc de distance finie, propagent
leur valeur.
Remarque
La complexité de la recherche du sommet de valeur \(d\) minimale est
linéaire en la taille de a_traiter. Chaque ajout dans a_traiter
correspond à une arête \(x \rightarrow y\) examinée depuis un sommet \(x\)
marqué, donc il y a au plus \(|A| + 1\) ajouts, et autant de retraits, dans une
liste de taille au plus \(|A| + 1\) : on a une complexité totale en
\(O(|S| + |A|^2)\). Si on n'ajoute \(y\) que lorsqu'il n'est pas déjà dans
a_traiter, cette liste est de taille au plus \(|S|\) et on obtient
\(O(|S| \times |A|)\) (on peut même obtenir \(O(|S|^2)\) en cherchant le minimum
directement dans le tableau d parmi les sommets non marqués).
Utilisation d'une file de priorité
On peut améliorer l'algorithme précédent avec une file de priorité où la priorité de \(x\) est \(d(x)\) et où on suppose qu'on extrait la priorité minimale. Cela permet ainsi d'obtenir une complexité en \(O(|S| + |A| \log |S|)\).
Cependant, il est alors nécessaire de modifier la priorité ce qui est une opération assez pénible. À la place, on peut ajouter une autre fois le sommet. Au pire, on fera grossir la file (qui reste de longueur \(O(|A|)\)) et quand on retirera un sommet déjà traité, celui-ci sera ignoré. Comme \(\log |A| \le \log |S|^2 = 2 \log |S|\), la complexité reste en \(O(|S| + |A| \log |S|)\).
On obtient ainsi l'algorithme suivant :
Algorithme : Dijkstra
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\) où \(\pi : A \rightarrow \R_+\)
- Un sommet \(s \in S\)
Déroulement :
- On crée un tableau
davec \(d(s) = 0\) et \(d(x) = \infty\) pour \(x \neq s\). - On crée une file de min-priorité
a_traiteret on ajoutesavec priorité0 - Les sommets sont initialement non marqués
- Tant que
a_traiterest non vide- On retire le sommet
xdea_traiter - Si
xest non marqué- On marque
x - Pour chaque arête \(x \rightarrow y\) où \(d(x) + \pi(x \rightarrow y) < d(y)\)
- On pose \(d(y) = d(x) + \pi(x \rightarrow y)\)
- On insère \(y\) avec priorité \(d(y)\)
- On marque
- On retire le sommet
Relaxation
Pour éclairer la correction de Dijkstra et le lien avec la positivité des poids des arêtes, on va présenter ici un cadre plus général.
Arêtes tendues
Définition
On dit qu'une arête \(x \rightarrow y\) est tendue si
Quand on pose ensuite \(d(y) = d(x) + \pi(x \rightarrow y)\) on dit qu'on relâche l'arête.
Ainsi, une arête est tendue quand on peut l'emprunter pour améliorer l'estimation du plus petit chemin de \(s\) à \(y\).
Théorème
On suppose que \(G\) est sans cycle de poids négatif, que \(d(s) = 0\) et que pour tout \(x \in S\), \(d(x)\) vaut \(\infty\) ou le poids d'un chemin de \(s\) à \(x\) (c'est le cas initialement et cela reste vrai quand on relâche une arête). Si aucune arête n'est tendue, alors \(d(x) = dist(s, x)\) pour tout \(x \in S\) (avec \(=\infty\) si \(x\) est inaccessible).
Preuve
Par hypothèse, \(d(x) \ge dist(s,x)\) pour tout \(x\), en particulier \(d(x) = \infty = dist(s,x)\) si \(x\) est inaccessible. Il reste à montrer que \(d(x) \le dist(s,x)\) pour \(x\) accessible.
Pour un tel \(x\), on note \(k(x)\) le nombre minimal d'arêtes d'un plus court chemin de \(s\) à \(x\), et on raisonne par récurrence forte sur \(k(x)\).
Si \(k(x) = 0\), alors \(x = s\) et \(d(s) = 0 = dist(s,s)\) (il n'y a pas de cycle de poids négatif).
Si \(k(x) \ge 1\), soit \(\varphi\) un plus court chemin de \(s\) à \(x\) ayant \(k(x)\) arêtes et \(y\) le prédécesseur de \(x\) dans ce chemin : on a \(\varphi = \psi\,(y \rightarrow x)\) où \(\psi : s \leadsto y\). Nécessairement, le chemin \(\psi\) est un plus court chemin de \(s\) à \(y\), sinon on obtiendrait un chemin vers \(x\) de poids strictement plus petit que celui de \(\varphi\). Ainsi \(k(y) \le k(x) - 1\) et, par hypothèse de récurrence, \(d(y) \le dist(s, y) = \pi(\psi)\).
Comme l'arête \(y \rightarrow x\) n'est pas tendue, on a alors \(d(x) \le d(y) + \pi(y \rightarrow x) \le \pi(\psi) + \pi(y \rightarrow x) = \pi(\varphi) = dist(s,x)\).
On en déduit un pseudo-algorithme appelé méthode de relaxation :
Algorithme : Relaxation
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\) sans cycle de poids négatif
- Un sommet \(s \in S\)
Déroulement :
- On pose \(d\) tel que \(d(s) = 0\) et \(\forall x \in S \backslash \{ s \}, d(x) = \infty\).
- Tant qu'il existe une arête \(e\) tendue
- On relâche l'arête \(e\)
Remarque
- On montre par récurrence sur le nombre d'itérations que si \(d(x) < \infty\) alors \(d(x)\) est le poids d'un chemin simple de \(s\) à \(x\). Comme ces chemins simples sont en nombre fini, leurs poids aussi et donc \(d\) ne peut prendre qu'un nombre fini de valeurs. Comme \(d\) diminue strictement en un point à chaque itération, la boucle termine.
- En présence d'un cycle de poids négatif accessible depuis \(s\), on pourrait continuellement relâcher les arêtes du cycle et donc l'algorithme ne termine pas.
-
En sortie de l'algorithme on a donc \(dist(s,x) \le dist(s,y) + \pi(y\rightarrow x)\) pour toute arête \(y \rightarrow x\). Or, on a l'égalité pour l'avant-dernier sommet \(y\) d'un plus court chemin. On en déduit donc l'égalité très importante suivante :
\[ \forall x \in S \backslash \{ s \}, dist(s, x) = \min\enscomp{ dist(s,y) + \pi(y \rightarrow x) }{y \in S} \]En fait, si on considère l'opération \(\Phi\) définie par \(\Phi(d)(s) = 0\) et :
\[ \forall x \in S \backslash\{s\}, \Phi(d)(x) = \min \enscomp{ d(y) + \pi(y \rightarrow x) }{y \in S} \]on remarque que \(x \mapsto dist(s, x)\) est un point fixe de \(\Phi\).
On pourrait ainsi le calculer comme la limite de la suite stationnaire \(d_{n+1} = \Phi(d_n)\) où \(d_0(s) = 0\) et \(\forall x \neq s, d_0(x) = \infty\).
Si on considère le graphe
et que l'on représente la suite \(d\) sous une forme de tableau, on obtient (pour \(s = 1\)) :
On peut montrer par récurrence sur \(n\) que, pour \(x \neq s\), \(d_n(x)\) est le plus petit poids d'un chemin de \(s\) à \(x\) ayant au plus \(n\) arêtes. En l'absence de cycles négatifs, un plus court chemin peut être supposé élémentaire, donc avoir au plus \(|S|-1\) arêtes : la suite est stationnaire à partir du rang \(|S|-1\) au plus. L'algorithme obtenu s'appelle l'algorithme de Bellman-Ford.
On en déduit une implémentation directe de l'algorithme de Bellman-Ford, avec la même représentation des graphes pondérés que pour Dijkstra. On calcule \(d_k\) à partir de \(d_{k-1}\) pour \(k\) allant de \(1\) à \(|S|-1\), puis on vérifie qu'aucune arête n'est encore tendue.
def bellman_ford(g, src):
    # renvoie None si un cycle de poids négatif est accessible depuis src
    n = len(g)
    inf = float('inf')
    d = [ inf ] * n
    d[src] = 0
    for k in range(1, n):
        n_d = d.copy() # calcul de d_k à partir de d_{k-1}
        for x in range(n):
            for y, poids in g[x]:
                if d[x] + poids < n_d[y]:
                    n_d[y] = d[x] + poids
        d = n_d
    # une arête encore tendue révèle un cycle de poids négatif
    for x in range(n):
        for y, poids in g[x]:
            if d[x] + poids < d[y]:
                return None
    return d
(* Renvoie Some d, ou None si un cycle de poids négatif
   est accessible depuis src *)
let bellman_ford g src =
    let n = Array.length g in
    let inf = max_int in
    let d = Array.make n inf in
    d.(src) <- 0;
    for _ = 1 to n - 1 do
        (* calcul de d_k à partir de d_{k-1}, recopié ensuite dans d *)
        let n_d = Array.copy d in
        for x = 0 to n - 1 do
            if d.(x) <> inf
            then List.iter (fun (y, poids) ->
                if d.(x) + poids < n_d.(y)
                then n_d.(y) <- d.(x) + poids
            ) g.(x)
        done;
        Array.blit n_d 0 d 0 n
    done;
    (* une arête encore tendue révèle un cycle de poids négatif *)
    let tendue = ref false in
    for x = 0 to n - 1 do
        if d.(x) <> inf
        then List.iter (fun (y, poids) ->
            if d.(x) + poids < d.(y)
            then tendue := true
        ) g.(x)
    done;
    if !tendue then None else Some d
#include <stdlib.h>
#include <limits.h>

#define INF INT_MAX

// Renvoie le tableau des distances (à libérer par l'appelant),
// ou NULL si un cycle de poids négatif est accessible depuis src
int *bellman_ford(graphe_pondere g, int src) {
    int *d = malloc(g.n * sizeof(int));
    int *n_d = malloc(g.n * sizeof(int));
    for (int x = 0; x < g.n; x++) {
        d[x] = INF;
    }
    d[src] = 0;
    for (int k = 1; k < g.n; k++) {
        // calcul de d_k à partir de d_{k-1} dans n_d
        for (int x = 0; x < g.n; x++) {
            n_d[x] = d[x];
        }
        for (int x = 0; x < g.n; x++) {
            if (d[x] != INF) {
                for (int i = 0; i < g.degre[x]; i++) {
                    int y = g.voisins[x][i].but;
                    if (d[x] + g.voisins[x][i].poids < n_d[y]) {
                        n_d[y] = d[x] + g.voisins[x][i].poids;
                    }
                }
            }
        }
        int *tmp = d;
        d = n_d;
        n_d = tmp;
    }
    free(n_d);
    // une arête encore tendue révèle un cycle de poids négatif
    for (int x = 0; x < g.n; x++) {
        if (d[x] != INF) {
            for (int i = 0; i < g.degre[x]; i++) {
                int y = g.voisins[x][i].but;
                if (d[x] + g.voisins[x][i].poids < d[y]) {
                    free(d);
                    return NULL;
                }
            }
        }
    }
    return d;
}
Remarque
- Le tableau
n_dest initialisé avec \(d_{k-1}\) et pas avec des \(\infty\) : en l'absence de cycle de poids négatif, cela ne change rien car \(d_k(y) \le d_{k-1}(y)\), et cela évite de traiter à part le sommet \(s\). - La complexité est en \(O(|S| \times (|S| + |A|))\) en temps et \(O(|S|)\) en espace.
- La vérification finale détecte exactement les cycles de poids négatif accessibles depuis \(s\). S'il n'y en a pas, on peut se restreindre aux sommets accessibles depuis \(s\) : \(d\) contient les distances, qui vérifient \(dist(s,y) \le dist(s,x) + \pi(x \rightarrow y)\), et aucune arête n'est tendue. Réciproquement, si \(c = v_0 \rightarrow v_1 \rightarrow \dots \rightarrow v_p = v_0\) est un cycle accessible depuis \(s\), ses sommets ont une valeur de \(d\) finie (ils sont accessibles par un chemin élémentaire, d'au plus \(|S|-1\) arêtes). Si aucune arête n'était tendue, on aurait \(d(v_i) \le d(v_{i-1}) + \pi(v_{i-1} \rightarrow v_i)\) pour tout \(i \in \range{1}{p}\) et, en sommant, \(0 \le \pi(c)\) : le cycle n'est pas de poids négatif.
Algorithme de Dijkstra comme relaxation
Quand on retire un sommet \(x\) de la file, si \(e = x \rightarrow y\) alors soit l'arête est non tendue et alors \(d(y) \le d(x) + \pi(x \rightarrow y)\), ce qui signifie qu'on connaît déjà un chemin simple de poids \(d(y)\) qui est au moins aussi bon que de passer par \(x\). Cela signifie notamment que \(y\) a déjà été découvert à un moment par l'algorithme (\(d(y) < \infty\)). Soit l'arête est tendue et passer par \(x\) améliore le chemin vers \(y\). On relâche l'arête. On a alors deux possibilités : soit \(y\) est dans la file, et on change sa priorité, soit on l'insère dans la file.
Quand la file est vide, aucune arête n'est tendue : en effet, après le dernier retrait d'un sommet \(x\), les arêtes issues de \(x\) ne sont plus tendues, et elles ne peuvent le redevenir que si \(d(x)\) diminue, auquel cas \(x\) est remis dans la file. D'après le théorème précédent, \(d\) contient alors les distances.
En procédant ainsi, on obtient un algorithme qui implémente le pseudo-algorithme précédent :
Algorithme : ProtoDijkstra
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\) sans cycle négatif
- Un sommet \(s \in S\)
Déroulement :
- On crée un tableau
davec \(d(s) = 0\) et \(d(x) = \infty\) pour \(x \neq s\). - On crée une file de min-priorité
a_traiteret on ajoutesavec priorité0 - Tant que
a_traiterest non vide- On retire le sommet
xdea_traiter - Pour chaque arête \(x \rightarrow y\) tendue vis-à-vis de \(d\)
- On relâche l'arête dans \(d\)
- Si \(y\) est dans
a_traiter- Alors, on remplace sa priorité par la nouvelle valeur de \(d(y)\)
- Sinon, on insère \(y\) avec priorité \(d(y)\)
- On retire le sommet
Exemple
L'exemple suivant permet d'observer l'algorithme sur un graphe comportant des poids négatifs. On a indiqué en bleu les sommets sur la file, en orange le sommet actuellement traité, en vert les sommets déjà retirés et en gris les sommets non atteints. Les arêtes de parenté sont présentées comme dans l'exemple précédent à mesure qu'elles sont modifiées.
On va ainsi partir du graphe suivant et du sommet source \(a\) :
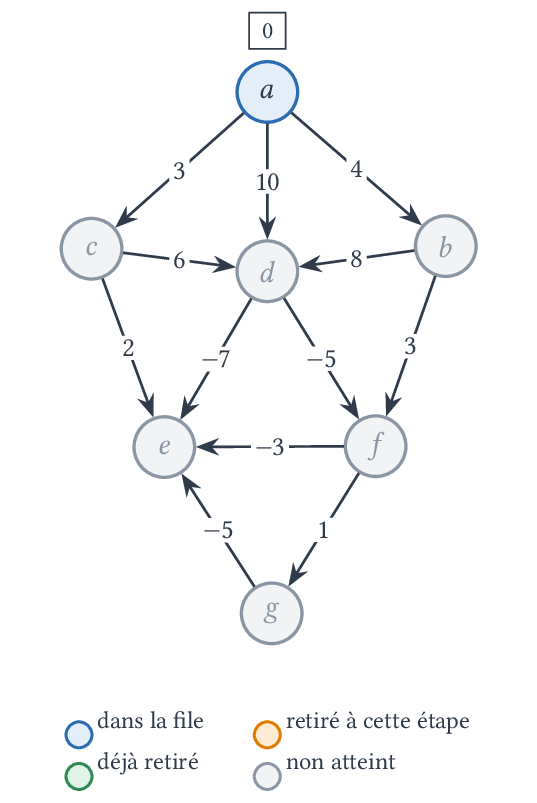
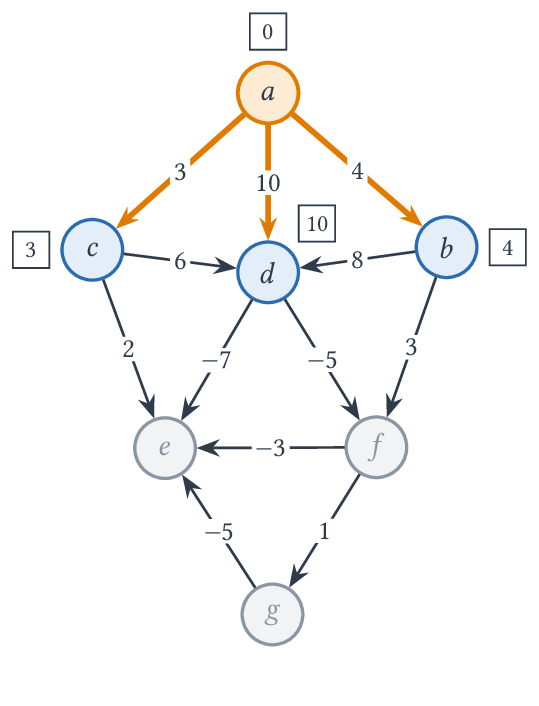
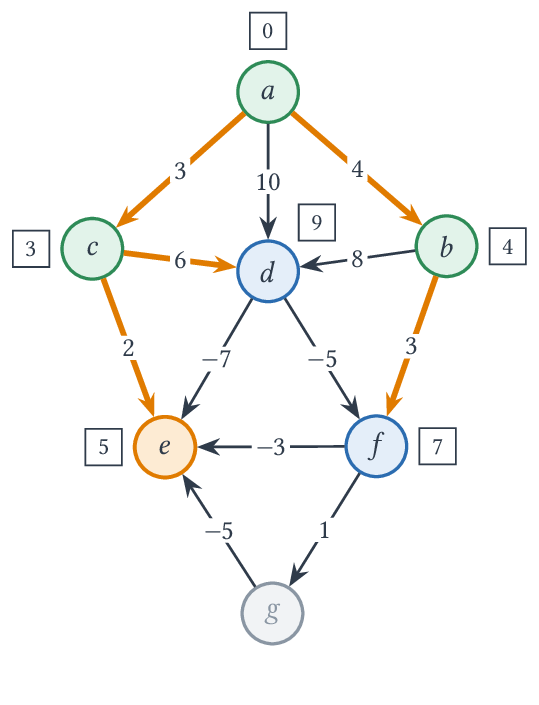
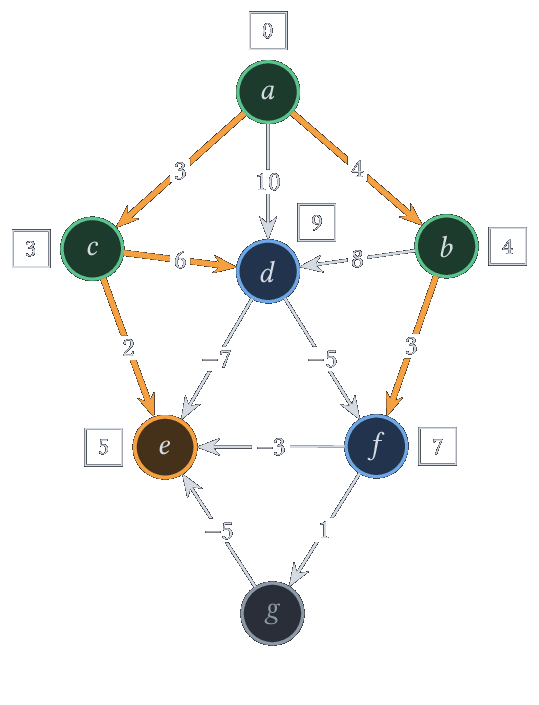
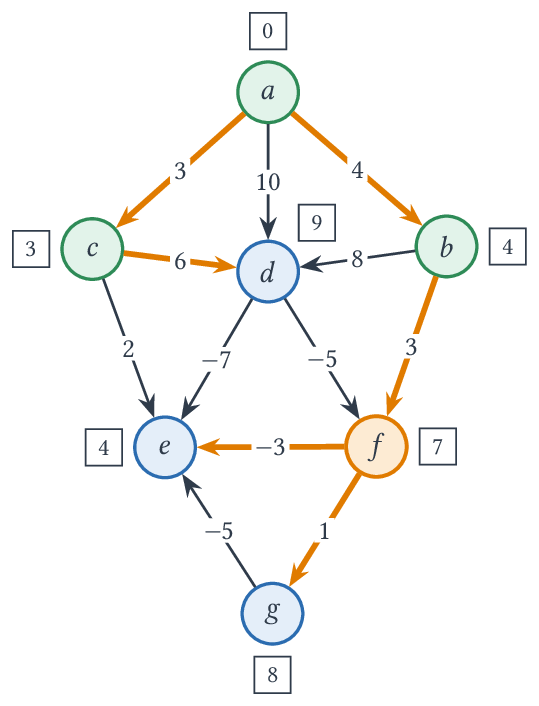
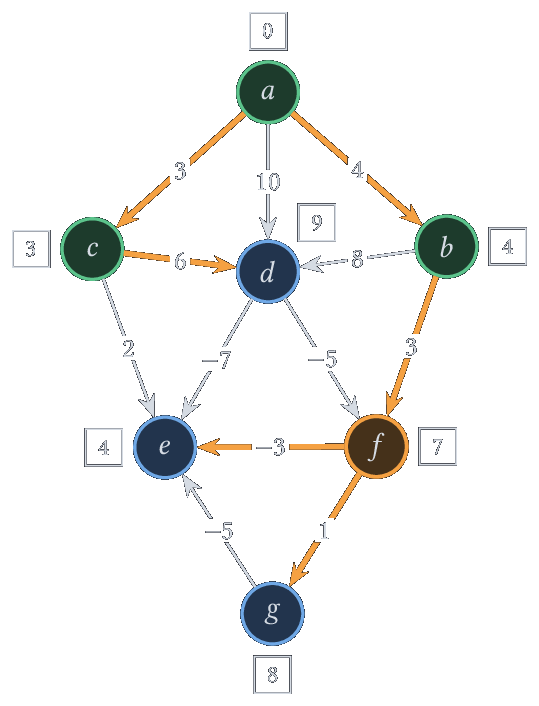
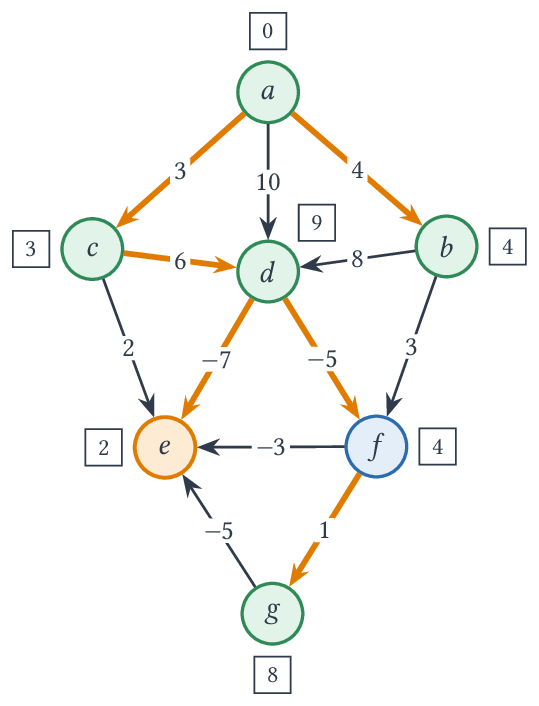
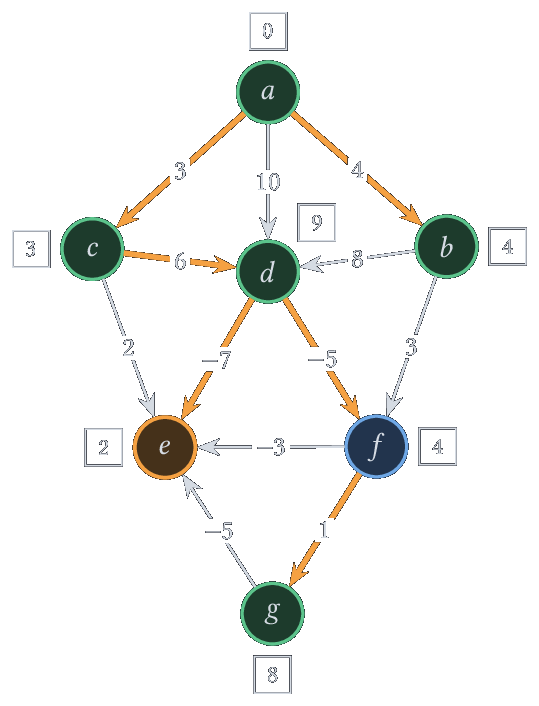
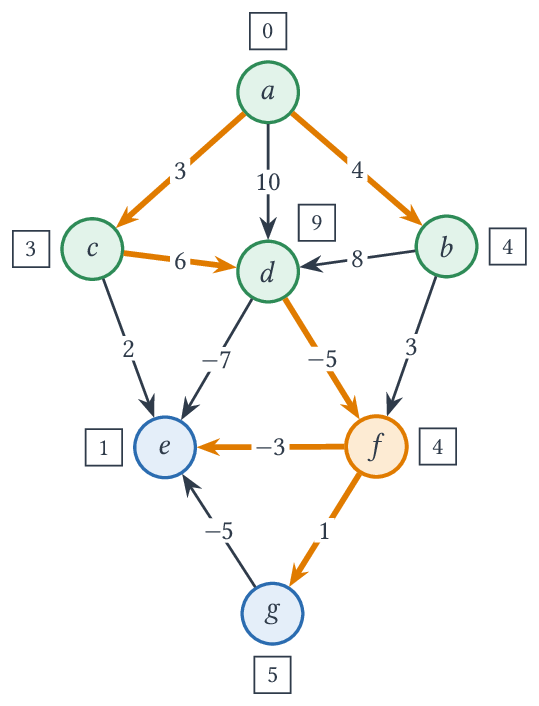
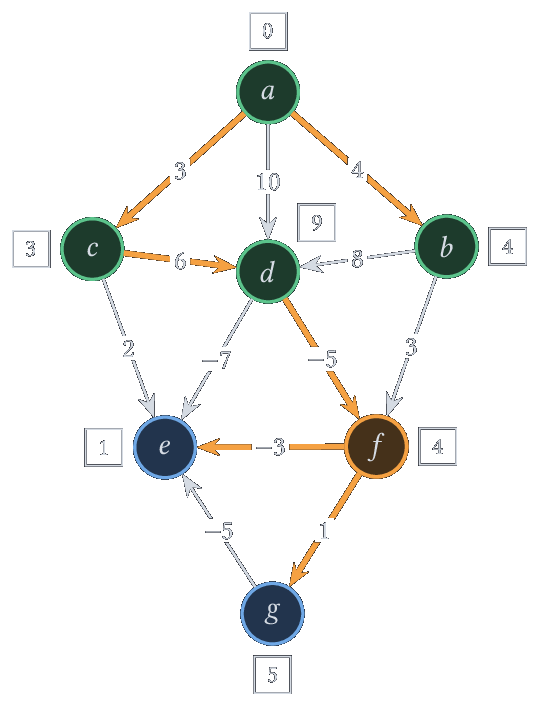
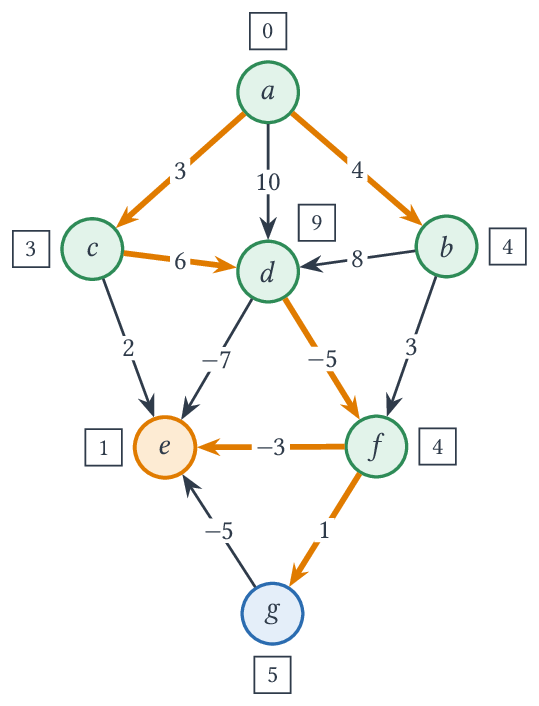
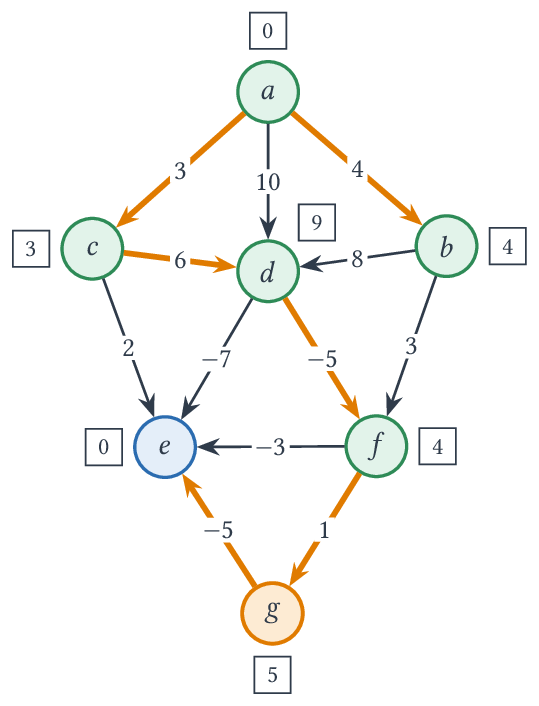
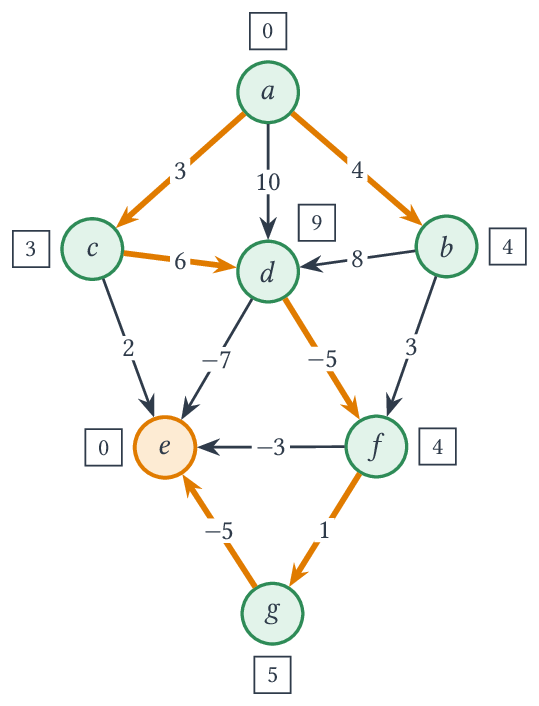
Contrairement à cet exemple, on constate, comme on l'a fait dans le paragraphe précédent, qu'avec des poids positifs l'algorithme se comporte particulièrement bien et d'une manière assez proche du parcours en largeur. Notamment, un sommet n'est placé qu'une fois sur la file de priorité : quand il en est retiré, \(d\) vaut déjà sa distance à \(s\) (c'est ce qu'on a montré pour l'algorithme de Dijkstra) et ne diminuera plus. On constate donc une vague de traitement qui progresse linéairement sur le graphe.
On peut donc se permettre de ne pas avoir à implémenter l'opération assez pénible de mise à jour de la priorité.
Remarque
Cette opération n'est pas vraiment compliquée dans un tas car il suffit de changer la valeur et de faire remonter l'élément le long de sa branche en direction de la racine en cas d'inversion de priorité. Le problème est qu'on a besoin de préserver un lien entre les sommets et leur emplacement dans le tas afin de savoir où est le nœud qui le contient. Le plus simple est de rajouter un dictionnaire, par exemple avec une table de hachage, mais cela alourdit conséquemment l'implémentation du tas car il faut maintenir l'intégrité du dictionnaire.
À la place, on va ajouter un sommet avec une autre priorité, meilleure, et il sera ainsi retiré avant. Pour ne pas traiter deux fois un sommet, on adopte alors une notion de marquage comme dans les parcours précédents. On retrouve ainsi l'algorithme de Dijkstra avec file de priorité présenté plus haut.
Floyd-Warshall
Pour résoudre le problème PlusCourtCheminToutCouple dans le cas d'un graphe orienté, l'algorithme de Floyd-Warshall va considérer une énumération \(x_1, \dots, x_n\) des sommets du graphe et construire une famille de matrices \(dist^{(k)}\) où \(dist^{(k)}(i, j)\) indique le poids d'un plus court chemin de \(x_i\) à \(x_j\) dont les sommets intermédiaires sont dans \(x_1, \dots, x_k\) lorsqu'un tel chemin existe, et \(\infty\) sinon.
On a donc \(dist^{(0)}(i, j) = \begin{cases} 0 \text{ si } i = j \\ \pi(x_i \rightarrow x_j) \text{ si } x_i \rightarrow x_j \in A \\ \infty \text{ sinon} \end{cases}\).
On remarque rapidement, en l'absence de cycle négatif, que ces matrices vérifient l'égalité, pour \(k > 0\) :
En effet, un plus court chemin pouvant être supposé élémentaire, soit il ne passe pas par \(x_k\), et son poids est \(dist^{(k-1)}(i,j)\), soit il passe exactement une fois par \(x_k\), et il se décompose en un chemin de \(x_i\) à \(x_k\) puis un chemin de \(x_k\) à \(x_j\) dont les sommets intermédiaires sont dans \(x_1, \dots, x_{k-1}\).
On en déduit un algorithme consistant à calculer successivement ces \(n+1\) matrices avec trois boucles for imbriquées.
Exemple
Si on considère le graphe
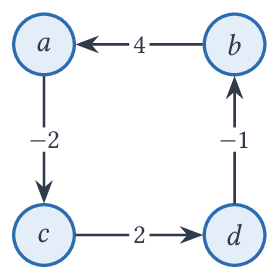
on va avoir la suite de matrices suivantes, dans l'ordre d'énumération alphabétique des sommets :
Une première version consisterait à calculer toutes les matrices, ce qui prend un espace en \(O(|S|^3)\). On peut optimiser cela avec une paire de matrices qui changent de rôle, mais on peut faire mieux. En effet, on a \(dist^{(k)}(i,k) = dist^{(k-1)}(i,k)\) car \(dist^{(k-1)}(k,k) = 0\) en l'absence de cycle négatif, et de même \(dist^{(k)}(k,j) = dist^{(k-1)}(k,j)\) : la ligne et la colonne \(k\) ne sont pas modifiées à l'étape \(k\). On en déduit donc qu'on peut effectuer le calcul en place dans une seule matrice. On obtient alors l'algorithme suivant :
Algorithme : Floyd-Warshall
Entrées :
- Un graphe pondéré \(G = (S,A,\pi)\) et une énumération \(x_1, \dots, x_n\) de \(S\)
Déroulement :
- On initialise une matrice \(d\) telle que \(d(i,i) = 0\), \(d(i,j) = \pi(x_i\rightarrow x_j)\) si \(x_i \rightarrow x_j \in A\) et \(d(i,j) = \infty\) sinon
- Pour k allant de 1 à n
- Pour i allant de 1 à n
- Pour j allant de 1 à n
- \(d(i,j) = \min(d(i,j), d(i,k)+d(k,j))\)
- Pour j allant de 1 à n
- Pour i allant de 1 à n
On en déduit le programme suivant, où le graphe est donné, comme pour Dijkstra, par listes d'adjacence pondérées et où les sommets sont numérotés à partir de \(0\). En OCaml et en C, on teste explicitement \(\infty\) pour ne pas dépasser la capacité des entiers.
def floyd_warshall(g):
    n = len(g)
    inf = float('inf')
    d = [ [ inf ] * n for _ in range(n) ]
    for i in range(n):
        d[i][i] = 0
        for j, poids in g[i]:
            d[i][j] = poids
    for k in range(n):
        for i in range(n):
            for j in range(n):
                if d[i][k] + d[k][j] < d[i][j]:
                    d[i][j] = d[i][k] + d[k][j]
    return d
let floyd_warshall g =
    let n = Array.length g in
    let inf = max_int in
    let d = Array.make_matrix n n inf in
    for i = 0 to n - 1 do
        d.(i).(i) <- 0;
        List.iter (fun (j, poids) -> d.(i).(j) <- poids) g.(i)
    done;
    for k = 0 to n - 1 do
        for i = 0 to n - 1 do
            for j = 0 to n - 1 do
                if d.(i).(k) <> inf && d.(k).(j) <> inf
                   && d.(i).(k) + d.(k).(j) < d.(i).(j)
                then d.(i).(j) <- d.(i).(k) + d.(k).(j)
            done
        done
    done;
    d
#include <stdlib.h>
#include <limits.h>

#define INF INT_MAX

// Renvoie la matrice des distances (à libérer avec libere_matrice)
int **floyd_warshall(graphe_pondere g) {
    int n = g.n;
    int **d = malloc(n * sizeof(int *));
    for (int i = 0; i < n; i++) {
        d[i] = malloc(n * sizeof(int));
        for (int j = 0; j < n; j++) {
            d[i][j] = INF;
        }
        d[i][i] = 0;
        for (int a = 0; a < g.degre[i]; a++) {
            d[i][g.voisins[i][a].but] = g.voisins[i][a].poids;
        }
    }
    for (int k = 0; k < n; k++) {
        for (int i = 0; i < n; i++) {
            for (int j = 0; j < n; j++) {
                if (d[i][k] != INF && d[k][j] != INF
                    && d[i][k] + d[k][j] < d[i][j]) {
                    d[i][j] = d[i][k] + d[k][j];
                }
            }
        }
    }
    return d;
}

void libere_matrice(int **d, int n) {
    for (int i = 0; i < n; i++) {
        free(d[i]);
    }
    free(d);
}
En l'absence de cycle de poids négatif, la matrice obtenue vérifie ainsi \(d(i,j) = dist(x_i,x_j)\). La complexité est en \(O(|S|^3)\) en temps et \(O(|S|^2)\) en espace.
Remarque
Il est aussi possible d'imposer que les plus courts chemins soient de longueur au moins 1, ce qui va mettre des \(\infty\) sur la diagonale dans \(dist^{(0)}\) et qui permettra, en fin d'algorithme, d'en déduire la présence de cycles ainsi que le poids d'un plus court cycle passant par \(x_i\) dans \(d(i,i)\).
Il y a de nombreux contextes dans lesquels la détermination d'une matrice des plus petits poids est suffisante. Cependant, si on a également besoin des chemins eux-mêmes, il est possible de construire une matrice de parenté \(P\) où \(P_{ij}\) indique le prédécesseur de \(x_j\) dans un plus court chemin de \(x_i\) à \(x_j\). On utilisera le symbole \(\perp\) quand un tel chemin n'existe pas (ou quand \(i = j\)).
Pour calculer \(P\) il suffit d'adapter l'algorithme précédent en considérant les \(P^{(k)}\) et en posant :
Puis,
Ce qui revient à changer le prédécesseur selon la résolution du \(\min\).
Remarque
- En appliquant Floyd-Warshall à un graphe quelconque, on peut détecter la présence de cycles de poids négatifs. En effet, si un tel cycle existe, on aura nécessairement \(d(i,i) < 0\) à la fin pour un sommet \(x_i\) de ce cycle.
- Floyd-Warshall a une application importante dans le cas du calcul de la fermeture transitive d'un graphe. En effet, il suffit de considérer la matrice d'adjacence au départ et d'appliquer Floyd-Warshall pour en déduire la matrice d'adjacence de la fermeture réflexive et transitive (en remplaçant les 0 hors de la diagonale par des \(\infty\)) où les arêtes sont en plus pondérées par la longueur d'un plus court chemin qui la réalise.