Note
Roadmap :
- finir l'écriture avec
Python. - rajouter
OCamletC. - en profiter pour faire une introduction aux références en
OCamlquitte à rajouter une partie spécifique. - rajouter beaucoup d'exemples et d'exercices.
Introduction
Dans ce chapitre introductif sur la programmation, on va présenter celle-ci à travers quatre notions permettant de comprendre ce que signifie programmer. Un certain soin a été porté au fait de rendre cette présentation indépendante du langage tout en permettant qu'elle serve de support pour l'apprentissage d'un langage particulier. Ainsi, les éléments propres à un langage donné sont clairement séparés.
Comme nous l'avons vu dans le chapitre d'introduction, la programmation consiste à décrire des algorithmes et la manière dont ils sont mis en œuvre sur une machine. En cela, le modèle que l'on suit ici est celui de la programmation dite impérative structurée. Pour autant, de nombreuses notions présentées ici restent valides dans d'autres paradigmes.
La présentation faite ici est indépendante du langage sous réserve que celui-ci comporte des traits impératifs structurés. Pour autant, selon les langages certaines notions sont plus ou moins riches. Des paragraphes spécifiques complètent ainsi le texte et on encourage le lecteur à basculer d'un langage à un autre tout au long de la lecture.
C est un langage ayant peu d'expressivité directe pour les données. On est
donc très vite réduit à devoir définir ses propres structures pour l'enrichir.
Or, c'est plus complexe que la mise en œuvre des notions impératives
développées ici. Le lecteur complétera alors sa lecture par le chapitre
d'introduction aux structures de données en C.
Python est le langage d'abord le plus aisé sur ces notions, mais aussi celui
pour lequel il est vraiment nécessaire d'avoir une discipline d'utilisation
afin de ne pas faire n'importe quoi. Ainsi, on a fait le choix de faire une
présentation sans artifice qui n'utilise pas de structures ou de mécanismes
propres à Python et problématiques. Ceux-ci sont esquissés en remarque en
précisant en quoi ils sont effectivement à manipuler avec parcimonie.
OCaml est un langage qui est avant tout fonctionnel déclaratif. Pour autant,
il possède des traits impératifs et permet d'écrire aussi naturellement des
programmes impératifs que dans des langages comme C ou Python. Cependant,
cette couche impérative se rajoute par-dessus la couche fonctionnelle et on
supposera que le lecteur la maîtrise déjà. Ainsi, dans la présentation qui
suit, on se concentrera sur l'exposition spécifique des notions impératives.
Les quatre étages de la programmation
Programmer c'est
- représenter des données, allant du booléen valant vrai ou faux, jusqu'aux bases de données permettant de modéliser des relations complexes
- manipuler ces données en lien avec un environnement, ce qui signifie autant de pouvoir les stocker que de pouvoir les transformer
- répéter ces manipulations élémentaires, car les données sont d'une taille finie, mais non connue à l'avance
- abstraire les notions précédentes pour ne pas avoir à se répéter, à travers la notion de fonctions
Exemple
Prenons un exemple simple pour comprendre les différents étages où le but final est de pouvoir calculer des sommes comme \(1^2 + 2^2 + \dots + n^2\).
Représenter Un entier comme 3 est une donnée qu'on pourra représenter telle quelle dans la
plupart des langages avec cependant des limitations à garder en tête : la
mémoire étant finie, on ne peut pas représenter des entiers quelconques, car il
y en a une infinité. Déjà, à ce stade, on peut se poser la question de savoir
si on ne veut représenter que des entiers dans un intervalle fixe, afin de
borner leur occupation mémoire, ou si on veut les représenter en
précision arbitraire. On peut opérer sur ces entiers avec un opérateur tel que
+ pour l'addition, mais le choix de la représentation aura son importance sur
ce qui se cache derrière cette opération. L'addition de deux très grands
entiers en précision arbitraire prendra plus de temps.
À l'aide de cela, on peut ainsi écrire 1*1 + 2*2 + 3*3 + 4*4 + 5*5.
Manipuler On peut aussi les stocker directement en mémoire à l'aide de variables. Ainsi
int x = 3;
x = 3
let x = ref 3
permettra de définir une variable nommée \(x\) et contenant la valeur entière \(3\). On peut alors manipuler cette variable en changeant sa valeur à l'aide des opérations :
x = x + 2;
x = x + 2
x := !x + 2
Avec ces instructions de manipulation, on peut reprendre le calcul précédent de \(1^2+2^2+\dots+5^2\) avec une suite d'instructions :
int s = 0;
s = s + 1*1;
s = s + 2*2;
s = s + 3*3;
s = s + 4*4;
s = s + 5*5;
s = 0
s = s + 1*1
s = s + 2*2
s = s + 3*3
s = s + 4*4
s = s + 5*5
let s = ref 0 in
s := !s + 1*1;
s := !s + 2*2;
s := !s + 3*3;
s := !s + 4*4;
s := !s + 5*5
Répéter
En fait, les 5 instructions d'ajout qu'on vient d'écrire ont la même structure :
il s'agit d'ajouter une valeur \(i^2\) à la variable s avec \(i\) prenant tour à tour les valeurs 1,
2, 3, 4 et 5. Une structure comme une boucle va permettre d'éviter cette
répétition et d'écrire qu'il existe une variable i prenant ces valeurs et les
instructions à réaliser pour chaque valeur de i. On pourra donc écrire :
int s = 0;
for(int i = 1; i <= 5; i++)
{
    s = s + i*i;
}
s = 0
for i in range(1,5+1):
    s = s + i*i
let s = ref 0 in
for i = 1 to 5 do
    s := !s + i*i
done
C'est en fait très proche de la notation \(1^2+2^2+\dots+5^2=\sum_{i=1}^5 i^2\). En fait, cette notation mathématique est très proche d'une boucle.
Abstraire Imaginons qu'on ait besoin d'effectuer le calcul précédent \(\sum_{i=1}^n i^2\) à plusieurs reprises pour différentes valeurs de \(n\), on pourrait à chaque fois recopier ces lignes en changeant la valeur maximale prise par \(i\). Mais c'est inefficace pour plusieurs raisons :
- en recopiant du code, on risque de propager et répéter des erreurs. Si jamais on découvre une meilleure manière de faire le calcul, il faudra ainsi changer le code à chaque endroit où on l'a copié.
- là où on a besoin de ce calcul, il est possible que ce soit pour faire d'autres choses avec et donc qu'il s'inscrive dans une logique complexe. En copiant le code, on rend le programme plus compliqué à comprendre, car la boucle pour calculer cette somme est mise sur le même plan que le code qui nous intéresse.
Pour faire un parallèle avec les mathématiques, c'est comme si on recopiait une preuve dans un cas particulier chaque fois qu'on a besoin d'appliquer un théorème.
On introduit ainsi une notion d'abstraction les fonctions qui vont nous permettre de faire un code générique de calcul en prenant \(n\) en paramètre.
int somme_carres(int n)
{
    int s = 0;
    for(int i = 1; i <= n; i++)
    {
        s = s + i*i;
    }
    return s;
}
def somme_carres(n):
    s = 0
    for i in range(1,n+1):
        s = s + i*i
    return s
let somme_carres n =
    let s = ref 0 in
    for i = 1 to n do
        s := !s + i*i
    done;
    !s
Comme on le verra, une telle fonction est caractérisée par son nom qui nous permet d'y faire référence, comme lorsqu'on applique le théorème de Thalès, ainsi que des arguments qui seront, à l'exécution, remplacés par les valeurs qui nous intéressent, comme le fait que Thalès est démontré dans un triangle générique mais on l'applique sur un triangle particulier et une valeur de retour qui correspond à ce que la fonction calcule.
On peut alors, quand on a besoin de faire le calcul de \(\sum_{i=1}^5 i^2\) juste écrire :
somme_carres(5)
somme_carres(5)
somme_carres 5
Se remettre sans cesse à l'ouvrage
De notre présentation étagée, on pourrait retenir une hiérarchisation des différents étages. Il n'en est rien.
Ainsi, autant il peut être assez direct de représenter des données, comme dans le cas précédent, autant cela peut être une étape cruciale que de choisir la meilleure représentation. C'est le cas quand on s'intéresse au choix d'une structure de données la plus adaptée ou quand on conçoit un schéma de base de données.
La programmation, et plus largement l'informatique, sont ainsi à rapprocher d'un art martial comme l'Aïkido où on travaille tout au long de sa pratique les mêmes gestes simples en se perfectionnant sans cesse. Aller au bout de ce chapitre ne sera donc pas le signe qu'on maîtrise la programmation, mais juste qu'on a fait le premier pas sur la voie du perfectionnement.
Tout au long des autres chapitres, on verra ainsi des méthodes, des notions, qui permettent de mieux comprendre et de mieux pratiquer la programmation. Mais au moment où on se retrouvera à programmer, on ne sortira pas de ces quatre étages.
Représenter
Les données sont regroupées en informatique autour de la notion de types. Un type de données peut être vu en première approximation comme un ensemble de données de même nature. On considère, par exemple, usuellement le type des entiers naturels ou celui des nombres à virgule flottante.
Les données simples
Les données les plus simples sont celles qui correspondent à des valeurs numériques. Elles dépendent assez souvent des langages de programmation, mais on retrouve toujours un type pour les booléens, un type pour les entiers et un type pour les nombres à virgule flottante, c'est-à-dire pour des représentations de certains nombres réels.
On a ainsi :
- le type
intdes entiers bornés, le plus souvent codés sur 32 bits, c'est-à-dire compris entre \(-2^{31}\) et \(2^{31}-1\). Les opérations sont+ - * / %où, entre deux entiers,/est la division entière et%le reste. Un dépassement de capacité sur unintest une erreur de programmation dont le comportement n'est pas défini par le langage. Il existe d'autres types entiers (unsigned int,long,int64_t, ...) qu'on verra selon les besoins. - le type
doubledes nombres à virgule flottante comme1.4ou-3.14, avec les opérations+ - * /. Ici/est une vraie division, mais attention :1 / 2vaut0car c'est une division entre deuxint, alors que1.0 / 2vaut0.5. - le type
booldes booléens, qui nécessite d'inclure<stdbool.h>, avec les deux valeurstrueetfalseet les opérations!(négation),&&(conjonction) et||(disjonction). Les opérateurs de comparaison sont== != > >= < <=. Historiquement,Cn'avait pas de booléens et utilisait des entiers :0pour faux et toute autre valeur pour vrai. C'est encore ce qui se passe en coulisses. - le type
chardes caractères comme'a', qui sont en fait de petits entiers (le code du caractère).
On a ainsi :
- le type
intdes entiers en précision arbitraire muni des opérations usuelles+ - * // % **en prenant garde au fait que//est la division entière (et%le reste). Ces opérations prennent d'autant plus de temps que les nombres ont beaucoup de chiffres. - le type
floatdes nombres à virgule flottante comme1.4ou-3.14. On verra plus loin les nombres de \(\R\) qui sont ainsi représentables. Les opérations sont alors+ - * / **. On remarque qu'on a une vraie division avec/et ainsi1 / 2renvoie unfloatcorrespondant à \(\frac{1}{2}\). -
le type
booldes booléens qui ne comporte que deux valeursTrueetFalseet des opérations suivantes :- la négation
notqui permet de passer deTrueàFalseet réciproquement. - la conjonction
andtelle queb1 and b2soitTruelorsqueb1etb2sont égaux àTrueetFalsesinon - la disjonction
ortelle queb1 or b2soitFalselorsqueb1etb2sont égaux àFalseetTruesinon
Les booléens sont particulièrement importants, car ils correspondent au type des comparaisons. On dispose des opérateurs de comparaison
== != > >= < <=qui correspondent aux relations mathématiques \(= \neq > \ge < \le\) (l'égalité==et!=existent pour tous les types, les comparaisons d'ordre pour les nombres, les chaînes, les tuples, ...). - la négation
-
le type
NoneTypeassez particulier qui ne contient qu'une seule valeurNoneet aucune opération. Ce type permet de donner un sens à l'absence de valeur, comme pour une fonction qui ne renvoie rien.
On a ainsi :
- le type
intdes entiers bornés, codés sur 63 bits sur une machine 64 bits : ils sont compris entremin_intetmax_int\(= 2^{62} - 1\). Les opérations sont+ - * / modoù/est la division entière etmodle reste. En cas de dépassement, le calcul se fait modulo \(2^{63}\) sans erreur. - le type
floatdes nombres à virgule flottante comme1.4ou-3.14. Les opérations ont des noms différents de celles des entiers :+. -. *. /. **. Il n'y a aucune conversion implicite,1 + 2.0est une erreur de typage et on écritfloat_of_int 1 +. 2.0. - le type
booldes booléens avec les valeurstrueetfalseet les opérationsnot,&&et||. Les opérateurs de comparaison sont= <> > >= < <=. Attention,==et!=existent aussi mais testent l'égalité physique (même emplacement mémoire) : on ne les utilise pas pour comparer des valeurs. - le type
chardes caractères comme'a'. - le type
unitqui ne contient que la valeur(). C'est le type des expressions qui ne renvoient rien d'intéressant, c'est-à-dire des instructions.
Remarque
Les divisions entières ne se comportent pas de la même manière sur les
nombres négatifs : en C et en OCaml, le quotient est arrondi vers zéro et
-7 / 2 vaut -3 (avec un reste -1), alors qu'en Python il est arrondi
vers \(-\infty\) et -7 // 2 vaut -4 (avec un reste 1). Dans tous les cas,
on a bien \(-7 = 2q + r\).
Les données composées ou structurées
Les données simples permettent de tout représenter. En effet, l'élément de donnée le plus primitif est le bit qui correspond à un booléen. Ainsi, la mémoire d'un ordinateur est entièrement constituée de booléens. Mais en disant cela, on ne dit pas grand-chose, car il ne s'agit pas d'une soupe informe de booléens, mais d'une organisation structurée. C'est ainsi qu'on considère des données composées comme les tableaux ou les couples.
On distingue deux types de données composées :
- les données immuables, c'est-à-dire celles qui ne permettent pas de changer les valeurs qu'elles regroupent ni leur structure après leur création
- les données mutables qui le permettent.
Les données composées sont rudimentaires en C :
- (mutable) les tableaux, de taille fixée à la déclaration, dont les
éléments sont tous du même type :
int t[3] = {1, 3, 4};. On accède à l'élément d'indicei, en numérotant à partir de 0, avect[i]. Il n'y a pas de moyen de retrouver la taille d'un tableau à partir du tableau lui-même : on doit la conserver à part, par exemple dans une variable. - les chaînes de caractères comme
"bonjour"sont des tableaux dechardont la fin est signalée par un caractère spécial'\0'. Les chaînes écrites directement dans le programme ne doivent pas être modifiées. - (mutable) les structures, qui regroupent plusieurs valeurs de types
éventuellement différents dans des champs nommés, à la manière d'un
\(n\)-uplet. On les verra dans le chapitre sur les structures de données en
C.
Les principaux types de données composées sont :
-
(immuable) les
tuplesqui permettent de représenter des \(n\)-uplets de valeurs de types quelconques. On les écrit comme en mathématiques :(1, 3.2, 4).Un tuple ne contenant qu'un seul élément doit tout de même faire apparaître la virgule pour le distinguer d'une valeur. Ainsi on écrit
(1,)car(1)est juste la valeur1. Le tuple vide s'écrit().On dispose d'un opérateur de concaténation
+qui permet de créer un tuple obtenu en mettant bout à bout deux autres tuples. Ainsi(1,2) + (3,4,5)est le tuple(1,2,3,4,5). En mathématiques, si \(b\) est entier naturel on a \(a \times b = a + ... + a\) où on ajoute \(b\) fois \(a\). De même, on dispose d'une opération*telle que(1,2) * 3corresponde à(1,2) + (1,2) + (1,2), c'est-à-dire au tuple(1,2,1,2,1,2).On obtient la taille d'un tuple à l'aide de
len. En effet,len( (1,2,3) )renvoie 3. Attention aux doubles parenthèses ici, on le verra,lenest une fonction et les parenthèses sont nécessaires pour l'appliquer, mais le tuple lui-même s'écrit avec des parenthèses.On accède aux différentes composantes d'un tuple avec la construction
t[i]oùtest un tuple etiest l'indice de la composante en commençant par numéroter à0. Ainsi(1, 3.2, 4)[1]est la valeur3.2. On peut aussi utiliser des indices négatifs : pour \(1 \le k \le\)len(t),t[-k]désignet[len(t)-k], ainsi on peut écriret[-1]plutôt quet[len(t)-1]pour accéder à la dernière composante. Un indice en dehors de ces valeurs provoque une erreur. -
(immuable) les
strou chaînes de caractères qui permettent de représenter des textes comme'bonjour'ou"au revoir". On utilise indifféremment'ou"mais il faut que ce soit le même symbole qui ouvre et ferme une chaîne. Il n'y a pas de type spécifique pour les caractères enPython: ce sont des chaînes de longueur 1 comme'a'.Les opérations sont les mêmes que pour les tuples avec
+pour la concaténation,lenpour la longueur ou[i]pour accéder au ième caractère. C'est quelque chose qu'on retrouvera pour la plupart des types composés qui sont des suites d'éléments, on parle de séquences. -
(mutable) les
listou tableaux qui correspondent à des tuples dont on peut modifier les valeurs ou même modifier la structure, comme en ajoutant ou en supprimant des éléments. Cela correspond alors à des manipulations et non des opérations, et on les verra au paragraphe suivant.Pour définir un tableau, on écrit comme un tuple mais avec des crochets. Ainsi on peut écrire
[1,3.2,3]. Le tableau vide est[]et comme il n'y a pas d'ambiguïté, un tableau contenant un unique élément se note juste[1].Là encore, on dispose des opérations communes de concaténation, longueur et accès.
-
(mutable) les
dictou dictionnaires, qui permettent de réaliser des associations entre des valeurs immuables et d'autres valeurs. On peut ainsi considérer une valeur comme{ 'nom' : 'Michel', 'prenom' : 'Louise', 42 : True }les valeurs à gauche du:sont les clés qui permettent d'accéder aux valeurs, comme lorsqu'on cherche un mot dans un dictionnaire pour accéder à sa définition.Ici, on ne dispose plus de concaténation, car ça ne voudrait pas dire grand-chose d'ajouter deux dictionnaires (que fait-on si une même clé est présente dans les deux ?). On dispose toutefois de
lenpour le nombre d'associations et il est possible d'accéder à la valeur associée à une clé en écrivantd[cle]oùdest une valeur de typedictetcleune clé présente dansd.Le dictionnaire vide est
{}et on verra dans le paragraphe suivant comment manipuler un dictionnaire pour ajouter ou supprimer des associations.
Les principaux types de données composées sont :
- (immuable) les \(n\)-uplets comme
(1, 3.2, 4)de typeint * float * int. On accède aux composantes par filtrage :let (a, b, c) = t in ...(ou avecfstetsndpour un couple). - (immuable) les chaînes de caractères comme
"bonjour", de typestring, avec^pour la concaténation,String.length spour la longueur ets.[i]pour le caractère d'indicei. - (immuable) les listes comme
[1; 3; 4], de typeint list, dont tous les éléments ont le même type. Ce sont des données inductives qu'on manipule principalement par filtrage et récursivité. - (mutable) les tableaux comme
[|1; 3; 4|], de typeint array, de taille fixée à la création, dont tous les éléments ont le même type. On obtient la taille avecArray.length t, on accède à l'élément d'indiceiavect.(i)et on crée un tableau de taillenrempli dexavecArray.make n x. - (mutable) les enregistrements dont certains champs ont été déclarés
mutable, comme danstype point = { mutable x : int; mutable y : int }. - (mutable) les tables de hachage du module
Hashtbl, qui jouent le rôle des dictionnaires.
Manipuler
Variables
L'élément clé permettant de manipuler des valeurs est de pouvoir les placer à un endroit et de changer la valeur qui s'y trouve. C'est ce qu'on appelle une variable. Même si cela ne correspond pas à une réalité selon les langages, il est d'usage de considérer une variable comme une case mémoire disposant d'un nom et dans laquelle on place des valeurs.
On a alors trois éléments :
- définir une variable, souvent en la limitant à un certain type de donnée, on parle de déclaration
- accéder à sa valeur
- changer sa valeur, on parle d'assignation
Les noms de variables sont le plus souvent composés de lettres, de chiffres et
du symbole _, ils doivent commencer par une lettre (ou _).
Une variable se déclare en précisant son type, éventuellement avec une valeur initiale :
int x;      // déclaration seule
int y = 3;  // déclaration avec initialisation
x = y + 2;  // assignation
Le type d'une variable est fixé une fois pour toutes : x ne pourra
contenir que des int. Pour accéder à la valeur d'une variable, il suffit
d'écrire son nom dans une expression, comme y + 2.
Attention, une variable déclarée sans initialisation contient une valeur indéterminée (ce qui se trouvait à cet endroit de la mémoire) : la lire avant de lui avoir assigné une valeur est une erreur classique.
Il n'existe pas de mécanisme spécifique pour déclarer une variable
distinct de l'assignation. Ainsi, on écrira x = 3 à la fois pour déclarer une
variable nommée x contenant la valeur 3 et pour changer la valeur de x.
Pour accéder à la valeur d'une variable, il suffit d'écrire son nom directement
dans une expression. Ainsi, on pourra écrire x+2 pour la valeur obtenue en
ajoutant 2 à la valeur de x.
Les valeurs en Python sont typées mais pas les variables. Ainsi on pourra
tout à fait écrire
x = 3 # déclare une variable x contenant un entier
# puis plus loin
x = 'Bonjour' # maintenant x contient une chaîne
Un nom défini par let x = 3 n'est pas une variable au sens de ce
chapitre : il désigne la valeur 3 et on ne pourra jamais changer cette
association. D'ailleurs, x = 4 n'est pas une assignation mais une
comparaison qui renvoie false.
Pour disposer d'une variable, on utilise une référence, créée avec ref,
qui est une case mémoire contenant une valeur qu'on peut modifier. On lit son
contenu avec ! et on le change avec := :
# let x = ref 3;;
val x : int ref = {contents = 3}
# !x + 2;;
- : int = 5
# x := 4;;
- : unit = ()
# x;;
- : int ref = {contents = 4}
Une référence a un type fixé : x : int ref ne pourra contenir que des
entiers, et x := "bonjour" provoque une erreur de typage. Il faut bien
distinguer x, qui est la case mémoire, de !x, qui est son contenu :
écrire x + 2 est une erreur de typage.
État d'exécution
L'ensemble des variables et des valeurs auxquelles elles sont associées à un moment de l'exécution d'un programme est un état d'exécution. Les instructions de déclaration et d'assignation modifient ainsi l'état.
Suite aux instructions
int a = 3;
int b = 2;
a = 3
b = 2
let a = ref 3
let b = ref 2
l'état est alors
| variable | valeur |
|---|---|
a |
3 |
b |
2 |
Si on exécute ensuite l'instruction
b = a;
b = a
b := !a
il devient
| variable | valeur |
|---|---|
a |
3 |
b |
3 |
Dans la suite, on pourra noter a=3, b=3 un tel état. Ici, le = permet une
notation intuitive.
Instructions et blocs
Les programmes qu'on va écrire vont maintenant être des suites d'instructions, comme
int x = 3;
int y = x + 2;
x = y;
x = 3
y = x + 2
x = y
let x = ref 3 in
let y = ref (!x + 2) in
x := !y
Ces instructions sont regroupées ensemble sous une notion de blocs. Suivant les langages, ces blocs sont plus ou moins explicites.
Un bloc est délimité par des accolades. Chaque bloc définit sa propre notion de portée.
{
    int x = 3;
    int y = 2;

    x = y + 2;
    { // bloc imbriqué
        int y = 4;
    } // la portée de ce y s'arrête ici

    x = y + 2; // ici y n'est pas celui du bloc imbriqué
}
Un bloc est un groupement d'instructions à la suite qui sont
toutes alignées dans le texte du programme. On dispose ainsi d'une indentation
signifiante, c'est-à-dire que cet alignement a du sens et il est directement
compris par Python pour savoir si une instruction appartient à un bloc ou
non.
Ainsi, on ne pourra pas écrire
x = 3
   y = x + 2 # non aligné avec le reste du bloc
x = y
En OCaml, il n'y a pas à proprement parler de notion de blocs car tout est
une expression. Cependant, l'opérateur ; permet d'évaluer successivement deux
expressions. On pourra donc écrire
x := 3;
y := !x + 2;
x := !y
pour exécuter successivement ces instructions. On remarque que, contrairement à
certains langages, ; n'est pas un terminateur mais un séparateur : il est
inutile de terminer par ;.
Comme la valeur des expressions à gauche de ; est perdue, on suppose qu'on ne
le fait que pour des expressions dont la valeur est () : unit, c'est-à-dire
pour les instructions. Si jamais on utilise ; avec une expression ayant une
autre valeur à gauche, un avertissement nous indique que l'usage est
problématique :
# 3 ; 2;;
Warning 10 [non-unit-statement]: this expression should have type unit.
- : int = 2
Les blocs ont souvent besoin d'être séparés du reste du programme comme on le verra dans la suite. Pour cela, comme il s'agit de simples expressions, on peut utiliser les parenthèses comme ici :
(x := 3;
y := !x + 2;
x := !y)
mais il est souvent plus clair d'utiliser la paire begin/end qui, bien
qu'elle soit strictement équivalente à une paire de parenthèses, permet de
faire apparaître le fait qu'on a un bloc :
begin
    x := 3;
    y := !x + 2;
    x := !y
end
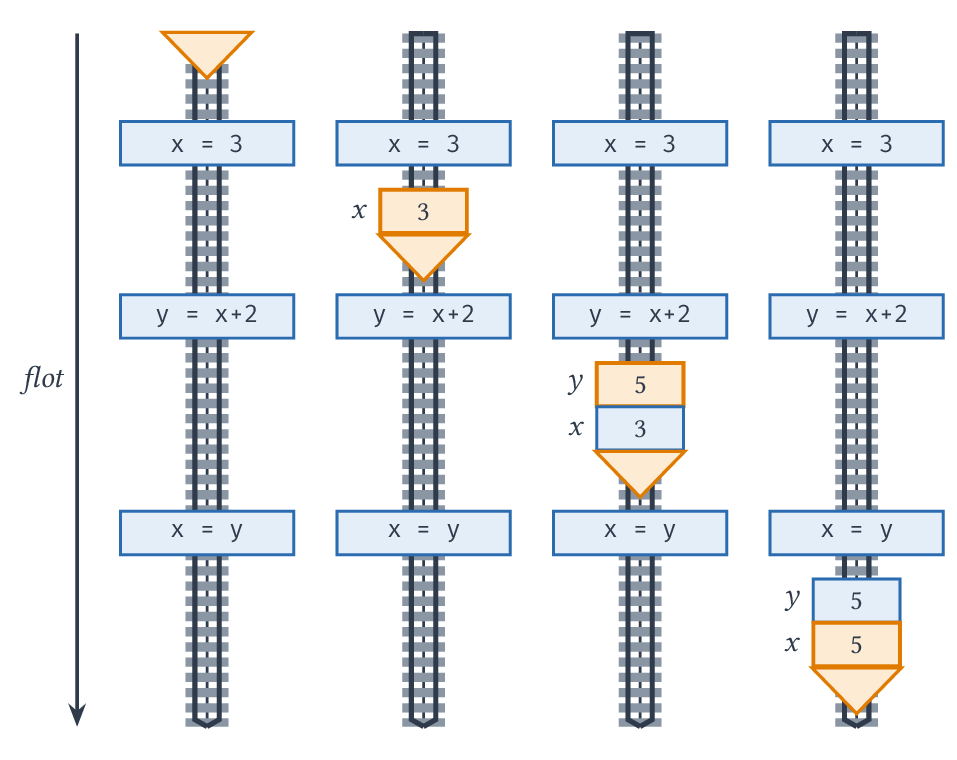
Derrière cette notion de bloc on trouve une notion implicite qui est celle de flot d'exécution et qui régit la manière dont les instructions sont exécutées. En accord avec la manière dont on écrit les programmes, les instructions sont exécutées de haut en bas. L'état d'exécution est alors modifié le long du flot.
Une analogie qui sera utile dans la suite est de voir l'état d'un programme comme un train qui circule à travers les rails du flot de contrôle, en rajoutant ou modifiant des wagons à chaque instruction présentée comme un arrêt. Cette image assez naïve permet de faire passer une idée très importante qui est celle de l'ordre d'évaluation et du contexte associé.
Un exemple important est celui de l'échange du contenu de deux variables a et b. On ne
peut pas écrire
b = a;
a = b;
b = a
a = b
b := !a;
a := !b
car comme on vient de le voir, la valeur de b est déjà perdue après la
première assignation. Une solution consiste alors à introduire une variable
temporaire qui ne va servir que de support pour pouvoir garder la valeur de
b. On écrira ainsi :
// ici, on ne peut pas le faire de manière
// générique, cela dépend du type de a et b.
int temp = b;
b = a;
a = temp;
temp = b
b = a
a = temp
let temp = !b in
b := !a;
a := temp (* pas besoin que temp soit une ref *)
Portée
Une variable a une durée de vie, souvent, elle n'existe que localement dans un programme. Par exemple, uniquement au sein de la fonction ou du bloc dans laquelle on l'a définie. On parle de portée d'une variable pour désigner l'ensemble des instructions dans lesquelles on peut y accéder.
La portée d'une variable s'étend de sa déclaration jusqu'à la fin du bloc
qui la contient, comme on l'a vu avec le y du bloc imbriqué. Une variable
déclarée dans l'en-tête d'une boucle for, comme i dans
for(int i = 1; i <= 5; i++), n'existe que dans cette boucle. Une
variable déclarée en dehors de toute fonction est dite globale et est
accessible partout dans la suite du fichier.
La portée des variables est assez dynamique. On peut ainsi définir une variable uniquement dans certains cas comme on le verra avec une instruction conditionnelle. Ce qui fait que selon l'état d'un programme, on définira différemment la portée d'une même variable.
La portée est explicite : dans let x = e1 in e2, le nom x n'est
accessible que dans l'expression e2. Un let x = e écrit au niveau
global, sans in, est accessible dans toute la suite du programme. Comme
une référence est une valeur comme une autre, ces règles s'appliquent aussi
aux variables créées avec ref.
Manipuler des données composées mutables
Les types de données mutables permettent de modifier leur valeur. Ce sont le plus souvent des collections, c'est-à-dire des arrangements structurés de valeurs, comme un tableau qui les arrange en ligne de la première à la dernière. Lorsqu'on peut faire un accès direct à une valeur, on peut alors la modifier comme si c'était une variable. Il peut également être possible de faire des modifications sur la structure de la collection elle-même, comme enlever ou rajouter des éléments.
Modification des valeurs des éléments
Pour un tableau t de \(n\) éléments, t[i] se comporte comme une variable
pour \(i \in \range{0}{n-1}\) : on peut écrire t[i] = 3. De même, pour une
structure p ayant un champ x, on écrit p.x = 3.
int t[3] = {1, 0, 2};
t[0] = 3;    // t contient 3, 0, 2
t[2] = t[1]; // t contient 3, 0, 0
Attention, C ne vérifie pas les indices : accéder à t[3] ou t[-1]
est un comportement indéfini. Le programme peut s'arrêter, mais il peut
aussi lire ou écraser silencieusement une autre donnée de la mémoire. C'est
une source majeure d'erreurs, et de failles de sécurité.
On a vu deux types mutables : les tableaux (list) et les dictionnaires
(dict).
-
Pour une variable
tcontenant un tableau de \(n\) éléments, on peut accéder àt[i]pour \(i \in \range{0}{n-1}\) comme si c'était une variable. Ainsi, on pourra écriret[i] = 3pour changer la valeur à la ième case par3. Un tableau peut ainsi être vu comme une suite finie de variables. Si jamais on accède en lecture comme en écriture àt[j]quand \(j \not\in \range{-n}{n-1}\), cela va déclencher une erreur et non ajouter une association entre \(j\) et cette valeur.Ainsi, il n'est pas possible de changer la structure d'un tableau par des assignations.
Si on exécute la suite d'instructions
t = [1, 0, 2]
t[0] = 3
t[2] = t[1]
L'état va alors passer de
t=[1, 0, 2]àt=[3, 0, 2]puist=[3, 0, 0].Tout se passe comme si on avait trois variables
t0, t1, t2avec les instructions :t0 = 1 t1 = 0 t2 = 2 t0 = 3 t2 = t1 -
Pour une variable
dcontenant un dictionnaire, on peut accéder àd[c], oùcest une clé présente dansd, en lecture comme en écriture. Si on assigne une valeur àd[c]alors quecn'est pas une clé présente dans le dictionnaire, elle sera alors ajoutée. Ce qui fait que, contrairement au cas des tableaux, il est possible de modifier la structure du dictionnaire à l'aide d'assignation.Si on considère la suite d'instructions
d = { 'a' : 2, 'test' : 3 }
d['a'] = 4
d['b'] = d['test']
On passe de l'état
d={ 'a' : 2, 'test' : 3 }àd={ 'a' : 4, 'test' : 3 }puisd={ 'a' : 4, 'test' : 3, 'b' : 3 }(l'ordre d'affichage des associations est l'ordre d'insertion).
-
Pour un tableau
tde \(n\) éléments et \(i \in \range{0}{n-1}\), on modifie l'élément d'indiceiavect.(i) <- v. Un indice hors de ces bornes déclenche l'exceptionInvalid_argument "index out of bounds".let t = [|1; 0; 2|] in t.(0) <- 3; (* t = [|3; 0; 2|] *) t.(2) <- t.(1) (* t = [|3; 0; 0|] *) -
Pour un enregistrement
rayant un champ mutablex, on écritr.x <- v. Une référence n'est d'ailleurs rien d'autre qu'un enregistrement avec un unique champ mutablecontents, etx := vest une abréviation dex.contents <- v. - Pour une table de hachage
d,Hashtbl.replace d c vassocievà la cléc, en ajoutant l'association sicn'était pas présente, etHashtbl.find d crenvoie la valeur associée àc(ou déclenche l'exceptionNot_found).
Partages de valeurs composées entre plusieurs variables
Il y a une différence fondamentale entre écrire
a = 3
b = a
a = 2
et écrire
a = [ 3 ]
b = a
a[0] = 2
Dans le premier cas, lors de l'assignation b = a, il n'y a pas de lien entre
la valeur 3 dans a et celle dans b. Dans le second cas, après b = a, on
a b et a qui pointent vers le même tableau. On notera b, a = [ 3 ] cet
état. Ainsi, quand on exécute l'instruction a[0] = 2 on modifie le tableau
qui est également associé à b. Donc a et b sont associées au tableau
[ 2 ].
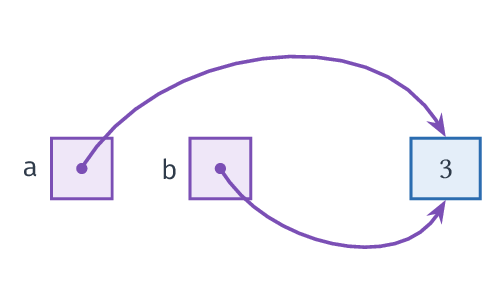
En fait, quand on écrit a = [ 3 ], on ne stocke pas la valeur du tableau
dans a. On crée le tableau [ 3 ] en mémoire et on place dans a une
référence vers ce tableau. Quand on exécute alors b = a, on place dans b
une autre référence mais vers le même tableau. Une manière simple de voir cela
est de représenter les références par des flèches, ainsi l'état pourrait en
fait se représenter ainsi :
Si on considère un tableau de tableau comme [ [ 0 ], [ 1 ] ] on aura alors
dans les cases du tableau principal des références vers les deux tableaux [ 0 ] et [ 1 ] :
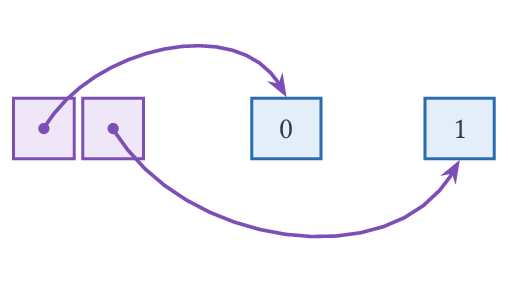
Ainsi, si on écrit
t = [ [ 0 ], [ 1 ] ]
t[1] = t[0]
t[1][0] = 2
on aura alors les deux références qui pointent vers le même tableau, et quand
on modifie t[1][0], on modifie donc forcément t[0][0] également pour
aboutir à l'état :
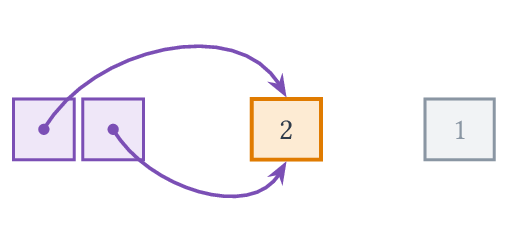
On peut remarquer que plus rien ne fait référence ici au tableau [ 1 ]. Il y a
un mécanisme dans Python qui détecte cela et qui supprime de la mémoire le
tableau.
Ce qui vient d'être dit pour les tableaux en Python est encore vrai avec les dictionnaires, et plus généralement avec la plupart des données.
Modification de la structure des données composées
Pour parler de modification de tableaux ou de dictionnaires, il est nécessaire
de comprendre que Python est un langage objet. On se contentera ici de dire
qu'un objet est une donnée munie d'opérations de manipulation sur cette donnée.
Ainsi, si t est un tableau, on pourra écrire t.append(x) pour ajouter la
valeur x comme une nouvelle case à la fin du tableau. t.append(x) est une
instruction, elle ne renvoie pas un nouveau tableau avec cette modification
mais elle modifie directement t. On dit que .append est une méthode de la
classe list de t. Il est tout à fait possible d'utiliser Python sans
écrire de classes, mais dans la mesure où c'est un langage objet dans son
cœur, on manipulera forcément des objets.
Par exemple, la suite d'instructions :
t = []
t.append(2)
t.append(3)
va faire passer l'état de t = [] à t = [ 2 ] puis t = [ 2, 3 ].
Il existe beaucoup de méthodes pour les types list et dict. On les verra
selon les besoins dans la suite. Il est toutefois possible, et souhaitable, de
se référer à la documentation pour avoir une description détaillée de
celles-ci.
Instruction conditionnelle
L'instruction conditionnelle va permettre d'enrichir le flot de contrôle avec des branchements. Elle permet d'orienter le flot d'exécution dans un bloc ou dans un autre selon qu'une condition soit vérifiée ou non.
On écrit
if (condition)
{
    // bloc si la
    // condition est vérifiée
}
else
{
    // bloc si la
    // condition n'est pas
    // vérifiée
}
Les parenthèses autour de la condition sont obligatoires.
if condition:
    # bloc si la
    # condition est vérifiée
else:
    # bloc si la
    # condition n'est pas
    # vérifiée
En OCaml il y a des expressions conditionnelles qui ont déjà été vues mais
qui maintenant prennent une autre signification avec des expressions contenant
des instructions. Dans le contexte de la programmation impérative, on pourra
utiliser begin/end pour accentuer les différences :
if condition
then
  begin
    (* bloc si la condition
    est vérifiée *)
  end
else
  begin
    (* bloc si la condition
    n'est pas vérifiée *)
  end
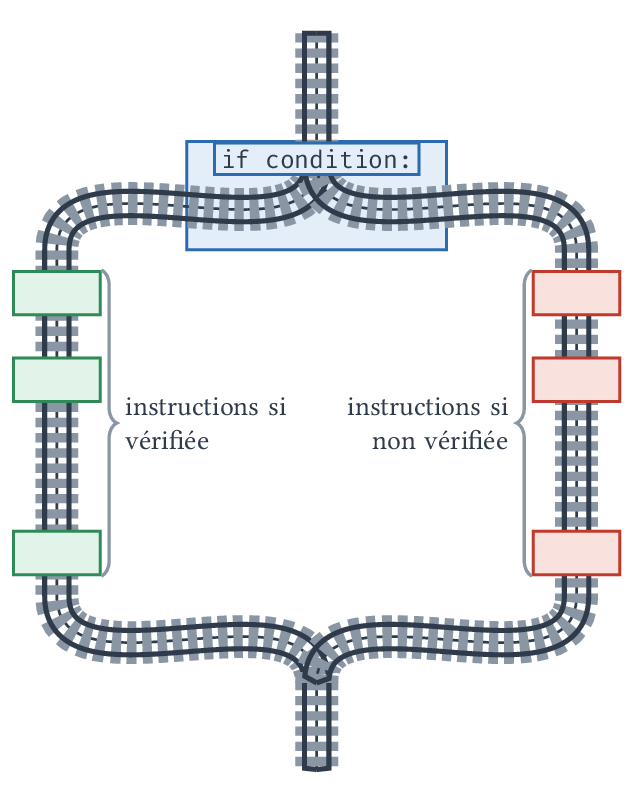
Si on reprend l'analogie des trains et des rails, une instruction conditionnelle est un échangeur qui, selon que le train vérifie ou pas la condition va le faire circuler dans une branche ou une autre. Il est important de comprendre qu'une fois une branche exécutée, les flots se rejoignent sur l'instruction qui suit l'instruction conditionnelle.
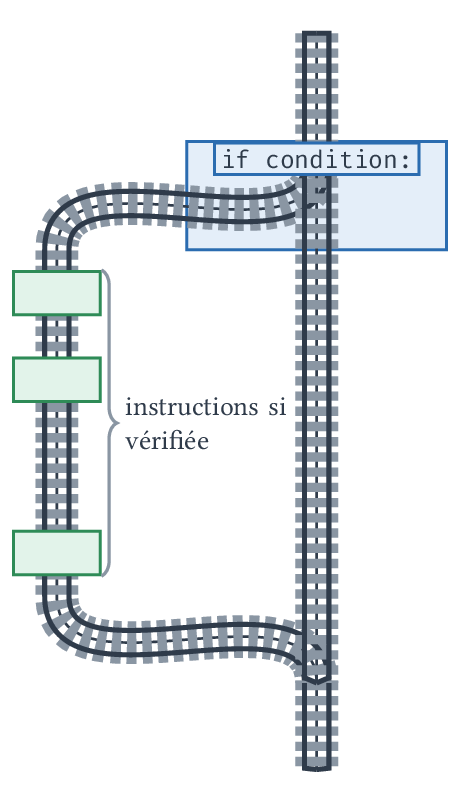
Il arrive qu'on n'ait rien à faire dans une branche, on peut alors placer un
bloc vide, mais, en général, on préfère, quitte à nier la condition, ne pas
écrire de else comme dans :
if condition:
    # bloc si la
    # condition est vérifiée
# le flot saute directement ici si
# la condition n'est pas vérifiée
Remarque
En Python, un bloc vide se note pass comme dans le programme suivant :
if x == 3:
    y = y + 1 # incrémente y si x vaut 3
else:
    pass # ne fait rien sinon
qu'on aurait pu écrire :
if x == 3:
    y = y + 1 # incrémente y si x vaut 3
On pourrait être tenté d'écrire l'instruction a priori inoffensive y = y
dans le bloc du else, mais une telle instruction n'est pas forcément gratuite.
En Python, y = y ne fait que recopier une référence (voir plus loin), mais
dans d'autres langages, comme C avec des structures, une assignation recopie
la donnée, ce qui peut être coûteux, et une opération comme y = y + 0 peut
construire une nouvelle valeur. C'est donc une bonne pratique de ne pas écrire
des opérations qui, si pour nous elles ne font rien, peuvent en fait avoir
un coût caché.
Un principe clé de la programmation est la compositionnalité des instructions de gestion de flot : on peut placer des instructions conditionnelles dans le corps d'une des branches. On pourra donc écrire
if condition1:
    if condition2:
        # bloc si condition 1 et condition 2 sont vérifiées
    else:
        # bloc si condition 1 est vérifiée mais condition 2 ne l'est pas
else:
    if condition2:
        # bloc si condition 1 n'est pas vérifiée et condition 2 l'est
    else:
        # bloc si condition 1 et condition 2 ne le sont pas
Conditions et opérations sur les booléens
Le rôle des conditions est central dans l'usage des instructions conditionnelles et ainsi c'est très important de bien comprendre le fonctionnement des booléens et de leurs opérations.
Une condition est une formule logique constituée
- de formules atomiques portant sur l'état comme
x == 3,x < 2, ... - d'opérateurs booléens pour relier ces formules :
not,andouor
Remarque
Les opérateurs and et or (&& et || en C et en OCaml) sont évalués
paresseusement de la gauche vers la droite : dans a and b, si a est
faux, b n'est même pas évalué puisque le résultat est forcément faux. De
même, dans a or b, b n'est pas évalué si a est vrai. C'est très utile
pour protéger un accès :
if i < len(t) and t[i] == x:
    # ici, on est sûr que t[i] existe
Écrire la condition dans l'autre ordre, t[i] == x and i < len(t),
provoquerait une erreur lorsque i est hors du tableau.
Inversion de point de vue par rapport aux mathématiques
En mathématiques, il est courant d'avoir des définitions de valeurs par cas. Par exemple, on pourrait écrire
On pourrait le traduire alors aisément ainsi :
if y % 2 == 0:
    x = y // 2
else:
    x = (y-1) // 2
Mais en faisant cela, on a inversé le point de vue en plaçant la condition
avant l'affectation de x.
Les trois langages disposent d'une expression conditionnelle qui permet de
conserver le point de vue mathématique, où l'on définit x par cas :
x = (y % 2 == 0) ? y / 2 : (y - 1) / 2;
x = y // 2 if y % 2 == 0 else (y - 1) // 2
En OCaml, if ... then ... else ... est toujours une expression, c'est
même son usage principal :
let x = if y mod 2 = 0 then y / 2 else (y - 1) / 2
On réserve cette écriture aux cas simples : dès que les branches contiennent plusieurs instructions, l'instruction conditionnelle est plus lisible.
Instructions conditionnelles en cascade
Il est fréquent d'avoir plus de deux cas. On pourrait imbriquer des
instructions conditionnelles dans les branches else, mais l'indentation
deviendrait vite illisible. On dispose donc d'une écriture en cascade, où les
conditions sont testées dans l'ordre et seul le bloc de la première condition
vérifiée est exécuté. Par exemple, pour calculer le signe d'un entier :
int s;
if (x > 0)
{
    s = 1;
}
else if (x < 0)
{
    s = -1;
}
else
{
    s = 0;
}
if x > 0:
    s = 1
elif x < 0:
    s = -1
else:
    s = 0
let s =
    if x > 0 then 1
    else if x < 0 then -1
    else 0
Remarque
L'ordre des conditions compte. Pour attribuer une mention à une note sur 20,
si on teste note >= 10 avant note >= 16, la branche « très bien » ne
sera jamais atteinte. Quand les cas se recouvrent, il faut tester du plus
restrictif au moins restrictif.
Entrées et sorties
Un programme communique avec son environnement : il lit des entrées (clavier, fichier, ...) et produit des sorties (affichage à l'écran, écriture dans un fichier, ...). Ces opérations modifient l'environnement et sont donc, elles aussi, des instructions.
On affiche avec printf (après #include <stdio.h>), qui prend une chaîne
de format où %d (entier), %f (flottant), %c (caractère) ou %s
(chaîne) sont remplacés par les valeurs suivantes :
printf("x vaut %d et y vaut %f\n", x, y);
On lit symétriquement avec scanf("%d", &x);. Le & sera expliqué avec la
notion de pointeur.
On affiche avec print(x, y), qui sépare les valeurs par des espaces et
termine par un retour à la ligne. On lit une ligne au clavier avec input(),
qui renvoie toujours une chaîne qu'on convertit si besoin :
n = int(input()). Les fichiers sont traités dans le chapitre sur les
entrées-sorties en Python.
On affiche avec print_int, print_string, print_newline (), ... ou avec
Printf.printf qui fonctionne comme en C :
Printf.printf "x vaut %d et y vaut %f\n" !x !y
On lit une ligne au clavier avec read_line (), qui renvoie une chaîne, ou un
entier avec read_int ().
Remarque
Afficher une valeur et la renvoyer sont deux choses très différentes. Une fonction qui affiche son résultat au lieu de le renvoyer ne peut pas être réutilisée dans un calcul. Dans ce cours, les fonctions renverront leur résultat et l'affichage sera réservé à la communication avec l'utilisateur.
Répéter
Jusqu'ici, on a vu des instructions permettant de manipuler l'état d'exécution, éventuellement de manière différente selon sa valeur à l'aide d'instructions conditionnelles. Mais étant donné un état de départ, on connait déjà les instructions qui seront exécutées et surtout on connait leur nombre qui est majoré par le nombre total d'instructions. En effet, pour reprendre l'analogie des trains, ceux-ci ne font que descendre le long du flot et le nombre d'arrêts rencontrés est majoré par le nombre d'arrêts total.
Cependant, la force principale de l'informatique vient du fait qu'on peut, à l'aide d'un nombre d'instructions fini, avoir la potentialité d'exécuter un nombre arbitrairement grand d'instructions. À cette fin, nous allons introduire un élément fondamental : la notion de répétition ou de boucles.
On pourrait être étonné de la formulation précédente sur ce nombre
arbitrairement grand car la mémoire, et même le temps d'exécution en pratique,
étant fini, tout est borné. Si on considère un programme qui va calculer la
somme des éléments d'un tableau et qu'on sait que la longueur d'un tel tableau est
majorée, on pourrait imaginer une énorme instruction conditionnelle en
cascade traitant séparément chaque longueur possible : si le tableau est de
longueur 0, la somme vaut 0, s'il est de longueur 1, c'est t[0], s'il est de
longueur 2, c'est t[0] + t[1], et ainsi de suite. Un tel programme aurait
une taille proportionnelle à la borne, il serait illisible, et il faudrait le
réécrire dès que la borne change. Une boucle permet au contraire de décrire
une seule fois ce qu'on fait pour un élément, indépendamment du nombre
d'éléments.
Répéter \(n\) fois
La boucle la plus simple consiste à répéter un bloc d'instructions un nombre
de fois connu à l'avance, en disposant d'une variable, appelée indice de
boucle, qui prend successivement des valeurs entières consécutives. C'est la
boucle de somme_carres vue en introduction. Par exemple, pour calculer \(x^n\) :
int p = 1;
for (int i = 0; i < n; i++)
{
    p = p * x;
}
L'en-tête for (initialisation; condition; mise à jour) est très général :
on exécute l'initialisation, puis, tant que la condition est vraie, on
exécute le bloc puis la mise à jour. La forme ci-dessus, où i prend les
valeurs \(0, 1, \dots, n-1\), est de loin la plus courante.
p = 1
for i in range(n):
    p = p * x
range(n) désigne les entiers \(0, 1, \dots, n-1\) et, plus généralement,
range(a, b) désigne les entiers de \(a\) inclus à \(b\) exclu. C'est
pourquoi on a écrit range(1, n+1) dans somme_carres. On peut préciser un
pas : range(n-1, -1, -1) parcourt \(n-1, n-2, \dots, 0\).
let p = ref 1 in
for _ = 1 to n do
    p := !p * x
done
for i = a to b do ... done fait prendre à i les valeurs de \(a\) à \(b\)
inclus, et for i = b downto a do ... done les parcourt dans l'ordre
décroissant. Quand l'indice ne sert pas dans le corps, on peut le nommer
_.
Remarque
On ne modifie jamais l'indice de boucle dans le corps de la boucle. En
OCaml, c'est impossible car i n'est pas une référence. En Python, une
assignation i = 10 dans le corps n'a d'effet que jusqu'à la fin de
l'itération courante, i reprenant ensuite la valeur suivante de range.
En C, c'est possible mais rend le programme très difficile à comprendre.
Répéter pour chaque élément
Un cas très fréquent consiste à effectuer un traitement pour chaque élément d'une collection, par exemple d'un tableau.
Comme on ne peut pas retrouver la taille d'un tableau, on la transmet avec lui et on parcourt les indices :
for (int i = 0; i < n; i++)
{
    // traitement de t[i]
}
On peut parcourir directement les éléments d'une séquence (tableau, tuple, chaîne, ...) sans passer par les indices :
for x in t:
    # traitement de x
Si on a besoin des indices, on écrit for i in range(len(t)):.
On parcourt les indices :
for i = 0 to Array.length t - 1 do
    (* traitement de t.(i) *)
done
On peut aussi utiliser Array.iter (fun x -> ...) t, ou List.iter pour une
liste, qui appliquent une fonction à chaque élément.
On distingue alors deux schémas classiques selon ce que l'on cherche à calculer.
Accumulateur
On utilise une variable, l'accumulateur, qui contient le résultat pour les éléments déjà parcourus et qu'on met à jour à chaque élément. Pour la somme des éléments d'un tableau :
int somme(int t[], int n)
{
    int s = 0;
    for (int i = 0; i < n; i++)
    {
        s = s + t[i];
    }
    return s;
}
def somme(t):
    s = 0
    for x in t:
        s = s + x
    return s
let somme t =
    let s = ref 0 in
    for i = 0 to Array.length t - 1 do
        s := !s + t.(i)
    done;
    !s
La propriété « après avoir traité les \(k\) premiers éléments, s contient leur
somme » est vraie avant la boucle (\(k = 0\), la somme vide vaut 0) et reste vraie
après chaque itération. C'est un invariant de boucle, notion qu'on
précisera plus bas. En fin de boucle, il assure que s contient la somme de
tous les éléments. En particulier, la fonction renvoie bien 0 pour un tableau
vide.
Le choix de la valeur initiale est crucial. Pour le maximum, il n'y a pas d'élément neutre parmi les entiers : on initialise avec le premier élément, ce qui suppose que le tableau est non vide.
int maximum(int t[], int n)
{
    assert(n > 0);
    int m = t[0];
    for (int i = 0; i < n; i++)
    {
        if (t[i] > m)
        {
            m = t[i];
        }
    }
    return m;
}
def maximum(t):
    m = t[0]
    for x in t:
        if x > m:
            m = x
    return m
let maximum t =
    let m = ref t.(0) in
    for i = 0 to Array.length t - 1 do
        if t.(i) > !m
        then m := t.(i)
    done;
    !m
Remarque
Initialiser m à 0 serait une erreur : sur un tableau ne contenant que des
nombres négatifs, la fonction renverrait 0, qui n'est même pas un élément du
tableau.
Drapeau
Pour savoir si au moins un élément vérifie une propriété, on utilise un
booléen, appelé drapeau, initialisé à faux et qu'on lève, c'est-à-dire
qu'on passe à vrai, dès qu'on rencontre un tel élément. Pour tester si x
apparait dans t :
bool appartient(int x, int t[], int n)
{
    bool trouve = false;
    for (int i = 0; i < n; i++)
    {
        if (t[i] == x)
        {
            trouve = true;
        }
    }
    return trouve;
}
def appartient(x, t):
    trouve = False
    for y in t:
        if y == x:
            trouve = True
    return trouve
let appartient x t =
    let trouve = ref false in
    for i = 0 to Array.length t - 1 do
        if t.(i) = x
        then trouve := true
    done;
    !trouve
Remarque
Une erreur classique consiste à écrire trouve = (y == x) dans la boucle :
le drapeau est alors baissé dès qu'un élément suivant est différent de x,
et la fonction ne teste plus que le dernier élément.
Pour tester si tous les éléments vérifient une propriété, on fait l'inverse : un drapeau initialisé à vrai qu'on baisse dès qu'on trouve un contre-exemple.
Ici, on continue à parcourir le tableau même après avoir trouvé x. En C et
en Python, on peut interrompre la fonction avec return dès qu'on l'a
trouvé, ce qu'on verra dans la partie sur les fonctions. En OCaml, on peut
utiliser une boucle while ou les exceptions.
Répéter tant qu'une condition est vérifiée
Il arrive qu'on ne connaisse pas à l'avance le nombre de répétitions. On utilise alors une boucle tant que, qui teste une condition avant chaque itération et s'arrête dès qu'elle est fausse. Par exemple, pour calculer la plus petite puissance de 2 supérieure ou égale à un entier \(n\) :
int p = 1;
while (p < n)
{
    p = 2 * p;
}
p = 1
while p < n:
    p = 2 * p
let p = ref 1 in
while !p < n do
    p := 2 * !p
done
Si la condition est fausse dès le départ, ici si \(n \le 1\), le corps n'est
jamais exécuté. À l'inverse, rien ne garantit qu'une boucle tant que
s'arrête : si on avait écrit p = p * 1 par erreur, ou initialisé p à 0, la
boucle tournerait indéfiniment. Il faut donc justifier, pour chaque boucle,
qu'elle termine et qu'elle calcule bien ce qu'on attend, ce qu'on appelle
sa correction.
Variant et invariant de boucle
Définition
- Un variant de boucle est une quantité entière, dépendant de l'état, qui est positive ou nulle tant que la condition de boucle est vraie et qui décroît strictement à chaque itération.
- Un invariant de boucle est une propriété de l'état qui est vraie avant la première itération et qui, si elle est vraie au début d'une itération, l'est encore à la fin de celle-ci.
Théorème
- Une boucle qui admet un variant termine.
- Si une boucle termine, un invariant est vrai en sortie de boucle, en même temps que la négation de la condition de boucle.
Preuve
- Si la boucle effectuait une infinité d'itérations, les valeurs successives du variant formeraient une suite infinie strictement décroissante d'entiers naturels, ce qui est impossible.
- Par récurrence sur le nombre \(k\) d'itérations effectuées, l'invariant est vrai après \(k\) itérations : c'est la définition pour \(k = 0\) et pour le passage de \(k\) à \(k + 1\). On sort de la boucle quand la condition est fausse.
Ainsi, pour prouver qu'une boucle est correcte, on cherche un invariant qui, combiné à la négation de la condition, donne le résultat voulu.
Pour prouver qu'une quantité est un variant, on vérifie donc trois points : elle est entière, elle est positive tant qu'on entre dans la boucle et elle diminue strictement à chaque itération. Pour un invariant \(I\), on vérifie l'initialisation (\(I\) est vraie avant la première itération) et l'hérédité (\(I\) vraie en début d'itération implique \(I\) vraie en fin d'itération).
Exemple
On calcule le quotient et le reste de la division euclidienne d'un entier \(a \ge 0\) par un entier \(b > 0\) par soustractions successives :
int q = 0;
int r = a;
while (r >= b)
{
    q = q + 1;
    r = r - b;
}
// ici, q est le quotient et r le reste
def division(a, b):
    q = 0
    r = a
    while r >= b:
        q = q + 1
        r = r - b
    return (q, r)
let division a b =
    let q = ref 0 in
    let r = ref a in
    while !r >= b do
        q := !q + 1;
        r := !r - b
    done;
    (!q, !r)
Sur l'entrée \((10, 4)\), les valeurs successives de \((q, r)\) sont \((0, 10)\), \((1, 6)\) puis \((2, 2)\) et on renvoie \((2, 2)\) : on a bien \(10 = 2 \times 4 + 2\).
Terminaison. La quantité \(r\) est un variant :
- elle est entière car elle vaut \(a\) au départ et on ne fait que des soustractions d'entiers ;
- elle est positive car, si on entre dans la boucle, c'est que \(r \ge b\), donc \(r - b \ge 0\) ;
- elle diminue strictement car \(b > 0\), donc \(r - b < r\).
Correction. On considère l'invariant \(I(q, r) := bq + r = a \text{ et } r \ge 0\).
- Initialisation : \(b \times 0 + a = a\) et \(a \ge 0\), donc \(I(0, a)\) est vérifié avant la première itération.
- Hérédité : si \(I(q, r)\) est vérifié au début d'une itération, alors \(a = bq + r = b(q+1) + (r - b)\) et \(r - b \ge 0\) puisqu'on est entré dans la boucle, donc \(I(q+1, r-b)\) est vérifié en fin d'itération.
En sortie de boucle, on a \(I(q, r)\) et la négation de la condition, \(r < b\). Ainsi \(a = bq + r\) avec \(0 \le r < b\) : \((q, r)\) est bien le couple (quotient, reste) de la division euclidienne de \(a\) par \(b\).
Exercice
On considère la fonction suivante, qui calcule \(a^n\) pour \(n \ge 0\) par exponentiation rapide :
int puissance(int a, int n)
{
    int p = 1;
    while (n > 0)
    {
        if (n % 2 == 1)
        {
            p = p * a;
        }
        a = a * a;
        n = n / 2;
    }
    return p;
}
def puissance(a, n):
    p = 1
    while n > 0:
        if n % 2 == 1:
            p = p * a
        a = a * a
        n = n // 2
    return p
let puissance a n =
    let a = ref a in
    let n = ref n in
    let p = ref 1 in
    while !n > 0 do
        if !n mod 2 = 1
        then p := !p * !a;
        a := !a * !a;
        n := !n / 2
    done;
    !p
- Dérouler la fonction sur l'entrée \((2, 5)\).
- Donner un variant de boucle.
- Montrer à l'aide d'un invariant de boucle que la fonction renvoie \(a^n\).
Solution
- Les valeurs successives de \((a, n, p)\) sont \((2, 5, 1)\), \((4, 2, 2)\), \((16, 1, 2)\) puis \((256, 0, 32)\) et on renvoie \(32 = 2^5\).
- \(n\) est un variant : il est entier, positif, et si on entre dans la boucle, \(n > 0\) donc \(\lfloor n/2 \rfloor < n\).
-
On note \(\alpha\) et \(\eta\) les valeurs initiales de \(a\) et \(n\) et on considère l'invariant \(I(a, n, p) := a^n p = \alpha^\eta\).
- Initialisation : \(\alpha^\eta \times 1 = \alpha^\eta\), donc \(I(\alpha, \eta, 1)\) est vérifié.
- Hérédité : si \(I(a, n, p)\) est vérifié en début d'itération, deux cas se présentent. Si \(n = 2n'\), alors \(\alpha^\eta = a^n p = (a^2)^{n'} p\), donc \(I(a^2, n', p)\). Si \(n = 2n' + 1\), alors \(\alpha^\eta = a^n p = (a^2)^{n'} (ap)\), donc \(I(a^2, n', ap)\). Dans les deux cas, l'invariant est vérifié en fin d'itération.
En sortie de boucle, \(n = 0\) et \(I(a, 0, p)\) donne \(p = \alpha^\eta\).
Remarque : lors de la dernière itération, on calcule encore a * a alors
que cette valeur ne servira plus. En C, cela peut provoquer un dépassement
de capacité même quand le résultat tient dans un int (par exemple pour
\(7^{10}\)).
Choisir la structure de boucle adaptée
Une boucle for peut toujours se réécrire avec une boucle while en gérant
l'indice à la main, et réciproquement on peut simuler beaucoup de boucles
while avec un for qu'on interrompt. Mais choisir la bonne structure rend
le programme plus lisible et évite des erreurs :
| situation | boucle adaptée |
|---|---|
| nombre d'itérations connu avant d'entrer dans la boucle | for sur un intervalle d'entiers |
| traitement de chaque élément d'une collection | for sur les éléments (ou les indices) |
| arrêt dépendant d'une condition calculée au fil des itérations | while |
Une boucle for sur un intervalle termine toujours, sans qu'on ait besoin de le
prouver. Avec un while, on doit penser à la terminaison, et à ne pas oublier
la mise à jour des variables qui interviennent dans la condition.
Remarque
En Python, on ne modifie pas la structure d'une collection, par exemple en
supprimant des éléments d'un tableau, pendant qu'on la parcourt avec
for x in t : le parcours sauterait alors des éléments. On construit
plutôt une nouvelle collection.
Boucles imbriquées et dimensionnalité
Le corps d'une boucle peut lui-même contenir une boucle. Pour chaque itération de la boucle externe, la boucle interne est exécutée entièrement. Si la boucle externe fait \(n\) itérations et la boucle interne \(m\), le corps de la boucle interne est donc exécuté \(n \times m\) fois.
C'est la structure naturelle pour parcourir des données à deux dimensions, comme une matrice représentée par un tableau de tableaux : une boucle par dimension.
Une matrice de taille fixée se déclare int m[3][4]; et on accède à ses
éléments avec m[i][j].
On crée une matrice de n lignes et p colonnes remplie de 0 avec
[[0] * p for i in range(n)] et on accède à ses éléments avec m[i][j].
Attention, [[0] * p] * n semble faire la même chose mais crée un
tableau contenant n références vers le même tableau ligne, comme on
l'a vu dans la partie sur le partage : modifier m[0][0] modifierait alors
toute la première colonne.
On crée une matrice de n lignes et p colonnes remplie de 0 avec
Array.make_matrix n p 0 et on accède à ses éléments avec m.(i).(j).
Pour la même raison qu'en Python, il ne faut pas écrire
Array.make n (Array.make p 0).
La boucle interne peut aussi dépendre de l'indice de la boucle externe. Par
exemple, pour compter les inversions d'un tableau, c'est-à-dire les paires
d'indices \(i < j\) telles que t[i] > t[j] :
int compte_inversions(int t[], int n)
{
    int c = 0;
    for (int i = 0; i < n; i++)
    {
        for (int j = i+1; j < n; j++)
        {
            if (t[i] > t[j])
            {
                c = c + 1;
            }
        }
    }
    return c;
}
def compte_inversions(t):
    n = len(t)
    c = 0
    for i in range(n):
        for j in range(i+1, n):
            if t[i] > t[j]:
                c = c + 1
    return c
let compte_inversions t =
    let n = Array.length t in
    let c = ref 0 in
    for i = 0 to n - 1 do
        for j = i+1 to n - 1 do
            if t.(i) > t.(j)
            then c := !c + 1
        done
    done;
    !c
Un tableau est trié dans l'ordre croissant si et seulement s'il n'a aucune inversion. Ici, le test est effectué \(\sum_{i=0}^{n-1} (n - 1 - i) = \frac{n(n-1)}{2}\) fois. Compter ainsi le nombre d'itérations des boucles imbriquées est la base de l'analyse de la complexité des algorithmes.
Abstraire
Définir et appeler des fonctions
On a déjà écrit plusieurs fonctions dans ce chapitre. Une définition de fonction comporte :
- un nom, qui permettra de l'appeler ;
- des paramètres, qui sont des noms désignant les valeurs sur lesquelles la fonction travaille ;
- un corps, c'est-à-dire les instructions à exécuter, qui produisent éventuellement une valeur de retour.
Un appel de fonction consiste à donner des valeurs, les arguments, aux paramètres et à exécuter le corps. La valeur de l'appel est la valeur de retour.
int cube(int x)
{
    return x * x * x;
}
Le type de retour (int) et le type de chaque paramètre sont précisés.
On appelle la fonction avec cube(3). Une fonction doit être déclarée avant
son premier appel dans le fichier.
def cube(x):
    return x * x * x
On appelle la fonction avec cube(3). Les parenthèses sont obligatoires,
même sans argument : f().
let cube x =
    x * x * x
On appelle la fonction avec cube 3, sans parenthèses ni virgules :
f 2 3 pour une fonction à deux arguments. Une fonction sans argument
utile prend () en paramètre, comme print_newline ().
Il faut bien distinguer la définition, qui ne fait qu'associer le corps au nom sans rien exécuter, de l'appel, qui exécute le corps.
Action d'une fonction et valeur de retour
En C et en Python, l'instruction return e évalue e, termine
immédiatement l'exécution de la fonction et renvoie la valeur obtenue. On
peut s'en servir pour sortir d'une boucle dès qu'on connait le résultat, comme
dans ce test de primalité :
bool est_premier(int n)
{
    if (n < 2)
    {
        return false;
    }
    int d = 2;
    while (d * d <= n)
    {
        if (n % d == 0)
        {
            return false;
        }
        d = d + 1;
    }
    return true;
}
def est_premier(n):
    if n < 2:
        return False
    d = 2
    while d * d <= n:
        if n % d == 0:
            return False
        d = d + 1
    return True
En OCaml, il n'y a pas de return : la valeur d'une fonction est celle de
son corps. On intègre donc la condition d'arrêt à la boucle :
let est_premier n =
    let premier = ref (n >= 2) in
    let d = ref 2 in
    while !premier && !d * !d <= n do
        if n mod !d = 0
        then premier := false;
        d := !d + 1
    done;
    !premier
Pour retrouver un retour prématuré, on peut utiliser les exceptions.
On s'arrête à \(\sqrt{n}\) car si \(n = d d'\) avec \(2 \le d \le d'\), alors \(d^2 \le n\) : si \(n\) n'a pas de diviseur \(d\) avec \(2 \le d\) et \(d^2 \le n\), il est premier.
Une fonction peut aussi agir sur son environnement sans renvoyer de valeur intéressante : on parle d'effet de bord. C'est le cas d'un affichage ou de la modification d'un tableau passé en argument, comme l'échange de deux cases :
void echange(int t[], int i, int j)
{
    int temp = t[i];
    t[i] = t[j];
    t[j] = temp;
}
Le type de retour void indique que la fonction ne renvoie rien.
def echange(t, i, j):
    temp = t[i]
    t[i] = t[j]
    t[j] = temp
Une fonction sans return renvoie None.
let echange t i j =
    let temp = t.(i) in
    t.(i) <- t.(j);
    t.(j) <- temp
Le type de echange est 'a array -> int -> int -> unit.
Fonctions et portée
Les paramètres et les variables définies dans le corps d'une fonction sont locaux : ils n'existent que pendant l'appel et sont distincts des variables de même nom ailleurs dans le programme. Chaque appel dispose de ses propres variables locales, rangées dans la pile d'exécution, comme on le détaille dans le chapitre sur la récursivité.
Lors d'un appel, la valeur de chaque argument est recopiée dans le paramètre correspondant. Modifier un paramètre dans la fonction ne change donc pas la variable de l'appelant :
def incremente(x):
    x = x + 1    # ne modifie que la variable locale x

a = 3
incremente(a)    # a vaut toujours 3
En revanche, pour un tableau, ce qui est recopié est la référence vers le
tableau, comme on l'a vu dans la partie sur le partage : la fonction et
l'appelant manipulent alors le même tableau. C'est pourquoi echange
modifie bien le tableau de l'appelant. Il en va de même en C, où un tableau
passé en argument n'est pas recopié, et en OCaml pour les tableaux et les
références.
Remarque
En Python, une fonction peut lire une variable globale, mais une
assignation dans le corps crée une variable locale, sauf si on a écrit
global x au début de la fonction. Utiliser des variables globales rend le
comportement d'une fonction dépendant de tout le programme : on préfère
passer explicitement les valeurs en arguments et récupérer le résultat avec
return.
Structurer des programmes avec des fonctions
Pour écrire un programme, on le découpe en fonctions courtes, chacune résolvant un sous-problème clairement identifié. Chaque fonction est décrite par sa spécification :
- ce qu'elle prend en entrée, avec les hypothèses faites sur ces entrées, appelées
préconditions («
test non vide », « \(b > 0\) », ...) ; - ce qu'elle renvoie ou modifie, appelé postcondition.
Une fois une fonction écrite et prouvée, on peut l'utiliser en ne se souciant que de sa spécification, sans relire son code. Par exemple, pour compter les nombres premiers inférieurs ou égaux à \(n\) :
/* n : entier
   renvoie le nombre d'entiers premiers dans [0, n] */
int nb_premiers(int n)
{
    int c = 0;
    for (int k = 0; k <= n; k++)
    {
        if (est_premier(k))
        {
            c = c + 1;
        }
    }
    return c;
}
def nb_premiers(n):
    """n : entier
    renvoie le nombre d'entiers premiers dans [0, n]"""
    c = 0
    for k in range(n+1):
        if est_premier(k):
            c = c + 1
    return c
(* n : entier
   renvoie le nombre d'entiers premiers dans [0, n] *)
let nb_premiers n =
    let c = ref 0 in
    for k = 0 to n do
        if est_premier k
        then c := !c + 1
    done;
    !c
Si on trouve un test de primalité plus efficace, il suffira de modifier
est_premier : nb_premiers n'aura pas à changer.
On peut vérifier les préconditions à l'exécution avec assert, comme dans la
fonction maximum en C, et tester une fonction sur des cas dont on connait
le résultat, en pensant aux cas limites : assert nb_premiers(1) == 0,
assert nb_premiers(2) == 1, assert nb_premiers(100) == 25.
Les fonctions comme valeurs
Revenons à somme_carres. Si on veut maintenant calculer \(\sum_{i=1}^n i^3\)
ou \(\sum_{i=1}^n \frac{1}{i}\), on va réécrire la même boucle en changeant
seulement le terme ajouté. Pour abstraire ce terme, on passe la fonction
qui le calcule en argument : une fonction est alors une valeur comme une autre.
Pour information, C permet de passer en argument un pointeur de
fonction, avec une syntaxe assez lourde :
int somme_f(int (*f)(int), int n)
{
    int s = 0;
    for (int i = 1; i <= n; i++)
    {
        s = s + f(i);
    }
    return s;
}
On appelle alors somme_f(cube, 5).
def somme_f(f, n):
    s = 0
    for i in range(1, n+1):
        s = s + f(i)
    return s
On peut appeler somme_f(cube, 5) ou, sans nommer la fonction,
somme_f(lambda i: i * i, 5) qui renvoie 55.
C'est l'usage naturel en OCaml, où les fonctions sont des valeurs
comme les autres :
let somme_f f n =
    let s = ref 0 in
    for i = 1 to n do
        s := !s + f i
    done;
    !s
On peut appeler somme_f cube 5 ou somme_f (fun i -> i * i) 5 qui
renvoie 55. Le type inféré est (int -> int) -> int -> int.
On retrouve ici le fait que la notation \(\sum_{i=1}^n f(i)\) est elle-même une opération qui prend une fonction \(f\) en argument. Ces fonctions qui prennent ou renvoient des fonctions, dites d'ordre supérieur, sont au cœur de la programmation fonctionnelle.