Introduction
Ce chapitre fait directement suite au chapitre sur les langages réguliers.
Si on considère un programme OCaml comme :
let f x =
  let y = x + 3 in
  x * y
On a appris à détecter des suites de caractères particulières, on pourrait notamment identifier dans le programme précédent :
- des mots-clés comme
letouin; - des opérateurs comme
=,*,+; - des identificateurs comme
f,xouy; - des nombres comme
3.
Ces types correspondent à des langages réguliers. Dans le contexte de la reconnaissance de syntaxe, on parle de lexèmes (ou de token en anglais) et un programme qui découpe une suite de caractères en une liste de lexèmes est appelé un analyseur lexical (lexer en anglais).
Ici, on pourrait considérer un type OCaml token :
type token =
  | Keyword of string
  | Identifier of string
  | Number of int
  | Equals | Plus | Times
Et le programme précédent deviendrait alors la liste :
[ Keyword "let"; Identifier "f"; Identifier "x";
  Equals; Keyword "let"; Identifier "y";
  Equals; Identifier "x"; Plus; Number 3; Keyword "in";
  Identifier "x"; Times; Identifier "y" ]
Cependant, il ne suffit pas de savoir que les éléments sont bien
des lexèmes. En effet, x + 3 est une expression mais + x 3 n'en est pas une
car on considère que + est un opérateur infixe.
La question qu'on se pose maintenant est de savoir comment décider ce qui est une phrase valide du langage ou non. Il s'agit ainsi de raisonner sur la manière dont les lexèmes sont positionnés les uns par rapport aux autres : c'est la grammaire.
Tout d'abord, on peut commencer par abstraire le contenu des lexèmes car au moment où on analyse la phrase, il n'est pas important. On peut alors essayer de reconnaître par des règles d'inférence les phrases valides :
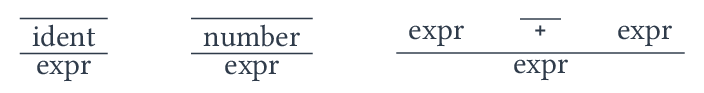
De gauche à droite, ces règles signifient :
- qu'un identificateur est une expression valide ;
- qu'un nombre est une expression valide ;
- que deux expressions séparées par un
+forment une expression valide.
On peut alors construire un arbre de dérivation comme dans le chapitre sur la déduction naturelle.
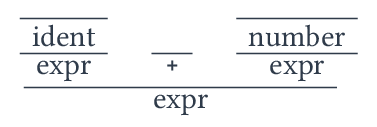
Il est traditionnel de voir cet arbre à plat dans le contexte des grammaires comme une suite de raffinements successifs permettant de passer de ce que l'on veut lire : une expression, à la suite des lexèmes qui la constituent :
On va ainsi s'intéresser dans les prochains paragraphes à la définition précise d'une grammaire non contextuelle et de son langage, ainsi qu'à la manière dont on peut en déduire un programme permettant d'effectuer cette reconnaissance.
Grammaire non contextuelle
Définition
Dans l'introduction, on a manipulé deux sortes de symboles : les lexèmes, qui apparaissent effectivement dans la phrase, et des symboles comme \(expr\) qui désignent une catégorie de phrases et qu'on remplace progressivement. Les règles d'inférence deviennent des règles de réécriture.
Définition
Une grammaire non contextuelle est un quadruplet \(G = (\Sigma, V, P, S)\) où :
- \(\Sigma\) est un alphabet fini dont les éléments sont appelés les symboles terminaux ;
- \(V\) est un ensemble fini, disjoint de \(\Sigma\), dont les éléments sont appelés les symboles non terminaux (ou variables) ;
- \(P \subset V \times (\Sigma \cup V)^*\) est un ensemble fini de règles de production. On note \(A \rightarrow \alpha\) la règle \((A, \alpha)\) ;
- \(S \in V\) est le symbole initial.
Remarque
- Quand plusieurs règles ont le même membre gauche, \(A \rightarrow \alpha_1, \dots, A \rightarrow \alpha_k\), on les regroupe en écrivant \(A \rightarrow \alpha_1 \mid \dots \mid \alpha_k\).
- Par convention, les non terminaux sont notés avec des majuscules et les terminaux avec des minuscules ou des symboles. Le plus souvent, on se contente de donner les règles, le symbole initial étant le membre gauche de la première règle.
- Non contextuelle signifie que le membre gauche d'une règle est un unique non terminal : on peut remplacer \(A\) par \(\alpha\) quel que soit ce qui l'entoure, c'est-à-dire son contexte.
Exemple
- La grammaire de l'introduction s'écrit, en notant \(E\) le symbole \(expr\) : \(E \rightarrow E + E \mid \mathtt{id} \mid \mathtt{num}\). Ici \(\Sigma = \{ +, \mathtt{id}, \mathtt{num} \}\), \(V = \{ E \}\) et \(S = E\).
- Sur \(\Sigma = \{a, b\}\), on considère la grammaire \(S \rightarrow a S b \mid \epsilon\) qui possède deux règles : \(S \rightarrow aSb\) et \(S \rightarrow \epsilon\).
- La grammaire
expr -> num | num + exprdu TP sur l'analyse des expressions est donnée sous la forme textuelleT = ...,NT = ...,s = ...qui liste explicitement \(\Sigma\), \(V\) et \(S\).
Dérivation et langage
Définition
Soit \(G = (\Sigma, V, P, S)\) une grammaire et \(u, v \in (\Sigma \cup V)^*\).
- On dit que \(u\) se dérive immédiatement en \(v\), et on note \(u \Rightarrow v\), lorsqu'il existe \(x, y \in (\Sigma \cup V)^*\) et une règle \(A \rightarrow \alpha \in P\) tels que \(u = xAy\) et \(v = x \alpha y\).
- On note \(u \Rightarrow^k v\) lorsqu'il existe \(u_0 = u, u_1, \dots, u_k = v\) avec \(u_0 \Rightarrow u_1 \Rightarrow \dots \Rightarrow u_k\) : c'est une dérivation de longueur \(k\).
- On note \(\Rightarrow^*\) la clôture réflexive et transitive de \(\Rightarrow\) : \(u \Rightarrow^* v\) si et seulement s'il existe \(k \in \N\) tel que \(u \Rightarrow^k v\).
Définition
Le langage engendré par la grammaire \(G\) est
Un langage est dit non contextuel (ou algébrique) lorsqu'il est engendré par une grammaire non contextuelle. Deux grammaires engendrant le même langage sont dites faiblement équivalentes.
Remarque
Seuls les mots de \(\Sigma^*\), donc sans non terminal, sont dans le langage. Les mots intermédiaires de \((\Sigma \cup V)^*\) apparaissant dans une dérivation sont parfois appelés des proto-mots.
Exemple
Avec la grammaire \(S \rightarrow aSb \mid \epsilon\), on a \(S \Rightarrow aSb \Rightarrow aaSbb \Rightarrow aabb\), donc \(aabb\) est dans le langage engendré.
Comme les règles s'appliquent indépendamment du contexte, une dérivation à partir d'un mot \(X_1 \dots X_n\) se décompose en \(n\) dérivations indépendantes. Ce lemme est l'outil de base pour raisonner sur les grammaires non contextuelles.
Lemme
Soient \(X_1, \dots, X_n \in \Sigma \cup V\), \(w \in \Sigma^*\) et \(k \in \N\). On a \(X_1 \dots X_n \Rightarrow^k w\) si et seulement s'il existe \(w_1, \dots, w_n \in \Sigma^*\) et \(k_1, \dots, k_n \in \N\) tels que \(w = w_1 \dots w_n\), \(k = k_1 + \dots + k_n\) et pour tout \(i \in \range{1}{n}\), \(X_i \Rightarrow^{k_i} w_i\).
Preuve
Le sens réciproque s'obtient en enchaînant les dérivations \(X_1 \dots X_n \Rightarrow^{k_1} w_1 X_2 \dots X_n \Rightarrow^{k_2} \dots \Rightarrow^{k_n} w_1 \dots w_n\).
Pour le sens direct, on procède par récurrence sur \(k\) (pour tous les mots \(X_1 \dots X_n\) simultanément).
- Si \(k = 0\), \(X_1 \dots X_n = w\) ne contient que des terminaux et on pose \(w_i = X_i\), \(k_i = 0\).
- Si \(k > 0\), la première étape remplace un certain \(X_j = A\) par \(\alpha = Y_1 \dots Y_p\) avec \(A \rightarrow \alpha \in P\) : \(X_1 \dots X_{j-1} Y_1 \dots Y_p X_{j+1} \dots X_n \Rightarrow^{k-1} w\). Par hypothèse de récurrence, \(w\) se découpe en \(w_1 \dots w_{j-1} v_1 \dots v_p w_{j+1} \dots w_n\) avec des dérivations de chaque symbole dont les longueurs sont de somme \(k-1\). On pose \(w_j = v_1 \dots v_p\) : par le sens réciproque, \(Y_1 \dots Y_p \Rightarrow^{l} w_j\) où \(l\) est la somme des longueurs des dérivations des \(Y_i\), donc \(X_j \Rightarrow \alpha \Rightarrow^{l} w_j\) et \(k_j = l+1\) convient.
Théorème
Le langage \(L = \enscomp{a^n b^n}{n \in \N}\) est engendré par la grammaire \(S \rightarrow aSb \mid \epsilon\). Il est donc non contextuel mais, d'après le chapitre précédent, il n'est pas régulier.
Preuve
Notons \(G\) cette grammaire.
- \(L \subset \mathop{lang}(G)\) : on montre par récurrence sur \(n\) que \(S \Rightarrow^* a^n S b^n\). C'est vrai pour \(n=0\) et si \(S \Rightarrow^* a^n S b^n\) alors \(S \Rightarrow^* a^n aSb b^n = a^{n+1} S b^{n+1}\). Ainsi \(S \Rightarrow^* a^n S b^n \Rightarrow a^n b^n\).
- \(\mathop{lang}(G) \subset L\) : on montre par récurrence sur \(k\) que si \(S \Rightarrow^k u\) alors \(u\) est de la forme \(a^n S b^n\) ou \(a^n b^n\). C'est vrai pour \(k = 0\) avec \(u = S\). Si \(S \Rightarrow^k u \Rightarrow v\), comme \(u\) contient un non terminal, \(u = a^n S b^n\) et \(v\) vaut \(a^{n+1} S b^{n+1}\) ou \(a^n b^n\) selon la règle appliquée. Les mots de \(\Sigma^*\) obtenus sont donc de la forme \(a^n b^n\).
Le fait que \(L\) ne soit pas régulier a été démontré avec le lemme de l'étoile.
On a ainsi trouvé un langage qui est non contextuel sans être régulier. Inversement, tout langage régulier est non contextuel : les grammaires non contextuelles sont strictement plus expressives que les automates finis.
Théorème
Tout langage régulier est non contextuel. L'inclusion est stricte.
Preuve
Soit \(L\) un langage régulier. D'après le théorème de Kleene, il est reconnu par un automate fini déterministe \(A = (Q, \Sigma, \delta, q_i, F)\), où l'on suppose, quitte à renommer les états, que \(Q \cap \Sigma = \emptyset\).
On considère la grammaire \(G = (\Sigma, Q, P, q_i)\) dont les non terminaux sont les états et dont les règles sont :
- \(q \rightarrow a\, q'\) pour chaque transition \(\delta(q, a) = q'\) ;
- \(q \rightarrow \epsilon\) pour chaque état final \(q \in F\).
Montrons que pour \(q, q' \in Q\) et \(w \in \Sigma^*\), on a \(q \Rightarrow^* w q'\) si et seulement si \(\delta^*(q, w) = q'\). Une dérivation à partir de \(q\) ne contient jamais qu'un seul non terminal, placé à la fin : tant qu'on applique des règles \(q \rightarrow a q'\) on obtient des mots de la forme \(u\,p\) avec \(u \in \Sigma^*\) et \(p \in Q\), et une règle \(q \rightarrow \epsilon\) supprime le dernier non terminal, après quoi plus rien n'est possible. Ainsi une dérivation \(q \Rightarrow^* w q'\) avec \(w = a_1 \dots a_n\) est exactement de la forme
avec \(\delta(p_{k-1}, a_k) = p_k\) pour tout \(k\), c'est-à-dire un chemin d'étiquette \(w\) de \(q\) à \(q'\) dans l'automate.
Enfin, la dernière étape d'une dérivation \(q_i \Rightarrow^* w\) avec \(w \in \Sigma^*\) est nécessairement l'application d'une règle \(q' \rightarrow \epsilon\) avec \(q' \in F\). Donc \(w \in \mathop{lang}(G)\) si et seulement s'il existe \(q' \in F\) tel que \(q_i \Rightarrow^* w q'\), c'est-à-dire si et seulement si \(\delta^*(q_i, w) \in F\), soit \(w \in \mathop{lang}(A)\).
L'inclusion est stricte d'après le théorème précédent.
Exemple
L'automate de l'exemple du chapitre précédent
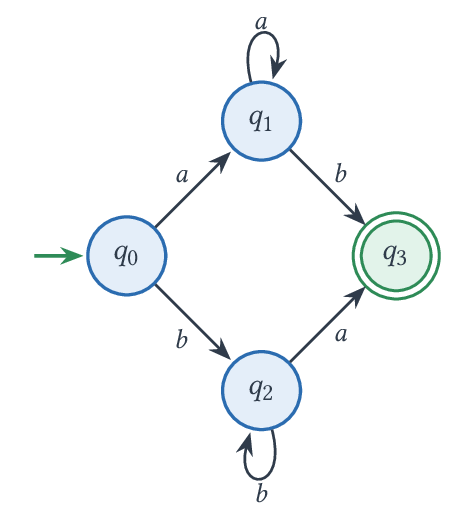
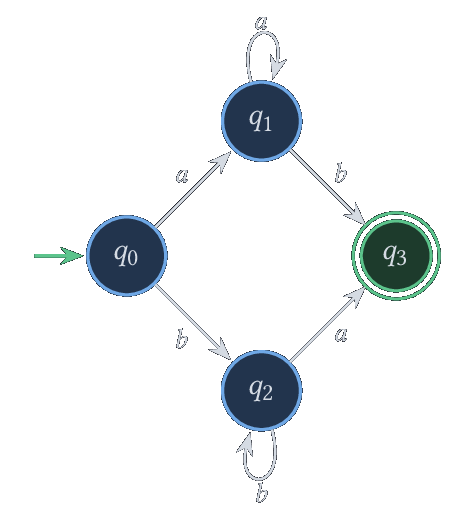
donne la grammaire
et la dérivation \(q_0 \Rightarrow a q_1 \Rightarrow a a q_1 \Rightarrow aab q_3 \Rightarrow aab\) correspond au chemin réussi d'étiquette \(aab\).
Remarque
- Les grammaires obtenues ainsi, où toutes les règles sont de la forme \(A \rightarrow aB\) ou \(A \rightarrow \epsilon\), sont dites linéaires à droite. On peut montrer qu'elles engendrent exactement les langages réguliers.
- On aurait aussi pu partir de la définition inductive de \(\mathop{Reg}(\Sigma)\) : les langages non contextuels contiennent \(\emptyset\) et les \(\{a\}\) et sont stables par union (\(S \rightarrow S_1 \mid S_2\)), concaténation (\(S \rightarrow S_1 S_2\)) et étoile (\(S \rightarrow S_1 S \mid \epsilon\)), en prenant des non terminaux disjoints pour les deux grammaires.
- Contrairement aux langages réguliers, les langages non contextuels ne sont pas stables par intersection ni par complémentaire (admis).
Exemple
Le langage des mots bien parenthésés sur \(\{ (, ) \}\) est engendré par la grammaire \(S \rightarrow (S)S \mid \epsilon\). On le prouve, comme pour \(a^n b^n\), par une double inclusion : par récurrence sur la longueur de la dérivation dans un sens, et en découpant un mot bien parenthésé non vide selon la parenthèse fermante associée à la première parenthèse ouvrante dans l'autre. Ce langage n'est pas régulier : son intersection avec le langage régulier \(\{(\}^* \{)\}^*\) est \(\enscomp{(^n )^n}{n \in \N}\).
Dérivations à gauche et à droite
Un même mot peut être obtenu par de nombreuses dérivations qui ne diffèrent que par l'ordre dans lequel on remplace les non terminaux. Avec la grammaire \(E \rightarrow E + E \mid \mathtt{id} \mid \mathtt{num}\), on a par exemple :
Pour éviter ces répétitions inutiles, on fixe un ordre.
Définition
Une dérivation \(u_0 \Rightarrow u_1 \Rightarrow \dots \Rightarrow u_k\) est une dérivation à gauche (resp. à droite) lorsqu'à chaque étape, c'est le non terminal le plus à gauche (resp. le plus à droite) de \(u_i\) qui est remplacé pour obtenir \(u_{i+1}\).
Exemple
Dans l'exemple précédent, la première dérivation est à gauche, la seconde à droite. La dérivation de l'introduction était une dérivation à gauche.
Remarque
Pour la grammaire de la preuve précédente issue d'un automate, il n'y a jamais qu'un seul non terminal : toute dérivation est à la fois à gauche et à droite.
On verra à la section suivante que se restreindre aux dérivations à gauche ne change pas le langage engendré : tout mot de \(\mathop{lang}(G)\) admet au moins une dérivation à gauche. C'est ce qui rend ces dérivations naturelles pour un analyseur qui lit le mot de gauche à droite.
Arbre d'analyse
Les dérivations portent encore trop d'information : l'ordre de remplacement des non terminaux n'a pas d'importance. Ce qui compte, c'est la règle choisie pour chaque non terminal, ce que l'on représente par un arbre, comme l'arbre de dérivation de l'introduction.
Définition
Soit \(G = (\Sigma, V, P, S)\) une grammaire et \(A \in V\). Un arbre d'analyse de racine \(A\) est un arbre tel que :
- la racine est étiquetée par \(A\) ;
- les nœuds internes sont étiquetés par des non terminaux ;
- les feuilles sont étiquetées par des terminaux ou par \(\epsilon\) ;
- si un nœud interne étiqueté par \(B\) a pour fils, de gauche à droite, des nœuds étiquetés par \(X_1, \dots, X_n\), alors \(B \rightarrow X_1 \dots X_n \in P\). Une feuille \(\epsilon\) est l'unique fils d'un nœud \(B\) tel que \(B \rightarrow \epsilon \in P\).
La frontière de l'arbre est le mot de \(\Sigma^*\) obtenu en concaténant les étiquettes des feuilles de gauche à droite.
Exemple
Pour la grammaire \(S \rightarrow aSb \mid \epsilon\), voici l'arbre d'analyse de racine \(S\) et de frontière \(aabb\) :
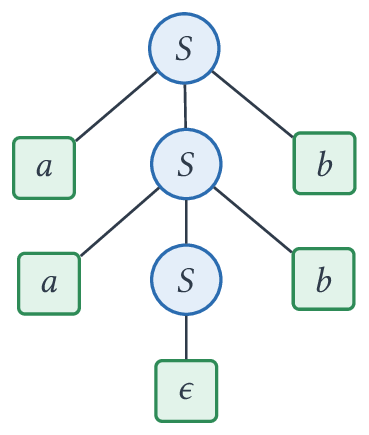
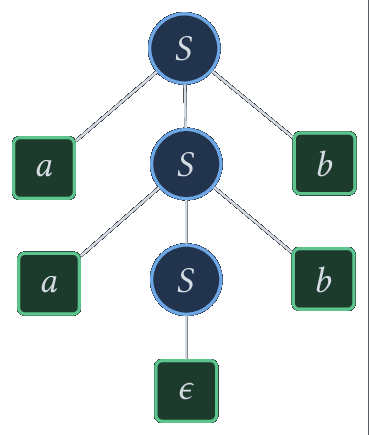
Théorème
Soit \(A \in V\) et \(w \in \Sigma^*\). On a \(A \Rightarrow^* w\) si et seulement s'il existe un arbre d'analyse de racine \(A\) et de frontière \(w\).
En particulier, \(\mathop{lang}(G)\) est l'ensemble des frontières des arbres d'analyse de racine \(S\).
Preuve
- Soit un arbre d'analyse de racine \(A\) et de frontière \(w\). On montre \(A \Rightarrow^* w\) par récurrence sur la hauteur de l'arbre. Si la racine a pour unique fils une feuille \(\epsilon\), on a \(A \rightarrow \epsilon \in P\) et \(w = \epsilon\). Sinon, la racine a pour fils \(X_1, \dots, X_n\) avec \(A \rightarrow X_1 \dots X_n \in P\). Pour chaque \(i\), si \(X_i\) est un terminal, c'est une feuille et on pose \(w_i = X_i\) ; sinon le sous-arbre de racine \(X_i\) est un arbre d'analyse de hauteur strictement plus petite, de frontière \(w_i\), et par hypothèse de récurrence \(X_i \Rightarrow^* w_i\). Comme \(w = w_1 \dots w_n\), le lemme de décomposition donne \(A \Rightarrow X_1 \dots X_n \Rightarrow^* w\).
- Réciproquement, on montre par récurrence forte sur \(k \ge 1\) que si \(A \Rightarrow^k w\), alors il existe un arbre d'analyse de racine \(A\) et de frontière \(w\) (\(k = 0\) est impossible car \(A \notin \Sigma^*\)). La première étape utilise une règle \(A \rightarrow X_1 \dots X_n\) et \(X_1 \dots X_n \Rightarrow^{k-1} w\). Si \(n = 0\), \(w = \epsilon\) et l'arbre \(A\) avec une feuille \(\epsilon\) convient. Sinon, d'après le lemme de décomposition, \(w = w_1 \dots w_n\) avec \(X_i \Rightarrow^{k_i} w_i\) et \(k_i \le k-1\). Pour un terminal \(X_i\), on prend la feuille \(X_i\) ; pour un non terminal, on obtient par hypothèse de récurrence un arbre de racine \(X_i\) et de frontière \(w_i\). On accroche ces arbres sous une racine étiquetée par \(A\).
Un arbre d'analyse oublie l'ordre des remplacements. Pour retrouver une dérivation à partir d'un arbre, il suffit de choisir un ordre : si on remplace toujours le non terminal le plus à gauche, on parcourt les nœuds internes dans l'ordre d'un parcours en profondeur préfixe et on obtient une dérivation à gauche.
Théorème
(admis) Pour tout \(w \in \Sigma^*\), l'application qui associe à une dérivation à gauche \(S \Rightarrow^* w\) l'arbre d'analyse qu'elle construit est une bijection entre les dérivations à gauche de \(w\) et les arbres d'analyse de racine \(S\) et de frontière \(w\). Il en va de même pour les dérivations à droite.
Remarque
En particulier, tout mot de \(\mathop{lang}(G)\) admet une dérivation à gauche. L'idée de la bijection est la suivante : dans une dérivation à gauche, le non terminal remplacé à chaque étape est imposé, seule la règle est à choisir, et c'est précisément cette suite de règles, lue dans l'ordre préfixe, que l'arbre mémorise.
Remarque
L'arbre d'analyse contient tous les détails de la grammaire : non terminaux
intermédiaires, parenthèses, etc. Un analyseur syntaxique construit en
général un arbre plus compact, l'arbre de syntaxe abstraite, comme les
valeurs du type expression du TP, où une expression (1 + 2) * x est
représentée par Mult (Add (Constant 1, Constant 2), Variable "x") sans
trace des parenthèses.
Ambiguïté
Définition
Une grammaire \(G\) est ambiguë lorsqu'il existe un mot \(w \in \mathop{lang}(G)\) admettant au moins deux arbres d'analyse distincts de racine \(S\), ou de manière équivalente, au moins deux dérivations à gauche distinctes.
L'exemple typique est celui des expressions arithmétiques du TP, avec les
lexèmes Id, Num, Plus, Minus, Times, Div, LPar, RPar notés
respectivement \(\mathtt{id}, \mathtt{num}, +, -, *, /, (, )\) :
Exemple
Le mot \(\mathtt{id} + \mathtt{id} * \mathtt{id}\) admet deux dérivations à gauche :
qui correspondent aux deux arbres d'analyse :
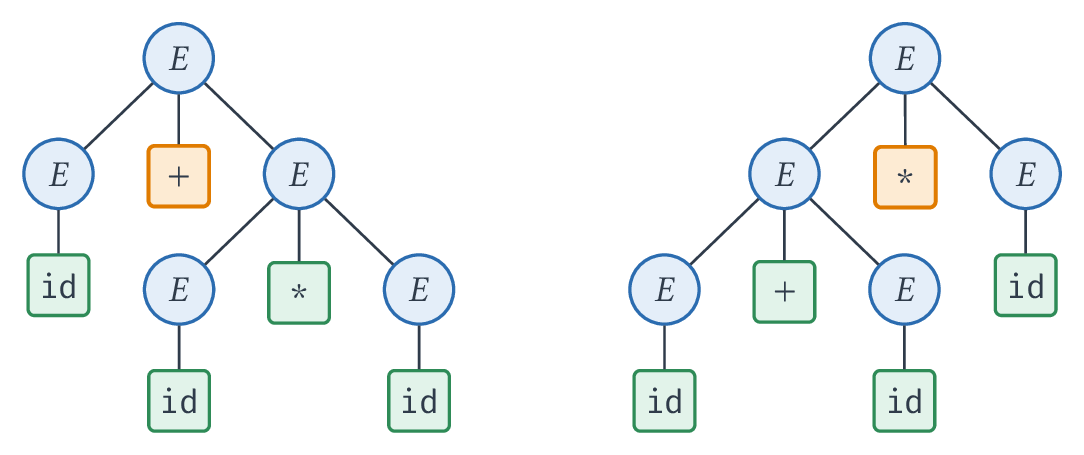
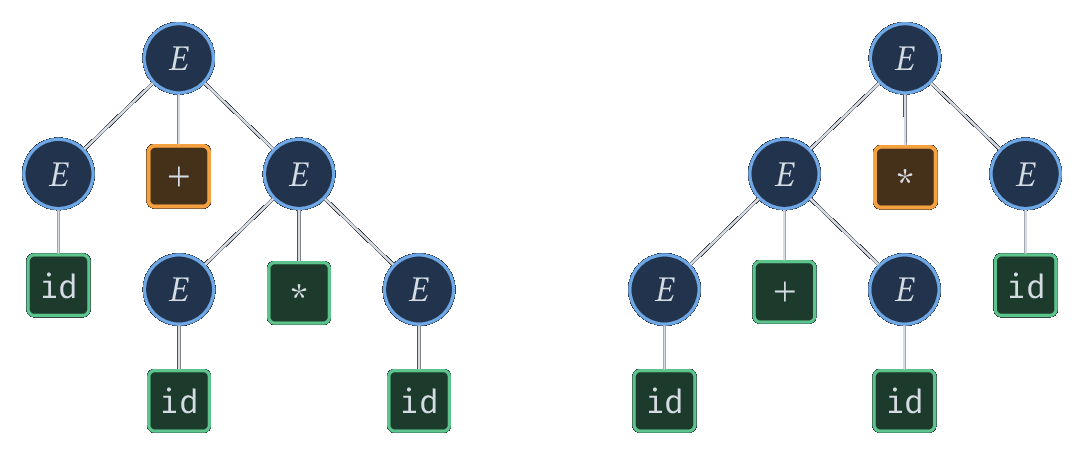
Le premier correspond à \(\mathtt{id} + (\mathtt{id} * \mathtt{id})\), le second à \((\mathtt{id} + \mathtt{id}) * \mathtt{id}\). Si on évalue l'expression à partir de l'arbre, avec \(1 + 2 * 3\), on obtient \(7\) dans un cas et \(9\) dans l'autre : l'ambiguïté n'est pas qu'un problème théorique.
De même, \(\mathtt{id} - \mathtt{id} - \mathtt{id}\) a deux arbres d'analyse, correspondant à \((8 - 2) - 1 = 5\) et \(8 - (2 - 1) = 7\).
Remarque
- L'ambiguïté est une propriété de la grammaire et non du langage : on va voir une grammaire non ambiguë engendrant le même langage. Il existe cependant des langages non contextuels dont toutes les grammaires sont ambiguës, comme \(\enscomp{a^i b^j c^k}{i = j \text{ ou } j = k}\) (admis).
- On ne peut pas décider algorithmiquement si une grammaire est ambiguë (admis, voir le chapitre de calculabilité).
- Pour la grammaire \(S \rightarrow aSb \mid \epsilon\), il n'y a pas d'ambiguïté : à chaque étape d'une dérivation, il n'y a qu'un seul non terminal, et la règle est imposée par le nombre de \(a\) restant à produire.
Pour lever l'ambiguïté, on encode dans la grammaire les conventions usuelles :
- priorité : \(*\) et \(/\) sont prioritaires sur \(+\) et \(-\) ;
- associativité : les quatre opérateurs sont associatifs à gauche, \(a - b - c\) se lit \((a - b) - c\).
Pour cela, on introduit un non terminal par niveau de priorité : \(E\) pour une expression (une somme de termes), \(T\) pour un terme (un produit de facteurs) et \(F\) pour un facteur.
Remarque
- Priorité : un opérande de \(*\) est un \(F\), il ne peut donc contenir un \(+\) qu'entre parenthèses. Dans \(\mathtt{id} + \mathtt{id} * \mathtt{id}\), le \(+\) est nécessairement à la racine.
- Associativité : dans \(E \rightarrow E - T\), l'opérande droit est un \(T\) qui ne peut pas contenir de \(-\) hors parenthèses. Dans \(\mathtt{id} - \mathtt{id} - \mathtt{id}\), c'est donc le dernier \(-\) qui est à la racine, ce qui donne bien \((\mathtt{id} - \mathtt{id}) - \mathtt{id}\). La récursivité à gauche de la règle donne l'associativité à gauche.
- On admet que cette grammaire n'est pas ambiguë et qu'elle est faiblement équivalente à la précédente.
- La grammaire complète du TP,
expr -> term + expr | term - expr | term, est récursive à droite : elle est elle aussi non ambiguë, mais rend les opérateurs associatifs à droite, ce qui est faux pour \(-\) et \(/\). On va voir pourquoi elle a été choisie ainsi et comment corriger ce défaut.
Analyse syntaxique par descente récursive
Étant donnés une grammaire et une suite de lexèmes, l'analyse syntaxique consiste à déterminer si la suite est dans le langage engendré, et le cas échéant à construire un arbre (d'analyse ou de syntaxe abstraite). La méthode la plus simple à écrire à la main est la descente récursive : on construit l'arbre depuis la racine, en lisant les lexèmes de gauche à droite, ce qui revient à produire une dérivation à gauche.
On reprend les types du TP :
type token =
  | Id of string
  | Num of int
  | Plus | Times | Minus | Div
  | LPar | RPar

type expression =
  | Variable of string
  | Constant of int
  | Add of expression * expression
  | Substract of expression * expression
  | Mult of expression * expression
  | Divide of expression * expression

exception ParsingError
Premier exemple
On considère la grammaire des mots bien parenthésés \(S \rightarrow (S)S \mid
\epsilon\) sur les lexèmes LPar et RPar. On écrit une fonction parse_s
qui lit un préfixe de la liste de lexèmes dérivant de \(S\) et renvoie le suffixe
non lu.
Pour choisir la règle, on regarde le premier lexème : un mot dérivé par
\(S \rightarrow (S)S\) commence par LPar, et sinon on applique
\(S \rightarrow \epsilon\), qui ne consomme rien. Lire le membre droit \((S)S\),
c'est lire LPar, puis un \(S\) par un appel récursif, puis vérifier la présence
de RPar, puis lire un dernier \(S\).
(* S -> ( S ) S | epsilon *)
let rec parse_s (tl : token list) : token list =
  match tl with
  | LPar :: q ->
    begin match parse_s q with
      | RPar :: q' -> parse_s q'
      | _ -> raise ParsingError
    end
  | _ -> tl

let bien_parenthesee (tl : token list) : bool =
  try parse_s tl = [] with ParsingError -> false
Exemple
bien_parenthesee [LPar; LPar; RPar; RPar; LPar; RPar]renvoietrue.bien_parenthesee [LPar]renvoiefalse: l'appel interne àparse_srenvoie[]et on ne trouve pasRPar.bien_parenthesee [LPar; RPar; RPar]renvoiefalse:parse_srenvoie[RPar], qui n'est pas vide.
Remarque
Il ne faut pas oublier de vérifier, à la fin, que tous les lexèmes ont été
consommés : parse_s s'arrête dès qu'elle ne peut plus appliquer la règle
\(S \rightarrow (S)S\), et
[LPar; RPar; RPar] a pour préfixe le mot bien parenthésé [LPar; RPar].
Principe général
Pour une grammaire \(G\), on écrit :
- une fonction
parse_Apar non terminal \(A\), ces fonctions étant mutuellement récursives. Elle prend une liste de lexèmes, lit un préfixe qui dérive de \(A\) et renvoie un couple formé de l'arbre construit et du suffixe restant ; - pour lire un membre droit \(X_1 \dots X_n\), on lit successivement chaque
symbole : pour un terminal, on vérifie que c'est le premier lexème de la
liste et on le consomme, sinon on lève
ParsingError; pour un non terminal \(B\), on appelleparse_Bsur la liste restante ; - pour choisir entre les règles \(A \rightarrow \alpha_1 \mid \dots \mid \alpha_k\), on regarde uniquement le premier lexème de la liste ;
- enfin, l'analyse complète appelle
parse_Set vérifie que la liste restante est vide.
C'est exactement ce que fait le TP avec parse_expression, parse_term et
parse_factor. Une telle analyse ne revient jamais en arrière : chaque lexème
est examiné un nombre borné de fois et l'analyse est en temps linéaire en le
nombre de lexèmes.
Cette méthode ne s'applique pas à toutes les grammaires. Deux obstacles apparaissent dès la grammaire non ambiguë des expressions :
- \(E \rightarrow E + T\) : pour lire un \(E\),
parse_expressioncommencerait par s'appeler elle-même sur la même liste, ce qui boucle indéfiniment ; - \(E \rightarrow T + E \mid T\) (version du TP) : le premier lexème ne permet pas de savoir quelle règle appliquer, les deux membres droits commençant par un \(T\).
On va voir deux transformations de grammaires, qui préservent le langage engendré, permettant de lever ces obstacles.
Élimination de la récursivité à gauche
Une règle \(A \rightarrow A\alpha\) est dite récursive à gauche. Avec une telle
règle, la fonction parse_A ressemblerait à
let rec parse_expression tl =
  let e, q = parse_expression tl in (* même liste : boucle infinie *)
  ...
et l'exécution se terminerait par un dépassement de pile (Stack_overflow).
Propriété
Soient \(\alpha, \beta \in (\Sigma \cup V)^*\) ne contenant pas \(A\). Remplacer les règles \(A \rightarrow A \alpha \mid \beta\) par les règles
où \(A'\) est un nouveau non terminal, ne change pas le langage engendré.
Preuve
Pour \(\gamma \in (\Sigma \cup V)^*\), notons \(L(\gamma) = \enscomp{w \in \Sigma^*}{\gamma \Rightarrow^* w}\), qui ne dépend que des règles des non terminaux autres que \(A\) et \(A'\) si \(\gamma\) ne contient ni \(A\) ni \(A'\). Il suffit de montrer que, dans les deux grammaires, les frontières des arbres d'analyse de racine \(A\) sont les mots de \(L(\beta) L(\alpha)^*\) ; le lemme de décomposition permet ensuite de conclure pour toute dérivation à partir de \(S\).
- Dans la première grammaire, considérons un arbre d'analyse de racine \(A\) et suivons depuis la racine la branche des premiers fils étiquetés \(A\) : on obtient \(n \ge 0\) nœuds utilisant la règle \(A \rightarrow A \alpha\) puis un nœud utilisant \(A \rightarrow \beta\). La frontière est donc la concaténation d'une frontière d'arbres pour \(\beta\) puis de \(n\) frontières d'arbres pour \(\alpha\) : c'est un mot de \(L(\beta) L(\alpha)^n\). Réciproquement, tout mot de \(L(\beta)L(\alpha)^n\) s'obtient ainsi.
- Dans la seconde grammaire, la racine utilise \(A \rightarrow \beta A'\) et on suit la branche des derniers fils étiquetés \(A'\) : \(n\) nœuds utilisent \(A' \rightarrow \alpha A'\) puis un nœud \(A' \rightarrow \epsilon\). La frontière est encore un mot de \(L(\beta) L(\alpha)^n\) et réciproquement.
Remarque
Plus généralement, \(A \rightarrow A\alpha_1 \mid \dots \mid A\alpha_m \mid \beta_1 \mid \dots \mid \beta_p\) se transforme en \(A \rightarrow \beta_1 A' \mid \dots \mid \beta_p A'\) et \(A' \rightarrow \alpha_1 A' \mid \dots \mid \alpha_m A' \mid \epsilon\).
Appliquée à la grammaire non ambiguë des expressions, cette transformation donne :
Remarque
Les arbres d'analyse de cette nouvelle grammaire penchent à droite : on a perdu la forme qui donnait l'associativité à gauche. Mais l'analyseur n'est pas obligé de renvoyer l'arbre d'analyse : la fonction associée à \(E'\) peut recevoir l'expression déjà lue dans un accumulateur et construire l'arbre de syntaxe abstraite de gauche à droite. C'est ce qui est fait dans l'exemple complet ci-dessous et qui répond à la remarque finale du TP.
Factorisation à gauche
Quand deux règles d'un même non terminal commencent par le même préfixe, \(A \rightarrow \alpha \beta_1 \mid \alpha \beta_2\) avec \(\alpha \neq \epsilon\), le premier lexème ne permet pas de choisir. On met alors ce préfixe en facteur avec un nouveau non terminal \(A'\) :
Le langage engendré est clairement inchangé : une étape \(A \Rightarrow \alpha \beta_i\) correspond aux deux étapes \(A \Rightarrow \alpha A' \Rightarrow \alpha \beta_i\).
Exemple
La grammaire du TP \(E \rightarrow T + E \mid T - E \mid T\) devient
C'est exactement ce que fait la fonction parse_expression du TP : elle
appelle d'abord parse_term, puis regarde si le lexème suivant est
Plus, Minus ou autre chose.
Exemple plus complet
On écrit maintenant l'analyseur de la grammaire obtenue après élimination de la
récursivité à gauche. Les fonctions parse_expression_suite et
parse_term_suite correspondent à \(E'\) et \(T'\) ; elles reçoivent dans acc
l'arbre de ce qui a déjà été lu à gauche, ce qui rend les opérateurs
associatifs à gauche.
let parser (tl : token list) : expression =
  (* E -> T E' *)
  let rec parse_expression tl =
    let t, q = parse_term tl in
    parse_expression_suite t q
  (* E' -> + T E' | - T E' | epsilon *)
  and parse_expression_suite acc tl =
    match tl with
    | Plus :: q ->
      let t, q = parse_term q in
      parse_expression_suite (Add (acc, t)) q
    | Minus :: q ->
      let t, q = parse_term q in
      parse_expression_suite (Substract (acc, t)) q
    | _ -> (acc, tl)
  (* T -> F T' *)
  and parse_term tl =
    let f, q = parse_factor tl in
    parse_term_suite f q
  (* T' -> * F T' | / F T' | epsilon *)
  and parse_term_suite acc tl =
    match tl with
    | Times :: q ->
      let f, q = parse_factor q in
      parse_term_suite (Mult (acc, f)) q
    | Div :: q ->
      let f, q = parse_factor q in
      parse_term_suite (Divide (acc, f)) q
    | _ -> (acc, tl)
  (* F -> ( E ) | id | num *)
  and parse_factor tl =
    match tl with
    | Id x :: q -> (Variable x, q)
    | Num n :: q -> (Constant n, q)
    | LPar :: q ->
      begin match parse_expression q with
        | e, RPar :: q -> (e, q)
        | _ -> raise ParsingError
      end
    | _ -> raise ParsingError
  in
  let e, q = parse_expression tl in
  if q <> [] then raise ParsingError;
  e
Exemple
parser [Num 8; Minus; Num 2; Minus; Num 1]renvoieSubstract (Substract (Constant 8, Constant 2), Constant 1), c'est-à-dire \((8 - 2) - 1\).parser [Num 1; Plus; Num 2; Times; Num 3]renvoieAdd (Constant 1, Mult (Constant 2, Constant 3)).parser [LPar; Num 1; Plus; Num 2; RPar; Times; Id "x"]renvoieMult (Add (Constant 1, Constant 2), Variable "x").parser [],parser [Num 1; Plus],parser [LPar; Num 1]etparser [Num 1; Num 2]lèventParsingError.
Remarque
Dans les cas \(\epsilon\), on renvoie la liste sans rien vérifier
(| _ -> (acc, tl)). Une erreur comme dans [Num 1; Num 2] n'est alors
détectée que plus haut, par le test final q <> []. On pourrait la
détecter plus tôt en vérifiant que le lexème suivant peut effectivement
suivre un \(E'\) : c'est ce que formalise la section suivante.
Aller plus loin
Cette section n'est plus au programme de MPI : elle formalise la condition « on peut choisir la règle en regardant le premier lexème » utilisée ci-dessus. On ajoute à la fin de l'entrée un terminal spécial \(\#\) qui marque la fin de la liste.
FIRST et FOLLOW
Définition
Soit \(G = (\Sigma, V, P, S)\) une grammaire.
- Pour \(\alpha \in (\Sigma \cup V)^*\), \(\mathrm{FIRST}(\alpha)\) est l'ensemble des terminaux \(a\) tels que \(\alpha \Rightarrow^* a u\) pour un certain \(u\), auquel on ajoute \(\epsilon\) si \(\alpha \Rightarrow^* \epsilon\).
- Pour \(A \in V\), \(\mathrm{FOLLOW}(A)\) est l'ensemble des terminaux de \(\Sigma \cup \{\#\}\) qui peuvent suivre \(A\) dans une dérivation, c'est-à-dire les \(a\) tels que \(S\# \Rightarrow^* u A a v\) pour certains \(u, v\).
On calcule ces ensembles en partant d'ensembles vides et en appliquant les règles suivantes jusqu'à ce que plus rien ne change :
- \(\mathrm{FIRST}(\epsilon) = \{ \epsilon \}\) et \(\mathrm{FIRST}(a \beta) = \{ a \}\) pour \(a \in \Sigma\) ;
- \(\mathrm{FIRST}(A\beta) = \mathrm{FIRST}(A)\) si \(\epsilon \notin \mathrm{FIRST}(A)\), et \((\mathrm{FIRST}(A) \setminus \{ \epsilon \}) \cup \mathrm{FIRST}(\beta)\) sinon ;
- \(\mathrm{FIRST}(A)\) est la réunion des \(\mathrm{FIRST}(\alpha)\) pour les règles \(A \rightarrow \alpha\) ;
- \(\# \in \mathrm{FOLLOW}(S)\) et pour chaque règle \(B \rightarrow \alpha A \beta\) : \(\mathrm{FIRST}(\beta) \setminus \{ \epsilon \} \subset \mathrm{FOLLOW}(A)\) et, si \(\epsilon \in \mathrm{FIRST}(\beta)\), \(\mathrm{FOLLOW}(B) \subset \mathrm{FOLLOW}(A)\).
Exemple
Pour la grammaire \(E \rightarrow T E'\), \(E' \rightarrow + T E' \mid - T E' \mid \epsilon\), \(T \rightarrow F T'\), \(T' \rightarrow * F T' \mid / F T' \mid \epsilon\), \(F \rightarrow ( E ) \mid \mathtt{id} \mid \mathtt{num}\) :
| Non terminal | FIRST | FOLLOW |
|---|---|---|
| \(E\) | \((, \mathtt{id}, \mathtt{num}\) | \(), \#\) |
| \(E'\) | \(+, -, \epsilon\) | \(), \#\) |
| \(T\) | \((, \mathtt{id}, \mathtt{num}\) | \(+, -, ), \#\) |
| \(T'\) | \(*, /, \epsilon\) | \(+, -, ), \#\) |
| \(F\) | \((, \mathtt{id}, \mathtt{num}\) | \(*, /, +, -, ), \#\) |
Par exemple, \(\mathrm{FOLLOW}(T)\) contient \(\mathrm{FIRST}(E') \setminus \{\epsilon\} = \{+, -\}\) à cause de la règle \(E \rightarrow T E'\) et, comme \(E' \Rightarrow \epsilon\), il contient aussi \(\mathrm{FOLLOW}(E) = \{ ), \# \}\).
Table de choix de production
On range dans une table \(M\), indexée par un non terminal \(A\) et un terminal \(a \in \Sigma \cup \{\#\}\), la règle à appliquer pour lire \(A\) quand le prochain lexème est \(a\) : la règle \(A \rightarrow \alpha\) est placée dans la case \(M[A, a]\) lorsque \(a \in \mathrm{FIRST}(\alpha)\), ou lorsque \(\epsilon \in \mathrm{FIRST}(\alpha)\) et \(a \in \mathrm{FOLLOW}(A)\). Une case vide signifie une erreur de syntaxe.
Exemple
Sur l'exemple précédent, en n'indiquant que le membre droit de la règle :
| \(\mathtt{id}\) | \(\mathtt{num}\) | \((\) | \()\) | \(+\) | \(-\) | \(*\) | \(/\) | \(\#\) | |
|---|---|---|---|---|---|---|---|---|---|
| \(E\) | \(TE'\) | \(TE'\) | \(TE'\) | ||||||
| \(E'\) | \(\epsilon\) | \(+TE'\) | \(-TE'\) | \(\epsilon\) | |||||
| \(T\) | \(FT'\) | \(FT'\) | \(FT'\) | ||||||
| \(T'\) | \(\epsilon\) | \(\epsilon\) | \(\epsilon\) | \(*FT'\) | \(/FT'\) | \(\epsilon\) | |||
| \(F\) | \(\mathtt{id}\) | \(\mathtt{num}\) | \((E)\) |
Chaque fonction de l'analyseur précédent correspond à une ligne de cette
table : les cases \(\epsilon\) sont le cas | _ -> (acc, tl) et les cases
vides de la ligne \(F\) le cas | _ -> raise ParsingError.
Grammaires LL(1)
Définition
Une grammaire est LL(1) lorsque chaque case de sa table de choix contient au plus une règle. De manière équivalente, pour toutes règles distinctes \(A \rightarrow \alpha\) et \(A \rightarrow \beta\) :
- \(\mathrm{FIRST}(\alpha) \cap \mathrm{FIRST}(\beta) = \emptyset\) ;
- si \(\epsilon \in \mathrm{FIRST}(\alpha)\), alors \(\mathrm{FIRST}(\beta) \cap \mathrm{FOLLOW}(A) = \emptyset\).
Le nom signifie : lecture de gauche à droite (Left to right), construction d'une dérivation à gauche (Leftmost derivation), avec \(1\) lexème d'avance. Ce sont exactement les grammaires pour lesquelles la descente récursive présentée ici fonctionne sans retour en arrière.
Remarque
- La grammaire précédente est LL(1), comme on le lit sur la table.
- Une grammaire récursive à gauche n'est jamais LL(1) (si \(A \rightarrow A\alpha \mid \beta\) avec \(\mathrm{FIRST}(\beta)\) contenant un terminal, il est aussi dans \(\mathrm{FIRST}(A\alpha)\)), ni une grammaire non factorisée comme \(E \rightarrow T + E \mid T\). Une grammaire ambiguë n'est jamais LL(1) (admis).
- Les outils comme
ocamlyaccoumenhirutilisent une autre famille de méthodes, l'analyse ascendante LR, qui accepte notamment les grammaires récursives à gauche.