Lambda-calcul non typé
On va présenter ici le \(\lambda\)-calcul en utilisant au maximum la
syntaxe d'OCaml.
On considère un ensemble dénombrable \(\mathcal{V}\) dont les éléments sont appelés des variables. On va appeler les programmes des termes, et l'ensemble \(\mathcal{T}\) des termes est défini inductivement par
- Un terme
u vest appelé une application : c'est l'application de la fonctionuà l'argumentv. - Un terme
fun x -> test appelé une abstraction : cela correspond au fait de considérer que la variablexapparaissant (ou non) danstest maintenant un paramètre.
Remarque
Comme on l'a vu précédemment, on définit ainsi un langage d'arbres qui
correspond à l'arbre syntaxique des termes. Une notation textuelle va
nécessairement être imprécise et on est obligé de mettre des parenthèses pour
distinguer u (v w) de (u v) w. Ces parenthèses ne font pas partie de la
syntaxe.
Exemple
Voici des exemples de termes :
xfun y -> x y(fun x -> x) xfun f -> fun g -> fun x -> f (g x)
Variables libres et liées
En fait, fun x -> est de même nature que \(\forall x.\), c'est un
lieur qui va capturer le nom x pour la suite du terme.
Une variable qui n'est pas capturée par un fun est dite libre.
Si \(t\) est un terme, on note \(FV(t)\) ses variables libres, pour free variables et en évitant l'ambiguïté de \(VL\) avec les variables liées.
On peut définir simplement \(FV\) ainsi :
- \(\forall \texttt{x} \in \mathcal{V}, FV(\texttt{x}) = \{ \texttt{x} \}\)
- \(\forall u, v \in \mathcal{T}, FV(u~v) = FV(u) \cup FV(v)\)
- \(\forall \texttt{x} \in \mathcal{V}, \forall t \in \mathcal{T}, FV(\texttt{fun x -> } t) = FV(t) \backslash \{ \texttt{x} \}\)
On dit parfois que fun x capture ou masque x.
Substitution
Si \(u, t \in \mathcal{T}\) et \(\texttt{x} \in \mathcal{V}\), on peut définir le terme où on a remplacé chaque occurrence libre de \(\texttt{x}\) dans \(u\) par le terme \(t\).
Par exemple, dans (fun x -> x) x si on remplace x par y z, le terme
devient (fun x -> x) (y z) vu que l'occurrence sous l'abstraction est liée.
On note \(u[\texttt{x} \backslash t]\) le terme substitué. On peut le définir par induction ainsi :
- \(\forall \texttt{y} \in \mathcal{V}, \texttt{y}[\texttt{x} \backslash t] = \begin{cases} t & \text{si } \texttt{x} = \texttt{y} \\ \texttt{y} & \text{sinon.} \end{cases}\)
- \(\forall u, v \in \mathcal{T}, (u~v)[\texttt{x} \backslash t] = u[\texttt{x} \backslash t] ~ v[\texttt{x} \backslash t]\)
- \(\forall \texttt{y} \in \mathcal{V}, \forall s \in \mathcal{T}, (\texttt{fun y -> } s) [\texttt{x} \backslash t] = \texttt{fun y -> } \begin{cases} s & \text{si } \texttt{x} = \texttt{y} \\ s[\texttt{x} \backslash t] & \text{si } \texttt{x} \neq \texttt{y} \text{ et } \texttt{y} \not\in FV(t)\end{cases}\)
- si \(\texttt{x} \neq \texttt{y}\) et \(\texttt{y} \in FV(t)\), on renomme d'abord la variable liée : \((\texttt{fun y -> } s) [\texttt{x} \backslash t] = \texttt{fun z -> } (s[\texttt{y} \backslash \texttt{z}])[\texttt{x} \backslash t]\) où \(\texttt{z}\) est une variable fraîche, c'est-à-dire n'apparaissant ni dans \(s\) ni dans \(t\), et distincte de \(\texttt{x}\).
Le dernier cas évite la capture des variables libres de \(t\). Par exemple,
(fun y -> x)[x\y] ne doit pas donner fun y -> y (la fonction identité) mais
fun z -> y (une fonction constante) : la variable libre y doit rester libre.
Ce renommage repose sur l'\(\alpha\)-conversion : deux termes qui ne diffèrent
que par le nom de leurs variables liées, comme fun x -> x et fun y -> y, sont
dits \(\alpha\)-équivalents. Formellement, fun y -> s est \(\alpha\)-équivalent à
fun z -> s[y\z] dès que z n'apparaît pas dans s, et on étend cela à toute
profondeur. Dans la suite, on identifie les termes \(\alpha\)-équivalents.
\(\beta\)-réduction
Un terme de la forme (fun x -> u) t est appelé un \(\beta\)-redex.
Cela correspond à une expression qui va s'évaluer en OCaml : on s'attend à ce
que l'expression devienne u dans lequel x est remplacé par t. Cela
correspond exactement à la notion précédente de substitution et on définit
une relation ainsi :
\(\texttt{(fun x -> } u \texttt{)}~t \rightarrow_\beta u[\texttt{x} \backslash t]\)
On peut naturellement prolonger \(\rightarrow_\beta\) par congruence en faisant en sorte que cette réduction s'applique à toute profondeur dans l'arbre syntaxique du terme :
- \(\forall u, t, t' \in \mathcal{T}, t \rightarrow_\beta t' \Rightarrow \begin{cases} u ~ t \rightarrow_\beta u ~ t' & \text{ et } \\ t ~ u \rightarrow_\beta t' ~ u \end{cases}\)
- \(\forall \texttt{x} \in \mathcal{V}, \forall t, t' \in \mathcal{T}, t \rightarrow_\beta t' \Rightarrow \texttt{fun x -> } t \rightarrow_\beta \texttt{fun x -> } t'\)
Exemple
- Si \(t =\)
(fun x -> x) y, ici c'est directement un \(\beta\)-redex, donc \(t \rightarrow_\beta\)y. - Si \(t =\)
((fun f -> fun x -> f (f x)) (fun y -> y)) zalors on peut réduire le redex sous l'application : \(t \rightarrow_\beta t' =\)(fun x -> (fun y -> y) ((fun y->y) x)) z.
Ici, on a trois \(\beta\)-redex : un pour chaque fun y -> y
et un pour fun x ->.
Choisissons de réduire celui qui est le plus en profondeur dans le terme :
\(t' \rightarrow_\beta\) (fun x -> (fun y -> y) x) z,
puis en réduisant à l'intérieur, \(\rightarrow_\beta\) (fun x -> x) z
\(\rightarrow_\beta\) z.
Au final, on a obtenu \(t \rightarrow_\beta\rightarrow_\beta
\rightarrow_\beta\rightarrow_\beta\) z.
- Si \(\Omega =\)
(fun x -> x x) (fun x -> x x)alors on peut poser \(\delta\) =fun x -> x xet on a alors \(\Omega = \delta \delta =\)(fun x -> x x)\(\delta \rightarrow_\beta \delta \delta = \Omega =\)(fun x -> x x) (fun x -> x x)
Ainsi \(\Omega \rightarrow_\beta \Omega\) : \(\Omega\) est un point fixe de la réduction.
Ces exemples permettent d'identifier deux points importants :
- la \(\beta\)-réduction est un petit pas de réduction, mais on souhaite pouvoir en réaliser tant que c'est possible. Le dernier exemple montre qu'il ne suffit pas de réduire en espérant tomber sur un terme sans \(\beta\)-redex : le processus n'a aucune raison de terminer.
On note \(\twoheadrightarrow_\beta\) la fermeture réflexive et transitive de
\(\rightarrow_\beta\), c'est-à-dire la plus petite relation réflexive et
transitive contenant \(\rightarrow_\beta\). On parle de réduction à grand pas,
cela revient à enchaîner un nombre quelconque, éventuellement nul, de
réductions. Ainsi, dans le second exemple,
on a montré \(t \twoheadrightarrow_\beta\) z.
* il est possible d'avoir le choix dans les \(\beta\)-redex que l'on peut
réduire. On peut se poser la question légitime de l'ordre et de son
importance. Le théorème suivant montre qu'il n'y a pas de problèmes.
Théorème
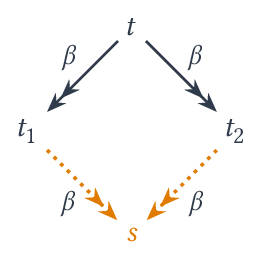
Church-Rosser Soient \(t, t_1, t_2 \in \mathcal{T}\) tels que \(t \twoheadrightarrow_\beta t_1\) et \(t \twoheadrightarrow_\beta t_2\).
Il existe \(s \in \mathcal{T}\) tel que \(t_1 \twoheadrightarrow_\beta s\) et \(t_2 \twoheadrightarrow_\beta s\).
Note on identifie ici les termes à \(\alpha\)-équivalence près, comme
fun x -> x = fun y -> y.
Ce théorème est admis.
On note ce théorème sous la forme d'un diagramme :
Définition
Si \(t \twoheadrightarrow_\beta t'\) et que \(t'\) ne contient pas de \(\beta\)-redex, on dit que \(t'\) est une forme normale de \(t\).
Conséquence du théorème précédent :
Corollaire
Si un terme a une forme normale, alors elle est unique.
Preuve
Si \(t_1\) et \(t_2\) sont deux formes normales de \(t\), le théorème de Church-Rosser fournit \(s\) tel que \(t_1 \twoheadrightarrow_\beta s\) et \(t_2 \twoheadrightarrow_\beta s\). Comme \(t_1\) ne contient aucun redex, la seule réduction possible depuis \(t_1\) est la suite vide, donc \(s = t_1\). De même \(s = t_2\), et ainsi \(t_1 = t_2\).
Remarque
Le terme \(t =\) (fun x -> y) \(\Omega\) a une forme normale y
en réduisant le redex le plus à gauche, mais on peut également
réduire \(\Omega\) et avoir \(t \rightarrow_\beta t\).
Ainsi, un terme peut avoir une forme normale et ne pas y aboutir en réduisant de manière quelconque.
Typage
Types simples
Pour résoudre le problème des termes comme \(\Omega\) dont la réduction ne termine pas, on va introduire une restriction sur les termes : une discipline de typage.
On note ici \(V\) un ensemble dénombrable de variables de type et on définit l'ensemble \(T\) des types inductivement ainsi :
Remarque
Il s'agit des formules du calcul propositionnel avec uniquement le connecteur \(\rightarrow\).
On note \(t : \tau\) pour affirmer que le terme \(t \in \mathcal{T}\) est du type \(\tau \in T\). On va considérer des jugements de la forme \(\Gamma \vdash t : \tau\) où \(\Gamma\), appelé contexte, est un ensemble d'hypothèses de la forme \(\texttt{x} : \tau'\) avec \(\texttt{x} \in \mathcal{V}\), chaque variable apparaissant au plus une fois dans \(\Gamma\).
On définit alors les règles d'inférence suivantes :
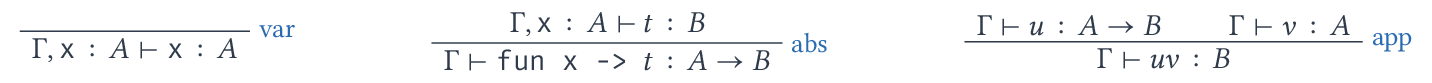
Remarque
Ce sont exactement les règles de la déduction naturelle \(ax, \rightarrow_i\) et \(\rightarrow_e\).
Définition
Un terme \(t\) a le type \(\tau\) s'il existe un contexte \(\Gamma\) tel que \(\Gamma \vdash t : \tau\) est dérivable.
Un terme \(t\) est bien typé, s'il existe \(\tau\) tel que \(t\) a le type \(\tau\).
On dit qu'un type \(\tau\) est habité s'il existe au moins un terme \(t\) tel que \(\vdash t : \tau\) soit dérivable dans le contexte vide (sinon, tout type serait habité par une variable : \(\texttt{x} : \tau \vdash \texttt{x} : \tau\)).
Dans la suite, on dira \(t : \tau\) pour affirmer que \(t\) a le type \(\tau\).
Remarque
On peut se poser la question du contexte dans la définition précédente : il est là pour traiter des variables libres.
Le théorème suivant affirme que le typage est compatible avec la réduction, on parle de correction, ou soundness, du typage.
Théorème
Si \(\Gamma \vdash t : \tau\) est dérivable et \(t \rightarrow_\beta t'\), alors \(\Gamma \vdash t' : \tau\) est dérivable.
Ce théorème est admis.
Le théorème suivant affirme que l'objectif est bien rempli : la réduction des termes bien typés termine toujours.
Théorème
Tait 1967 Si \(t\) est bien typé, alors il a une forme normale.
De plus, ici, toute suite de réductions \(\rightarrow_\beta\) partant de \(t\) est finie, et sa longueur est majorée par une constante ne dépendant que de \(t\) : c'est impossible de boucler en réduisant. On dit qu'il y a normalisation forte. Ce théorème est admis.
Remarque
Même si les types sont simples et que cela correspond à la déduction naturelle, il a fallu attendre 35 ans entre la définition du \(\lambda\)-calcul et ce théorème.
Exemple
Voici un exemple de preuve du fait que
((fun f -> fun x -> f x) (fun x -> x)) y
est bien typé :
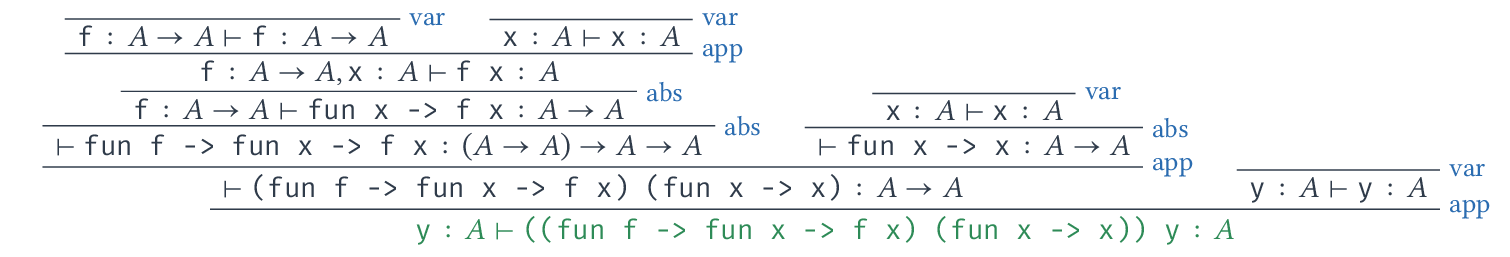
On a retiré des contextes les hypothèses inutiles pour alléger la preuve.
Si on représente le terme sous la forme d'un arbre, on constate que cet arbre a exactement la même structure que la preuve.
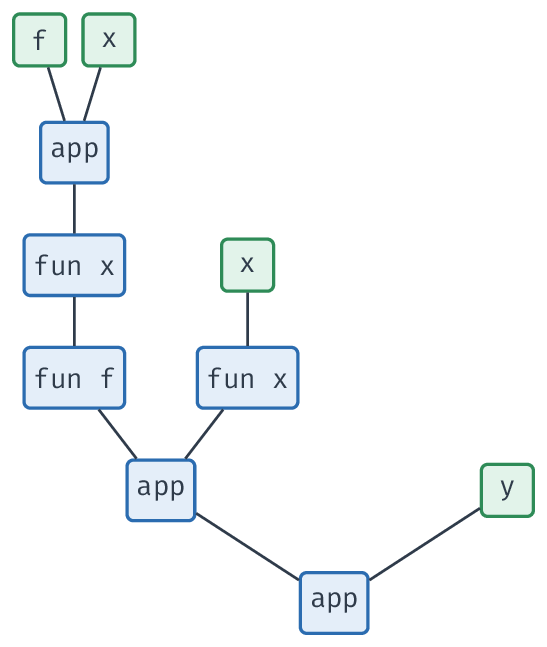
Le terme est en quelque sorte une représentation à plat de la preuve.
Une fois le terme connu, il n'est pas possible de changer les règles à appliquer. Elles sont déjà présentes dans le terme.
Par contre, on peut oublier les termes dans l'arbre de typage et ne conserver que les formules. On obtient alors une preuve valide en déduction naturelle.
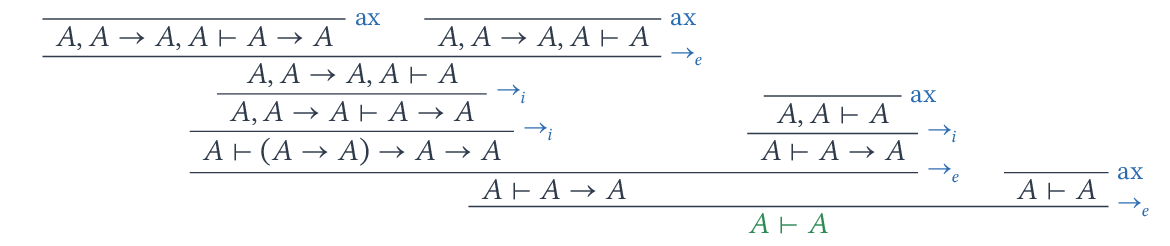
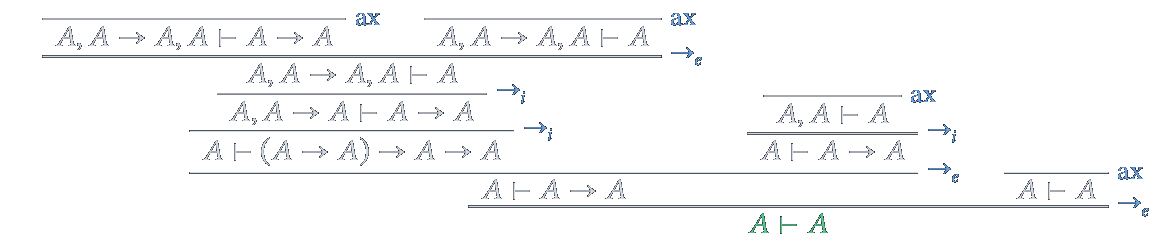
Bien entendu, cette preuve semble très étrange vu qu'une simple règle axiome
permet de conclure. Mais on pourrait également remarquer que le terme admet y
comme forme normale et que la preuve du typage y \(: A\) ne sera également
qu'une seule règle var.
Comme on vient de le voir, vérifier un typage ne demande aucune invention : le choix des règles à appliquer ainsi que les formules utilisées pour les éliminations sont déjà connus. La vérification est purement mécanique par induction.
La question qui se posera est plutôt de savoir inventer un bon type pour un terme typable donné. C'est la question de l'inférence de type.
Enrichir le langage
On va enrichir le langage avec de nouvelles constructions.
Les termes sont maintenant définis par :
Et les types par :
On retrouve ainsi les connecteurs \(\wedge\) et \(\vee\) du calcul propositionnel.
On considère également quatre nouveaux types de redex pour la réduction. C'est un peu abusif de parler de \(\beta\)-réduction, donc on utilisera uniquement \(\rightarrow\) ici et on parlera juste de réduction.
fst (t,t')\(\rightarrow\)tsnd (t,t')\(\rightarrow\)t'match Left t with Left x -> u | Right y -> v\(\rightarrow\)u[x\t]match Right t with Left x -> u | Right y -> v\(\rightarrow\)v[y\t]
Ces règles correspondent à l'exécution en OCaml en rajoutant la définition de
type :
type ('a,'b) type_or = Left of 'a | Right of 'b
Remarque
Il peut sembler que ce que l'on propose ici est un enrichissement de la syntaxe, mais en fait, c'est surtout le système de type qu'on enrichit.
En effet, on pourrait supposer l'existence de termes fonctionnels réalisant les éléments de syntaxe. Ce qui compte, c'est surtout de pouvoir les typer.
L'exemple caractéristique, ce sont les couples. Une fois acquise une construction \(A \wedge B\) (ou
A * B en OCaml) pour le type d'un couple, on pourrait admettre l'existence de trois fonctions
polymorphes :
make_pair : A -> B -> A * Bfst : A * B -> Asnd : A * B -> B
Reste à demander à ce que fst (make_pair x y) = x pour tout x,y, et la relation symétrique
pour snd.
On rajoute également des nouvelles règles de typage :
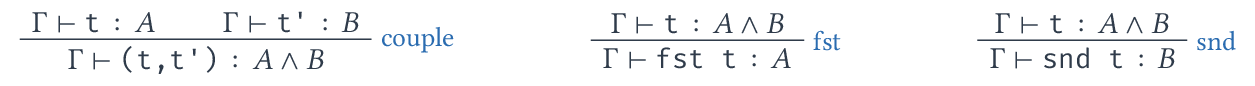



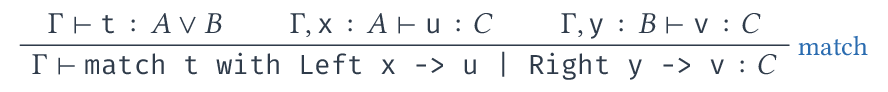
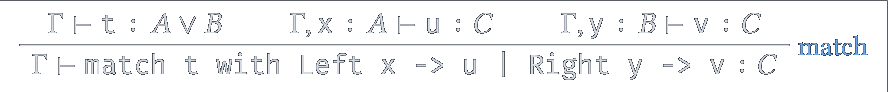
On retrouve exactement les règles \(\wedge_i\), \(\wedge_{e,g}\), \(\wedge_{e,d}\), \(\vee_{i,g}\), \(\vee_{i,d}\) et \(\vee_e\) de la déduction naturelle.
Exemple
On considère le terme
fun p -> match fst p with Left a -> Left (a, snd p) | Right b -> Right (b, snd p)
qui prend un couple dont la première composante est un Left ou un Right
et fait « rentrer » la seconde composante dans le Left ou le Right.
On note \(t\) le corps de la fonction (le match), \(\Gamma\) le contexte
\(\texttt{p} : (A \vee B) \wedge C\) et \(D = (A \wedge C) \vee (B \wedge C)\).
Voici une dérivation de typage de ce terme :
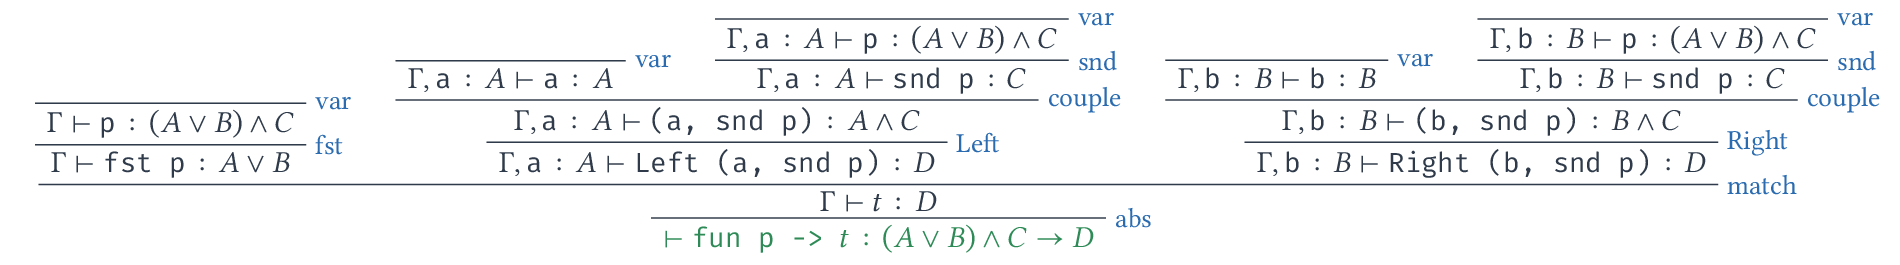
En oubliant les termes, on obtient exactement la preuve de
\((A \vee B) \wedge C \vdash (A \wedge C) \vee (B \wedge C)\) donnée en
exemple dans le chapitre Déduction naturelle,
suivie d'une règle \(\rightarrow_i\). Chaque règle de la preuve se lit dans
le terme : le match est la disjonction de cas \(\vee_e\), fst et snd
sont les éliminations \(\wedge_{e,g}\) et \(\wedge_{e,d}\), le couple est
\(\wedge_i\), Left et Right sont \(\vee_{i,g}\) et \(\vee_{i,d}\).
En OCaml, avec le type type_or précédent, cette fonction est acceptée
et le type inféré est bien la formule attendue :
let distrib = fun p ->
  match fst p with
  | Left a -> Left (a, snd p)
  | Right b -> Right (b, snd p)
(* val distrib : ('a, 'b) type_or * 'c -> ('a * 'c, 'b * 'c) type_or *)
Conclusion : la correspondance de Curry-Howard
Ce qu'on a observé tout au long de ce chapitre porte le nom de correspondance de Curry-Howard (ou correspondance preuves-programmes) : on peut lire chaque terme bien typé comme une preuve, et chaque type comme la formule qu'il prouve.
| Logique (déduction naturelle) | Programmation (\(\lambda\)-calcul typé) |
|---|---|
| formule | type |
| preuve de \(\Gamma \vdash A\) | terme \(t\) tel que \(\Gamma \vdash t : A\) |
| hypothèse, règle \(ax\) | variable, règle var |
| \(\rightarrow_i\) / \(\rightarrow_e\) | fun x -> t / application |
| \(\wedge_i\) / \(\wedge_{e,g}\), \(\wedge_{e,d}\) | couple / fst, snd |
| \(\vee_{i,g}\), \(\vee_{i,d}\) / \(\vee_e\) | Left, Right / match |
| formule prouvable | type habité |
| simplification d'une preuve | réduction d'un terme |
Le dernier point mérite une explication. Un redex, comme fst (t,t'),
correspond dans la preuve à une introduction immédiatement suivie d'une
élimination du même connecteur : on prouve \(A \wedge B\) pour en déduire
aussitôt \(A\), ce qui est un détour inutile puisqu'on avait déjà une preuve de
\(A\). Réduire le terme, c'est supprimer ce détour dans la preuve. Le théorème de
correction du typage affirme que la preuve obtenue prouve toujours la même
formule, et le théorème de Tait affirme qu'on finit toujours par obtenir une
preuve sans détour.
Remarque
La correspondance permet de transporter des résultats d'un monde à
l'autre. Par exemple, la formule de Peirce
\(((A \rightarrow B) \rightarrow A) \rightarrow A\) est une tautologie, mais
elle n'est pas prouvable en déduction naturelle intuitionniste (on peut le
voir avec la sémantique de Gödel).
Comme une dérivation de typage donne une preuve en oubliant les termes, le
type (('a -> 'b) -> 'a) -> 'a n'est habité par aucun terme de notre
\(\lambda\)-calcul. On ne peut donc pas écrire de fonction OCaml de ce type
avec les seules constructions de ce chapitre : il faudrait des traits
impératifs comme les exceptions, ou une fonction qui ne termine pas.
Remarque
On n'a pas traité ici \(\bot\), \(\neg\), ni les quantificateurs. On peut
prolonger la correspondance : \(\bot\) correspond à un type vide, et les
quantificateurs à des types dépendants. C'est sur ce principe que reposent
les assistants de preuve comme Rocq (anciennement Coq) ou Lean, dans
lesquels écrire une preuve revient à écrire un programme bien typé.