Source image : https://www.flickr.com/photos/x6e38/3440634940/
Remarque
Dans ce chapitre, on étudie des problèmes pour lesquels on va exprimer des algorithmes permettant d'obtenir des solutions exactes. C'est à contraster avec le chapitre sur l'algorithmique approchée.
Une grande partie des stratégies de résolution est basée sur la résolution de sous-problèmes. On verra ainsi trois types de stratégies résumées dans le schéma suivant :
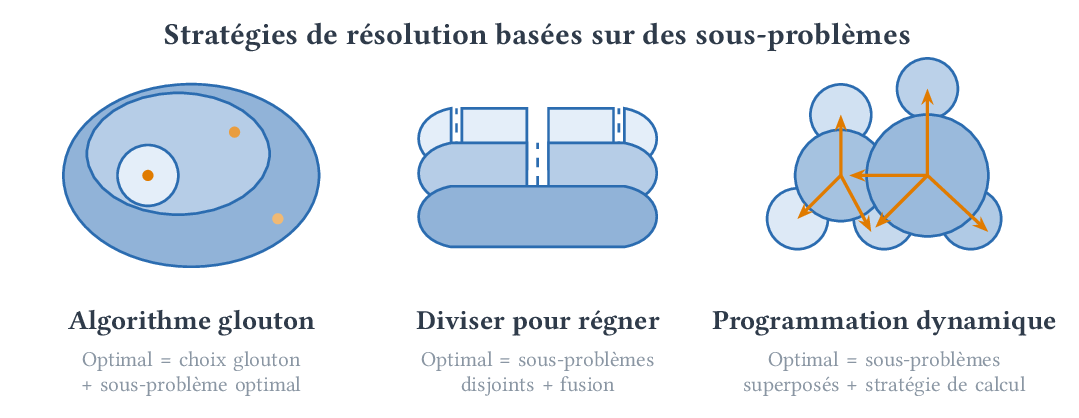
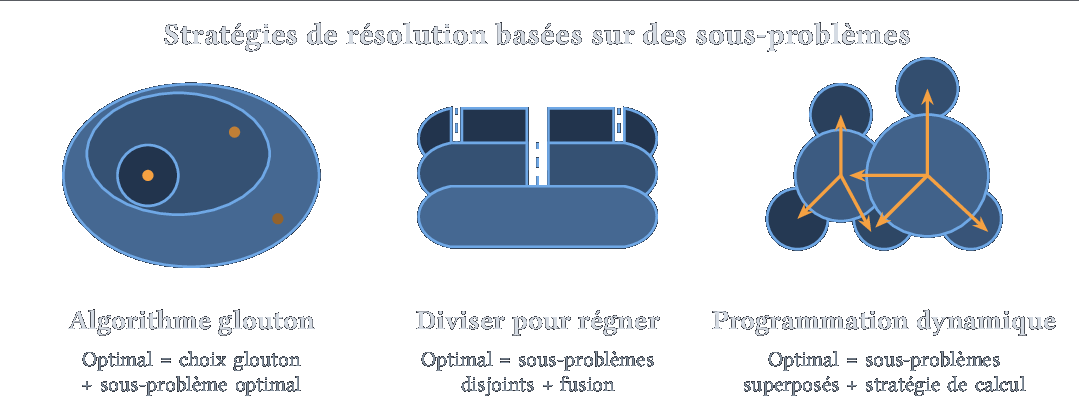
Stratégies de résolution
Ces stratégies se comparent bien sur l'arbre des positions qu'on construit en prenant des décisions successives, décrit au début du chapitre sur les algorithmes gloutons et dans le résumé du chapitre sur la programmation dynamique.
- Recherche exhaustive. On explore tout l'arbre, en abandonnant au plus tôt les branches qui ne peuvent pas aboutir (retour sur trace). C'est toujours possible, mais l'arbre est le plus souvent de taille exponentielle. Voir le chapitre sur la recherche par force brute.
- Algorithme glouton. On ne suit qu'une branche, en faisant à chaque étape le choix qui semble localement le meilleur. C'est très efficace, mais il faut démontrer que ce choix mène à une solution optimale (choix glouton et sous-problème optimal), ce qui est faux en général. Voir le chapitre sur les algorithmes gloutons.
- Diviser pour régner. On découpe le problème en sous-problèmes disjoints, résolus récursivement, dont on fusionne les solutions. Voir le chapitre diviser pour régner.
- Programmation dynamique. Quand les sous-problèmes se superposent, c'est-à-dire quand on atteint une même position par plusieurs chemins, on calcule la valeur optimale une seule fois par sous-problème, par mémoïsation ou par tabulation, à l'aide d'une équation de récurrence (équation de Bellman). On explore ainsi le graphe des positions plutôt que l'arbre. Voir le chapitre sur la programmation dynamique, qui traite le principe général (mémoïsation, tabulation, reconstruction) et de nombreux exemples (chemins monotones, produit de matrices, plus longue sous-séquence croissante, distance d'édition), ainsi que le TP Python sur la somme de sous-ensembles.
Exemple
Le rendu de monnaie illustre ces différences. Le glouton qui rend toujours la plus grosse pièce possible n'est pas optimal pour le système \((1, 2, 7, 10)\) : il rend \(14 = 10 + 2 + 2\) alors que \(14 = 7 + 7\). La recherche exhaustive trouve l'optimum mais en temps exponentiel, alors que la programmation dynamique calcule le nombre minimal de pièces pour chaque montant de \(0\) à \(n\), en temps \(O(n p)\) pour \(p\) pièces.
Compléments de programmation dynamique
Deux exemples classiques supplémentaires, qui suivent la méthode du chapitre sur la programmation dynamique.
Ordonnancement de tâches pondérées
On reprend le problème de la sélection d'activités en associant à chaque activité un poids, par exemple le gain qu'elle rapporte. On ne cherche plus à maximiser le nombre d'activités sélectionnées mais leur poids total. Il ne faut pas confondre ce problème avec l'ordonnancement de tâches avec dates limites du chapitre glouton.
Problème : ordonnancement de tâches pondérées
- Entrée : \(n\) activités \((d_1,f_1,w_1), \dots, (d_n,f_n,w_n)\) avec \(d_i < f_i\) et \(w_i \in \N\).
- Sortie : un ensemble indépendant \(I \subset \range{1}{n}\), c'est-à-dire sans deux activités en conflit, tel que \(\sum_{i \in I} w_i\) soit maximal.
Comme dans le chapitre glouton, \((d_i,f_i)\) et \((d_j,f_j)\) sont en conflit quand \([d_i,f_i[ \cap [d_j,f_j[ \neq \emptyset\). Si tous les poids valent \(1\), on retrouve la sélection d'activités.
Exemple
On considère les activités suivantes, déjà triées par temps de fin :
| \(i\) | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| \(d_i\) | 0 | 3 | 2 | 4 |
| \(f_i\) | 3 | 5 | 6 | 7 |
| \(w_i\) | 3 | 1 | 6 | 4 |
- Le glouton de la sélection d'activités choisit \(\{1, 2\}\) de poids \(4\).
- Le glouton qui choisit les activités par poids décroissant choisit \(\{3\}\) de poids \(6\), car \(3\) est en conflit avec toutes les autres.
- L'optimum est \(\{1, 4\}\) de poids \(7\).
On trie les activités par temps de fin croissant : \(f_1 \le \dots \le f_n\). On s'intéresse alors à la dernière activité \(n\) : soit on ne la prend pas, soit on la prend et on ne peut alors garder que des activités finissant avant \(d_n\). Pour \(j \in \range{1}{n}\), on note
Comme les \(f_i\) sont croissants, les activités \(i < j\) qui finissent avant \(d_j\) sont exactement \(1, \dots, \mathop{pred}(j)\).
Pour \(j \in \range{0}{n}\), on note \(\mathop{Opt}(j)\) le poids maximal d'un ensemble indépendant inclus dans \(\range{1}{j}\).
Théorème
\(\mathop{Opt}(0) = 0\) et pour \(j \in \range{1}{n}\), \(\mathop{Opt}(j) = \max\left( \mathop{Opt}(j-1), w_j + \mathop{Opt}(\mathop{pred}(j)) \right)\).
Preuve
Soit \(j \ge 1\) et \(I \subset \range{1}{j}\) un ensemble indépendant de poids \(\mathop{Opt}(j)\).
- Si \(j \notin I\), alors \(I \subset \range{1}{j-1}\) et \(\mathop{Opt}(j) \le \mathop{Opt}(j-1)\).
- Si \(j \in I\), soit \(i \in I \setminus \{j\}\). On a \(i < j\) donc \(f_i \le f_j\). Si on avait \(f_i > d_j\), comme \(d_i < f_i \le f_j\), les activités \(i\) et \(j\) seraient en conflit. Donc \(f_i \le d_j\), c'est-à-dire \(i \le \mathop{pred}(j)\). Ainsi \(I \setminus \{j\}\) est un ensemble indépendant inclus dans \(\range{1}{\mathop{pred}(j)}\) et \(\mathop{Opt}(j) \le w_j + \mathop{Opt}(\mathop{pred}(j))\).
Réciproquement, un ensemble indépendant de \(\range{1}{j-1}\) est un ensemble indépendant de \(\range{1}{j}\), et si \(J\) est un ensemble indépendant de \(\range{1}{\mathop{pred}(j)}\), alors \(J \cup \{j\}\) est indépendant car toutes les activités de \(J\) finissent avant \(d_j\). Donc \(\mathop{Opt}(j)\) est supérieur aux deux valeurs du maximum.
Exemple
Sur l'exemple précédent, \(\mathop{pred} = (0, 1, 0, 1)\) et on obtient successivement \(\mathop{Opt} = (0, 3, 4, 6, 7)\). Pour reconstruire, on part de \(j = 4\) : \(\mathop{Opt}(4) \neq \mathop{Opt}(3)\) donc on prend \(4\) et on continue en \(\mathop{pred}(4) = 1\), où \(\mathop{Opt}(1) \neq \mathop{Opt}(0)\) donc on prend \(1\).
Comme les temps de fin sont triés, on calcule \(\mathop{pred}(j)\) par
dichotomie. Dans le code, les activités sont numérotées à partir de 0 et
pred.(j) est le nombre d'activités parmi les \(j-1\) premières qui finissent
avant le début de la \(j\)-ième.
type activite = { debut : int; fin : int; poids : int }

let ordonnancement_pondere activites =
  let a = Array.copy activites in
  Array.sort (fun x y -> compare x.fin y.fin) a;
  let n = Array.length a in
  (* pred.(j) : nombre d'activités a.(0..k-1) finissant avant le début
     de a.(j-1), obtenu par dichotomie *)
  let pred = Array.make (n + 1) 0 in
  for j = 1 to n do
    let d = a.(j-1).debut in
    (* invariant : a.(0..g-1) finissent avant d,
                   a.(dr..j-2) finissent après d *)
    let g = ref 0 and dr = ref (j - 1) in
    while !g < !dr do
      let m = (!g + !dr) / 2 in
      if a.(m).fin <= d then g := m + 1 else dr := m
    done;
    pred.(j) <- !g
  done;
  (* opt.(j) : poids maximal pour les activités a.(0..j-1) *)
  let opt = Array.make (n + 1) 0 in
  for j = 1 to n do
    opt.(j) <- max opt.(j-1) (a.(j-1).poids + opt.(pred.(j)))
  done;
  let rec reconstruit j acc =
    if j = 0 then acc
    else if opt.(j) = opt.(j-1) then reconstruit (j-1) acc
    else reconstruit pred.(j) (a.(j-1) :: acc)
  in
  opt.(n), reconstruit n []
#include <stdlib.h>
#include <stdbool.h>

typedef struct {
    int debut;
    int fin;
    int poids;
} activite;

int compare_activites(const void *x, const void *y)
{
    return ((const activite *)x)->fin - ((const activite *)y)->fin;
}

/* trie a selon les temps de fin et marque les activités choisies */
int ordonnancement_pondere(activite a[], int n, bool choisi[])
{
    qsort(a, n, sizeof(activite), compare_activites);
    int *pred = malloc(sizeof(int) * (n + 1));
    int *opt = malloc(sizeof(int) * (n + 1));
    opt[0] = 0;
    for (int j = 1; j <= n; j++)
    {
        /* dichotomie : nombre d'activités finissant avant a[j-1].debut */
        int g = 0, d = j - 1;
        while (g < d)
        {
            int m = (g + d) / 2;
            if (a[m].fin <= a[j - 1].debut)
                g = m + 1;
            else
                d = m;
        }
        pred[j] = g;
        int avec = a[j - 1].poids + opt[pred[j]];
        opt[j] = avec > opt[j - 1] ? avec : opt[j - 1];
    }
    /* reconstruction */
    for (int i = 0; i < n; i++)
        choisi[i] = false;
    int j = n;
    while (j > 0)
    {
        if (opt[j] == opt[j - 1])
            j--;
        else
        {
            choisi[j - 1] = true;
            j = pred[j];
        }
    }
    int res = opt[n];
    free(pred);
    free(opt);
    return res;
}
def ordonnancement_pondere(activites):
    """activites est une liste de triplets (debut, fin, poids)"""
    a = sorted(activites, key=lambda act: act[1])
    n = len(a)
    # pred[j] : nombre d'activités de a[0..j-2] finissant avant le début
    # de a[j-1], obtenu par dichotomie
    pred = [0] * (n + 1)
    for j in range(1, n + 1):
        g, d = 0, j - 1
        while g < d:
            m = (g + d) // 2
            if a[m][1] <= a[j-1][0]:
                g = m + 1
            else:
                d = m
        pred[j] = g
    # opt[j] : poids maximal pour les activités a[0..j-1]
    opt = [0] * (n + 1)
    for j in range(1, n + 1):
        opt[j] = max(opt[j-1], a[j-1][2] + opt[pred[j]])
    # reconstruction
    res = []
    j = n
    while j > 0:
        if opt[j] == opt[j-1]:
            j = j - 1
        else:
            res.append(a[j-1])
            j = pred[j]
    return opt[n], res[::-1]
Le tri et les \(n\) dichotomies sont en \(O(n \log_2 n)\), le remplissage de
opt et la reconstruction en \(O(n)\), d'où une complexité temporelle en
\(O(n \log_2 n)\).
Plus longue sous-suite commune
Définition
Soit \(u = u_1 \dots u_n\) un mot. On dit que \(w\) est une sous-suite (ou un mot extrait) de \(u\) s'il existe des indices \(1 \le i_1 < \dots < i_k \le n\) tels que \(w = u_{i_1} \dots u_{i_k}\).
Une plus longue sous-suite commune (plssc) à deux mots \(u\) et \(v\) est un mot de longueur maximale qui est une sous-suite de \(u\) et de \(v\).
Exemple
BCBA est une plssc de ABCBDAB et de BDCABA. Ce n'est pas la seule :
BDAB convient aussi.
Remarque
Une sous-suite n'est pas un facteur : les lettres ne sont pas forcément
consécutives. Ce problème intervient par exemple dans la commande diff, qui
affiche les différences entre deux fichiers en calculant une plssc de leurs
suites de lignes, ou en bio-informatique pour comparer des séquences d'ADN.
Comme il y a \(2^n\) sous-suites de \(u\), on cherche des sous-problèmes. On regarde les dernières lettres de \(u\) et \(v\) et on se ramène à des préfixes. Pour \(u = u_1 \dots u_n\) et \(v = v_1 \dots v_m\), on note, pour \(i \in \range{0}{n}\) et \(j \in \range{0}{m}\), \(L(i,j)\) la longueur d'une plssc de \(u_1 \dots u_i\) et \(v_1 \dots v_j\).
Théorème
- Pour tous \(i, j\), \(L(i,0) = L(0,j) = 0\).
- Pour \(i \ge 1\) et \(j \ge 1\),
Preuve
Le premier point vient de ce que la seule sous-suite du mot vide est le mot vide. Soient \(i, j \ge 1\) et \(w = w_1 \dots w_k\) une plssc de \(u_1 \dots u_i\) et \(v_1 \dots v_j\).
- Si \(u_i = v_j\). Si \(w'\) est une sous-suite commune à \(u_1 \dots u_{i-1}\) et \(v_1 \dots v_{j-1}\), alors \(w' u_i\) est une sous-suite commune à \(u_1 \dots u_i\) et \(v_1 \dots v_j\), donc \(L(i,j) \ge 1 + L(i-1,j-1)\). Réciproquement, on a forcément \(k \ge 1\) car \(u_i\) est une sous-suite commune. Soient \(i_1 < \dots < i_k \le i\) des indices réalisant \(w\) comme sous-suite de \(u_1 \dots u_i\). Si \(w_k \neq u_i\), alors \(w u_i\) serait une sous-suite commune de longueur \(k+1\), ce qui est absurde. Donc \(w_k = u_i\) et on peut remplacer \(i_k\) par \(i\) : les indices restent strictement croissants. Ainsi \(w_1 \dots w_{k-1}\) est une sous-suite de \(u_1 \dots u_{i-1}\) et, de même, de \(v_1 \dots v_{j-1}\). Donc \(k - 1 \le L(i-1,j-1)\).
- Si \(u_i \neq v_j\). Toute sous-suite commune à \(u_1 \dots u_{i-1}\) et \(v_1 \dots v_j\) (ou à \(u_1 \dots u_i\) et \(v_1 \dots v_{j-1}\)) est une sous-suite commune à \(u_1 \dots u_i\) et \(v_1 \dots v_j\), d'où l'inégalité \(\ge\). Réciproquement, si \(k \ge 1\), \(w_k\) ne peut pas être à la fois égale à \(u_i\) et à \(v_j\). Si \(w_k \neq u_i\), le dernier indice de \(w\) dans \(u\) est strictement inférieur à \(i\) et \(w\) est une sous-suite commune à \(u_1 \dots u_{i-1}\) et \(v_1 \dots v_j\), donc \(k \le L(i-1,j)\). Sinon, \(w_k \neq v_j\) et, de même, \(k \le L(i,j-1)\). Si \(k = 0\), c'est direct.
Chaque valeur \(L(i,j)\) dépend de valeurs situées sur la ligne précédente ou à gauche sur la même ligne : on remplit donc le tableau ligne par ligne, de gauche à droite. Pour reconstruire une plssc, on part de \((n,m)\) et on remonte en suivant l'égalité qui a donné \(L(i,j)\), ce qui fournit les lettres de la fin vers le début.
let plssc u v =
  let n = String.length u and m = String.length v in
  (* l.(i).(j) : longueur d'une plssc de u[0..i-1] et v[0..j-1] *)
  let l = Array.make_matrix (n + 1) (m + 1) 0 in
  for i = 1 to n do
    for j = 1 to m do
      l.(i).(j) <-
        if u.[i-1] = v.[j-1] then 1 + l.(i-1).(j-1)
        else max l.(i-1).(j) l.(i).(j-1)
    done
  done;
  (* reconstruction en partant de la fin *)
  let rec reconstruit i j acc =
    if i = 0 || j = 0 then acc
    else if u.[i-1] = v.[j-1] then reconstruit (i-1) (j-1) (u.[i-1] :: acc)
    else if l.(i-1).(j) >= l.(i).(j-1) then reconstruit (i-1) j acc
    else reconstruit i (j-1) acc
  in
  String.of_seq (List.to_seq (reconstruit n m []))
#include <stdlib.h>
#include <string.h>

char *plssc(const char *u, const char *v)
{
    int n = strlen(u), m = strlen(v);
    /* l[i * (m+1) + j] : longueur d'une plssc de u[0..i-1] et v[0..j-1] */
    int *l = malloc(sizeof(int) * (n + 1) * (m + 1));
    for (int i = 0; i <= n; i++)
        for (int j = 0; j <= m; j++)
        {
            if (i == 0 || j == 0)
                l[i * (m + 1) + j] = 0;
            else if (u[i - 1] == v[j - 1])
                l[i * (m + 1) + j] = 1 + l[(i - 1) * (m + 1) + j - 1];
            else
            {
                int a = l[(i - 1) * (m + 1) + j], b = l[i * (m + 1) + j - 1];
                l[i * (m + 1) + j] = a > b ? a : b;
            }
        }
    /* reconstruction en partant de la fin */
    int k = l[n * (m + 1) + m];
    char *w = malloc(k + 1);
    w[k] = '\0';
    int i = n, j = m;
    while (i > 0 && j > 0)
    {
        if (u[i - 1] == v[j - 1])
        {
            w[--k] = u[i - 1];
            i--;
            j--;
        }
        else if (l[(i - 1) * (m + 1) + j] >= l[i * (m + 1) + j - 1])
            i--;
        else
            j--;
    }
    free(l);
    return w;
}
def plssc(u, v):
    n, m = len(u), len(v)
    # l[i][j] : longueur d'une plssc de u[0..i-1] et v[0..j-1]
    l = [[0] * (m + 1) for _ in range(n + 1)]
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            if u[i-1] == v[j-1]:
                l[i][j] = 1 + l[i-1][j-1]
            else:
                l[i][j] = max(l[i-1][j], l[i][j-1])
    # reconstruction en partant de la fin
    res = []
    i, j = n, m
    while i > 0 and j > 0:
        if u[i-1] == v[j-1]:
            res.append(u[i-1])
            i, j = i - 1, j - 1
        elif l[i-1][j] >= l[i][j-1]:
            i = i - 1
        else:
            j = j - 1
    return ''.join(reversed(res))
La complexité temporelle et spatiale est en \(O(nm)\) et la reconstruction en \(O(n+m)\) puisque \(i + j\) diminue à chaque étape.