Introduction
Dans le cadre de l'étude des structures de données, il est fréquent de considérer non pas la complexité dans le pire des cas d'une opération mais celle d'une succession d'opérations divisée par le nombre d'opérations effectuées. Ainsi, on peut très bien avoir une opération ponctuellement plus coûteuse que les autres, mais en procédant ainsi on lisse le surcoût sur l'ensemble des opérations. On parle alors de complexité amortie.
Remarque
Cette notion ne masque pas le fait qu'une opération puisse prendre ponctuellement plus de temps. Dans des contextes temps réel où il est important de maîtriser pleinement les complexités, il est peu judicieux d'utiliser de telles complexités. Par exemple, dans une visualisation en 3D, pour maintenir un débit constant d'images par seconde, chaque image doit prendre un temps similaire. Se reposer sur une structure de données ayant une faible complexité amortie mais une complexité dans le pire des cas importante, c'est risquer d'avoir des saccades avec une image qui prendrait plus de temps pour être calculée.
Remarque
La complexité amortie n'est pas une complexité en moyenne : il n'y a ici aucune hypothèse probabiliste sur les entrées. On majore le coût total de n'importe quelle suite d'opérations, dans le pire des cas.
On va reprendre ici deux exemples simples déjà traités par ailleurs.
Implémentation d'une file avec deux piles
On considère une file réalisée avec deux piles in et out (voir
le chapitre Piles et files).
Comme on l'a vu, on enfile en \(O(1)\) en empilant sur la pile in et on défile :
- soit en \(O(1)\) en dépilant sur
outsi elle est non vide ; - soit en \(O(p)\), où \(p\) est le nombre d'éléments de
in, en déversantindansoutpuis en se ramenant au cas précédent.
Ainsi, en pire cas, on est en \(O(n)\) pour l'opération défiler, où \(n\) est le nombre d'éléments de la file, mais la bascule permettra de faire ensuite cette même opération en \(O(1)\).
Les tableaux dynamiques
Les tableaux dynamiques sont une structure de données de haut niveau pour implémenter le type abstrait des listes. La différence principale entre cette structure de données et celle des tableaux de C est qu'on peut ajouter et supprimer des éléments.
Un tableau dynamique d'entiers est un triplet (t,c,l) où t est un tableau
de taille c, appelée la capacité du tableau dynamique, et l est un autre entier
représentant la longueur logique du tableau.
À tout moment \(c \ge l\). Dans t il
y a ainsi \(c-l\) cases déjà allouées qui permettent de rajouter un élément en
temps constant. Quand \(c=l\), on alloue une nouvelle zone mémoire, souvent de
taille \(2c\), on recopie le tableau t dans cette zone et on a donc, pour les
ajouts suivants, un certain nombre de cases d'avance.
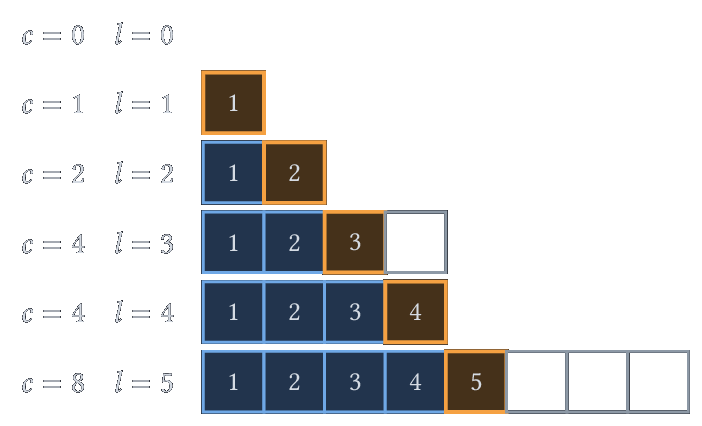
La figure suivante présente une succession d'ajouts :

Une implémentation de ces opérations est proposée dans le programme suivant :
#include <stdio.h>
#include <stdlib.h>
#include <assert.h>

typedef struct {
    int *t;
    size_t c;
    size_t l;
} tableau_dynamique;

tableau_dynamique tableau_dynamique_creer(void)
{
    tableau_dynamique d;

    d.t = NULL;
    d.c = 0;
    d.l = 0;

    return d;
}

void tableau_dynamique_ajout(tableau_dynamique *d, int x)
{
    if (d->c == d->l)
    {
        if (d->c == 0)
        {
            d->c = 1;
            d->t = malloc(sizeof(int));
        }
        else
        {
            d->c = 2 * d->c;
            d->t = realloc(d->t, d->c * sizeof(int));
        }
        assert(d->t != NULL);
    }
    d->t[d->l] = x;
    d->l++;
}

void tableau_dynamique_detruire(tableau_dynamique *d)
{
    free(d->t);
    d->t = NULL;
    d->c = 0;
    d->l = 0;
}

void tableau_dynamique_print(tableau_dynamique d)
{
    printf("c=%zu\tl=%zu\t|", d.c, d.l);
    for (size_t i = 0; i < d.l; i++)
    {
        printf("%d|", d.t[i]);
    }
    for (size_t i = d.l; i < d.c; i++)
    {
        printf(" |");
    }
    printf("\n");
}

int main(void)
{
    tableau_dynamique d = tableau_dynamique_creer();
    tableau_dynamique_print(d);
    for (int i = 1; i < 6; i++)
    {
        tableau_dynamique_ajout(&d, i);
        tableau_dynamique_print(d);
    }
    tableau_dynamique_detruire(&d);
    return 0;
}
Ce programme, une fois exécuté, produit la sortie suivante qui permet de retrouver exactement le comportement attendu :
c=0 l=0 |
c=1 l=1 |1|
c=2 l=2 |1|2|
c=4 l=3 |1|2|3| |
c=4 l=4 |1|2|3|4|
c=8 l=5 |1|2|3|4|5| | | |
Remarque
La fonction realloc recopie, si nécessaire, le contenu de l'ancienne zone
dans la nouvelle : c'est cette recopie de \(l\) éléments qui fait le coût d'un
doublement.
Avec une analyse en pire cas, l'ajout d'un élément peut entraîner un doublement de taille et une recopie, donc coûter \(O(c)\) opérations où \(c\) est la capacité avant doublement. Cependant, on constate que ce doublement permettra plusieurs ajouts ensuite en temps constant, ainsi, le pire cas ne semble pas le plus pertinent.
Techniques de calcul
Cadre
On considère une structure de données, pour simplifier initialement vide, et une succession \(o_1, \dots, o_n\) d'opérations valides sur cette structure de données. En reprenant l'exemple précédent, cela peut être une succession d'ajouts ou de suppressions dans une file mais sans jamais essayer de retirer des éléments à une file vide.
On considère de plus que pour chaque opération \(o_i\), on connaît le coût temporel \(c_i\) en termes d'opérations élémentaires. La question que l'on se pose est d'estimer \(\frac{1}{n} \sum_{i=1}^n c_i\), c'est-à-dire le coût moyen de chaque opération. L'objectif est de montrer que ce coût moyen est \(O(f(n))\), avec assez souvent \(O(1)\), c'est-à-dire que \(\sum_{i=1}^n c_i = O(n f(n))\), quelle que soit la suite d'opérations valides considérée. On dit alors que les opérations ont une complexité amortie en \(O(f(n))\).
Calcul naïf
Une approche naïve consiste à calculer directement la somme des coûts. On parle aussi de méthode de l'agrégat. Tout le problème ici est qu'on ne connaît pas les opérations et l'ordre dans lequel elles ont été effectuées.
Exemple de la file avec deux piles
On va commencer par calculer \(c_i\) pour les différentes opérations :
- S'il s'agit d'un ajout sur
inou d'un dépilement surout, on a \(c_i = 1\). - Si l'opération est un dépilement nécessitant un renversement, on a \(c_i =
2 p + 1\) où \(p \ge 1\) est la taille de
in: \(p\) dépilements dein, \(p\) empilements suroutpuis un dépilement deout.
Le problème du calcul naïf ici est de connaître l'ordre des opérations.
On peut regrouper les opérations \(o_1,\dots,o_n\) par paquets :
ajouts, suppression avec renversement, ajouts ou suppressions sans
renversement, suppression avec renversement... On va noter \(r\) le nombre de
renversements et \(p_i\) la taille de in avant le \(i\)-ème renversement. On a
donc \(p_1\) ajouts avant le premier renversement et \(p_{i+1}\) ajouts entre le
\(i\)-ème et le \((i+1)\)-ème renversement. Comme out doit être vide pour qu'un
renversement ait lieu, on a effectué exactement \(p_i-1\) suppressions sans
renversement entre les deux.
Les \(m\) éventuelles opérations qui suivent le dernier renversement coûtent chacune \(1\) : elles ajoutent \(m\) au coût total comme au nombre d'opérations. On commence par supposer que \(o_n\) est la suppression provoquant le \(r\)-ième renversement, c'est-à-dire \(m = 0\).
On obtient alors
car \(p_r \ge 1\).
Pour conclure, il est nécessaire de relier le nombre d'opérations aux \(p_i\). Or, on a
Ainsi \(\frac{1}{n} \sum_{i=1}^n c_i \le 4\). Dans le cas général, en notant \(S = p_1 + \dots + p_r\), on a \(\sum_{i=1}^n c_i \le 4S + m\) et \(n \ge S + m\), donc on a encore \(\frac{1}{n} \sum_{i=1}^n c_i \le 4\) (et c'est immédiat s'il n'y a aucun renversement, puisque toutes les opérations coûtent alors \(1\)).
Remarque
Cette analyse est assez pénible à mettre en œuvre car elle demande de compter avec précision ce qui se passe.
Exemple du tableau dynamique
Ici, les opérations sont toutes des ajouts d'éléments, mais certains provoquent une recopie tandis que d'autres sont en temps constant. On compte une unité pour l'écriture du nouvel élément et une unité par élément recopié. La suite des \(c_i\) est alors toujours \(1, 2, 3, 1, 5, 1, 1, 1, 9, 1, 1, 1, \dots\).
Plus précisément, \(c_i = \begin{cases} 2^p+1 & \text{si } i = 2^p+1 \text{ avec } p \in \N \\ 1 & \text{sinon} \end{cases}\).
Donc si \(n \ge 1\) et \(p = \lceil \log_2 n \rceil\), c'est-à-dire \(2^{p-1} < n \le 2^p\), les indices \(i \le n\) de la forme \(2^k + 1\) sont ceux pour lesquels \(k \in \range{0}{p-1}\), et on a \(\sum_{i=1}^n c_i = n + \sum_{k=0}^{p-1} 2^k = n + 2^p - 1 < 3n\), car \(2^p < 2n\).
On en déduit que \(\frac{1}{n} \sum_{i=1}^n c_i \le 3\) c'est-à-dire que c'est un \(O(1)\).
Améliorer la méthode naïve
Une amélioration de la méthode naïve va consister à considérer non pas le coût réel \(c_i\) de l'opération \(o_i\) mais un coût amorti \(c'_i\) tel qu'à la fin des opérations on ait \(\sum_{i=1}^n c_i \le \sum_{i=1}^n c'_i\) où cette dernière somme est facile à majorer.
On fera souvent en sorte que la majoration soit valide tout au long des opérations, c'est-à-dire que
Méthode du banquier
On va imaginer maintenant que les opérations coûtent un certain nombre de crédits, comme si l'ordinateur marchait avec des pièces de monnaie. Cette méthode est aussi appelée méthode comptable.
Des opérations vont alors accumuler des crédits dans une réserve et d'autres opérations vont consommer ces crédits. L'idée est de payer un peu plus pour chaque opération peu coûteuse afin de couvrir les coûts des opérations coûteuses.
Précisément, on considère pour chaque opération \(o_i\) :
- une quantité \(a_i \ge 0\) de crédits qui seront accumulés dans la réserve ;
- et une quantité \(d_i \ge 0\) de crédits qu'il faudra dépenser.
On pose alors \(c'_i = c_i + a_i - d_i\). On s'arrange pour faire en sorte que \(c'_i \le A f(n)\) où \(A\) est une constante. Dans le cas d'une complexité constante amortie, on s'assurera que \(c'_i \le A\).
On va maintenir un invariant sur les crédits qui est que
Cela signifie qu'à tout moment la réserve de crédits est positive ou nulle : on ne dépense pas de crédits n'ayant pas été accumulés.
On a alors directement la majoration voulue de \(\sum_i c_i\) : soit \(k \in \range{1}{n}\),
et donc \(\sum_{i=1}^n c_i \le \sum_{i=1}^n c'_i \le n A f(n)\).
Exemple de la file avec deux piles
Pour chaque élément enfilé on va allouer deux crédits correspondant
au futur dépilement de in puis empilement sur out qui auront lieu
lors du renversement.
On pose donc pour chaque opération \(o_i\), \(c'_i = c_i + a_i - d_i\) où :
- \(a_i = 2\) et \(d_i = 0\) si l'opération est un ajout ;
- \(a_i = d_i = 0\) si l'opération est un défilement ne nécessitant pas de renversement ;
- \(a_i = 0\) et \(d_i = 2 p\) où \(p\) est la taille de
indans le cas d'un défilement provoquant un renversement.
Soit \(k \in \range{1}{n}\). On a donc \(\sum_{i=1}^k a_i = 2 A\) où \(A\) est le
nombre d'ajouts effectués par les \(k\) premières opérations. Si ces opérations
ont effectué des renversements successifs de \(p_1, p_2, \dots, p_r\) éléments
de in, on a
La majoration vient du fait qu'un élément n'est ajouté qu'une seule fois
dans in et ne quitte in qu'une seule fois, donc que la somme
\(p_1+\dots+p_r\) des longueurs de in lors des renversements ne peut dépasser
le nombre \(A\) d'éléments empilés.
On a ainsi vérifié l'invariant sur les crédits et on a donc la majoration \(\sum_{i=1}^k c_i \le \sum_{i=1}^k c'_i\).
Pour conclure, il suffit de calculer \(c'_i\) selon les cas :
- Si l'opération est un ajout, on a \(c'_i = 1 + 2 - 0 = 3\).
- Si l'opération est une suppression sans renversement, on a \(c'_i = 1\).
- Si l'opération est une suppression avec renversement, on a \(c'_i = 2 p + 1 + 0 - 2p = 1\).
Dans tous les cas, on a donc \(c'_i \le 3\).
On en déduit la majoration \(\sum_{i=1}^n c_i \le \sum_{i=1}^n c'_i \le 3 n\) qui est plus fine que la majoration obtenue précédemment.
Exemple du tableau dynamique
On va considérer qu'on alloue 2 crédits pour chaque opération d'ajout d'un élément (sauf pour le premier) :
- un crédit pour la première recopie de cet élément ;
- un crédit pour copier l'élément qui lui est symétrique par rapport à la demi-capacité :
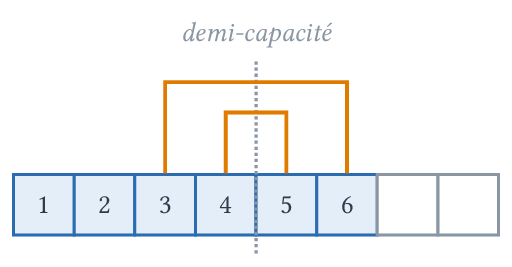
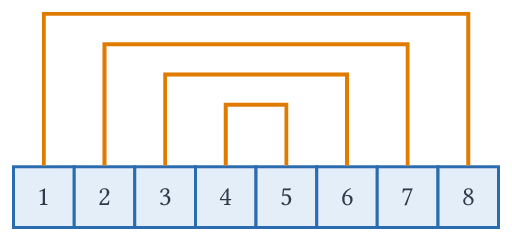
Ainsi, juste avant un doublement de capacité, on dispose d'un crédit pour chaque recopie :
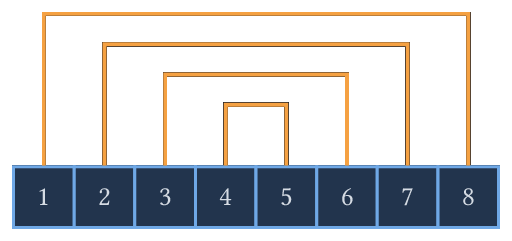
Plus précisément, on définit pour chaque opération \(o_i\) : \(c'_i = c_i + a_i - d_i\) où \(a_i = \begin{cases} 1 & \text{si } i = 1 \\ 2 & \text{sinon}\end{cases}\) et \(d_i = \begin{cases} 2^p & \text{si } i = 2^p+1 \text{ avec } p \in \N \\ 0 & \text{sinon} \end{cases}\).
On a donc \(c'_1 = 1 + 1 - 0 = 2\), \(c'_i = (2^p + 1) + 2 - 2^p = 3\) si \(i = 2^p + 1\) et \(c'_i = 1 + 2 - 0 = 3\) sinon. Dans tous les cas, \(c'_i \le 3\).
Théorème
\(\forall n \in \N^*, \sum_{i=1}^n a_i \ge \sum_{i=1}^n d_i\).
Preuve
On a \(\sum_{i=1}^n a_i = 2n - 1\). Si \(n = 1\), \(\sum_{i=1}^n d_i = 0\). Sinon, soit \(p \in \N\) tel que \(2^p < n \le 2^{p+1}\), c'est-à-dire \(2^p \le n - 1 < 2^{p+1}\). Les indices \(i \le n\) de la forme \(2^k + 1\) sont ceux pour lesquels \(k \le p\), donc
L'inégalité est bien vérifiée.
Ainsi,
On retombe sur une complexité amortie en \(O(1)\).
Présentation de la méthode
La présentation qui vient d'être faite de cette méthode est assez lourde bien que précise. En général, on se contente de présenter informellement la distribution de crédits en s'assurant qu'on a couvert les opérations coûteuses.
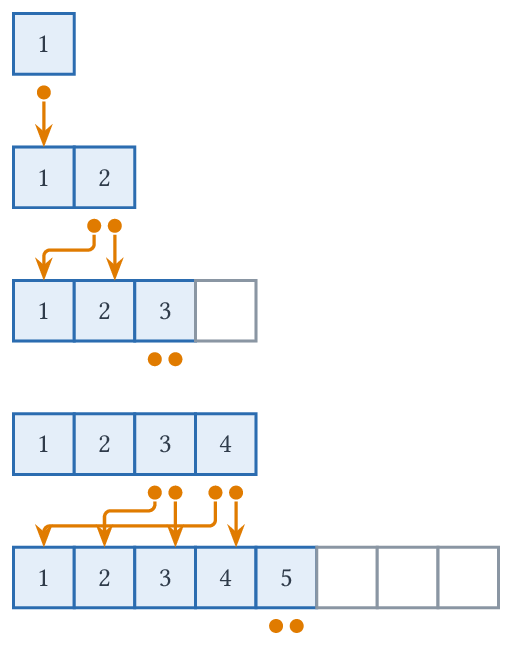
Une manière de bien s'en assurer est de décorer les structures de données en rendant les crédits apparents.
Si on reprend les tableaux dynamiques, on va rajouter sous une case le nombre de crédits dont elle dispose. Si on reprend la séquence d'ajouts précédente on pourra la représenter ainsi (les flèches indiquent les recopies payées par chaque crédit lors d'un doublement) :
Méthode du potentiel
L'idée de la méthode du potentiel est de définir une fonction \(\Phi\) qui associe à chaque valeur de la structure de données un nombre réel. Ce réel correspond à la notion physique de potentiel : si on considère un pendule simple dans sa trajectoire, son énergie potentielle est maximale au sommet quand sa vitesse, et donc son énergie cinétique, est nulle. À l'inverse son énergie potentielle est minimale au point le plus bas et sa vitesse maximale.
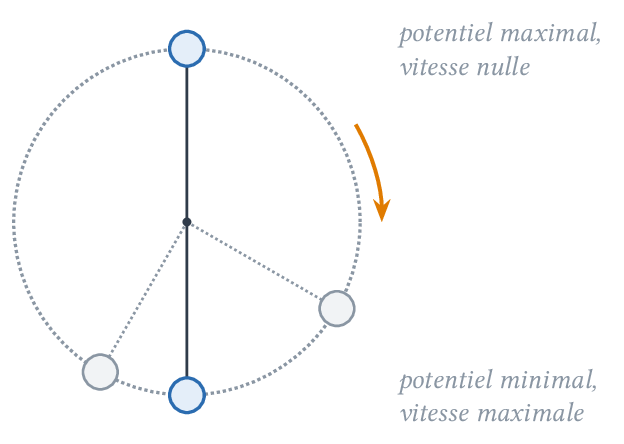
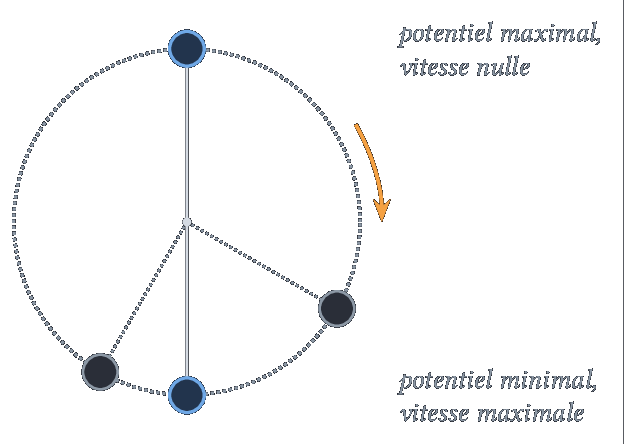
L'idée ici est que le potentiel va correspondre aux gains de temps obtenus par des opérations peu coûteuses. Chaque opération va ainsi faire évoluer le potentiel. On peut prendre l'image d'un empilement de tuiles de bois, comme des Kapla : chaque ajout d'une tuile de bois augmente le potentiel jusqu'à un éventuel effondrement. On retrouve ici la dualité entre les opérations rapides et les opérations coûteuses liées à un basculement.
Précisément, on va noter \(t_i\) la structure obtenue à l'issue de l'opération \(o_i\). On considère que \(t_0\) est la structure vide et \(\Phi(t_0) =0\). On pose \(c'_i = c_i + \Phi(t_i) - \Phi(t_{i-1})\), ce qui correspond à considérer la différence de potentiel.
On a donc, par télescopage,
Pour conclure par une majoration de \(\sum_{i=1}^k c_i\), il suffit de s'assurer que le potentiel ne soit jamais négatif : on a alors \(\sum_{i=1}^k c_i \le \sum_{i=1}^k c'_i\).
Exemple de la file avec deux piles
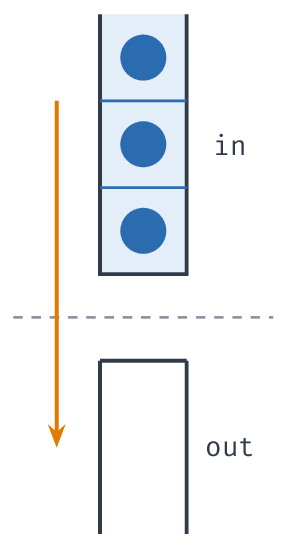
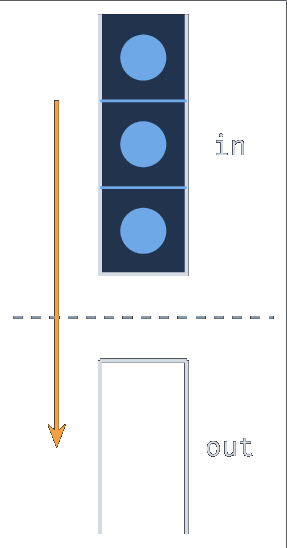
On va poser \(\Phi(t) = 2|\textsf{in}|\) où \(|\textsf{in}|\) est
la taille de la pile d'entrée. Pour reprendre le parallèle physique,
on peut s'imaginer que la pile in est au-dessus de la pile out
et que les éléments menacent de s'y déverser, ce qui permet
d'avoir l'image du potentiel comme pour le pendule au sommet de sa
trajectoire.
On a directement la majoration car \(\Phi(t) \ge 0\) et \(\Phi(t_0) = 0\).
Pour conclure, il faut calculer \(c'_i\) dans chaque cas :
- Si l'opération est un ajout,
inaugmente d'un élément et donc \(c'_i = c_i + 2 = 3\). - Si l'opération est une suppression sans renversement, le potentiel ne change pas et \(c'_i = 1\).
- Si l'opération est une suppression avec renversement
et que
incontient \(p\) éléments, on a \(c'_i = 2 p + 1 + 0 - 2p = 1\).
On retombe exactement sur le calcul précédent avec la méthode du banquier.
Remarque
Dans le chapitre Piles et files, on compte un coût \(k+1\) (et non \(2k+1\)) pour un renversement de \(k\) éléments, et le potentiel \(|\textsf{in}|\) suffit alors : c'est le même raisonnement avec un autre modèle de coût.
Exemple du tableau dynamique
On pose ici \(\Phi(t) = 2 l(t) - c(t)\) où \(l(t)\) est la longueur de \(t\) et \(c(t)\) est sa capacité.
Ici, ce potentiel se comprend mieux en écrivant \(2 (l(t) - c(t)/2)\) car \(l(t) - c(t)/2\) correspond au nombre d'éléments ajoutés depuis le dernier doublement.
On a \(\Phi(t_0) = 0\) et, comme on ne fait que des ajouts, \(c(t) \ge l(t) \ge \frac{c(t)}{2}\) (juste après un doublement, \(l(t) = A+1\) et \(c(t) = 2A\)), on a donc \(\Phi(t) \ge 0\), ce qui valide la majoration.
On calcule \(c'_i\) selon les cas d'ajout :
-
Le premier ajout fait passer la capacité de \(0\) à \(1\) sans recopie : \(c'_1 = 1 + \Phi(t_1) - \Phi(t_0) = 1 + (2 - 1) - 0 = 2\).
-
Si c'est un ajout sans doublement, alors \(l(t_i) = 1 + l(t_{i-1})\), \(c(t_i) = c(t_{i-1})\) et ainsi
\[ \begin{aligned} c'_i &= c_i + \Phi(t_i) - \Phi(t_{i-1}) \\ &= 1 + 2 l(t_{i-1}) + 2 - c(t_{i-1}) - 2 l(t_{i-1}) + c(t_{i-1}) = 3 \end{aligned} \] -
Si c'est un ajout avec doublement de capacité, alors \(l(t_{i-1}) = c(t_{i-1}) = A \ge 1\), \(l(t_i) = 1 + l(t_{i-1}) = 1 + A\), \(c(t_i) = 2 c(t_{i-1}) = 2A\) et \(c_i = A+1\). On a donc :
\[ \begin{aligned} c'_i &= c_i + \Phi(t_i) - \Phi(t_{i-1}) \\ & = A + 1 + 2(A+1) - 2A - 2A + A \\ & = 3 \end{aligned} \]
Ainsi, \(3 n \ge \sum_{i=1}^n c'_i \ge \sum_{i=1}^n c_i\). On retombe sur la majoration voulue.
Comparatif des méthodes
On remarque que la méthode du potentiel et la méthode du banquier sont très proches. En fait, on peut montrer qu'elles sont équivalentes : la réserve de crédits après \(k\) opérations, \(\sum_{i=1}^k (a_i - d_i)\), joue le rôle de \(\Phi(t_k)\), et réciproquement un potentiel définit les crédits \(a_i - d_i = \Phi(t_i) - \Phi(t_{i-1})\). La différence entre les deux est que la méthode du banquier demande de regarder avec précision les opérations pour lesquelles il va falloir allouer des crédits alors que pour la méthode du potentiel il suffit de trouver son expression, qui ne dépend que de l'état de la structure. Cependant, trouver l'expression du potentiel est parfois plus complexe que de définir les crédits.
On cherchera donc la méthode la mieux adaptée aux problèmes considérés. Dans l'exemple de la file, le potentiel est très facilement défini ; dans le cas du tableau dynamique, la méthode du banquier peut paraître plus naturelle.