MPI — DS 5 — Informatique. Durée : 4h.
Tous documents interdits.
Preuves en déduction naturelle usuelle
Les règles et notations sont celles du chapitre de déduction naturelle.
Logique propositionnelle intuitionniste
On rappelle les règles de la déduction naturelle pour les connecteurs \(\wedge, \neg, \rightarrow\) et pour la règle axiome.
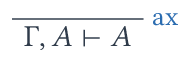
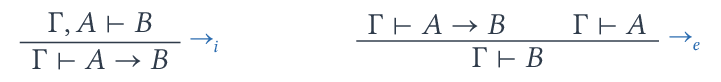




Question 1. Donnez les règles pour \(\vee\).
Corrigé


Question 2. Prouvez en déduction naturelle :
- \(A \wedge B \rightarrow B \wedge A\)
- \((A \vee B \rightarrow C) \rightarrow A \rightarrow C\)
- \(A \rightarrow \neg \neg A\)
Corrigé
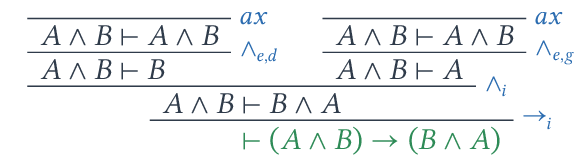
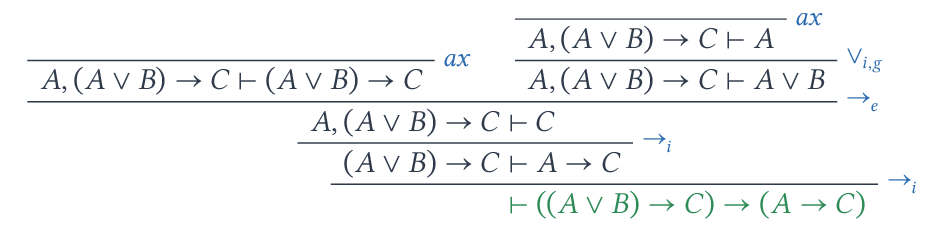
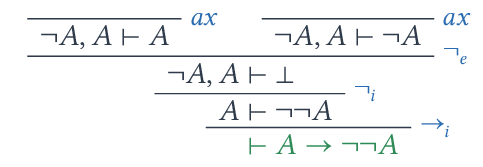
Logique propositionnelle classique
Question 3. On rajoute la règle :
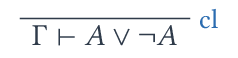
Démontrez :
- \(\neg \neg A \rightarrow A\)
- \(((A \rightarrow B) \rightarrow A) \rightarrow A\)
Corrigé
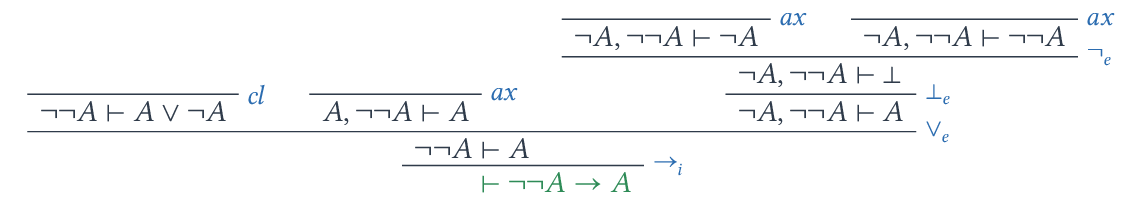
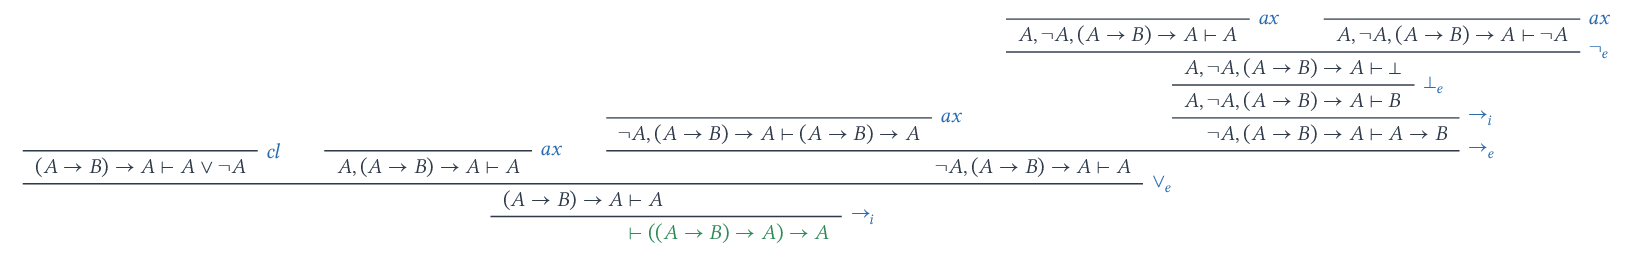
Logique du premier ordre
On rappelle les règles sur les quantificateurs :
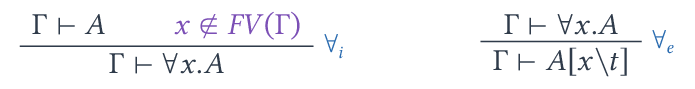
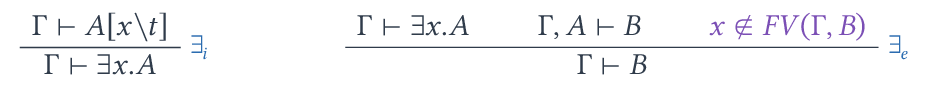

Question 4. Démontrez :
- \(P(a) \rightarrow Q(a) \rightarrow \exists x. P(x) \wedge Q(x)\)
- \((\forall x.P(x)) \rightarrow \exists x.P(x)\)
Corrigé
-
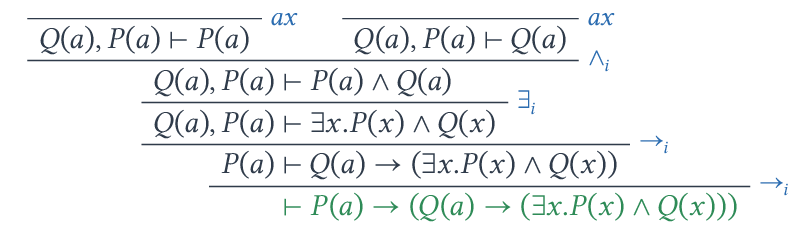
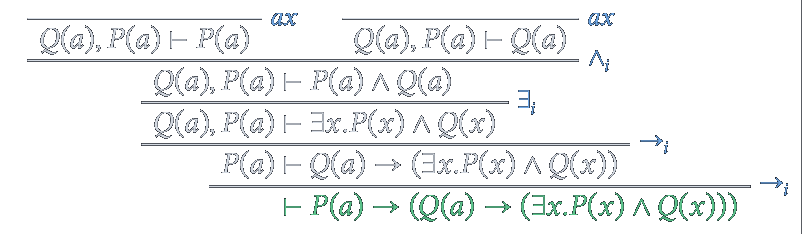
-
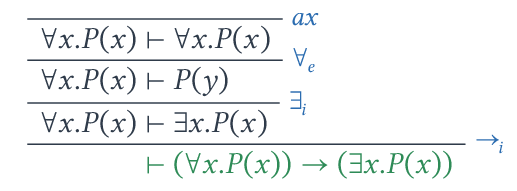
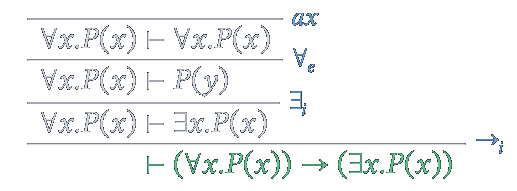
On a utilisé \(\forall_e\) avec le terme \(y\), puis \(\exists_i\) avec ce même terme.
Grammaires
On emploiera ici le mot grammaire par simplification pour désigner des grammaires non contextuelles. Les définitions et notations sont celles du chapitre sur les grammaires.
Étude d'une chaîne dans une grammaire
On considère la grammaire donnée par \(G = (\{ +, *, a \}, \{ S \}, P, S)\) où \(P\) est l'ensemble des productions :
et un mot \(m = aa+a*\).
Question 5. Donnez une dérivation à gauche de \(m\).
Corrigé
\(S \Rightarrow S S * \Rightarrow S S + S * \Rightarrow a S + S * \Rightarrow a a + S * \Rightarrow a a + a *\)
Question 6. Donnez une dérivation à droite de \(m\).
Corrigé
\(S \Rightarrow S S * \Rightarrow S a * \Rightarrow S S + a * \Rightarrow S a + a * \Rightarrow a a + a *\)
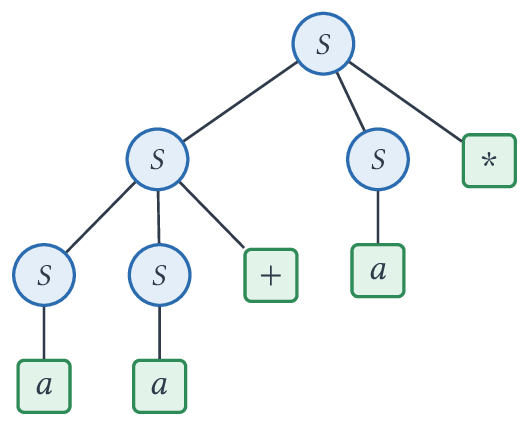
Question 7. Donnez un arbre d'analyse de \(m\).
Corrigé
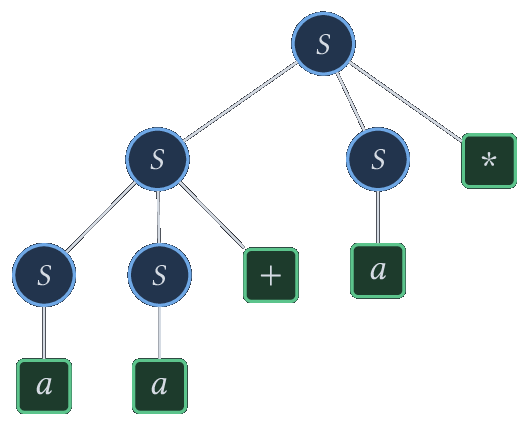
Question 8. Cette grammaire est-elle ambiguë ? Justifiez votre réponse.
Corrigé
Cette grammaire n'est pas ambiguë car chaque production va faire apparaître un terminal à droite qui fixe la règle à appliquer.
Pour que l'argument soit complet, il faut aussi justifier que le découpage d'un mot \(w = w_1 w_2 +\) (ou \(w_1 w_2 *\)) avec \(w_1, w_2 \in \mathop{lang}(G)\) est unique. On associe à chaque mot son poids : le nombre de \(a\) moins le nombre d'opérateurs. Par récurrence sur la dérivation, tout mot \(w\) de \(\mathop{lang}(G)\) est de poids \(1\) et tous ses préfixes non vides sont de poids \(\ge 1\) : c'est vrai pour \(a\) et, pour \(w_1 w_2 +\), un préfixe non vide de \(w_1\) est de poids \(\ge 1\), un préfixe \(w_1 p\) avec \(p\) préfixe non vide de \(w_2\) est de poids \(1 + (\ge 1) \ge 2\) et \(w_1 w_2 +\) est de poids \(1 + 1 - 1 = 1\).
Ainsi, \(w_1\) est le plus long préfixe de poids \(1\) de \(w_1 w_2\) : il est déterminé par \(w\). On montre alors par récurrence forte sur la longueur que tout mot de \(\mathop{lang}(G)\) a un unique arbre d'analyse : la dernière lettre fixe la règle appliquée à la racine, le découpage \(w_1 w_2\) est unique et, par hypothèse de récurrence, \(w_1\) et \(w_2\) ont chacun un unique arbre d'analyse.
Question 9. Décrivez le langage reconnu par cette grammaire.
Corrigé
Ce sont les expressions postfixes sur a avec deux opérations binaires : * et +.
Écriture de grammaires
Question 10. Déterminez une grammaire reconnaissant l'ensemble des palindromes sur l'alphabet \(\{0,1\}\).
Rappel : un palindrome est un mot qui se lit de la même manière de gauche à droite et de droite à gauche.
Corrigé
On considère la grammaire \(G\) définie par
Les règles \(S \rightarrow 0\) et \(S \rightarrow 1\) sont indispensables pour obtenir les palindromes de longueur impaire, comme \(0\) ou \(101\).
Il est assez immédiat que \(\mathop{lang}(G)\) est l'ensemble des palindromes, par récurrence sur la longueur d'un mot : un mot de longueur au plus \(1\) est un palindrome et est engendré directement ; sinon, on considère la première lettre qui est forcément égale à la dernière, soit par application d'une production, soit par définition, et ainsi on peut faire la récurrence sur le mot intérieur.
Question 11. Déterminez une grammaire reconnaissant l'ensemble des mots sur \(\{0,1\}\) qui ne contiennent pas \(011\).
Corrigé
Ici, c'est un langage régulier, on peut donc raisonner un peu à la manière des automates (voir la construction d'une grammaire linéaire à droite à partir d'un automate dans le chapitre sur les grammaires) :
Le non terminal \(S\) correspond à un préfixe lu ne se terminant pas par un début de \(011\), \(S'\) à un préfixe se terminant par \(0\) et \(S''\) à un préfixe se terminant par \(01\) : depuis \(S''\), lire un \(1\) est interdit.
On montre que le langage est bien celui demandé par récurrence sur la longueur d'un mot, en raisonnant sur le préfixe.
Écriture d'un analyseur syntaxique
On considère la grammaire \(G\) donnée par :
- les terminaux \(\textbf{if}, \textbf{then}, \textbf{else}, \textbf{begin}, \textbf{end}, \textbf{print}, ;, +, -, *, /, (, ), \textbf{id}, \textbf{num}\)
- les non terminaux \(stmt, stmtList, expr, term, factor\)
- le symbole initial \(stmt\)
- et les productions :
Les terminaux sont ainsi donnés, dans l'ordre précédent, par un type token :
type token =
    | Tif | Tthen | Telse | Tbegin | Tend | Tprint
    | Tscolon | Tplus | Tminus | Ttimes | Tdiv
    | Tlpar | Trpar | Tid of string | Tnum of int
On définit un type pour représenter l'arbre syntaxique :
type expr =
      Variable of string
    | Constant of int
    | Add of expr * expr
    | Substract of expr * expr
    | Mult of expr * expr
    | Divide of expr * expr

type stmt =
    | IfThenElse of expr * stmt * stmt option
    | Block of stmt list
    | Print of expr
On vous donne également une fonction :
val parse_expr : token list -> expr * token list
où parse_expr tl prend en entrée une liste de tokens et renvoie un couple (e, tl')
où e est l'expression lue et tl' sont les tokens restants.
Question 12. Pour cette question, on pourra, avec une note qui en dépendra, considérer :
- soit la grammaire complète précédente ;
- soit la grammaire simplifiée sans le
else; - soit la grammaire simplifiée sans les deux productions du
if.
Écrivez une fonction
val parse_stmt : token list -> stmt * token list
où parse_stmt tl prend en entrée une liste de tokens et renvoie un couple
(st, tl') où st est un stmt lu et tl' sont les tokens restants.
Corrigé
On lève une exception ParsingError en cas d'erreur de syntaxe.
exception ParsingError

let rec parse_stmt tl =
    match tl with
    | Tif :: q -> begin
        let cond, tl1 = parse_expr q in
        match tl1 with
        | Tthen :: q1 -> begin
            let sthen, tl2 = parse_stmt q1 in
            match tl2 with
            | Telse :: q2 ->
                let selse, tl3 = parse_stmt q2 in
                IfThenElse(cond, sthen, Some selse), tl3
            | _ -> IfThenElse(cond, sthen, None), tl2
        end
        | _ -> raise ParsingError
    end
    | Tbegin :: q -> begin
        let s_list, tl1 = parse_stmt_list q in
        match tl1 with
        | Tend :: q1 -> Block s_list, q1
        | _ -> raise ParsingError
    end
    | Tprint :: q ->
        let e, tl1 = parse_expr q in
        Print e, tl1
    | _ -> raise ParsingError
and parse_stmt_list tl =
    let s, tl1 = parse_stmt tl in
    match tl1 with
    | Tscolon :: q ->
        let sl, tl2 = parse_stmt_list q in
        s :: sl, tl2
    | _ -> [s], tl1
La grammaire est ambiguë : \(\textbf{if}~e_1~\textbf{then}~\textbf{if}~e_2
~\textbf{then}~s_1~\textbf{else}~s_2\) a deux arbres d'analyse (problème
du « else pendant »). Cet analyseur, qui lit un else dès qu'il le
peut, rattache le else au if le plus proche, ce qui est la convention
usuelle.
Extension de la syntaxe
On se propose de rajouter deux extensions pour écrire les productions :
- \(A \rightarrow \alpha [\beta] \gamma\) signifiant que \(\beta\) est optionnel. Cela équivaut à \(A \rightarrow \alpha \gamma ~|~ \alpha \beta \gamma\) ;
- \(A \rightarrow \alpha \{\beta\} \gamma\) signifiant que \(\beta\) peut être répété un nombre quelconque de fois, y compris \(0\) fois. Cela équivaut à \(A \rightarrow \alpha \gamma ~|~ \alpha \beta \gamma ~|~ \alpha \beta \beta \gamma ~|~ \dots\)
Question 13. Donnez une forme simplifiée de la grammaire précédente en utilisant cette extension.
On ne changera pas, et on ne répétera pas, les productions pour les expressions.
Corrigé
Question 14. Démontrez que toute grammaire utilisant ces extensions peut se mettre sous une forme faiblement équivalente qui ne les utilise pas.
Corrigé
La réponse est dans la question pour la première extension.
Pour la deuxième extension, il suffit de remplacer
par
où \(A'\) est un nouveau non terminal, propre à cette occurrence. On a \(A' \Rightarrow^* \beta^k A'\) pour tout \(k\), donc \(A'\) se dérive en \(\beta^k\) pour tout \(k \in \N\), et ce sont les seules possibilités : cette transformation ne change pas le langage engendré.
Si les extensions sont imbriquées ou multiples, on les élimine une par une. Pour que le nombre d'extensions diminue strictement à chaque étape, il vaut mieux traiter aussi la première extension avec un nouveau non terminal, \(A \rightarrow \alpha A' \gamma\) et \(A' \rightarrow \beta ~|~ \epsilon\) : la réécriture \(A \rightarrow \alpha \gamma ~|~ \alpha \beta \gamma\) dupliquerait les extensions éventuellement présentes dans \(\alpha\) et \(\gamma\). Chaque étape supprime ainsi exactement une paire de crochets ou d'accolades, et on obtient au bout d'un nombre fini d'étapes une grammaire sans extension faiblement équivalente.
★ Lemme d'Ogden
On va présenter ici un lemme qui sera l'équivalent du lemme de l'étoile pour les grammaires non contextuelles.
Lemme combinatoire sur les arbres
On considère ici un arbre d'arité quelconque dont certaines feuilles sont distinguées.
On dit alors que :
- un nœud est distingué lorsque le sous-arbre dont il est racine contient des feuilles distinguées ;
- un nœud est spécial lorsqu'il a au moins deux fils distingués.
Une branche est un chemin de la racine à une feuille.
Remarque
Cette notion de distingué est juste une manière d'introduire une sorte de coloration qui va nous servir pour rajouter de la structure dans un arbre de dérivation dans la suite. C'est une forme de ressource, comme lorsqu'on comptait des crédits pour la complexité amortie.
Question 15. On dit qu'un nœud est le plus petit ancêtre commun de deux nœuds \(x\) et \(y\) s'il est le premier nœud où les branches de \(x\) et \(y\) vers la racine se rejoignent.
Que peut-on dire du plus petit ancêtre commun de deux nœuds distingués ?
Corrigé
Soit \(z\) le plus petit ancêtre commun de deux nœuds distingués \(x\) et \(y\). Il est distingué, car son sous-arbre contient celui de \(x\).
Si de plus aucun des deux n'est ancêtre de l'autre (par exemple si ce sont deux feuilles distinctes), alors \(z \neq x\) et \(z \neq y\) : les chemins de \(z\) vers \(x\) et vers \(y\) passent par deux fils distincts de \(z\) (sinon ce fils serait un ancêtre commun plus bas). Ces deux fils sont distingués car leurs sous-arbres contiennent respectivement \(x\) et \(y\) : \(z\) est donc spécial.
Si \(x\) est un ancêtre de \(y\), le plus petit ancêtre commun est \(x\), qui n'a aucune raison d'être spécial.
On considère le lemme :
Lemme
Soit \(t\) un arbre dont tous les nœuds sont d'arité au plus \(m \ge 1\) et ayant \(k\) feuilles distinguées.
Si chaque branche de \(t\) contient au plus \(r\) nœuds spéciaux, alors \(k \le m^r\).
Question 16. En raisonnant par récurrence sur \(r\), démontrez ce lemme.
Corrigé
On remarque d'abord que le caractère distingué ou spécial d'un nœud ne dépend que du sous-arbre dont il est racine : on peut donc l'examiner indifféremment dans \(t\) ou dans un sous-arbre de \(t\).
On montre par récurrence sur \(r\) la propriété « pour tout arbre \(t\) d'arité au plus \(m\) dont chaque branche contient au plus \(r\) nœuds spéciaux, \(t\) a au plus \(m^r\) feuilles distinguées ».
- \(r = 0\) : si \(t\) avait deux feuilles distinguées distinctes, leur plus petit ancêtre commun serait spécial d'après la question précédente, et la branche menant à l'une de ces feuilles contiendrait un nœud spécial. Donc \(k \le 1 = m^0\).
-
Supposons la propriété vraie pour \(r\) et soit \(t\) dont chaque branche contient au plus \(r+1\) nœuds spéciaux. Si \(k \le 1\), on a bien \(k \le m^{r+1}\). Sinon, \(t\) contient un nœud spécial (le plus petit ancêtre commun de deux feuilles distinguées) ; soit \(s\) un nœud spécial de profondeur minimale.
Toutes les feuilles distinguées sont dans le sous-arbre de \(s\) : si une feuille distinguée \(f\) n'y était pas, en prenant une feuille distinguée \(g\) sous \(s\), le plus petit ancêtre commun de \(f\) et \(g\) serait un ancêtre strict de \(s\) et serait spécial, ce qui contredit la minimalité de la profondeur de \(s\).
Soient \(c_1, \dots, c_q\) les fils de \(s\), avec \(q \le m\). Toute branche du sous-arbre de racine \(c_l\) se prolonge en une branche de \(t\) passant par \(s\), qui est spécial et n'est pas dans ce sous-arbre : elle contient donc au plus \(r\) nœuds spéciaux. Par hypothèse de récurrence, le sous-arbre de racine \(c_l\) a au plus \(m^r\) feuilles distinguées, et donc
\[ k \le q \cdot m^r \le m^{r+1} \]
Lemme d'Ogden
On considère maintenant le lemme suivant dû à Ogden :
Lemme
Soit \(G = (\Sigma, V, P, S)\) une grammaire non contextuelle et \(X \in V\).
Il existe \(K \in \N\) tel que tout mot \(f \in (\Sigma \cup V)^*\) vérifiant \(X \Rightarrow^* f\) et ayant au moins \(K\) lettres, donc des éléments de \(\Sigma \cup V\), distinguées se factorise en \(f = \alpha u \beta v \gamma\) où \(\alpha,u,\beta,v,\gamma \in (\Sigma \cup V)^*\), avec :
- \(X \Rightarrow^* \alpha A \gamma\), \(A \Rightarrow^* u A v\), \(A \Rightarrow^* \beta\) où \(A \in V\) ;
- soit \(\alpha, u\) et \(\beta\), soit \(\beta, v\) et \(\gamma\) contiennent des lettres distinguées ;
- \(u \beta v\) contient moins de \(K\) lettres distinguées.
Question 17. Montrer que des conditions du lemme, on peut en déduire que pour tout \(n \in \N\), on a \(X \Rightarrow^* \alpha u^n \beta v^n \gamma\).
Note : c'est une forme d'étoile symétrique.
Corrigé
On montre par récurrence sur \(n\) que \(A \Rightarrow^* u^n A v^n\). Pour \(n = 0\), c'est la dérivation de longueur nulle. Si \(A \Rightarrow^* u^n A v^n\), comme les règles s'appliquent indépendamment du contexte, on peut dériver le \(A\) central en \(u A v\) : \(A \Rightarrow^* u^n A v^n \Rightarrow^* u^n u A v v^n = u^{n+1} A v^{n+1}\).
Ainsi, pour tout \(n\) :
Question 18. Démontrez le lemme d'Ogden en appliquant le lemme précédent à l'arbre correspondant à la dérivation.
Corrigé
Arbre d'une dérivation. Comme dans le cours, à une dérivation \(X \Rightarrow^* f\) on associe un arbre de racine \(X\) dont les nœuds internes sont étiquetés par des non terminaux et respectent les règles de production, mais dont les feuilles peuvent maintenant être étiquetées par des terminaux, par \(\epsilon\) ou par des non terminaux (ceux qui n'ont pas été réécrits). Sa frontière est \(f\), et réciproquement tout tel arbre de frontière \(f\) donne une dérivation \(X \Rightarrow^* f\) (même preuve que dans le cours). Les feuilles distinguées sont celles qui portent les lettres distinguées de \(f\).
Choix de \(K\). Soit \(h = |V|\) le nombre de non terminaux et \(m \ge 2\) un majorant de la longueur des membres droits des règles, qui majore donc l'arité des nœuds. On pose \(K = m^{2h+3} + 1\).
Soit \(f\) avec \(X \Rightarrow^* f\) ayant au moins \(K\) lettres distinguées, et \(t\) un arbre de cette dérivation. Comme \(t\) a plus de \(m^{2h+2}\) feuilles distinguées, d'après le lemme combinatoire, une branche de \(t\) contient au moins \(2h+3\) nœuds spéciaux.
Choix d'un sous-arbre. Soit \(x\) un nœud de profondeur maximale tel que le sous-arbre de racine \(x\) contienne une branche (de \(x\) à une feuille) avec au moins \(2h+3\) nœuds spéciaux. Aucun fils de \(x\) n'a cette propriété, donc chaque branche du sous-arbre de racine \(x\) contient au plus \(1 + (2h+2) = 2h+3\) nœuds spéciaux. D'après le lemme combinatoire, ce sous-arbre a au plus \(m^{2h+3} < K\) feuilles distinguées.
Choix de \(A\). Fixons une branche \(b\) issue de \(x\) contenant au moins \(2h+3\) nœuds spéciaux. Un nœud spécial \(s\) de \(b\) a au moins deux fils distingués, dont au plus un est sur \(b\) : il a donc un fils distingué à gauche ou à droite du fils par lequel passe \(b\). On dit que \(s\) est gauche ou droit en conséquence (au choix s'il est les deux). Parmi \(2h+3\) nœuds spéciaux, au moins \(h+2\) sont du même côté, disons gauche (l'autre cas est symétrique). Notons-les \(t_0, t_1, \dots, t_{h+1}\) de haut en bas. Parmi les \(h+1\) nœuds \(t_1, \dots, t_{h+1}\), deux portent la même étiquette \(A \in V\) d'après le principe des tiroirs : \(t_a\) au-dessus de \(t_c\), avec \(1 \le a < c\).
Factorisation. On note \(\beta\) la frontière du sous-arbre de racine \(t_c\), \(u \beta v\) celle du sous-arbre de racine \(t_a\), et \(f = \alpha u \beta v \gamma\).
- En coupant l'arbre sous \(t_a\), on obtient un arbre de racine \(X\) de frontière \(\alpha A \gamma\), donc \(X \Rightarrow^* \alpha A \gamma\). De même, le sous-arbre de racine \(t_a\) coupé sous \(t_c\) donne \(A \Rightarrow^* u A v\), et le sous-arbre de racine \(t_c\) donne \(A \Rightarrow^* \beta\).
- \(\beta\) contient une lettre distinguée car \(t_c\), spécial, est distingué. Le fils distingué gauche de \(t_a\) est à gauche de la branche \(b\), qui mène à \(t_c\) : ses feuilles sont dans \(u\), qui contient donc une lettre distinguée. De même, le fils distingué gauche de \(t_0\) est à gauche de \(t_a\) : \(\alpha\) contient une lettre distinguée.
- \(u \beta v\) est la frontière du sous-arbre de racine \(t_a\), inclus dans celui de racine \(x\) : il contient au plus \(m^{2h+3} < K\) lettres distinguées.
Dans le cas symétrique, on obtient de même que \(\beta, v\) et \(\gamma\) contiennent des lettres distinguées.
Le corollaire suivant suffit en pratique pour montrer qu'un langage n'est pas non contextuel :
Question 19. En déduire que si \(L\) est un langage non contextuel, il existe \(N \ge 0\) tel que pour tout mot \(f \in L\), si \(|f| \ge N\) alors on peut trouver une factorisation \(f = \alpha u \beta v \gamma\) telle que \(|uv|>0, |u \beta v| < N\) et \(\alpha u^n \beta v^n \gamma \in L\) pour tout \(n \ge 0\).
Corrigé
Soit \(G = (\Sigma, V, P, S)\) une grammaire engendrant \(L\) et \(K\) la constante donnée par le lemme d'Ogden pour \(X = S\). On pose \(N = K\).
Soit \(f \in L\) avec \(|f| \ge N\). On distingue toutes les lettres de \(f\) : il y en a au moins \(K\), et \(S \Rightarrow^* f\). On obtient une factorisation \(f = \alpha u \beta v \gamma\) vérifiant les trois conditions du lemme.
- D'après la condition 2, \(u\) ou \(v\) contient une lettre distinguée, donc \(|uv| > 0\).
- Toutes les lettres étant distinguées, la condition 3 donne \(|u \beta v| < K = N\).
- D'après la question 17, \(S \Rightarrow^* \alpha u^n \beta v^n \gamma\) pour tout \(n \ge 0\). Comme \(f \in \Sigma^*\), les mots \(\alpha, u, \beta, v, \gamma\) ne contiennent que des terminaux, donc \(\alpha u^n \beta v^n \gamma \in \mathop{lang}(G) = L\).
Application
Question 20. Démontrez que le langage \(L = \enscomp{ a^n b^n c^n }{n \ge 0}\) n'est pas reconnaissable par une grammaire non contextuelle.
Corrigé
Supposons \(L\) non contextuel et soit \(N\) donné par la question précédente. On considère \(f = a^N b^N c^N \in L\), de longueur \(3N \ge N\), et une factorisation \(f = \alpha u \beta v \gamma\) comme dans la question précédente.
Le facteur \(u \beta v\) est de longueur strictement inférieure à \(N\) : il ne peut pas contenir à la fois un \(a\) et un \(c\), sinon il contiendrait les \(N\) lettres \(b\) situées entre les deux. Supposons par exemple qu'il ne contienne pas de \(c\) (l'autre cas est symétrique).
Pour \(n = 0\), on a \(\alpha \beta \gamma \in L\). Or ce mot est obtenu en retirant de \(f\) les lettres de \(u\) et \(v\), qui ne sont pas des \(c\) : il contient donc encore \(N\) lettres \(c\), et il est de longueur \(3N - |uv| < 3N\). Un mot de \(L\) contenant \(N\) lettres \(c\) est \(a^N b^N c^N\), de longueur \(3N\) : contradiction.
Ainsi \(L\) n'est pas non contextuel.