Langages réguliers
Alphabet et mots
Définition
On considère un ensemble fini appelé alphabet et noté traditionnellement \(\Sigma\). Ses éléments sont appelés des lettres ou des symboles.
Un mot sur \(\Sigma\) est une suite finie d'éléments de \(\Sigma\). On note \(\epsilon\) le mot vide. Un mot non vide \((a,b,c,\dots)\) sera juste noté \(abc...\).
On note \(\Sigma^*\) l'ensemble des mots.
Exemple
Si \(\Sigma = \{ a, b, \dots, z \}\) alors \(bonjour\) est un mot.
On utilisera souvent l'alphabet réduit à deux lettres : \(\{ a, b\}\). Il est particulièrement important dans le contexte du binaire.
Remarque
- On a donc \(\Sigma^* = \bigcup_{n \in \N} \Sigma^n\) en posant \(\Sigma^0 = \{ \epsilon \}\).
- On note \(|u|\) la longueur du mot \(u\). On a donc \(|\epsilon| = 0\).
Définition
On définit une loi de composition \(.\) interne appelée concaténation ainsi :
Remarque
- \(\epsilon\) est le neutre de la concaténation
- La concaténation est associative. On dit que \((\Sigma^*, .)\) est un monoïde.
- On omet le plus souvent le symbole de la concaténation. Dans le contexte où on mélange des mots et des lettres, cela revient à identifier les lettres et les mots à une lettre qui leur sont associées. Par exemple, si on écrit \(awb\) avec \(a,b \in \Sigma\) et \(w \in \Sigma^*\).
- \(|uv| = |u| + |v|\).
- Si \(\Sigma = \{ \star \}\) l'alphabet à une lettre, alors \((\Sigma^*, .)\) est isomorphe à \((\N, +)\) en tant que monoïde.
Conséquence directe de la définition de \(\Sigma^*\) :
Théorème
Soient \(w, w' \in \Sigma^*\).
Suffixe, Préfixe, facteurs, sous-mots
Définition
Soit \(u,v \in \Sigma^*\). On dit que \(v\) est un
- suffixe de \(u\) lorsqu'il existe \(w\in \Sigma^*\) tel que \(u = w v\). Quand de plus \(w \neq \epsilon\), c'est-à-dire \(v \neq u\), on dit que \(v\) est un suffixe propre de \(u\).
- préfixe de \(u\) lorsqu'il existe \(w\in \Sigma^*\) tel que \(u = v w\). Quand de plus \(w \neq \epsilon\), on dit que \(v\) est un préfixe propre de \(u\).
- facteur de \(u\) lorsqu'il existe \(w,w' \in \Sigma^*\) tels que \(u = w v w'\). Quand de plus \(v \neq u\), on dit que \(v\) est un facteur propre de \(u\).
- sous-mot de \(u = x_1 \dots x_n\), où \(x_1,\dots, x_n \in \Sigma\), lorsqu'il existe des indices \(1 \le i_1 < i_2 < \dots < i_k \le n\) tels que \(v = x_{i_1} \dots x_{i_k}\). Pour \(k = 0\), on obtient que \(\epsilon\) est un sous-mot de tout mot.
Exemple
Si on considère le mot \(triskaidekaphobia\),
- \(tri\) est un préfixe propre
- \(phobia\) est un suffixe propre
- \(aide\) est un facteur propre
- \(trap\) est un sous-mot
Langage
Définition
Un langage sur l'alphabet \(\Sigma\) est une partie de \(\Sigma^*\).
Exemple
Sur l'alphabet \(\{a,b\}\), les ensembles suivants sont des langages :
- les mots ne contenant que des \(a\) : \(\enscomp{a^n}{n \in \N}\)
- les mots ayant le même nombre de \(a\) que de \(b\)
- les palindromes, c'est-à-dire les mots pouvant se lire de la même manière de gauche à droite et de droite à gauche
Remarque
Les langages peuvent être faciles à définir mais durs à expliciter. Il existe ainsi un langage contenant tous les énoncés que vous aurez aux concours, mais ce sera difficile de le déterminer avant les épreuves !
Définition
Soient \(L, L'\) des langages sur un même alphabet.
On note
- \(L+L' = L\cup L'\) le langage union de ces langages.
- \(L L' = \enscomp{uv}{u \in L, v\in L'}\) la concaténée de ces langages.
- \(L^n = L \dots L\) la concaténée de \(n\) copies de \(L\) et \(L^0 = \{ \epsilon \}\).
- \(L^* = \bigcup_{n \in \N} L^n\) appelée l'étoile de Kleene de \(L\).
Théorème
\(L^*\) est clos par concaténation : \(\forall w, w' \in L^*, ww' \in L^*\).
Preuve
Soit \(w, w' \in L^*\). Il existe \(n, m\) tels que \(w = w_1 \dots w_n \in L^n\) et \(w' = w'_1 \dots w'_m \in L^m\), on a donc \(w w' = w_1 \dots w_n w'_1 \dots w'_m \in L^{n+m} \subset L^*\).
Exemple
\(\emptyset^* = \{ \epsilon \}^* = \{ \epsilon \}\)
Remarque
On peut démontrer de nombreuses relations sur les langages :
- \(\cup\) est associative, commutative, idempotente et d'élément neutre \(\emptyset\).
- la concaténation est associative et d'élément neutre \(\{ \epsilon \}\) mais non commutative dès que \(\Sigma\) contient au moins deux lettres. Elle distribue sur l'union.
- L'étoile est idempotente : \((L^*)^* = L^*\).
Preuve
On a \(L^* = (L^*)^1 \subset (L^*)^*\). Réciproquement, soit \(w \in (L^*)^*\) : il existe \(n \in \N\) et \(w_1, \dots, w_n \in L^*\) tels que \(w = w_1 \dots w_n\). On montre par récurrence sur \(n\) que \(w_1 \dots w_n \in L^*\) : pour \(n = 0\), c'est le mot vide, qui est dans \(L^0 \subset L^*\), et le passage de \(n\) à \(n+1\) découle de la clôture de \(L^*\) par concaténation. Ainsi, on a l'égalité par double inclusion.
Langages réguliers
Définition
L'ensemble \(\mathop{Reg}(\Sigma)\) des langages réguliers sur \(\Sigma\) est défini inductivement ainsi :
- \(\emptyset \in \mathop{Reg}(\Sigma)\)
- \(\forall a \in \Sigma, \{a\} \in \mathop{Reg}(\Sigma)\)
- \(\forall A \in \mathop{Reg}(\Sigma), A^* \in \mathop{Reg}(\Sigma)\)
- \(\forall A,B \in \mathop{Reg}(\Sigma), A+B, AB \in \mathop{Reg}(\Sigma)\)
Remarque
- Autrement dit, \(\mathop{Reg}(\Sigma)\) est le plus petit ensemble contenant \(\emptyset\) et les langages réduits à une lettre qui soit stable par concaténation, union et étoile de Kleene.
- Les langages réguliers correspondent à la classe des langages facilement reconnaissables, comme on le verra dans la partie suivante, tout en étant suffisamment expressifs.
Exemple
Soit \(L\) le langage des mots sur \(\{ a, b \}\) sans facteurs \(aa\) ou \(bb\).
Il s'agit donc des mots qui alternent les lettres.
\(L\) est régulier car on peut l'écrire :
où \(\{\epsilon\} = \emptyset^*\) et \(\{ab\} = \{a\}\{b\}\) sont bien réguliers. En effet, un tel mot est de quatre formes selon qu'il commence ou pas par un \(b\) et qu'il finisse ou pas par un \(a\).
Expression régulière
On a pu voir dans le dernier exemple que la notation d'un langage régulier à l'aide de la définition inductive est un peu lourde. Afin d'améliorer cela, on va introduire une dénotation particulière des langages réguliers : les expressions régulières.
Définition
Les expressions régulières sur \(\Sigma\) sont des arbres d'expressions dont les feuilles sont étiquetées par \(\{ \emptyset, \epsilon \} \cup \Sigma\) et ayant des nœuds binaires étiquetés par \(\{|, .\}\) et des nœuds unaires étiquetés par \(\{*\}\).
On adopte la notation infixe usuelle pour ces expressions en plaçant \(*\) en opérateur unaire postfixe et en omettant de noter \(.\).
Exemple
Les expressions suivantes sont des expressions régulières sur \(\{a,b\}\) :
Remarque
On suppose que les opérateurs ont des précédences dans l'ordre \(* > . > |\) et ainsi, on pourra omettre certaines parenthèses : \((a(b^*))|c = ab^*|c\).
Définition
On associe à toute expression régulière \(e\) sur \(\Sigma\) un langage \(\mathop{lang}(e)\) :
- \(\mathop{lang}(\emptyset) = \emptyset\)
- \(\mathop{lang}(\epsilon) = \{ \epsilon \}\)
- \(\forall a \in \Sigma, \mathop{lang}(a) = \{ a \}\).
- \(\mathop{lang}(e e') = \mathop{lang}(e) \mathop{lang}(e')\)
- \(\mathop{lang}(e|e') = \mathop{lang}(e) + \mathop{lang}(e')\)
- \(\mathop{lang}(e^*) = \mathop{lang}(e)^*\)
On dit que \(e\) est une dénotation du langage \(\mathop{lang}(e)\).
La définition calquant celle des langages réguliers, on a le théorème suivant, qui se prouve par une induction immédiate dans chaque sens (le seul cas qui n'est pas une traduction directe est \(\mathop{lang}(\epsilon) = \{\epsilon\}\), qui est régulier car \(\{\epsilon\} = \emptyset^*\)) :
Théorème
Les langages admettant une dénotation par une expression régulière sont exactement les langages réguliers.
Remarque
Un langage régulier n'admet pas une unique dénotation. Par exemple, \(\{ a \}^*\) peut se noter \(a^*\) mais également \(aa^*|\epsilon\)
Afin de simplifier les expressions régulières, on est amené à identifier deux expressions régulières dénotant un même langage. Ainsi, on écrira directement \((a|b)c = ac|bc\).
Expressions régulières étendues POSIX
On distingue trois types d'expressions régulières dans les outils Unix :
- les expressions simples acceptées par un shell
- les expressions régulières POSIX
- les expressions régulières POSIX étendues.
On présente ici les expressions étendues. Elles sont composées :
- de caractères, pour ceux qui sont utilisés dans les définitions suivantes, on
les échappe avec un
\comme dans\.ou\* - de listes de caractères sous la forme
[abc]pour représenter \(a|b|c\). On peut aussi utilisera-zpour indiquer tous les caractères deaàz. - de listes niées de la forme
[^...]où on considère tous les caractères sauf ceux qui sont indiqués. - le caractère
.représente n'importe quel caractère. - le caractère
^est un caractère spécial représentant le début d'une chaîne. De même,$représente la fin. - de parenthèses pour regrouper des sous-expressions
- des opérateurs
*et|comme dans la définition des expressions régulières
On a également des ajouts pratiques :
+et?qui sont des sucres syntaxiques pour les définitions suivantes :e+ = ee*ete? = (e|). Il n'y a pas de \(\epsilon\), on se contente d'utiliser l'expression vide comme ici.- pour \(m,n \in \N\) et
eune expression on peut écrire :e{n}pour exactement \(n\) copies deee{m,}pour au moins \(m\) copies deee{,n}pour au plus \(n\) copies deee{m,n}pour entre \(m\) et \(n\) copies dee
Remarque
Il s'agit ici aussi de sucres. En effet, on pourrait écrire :
e{3} = eeee{3,} = eeee*e{,3} = (|e|ee|eee)e{2,3} = (ee|eee)
Automates finis
On va présenter ici un modèle de calcul permettant de reconnaître des langages réguliers.
Automates finis déterministes
Définition
Un automate fini déterministe est un quintuplet \(A = (Q, \Sigma, \delta, q_i, F)\) où
- \(\Sigma\) est un alphabet fini
- \(Q\) est un ensemble fini appelé l'ensemble des états de l'automate
- \(q_i \in Q\) est appelé l'état initial
- \(F \subset Q\) est appelé l'ensemble des états finaux
- \(\delta\) est une application partielle de \(Q \times \Sigma\) dans \(Q\) et est appelée la fonction de transition de l'automate.
Remarque
Une application partielle de \(E\) dans \(F\) est une application \(E' \rightarrow F\) où \(E' \subset E\) est le domaine de l'application.
Quand le domaine de \(\delta\) est \(Q \times \Sigma\), on dit que l'automate est complet.
Exemple
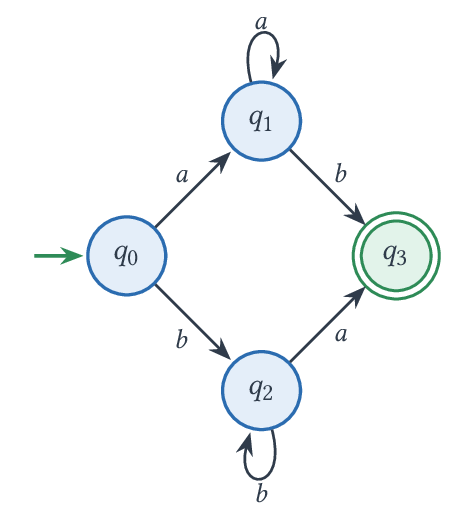
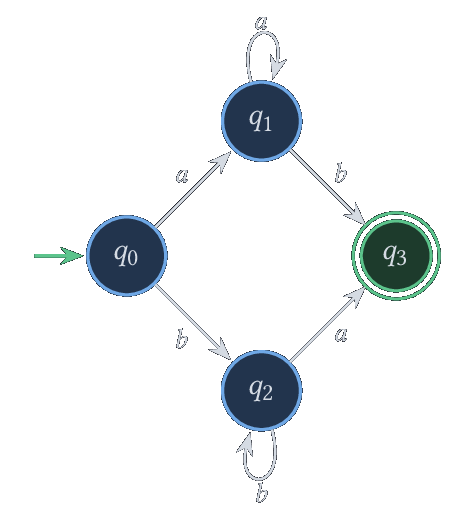
Considérons l'automate fini \(A = (\{q_0,q_1,q_2,q_3\}, \{a,b\}, \delta, q_0, \{ q_3 \})\) où :
et \(\delta(q_3, a)\), \(\delta(q_3, b)\) ne sont pas définies.
On peut représenter \(\delta\) sous forme tabulaire, on parle alors de table de transition. L'état initial est indiqué par une flèche et les états finaux par un astérisque.
On adopte une notation graphique pour présenter les automates. Les états sont des nœuds et les arêtes permettent de représenter \(\delta\). Les états finaux sont indiqués par une flèche sortante ou un double trait comme ici :
Accessibilité, Co-accessibilité
On peut préciser la notation précédente d'un automate sous la forme d'un graphe. Comme on peut avoir deux transitions \(\delta(q,a) = \delta(q,b) = q'\) avec \(a \neq b\) ainsi que des boucles, le graphe n'est pas simple et parler d'ensemble de couples de sommets pour les arêtes ne suffit plus.
Définition
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate fini.
On pose \(E_A \subset Q \times \Sigma \times Q\) défini par \((q,a,q') \in E_A \iff \delta(q,a) = q'\).
Le couple \(G_A = (Q, E_A)\) est le graphe, dont les arêtes sont étiquetées, associé à l'automate \(A\).
Un chemin de \(q\) à \(q'\) dans \(A\) est une suite de transitions \(q = q_0 \xrightarrow{a_1} q_1 \xrightarrow{a_2} \dots \xrightarrow{a_n} q_n = q'\) avec \((q_{k-1}, a_k, q_k) \in E_A\) pour tout \(k \in \range{1}{n}\). Le mot \(a_1 \dots a_n\) est appelé l'étiquette de ce chemin. Pour \(n = 0\), on obtient le chemin vide de \(q\) à \(q\), d'étiquette \(\epsilon\).
On note \(q \leadsto q'\) lorsqu'il existe un chemin de \(q\) à \(q'\).
Grâce à ce graphe, on peut utiliser des notions de chemins entre états :
Définition
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate fini et \(q \in Q\).
On dit que \(q\) est
- accessible lorsque \(q_i \leadsto q\).
- co-accessible lorsqu'il existe \(q_f\in F\) tel que \(q \leadsto q_f\).
Quand tous les états d'un automate sont accessibles et co-accessibles, on dit que l'automate est émondé.
Langage reconnu par un automate fini
Définition
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate fini.
On dit que \(m \in \Sigma^*\) est reconnu par \(A\) si c'est l'étiquette d'un chemin de \(q_i\) à un état final.
On appelle langage reconnu par l'automate l'ensemble des mots reconnus, on le note \(\mathop{lang}(A)\).
Exemple
On reprend l'exemple précédent d'automate. Pour qu'il reconnaisse un mot, on voit que celui-ci doit être soit de la forme \(a^nb\) soit de la forme \(b^na\) avec \(n > 0\).
On peut décrire précisément ce langage par l'expression régulière \(aa^*b | bb^*a\).
Théorème
Étant donné un automate fini, il est possible d'en déduire un automate complet et, si ce langage est non vide, un automate émondé ayant tous les trois le même langage reconnu.
Preuve
Complétion. On rajoute un état supplémentaire, communément appelé état puits, \(q_p \not\in Q\) et on pose \(A' = (Q \cup \{ q_p \}, \Sigma, \delta', q_i, F)\) avec, pour \(q \in Q\cup \{q_p\}\) et \(a \in \Sigma\), \(\delta'(q,a) = \delta(q,a)\) si la transition était définie et \(\delta'(q,a) = q_p\) sinon. En particulier, \(\delta'(q_p, a) = q_p\). L'automate \(A'\) est complet. Tout chemin de \(A\) est un chemin de \(A'\), donc \(\mathop{lang}(A) \subset \mathop{lang}(A')\). Réciproquement, un chemin de \(A'\) qui passe par \(q_p\) ne peut plus en sortir, et \(q_p \not\in F\) : un chemin de \(q_i\) à un état final dans \(A'\) ne passe donc pas par \(q_p\), c'est un chemin de \(A\).
Émondage. Tout état d'un chemin de \(q_i\) à un état final est accessible (on suit le début du chemin) et co-accessible (on suit sa fin). Si on supprime les états qui ne sont pas accessibles ou pas co-accessibles, ainsi que les transitions qui les concernent, on conserve donc tous les chemins de \(q_i\) à un état final, et le langage reconnu est inchangé. Si ce langage est non vide, il existe un tel chemin, donc \(q_i\) est conservé et on obtient bien un automate. L'automate obtenu est émondé : un état conservé a un chemin depuis \(q_i\) et un chemin vers un état final, et tous les états de ces chemins sont eux-mêmes accessibles et co-accessibles, donc conservés.
Fonction de transition étendue
Il est souvent utile de raisonner directement sur des mots pour effectuer plusieurs transitions d'affilée. On introduit alors la notion suivante :
Définition
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate fini déterministe, on définit sa fonction de transition étendue \(\delta^* : Q \times \Sigma^* \rightarrow Q\) par récurrence sur la longueur des mots ainsi :
Comme \(\delta\), l'application \(\delta^*\) est partielle : \(\delta^*(q,wa)\) n'est définie que si \(\delta^*(q,w)\) est définie et que \(\delta\) est définie en \((\delta^*(q,w), a)\).
Remarque
\(\delta^*(q,w)\) est défini si et seulement s'il existe un chemin d'étiquette \(w\) partant de \(q\), et c'est alors l'état d'arrivée de ce chemin, qui est unique car l'automate est déterministe. On a ainsi
Modélisation par des automates
On vient de voir que les automates finis permettent de caractériser certains langages, mais ils permettent également de modéliser des systèmes à plusieurs états.
Exemple
On considère un distributeur de boissons qui permet de distribuer des expressos ou des cafés longs. Un expresso coûte 1€ et un long coûte 2€. On considère qu'on peut mettre des pièces de 50c, 1€ ou 2€. On souhaite modéliser l'échange amenant à valider la quantité d'argent insérée. On suppose que la boisson qui sera distribuée est stockée ailleurs que dans un état, donc un état final signifiera uniquement que le bon montant a été inséré.
On ignore également toutes les pièces dépassant le montant dû, on pourrait ainsi rajouter des boucles sur les états avec ces valeurs. On les omet dans le dessin suivant pour être plus lisible :
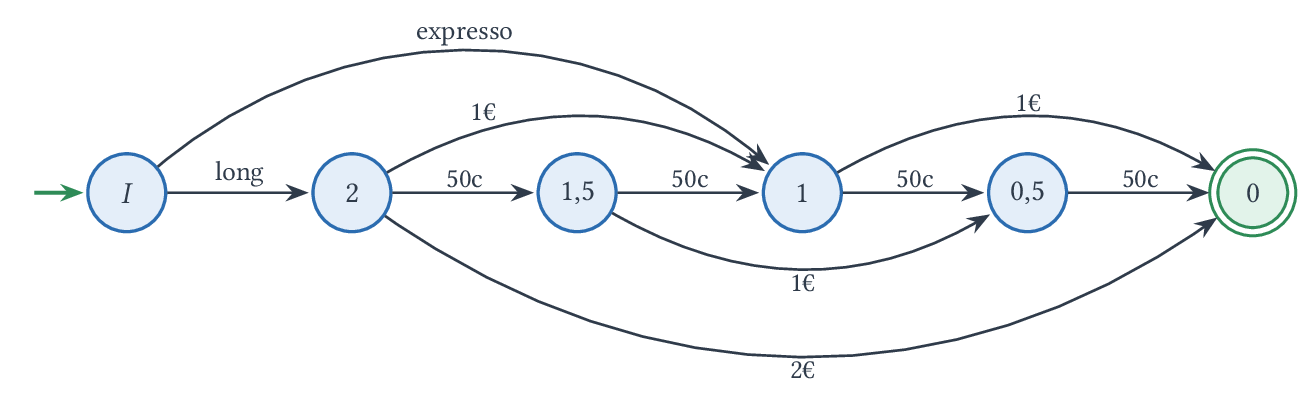
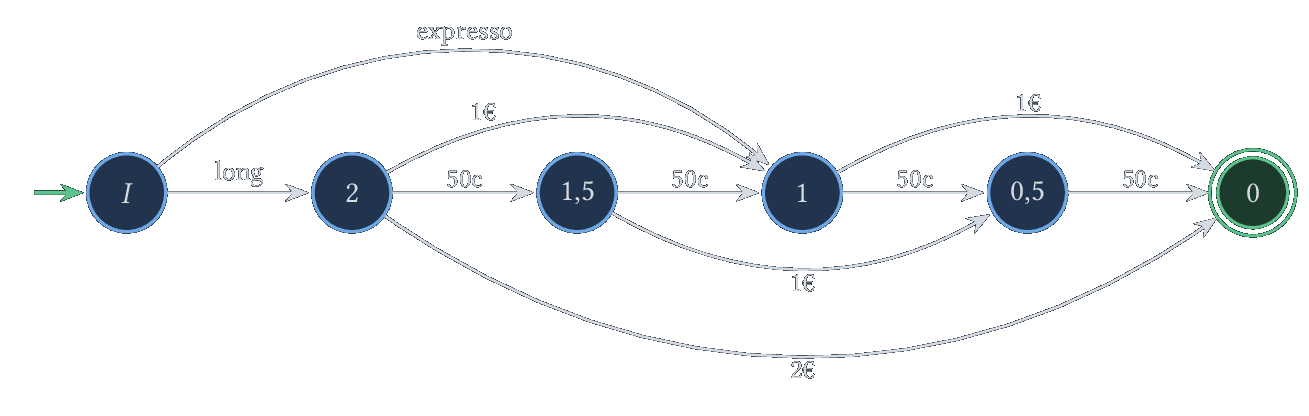
Les mots reconnus sont alors :
- long-2€
- long-1€-1€
- long-1€-50c-50c
- long-50c-1€-50c
- long-50c-50c-1€
- long-50c-50c-50c-50c
- expresso-1€
- expresso-50c-50c
Ce qui correspond exactement au comportement souhaité.
Remarque
On a parlé de mots, mais on parle en général de traces d'exécution qui permettent de s'assurer que le comportement est celui que l'on souhaite.
Automates non déterministes
On va modifier la définition afin de donner plus de souplesse et donc a priori plus de pouvoir expressif aux automates.
Définition
Un automate fini non déterministe est un quintuplet \(A = (Q, \Sigma, \delta, I, F)\) où
- \(\Sigma\) est un alphabet fini
- \(Q\) est un ensemble fini appelé l'ensemble des états de l'automate
- \(I \subset Q\) est appelé l'ensemble des états initiaux
- \(F \subset Q\) est appelé l'ensemble des états finaux
- \(\delta : Q \times \Sigma \rightarrow \mathcal{P}(Q)\) est appelée la fonction de transition de l'automate.
Remarque
Dans cette définition, les seuls changements par rapport aux automates déterministes sont la présence de plusieurs états initiaux et le fait qu'on ait des transitions vers \(0,1\) ou plus d'états.
Si \(\delta(q,a) = \emptyset\) c'est équivalent à ne pas avoir défini la transition dans l'application partielle d'un automate déterministe. La nouveauté est donc dans le fait de pouvoir avoir plusieurs états d'arrivée.
On représente naturellement ces automates en rajoutant des flèches étiquetées par \(a\) depuis un état \(q\) vers chaque état de \(\delta(q,a)\).
On définit de même la fonction de transition étendue d'un automate non-déterministe.
Définition
Soit \(A = (Q, \Sigma, \delta, I, F)\) un automate fini non déterministe, on définit sa fonction de transition étendue \(\delta^* : Q \times \Sigma^* \rightarrow \mathcal{P}(Q)\) par récurrence sur la longueur des mots ainsi :
Définition
Soit \(A = (Q, \Sigma, \delta, I, F)\) un automate fini non-déterministe, on appelle langage reconnu par \(A\) l'ensemble
Autrement dit, \(w\) est reconnu lorsqu'il existe au moins un chemin d'étiquette \(w\) d'un état initial à un état final.
Exemple
L'automate non-déterministe suivant reconnaît les mots dont l'avant-dernière lettre est un a.
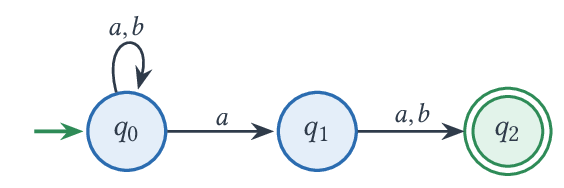
On voit qu'il y a un choix non-déterministe ici qui permet de deviner la fin d'un mot.
Théorème
Soit \(A\) un automate fini non-déterministe, il existe un automate fini déterministe \(A'\) reconnaissant le même langage que \(A\).
De plus, si \(A\) contient \(n\) états, alors \(A'\) contient au plus \(2^n\) états.
Preuve
On va, en fait, présenter une méthode permettant de déterminiser un automate fini. Cette construction est appelée l'automate des parties.
Si \(A = (Q, \Sigma, \delta, I, F)\) on pose \(A' = (\mathcal{P}(Q), \Sigma, \delta', I, F')\) où
et, pour \(p \subset Q\) et \(a \in \Sigma\),
On peut émonder l'automate pour diminuer son nombre d'états, mais on voit tout de suite qu'il en contient au plus \(2^{|Q|}\).
Pour conclure, on doit montrer que \(\mathop{lang}(A) = \mathop{lang}(A')\). Pour cela, on va montrer le résultat suivant par récurrence sur \(|w|\) :
- Initialisation : \(\bigcup_{q_i \in I} \delta^*(q_i,\epsilon) = \bigcup_{q_i \in I} \{ q_i \} = I = \delta'^*(I,\epsilon)\)
-
Hérédité : si la propriété est vraie pour des mots de longueur \(n\), soit \(wa \in \Sigma^*\) où \(a \in \Sigma\) avec \(|w|=n\).
On a
\[ \begin{array}{rcl} \bigcup_{q_i \in I} \delta^*(q_i,wa) & = &\bigcup_{q_i \in I} \bigcup_{q \in \delta^*(q_i,w)} \delta(q,a) \\ & = &\bigcup_{q \in \bigcup_{q_i \in I} \delta^*(q_i,w)} \delta(q,a) \\ & = &\bigcup_{q \in \delta'^*(I,w)} \delta(q,a) \\ & = & \delta'(\delta'^*(I,w),a) \\ & = & \delta'^*(I,wa) \end{array} \]
Ainsi, on a l'égalité voulue et donc
Exemple
Pour réaliser ce procédé de déterminisation en pratique, on établit une table de transition en partant de \(I\) et en rajoutant une ligne pour chaque nouvel état rencontré. Ce faisant, on obtient un automate partiellement émondé.
Si on reprend l'exemple précédent, on va définir la table suivante :
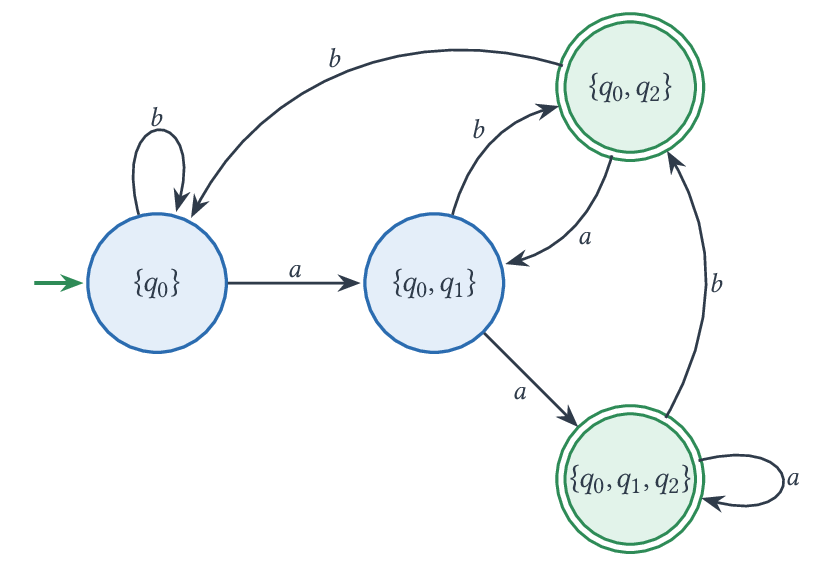
On remarque avec cette construction qu'on a deux états acceptants qui correspondent aux suffixes \(aa\) et \(ab\). Plus généralement, l'état atteint ne dépend que des deux dernières lettres lues.
Réciproquement, un automate déterministe \((Q, \Sigma, \delta, q_i, F)\) peut être vu comme l'automate non-déterministe \((Q, \Sigma, \delta', \{q_i\}, F)\) en posant \(\delta'(q,a) = \{ \delta(q,a) \}\) quand \(\delta(q,a)\) est défini et \(\delta'(q,a) = \emptyset\) sinon. On a alors le corollaire :
Corollaire
Les langages reconnus par des automates déterministes sont exactement les langages reconnus par des automates non-déterministes.
Transitions spontanées
On peut également étendre les automates non-déterministes en rajoutant des transitions spontanées, également appelées \(\epsilon\)-transitions, entre les états en considérant une fonction de transition prenant également le mot vide en entrée. Comme on va le voir, cela permet de n'avoir qu'un seul état initial.
Définition
Un automate fini non-déterministe à transitions spontanées est un quintuplet \(A = (Q, \Sigma, \delta, q_i, F)\) où
- \(\Sigma\) est un alphabet fini
- \(Q\) est un ensemble fini appelé l'ensemble des états de l'automate
- \(q_i \in Q\) est appelé l'état initial
- \(F \subset Q\) est appelé l'ensemble des états finaux
- \(\delta : Q \times (\Sigma \cup \{ \epsilon \}) \rightarrow \mathcal{P}(Q)\) est appelée la fonction de transition.
Exemple
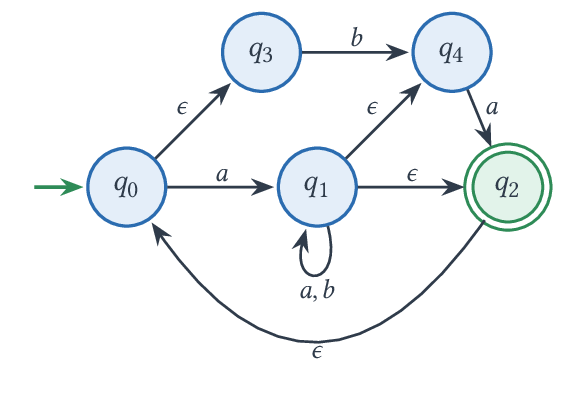
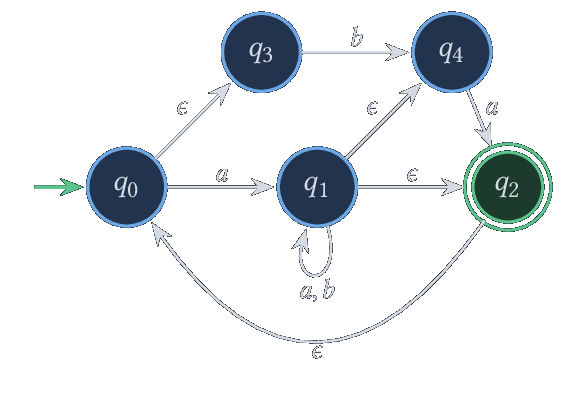
L'automate suivant, d'état initial \(q_0\) et d'état final \(q_2\), présente des transitions spontanées indiquées par \(\epsilon\) :
Définition
Soit \(A\) un automate fini non-déterministe possédant des transitions spontanées et \(q \in Q\). On définit l'ensemble \(\overline{q}\), appelé clôture de \(q\), comme le plus petit ensemble tel que \(q \in \overline{q}\) et
Si \(E \subset Q\), on pose \(\overline{E} = \bigcup_{q \in E} \overline{q}\).
Remarque
\(\overline{q}\) est donc l'ensemble des états accessibles dans le sous-graphe des états obtenus en ne conservant que les transitions spontanées.
Cette complétion est nécessaire pour comprendre l'action de l'automate sur les états dans la mesure où \(q' \in \delta(q,a)\) signifie qu'on peut également accéder aux états accessibles depuis \(q'\) par transition spontanée.
On remarque qu'on a \(\overline{E \cup E'} = \overline{E} \cup \overline{E'}\) et \(\overline{\overline{E}} = \overline{E}\).
Exemple
Dans l'automate précédent, on a \(\overline{q_0} = \{q_0,q_3\}\), \(\overline{q_2} = \{q_0, q_2, q_3\}\) et \(\overline{q_1} = \{q_0,q_1,q_2,q_3,q_4\}\).
On peut alors définir la fonction de transition étendue d'un tel automate ainsi :
et on définit alors le langage reconnu par un tel automate ainsi :
Théorème
Soit \(A\) un automate fini non-déterministe possédant des transitions spontanées. Il existe un automate non-déterministe \(A'\) tel que \(\mathop{lang}(A) = \mathop{lang}(A')\).
Preuve
On pose \(A' = (Q, \Sigma, \delta', \overline{q_i}, F)\) où
On va montrer par récurrence sur \(|w|\) que
- Initialisation \(\delta^*(q_i,\epsilon) = \overline{q_i} = \bigcup_{q \in \overline{q_i}} \{q \} = \bigcup_{q \in \overline{q_i}} \delta'^*(q, \epsilon)\)
-
Hérédité supposons la propriété vraie pour les mots de longueur \(n\) et soit \(wa \in \Sigma^*\) où \(|w|=n\) et \(a \in \Sigma\). On a, en utilisant \(\overline{E \cup E'} = \overline{E} \cup \overline{E'}\) puis l'hypothèse de récurrence :
\[\begin{array}{rcl} \delta^*(q_i, wa) & = & \overline{\bigcup_{q' \in \delta^*(q_i,w)} \delta(q',a)} \\ & = & \bigcup_{q' \in \delta^*(q_i,w)} \overline{\delta(q',a)} \\ & = & \bigcup_{q' \in \bigcup_{q \in \overline{q_i}} \delta'^*(q,w)} \delta'(q',a) \\ & = & \bigcup_{q \in \overline{q_i}} \bigcup_{q' \in \delta'^*(q,w)} \delta'(q',a) \\ & = & \bigcup_{q \in \overline{q_i}} \delta'^*(q, wa) \end{array}\]
On peut alors conclure sur les langages reconnus :
Exemple
On va éliminer les transitions spontanées de l'automate précédemment donné en exemple. Pour cela, on peut commencer par établir une table complétée :
Les états initiaux sont ceux de \(\overline{q_0} = \{q_0,q_3\}\) et l'unique état final reste \(q_2\).
On a donc l'automate non-déterministe équivalent suivant :
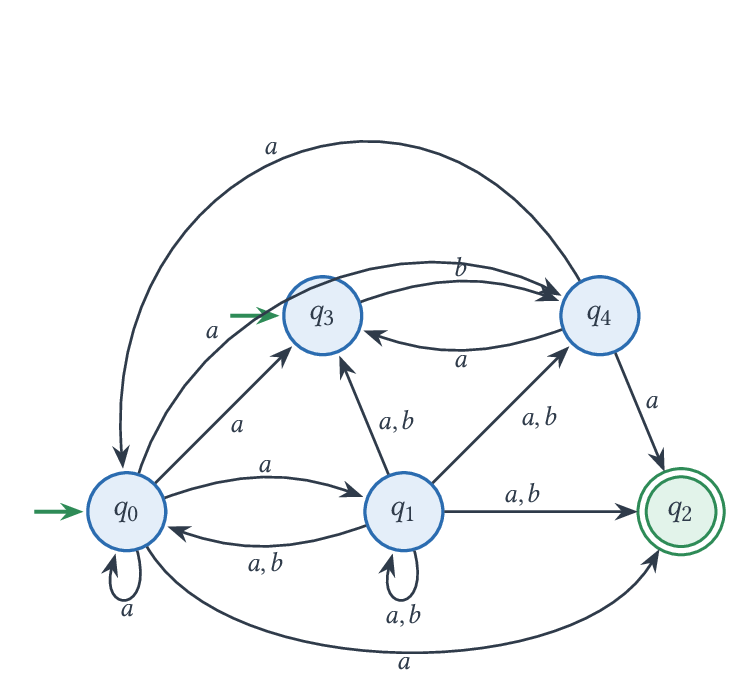
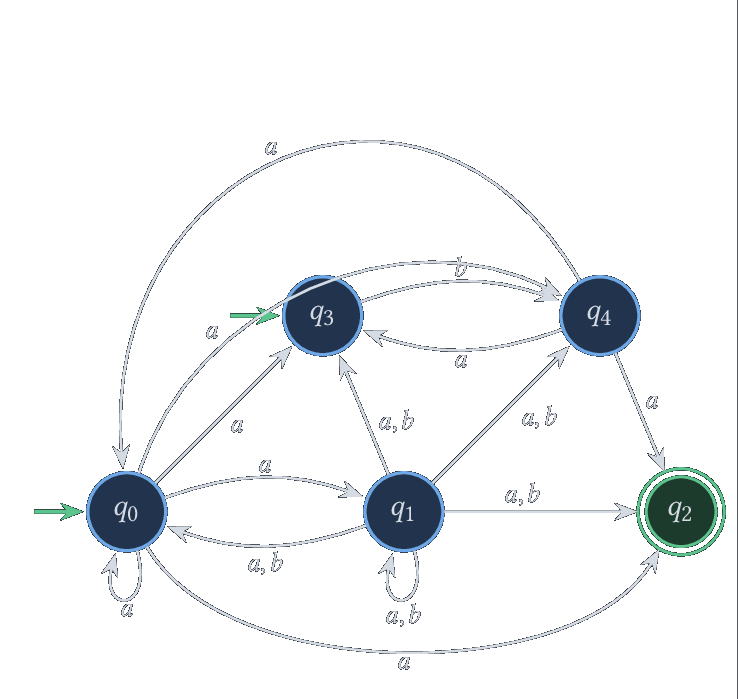
On remarque donc que cette élimination des transitions spontanées ne change pas les sommets mais uniquement les arêtes du graphe associé à l'automate en en rajoutant par complétion.
Remarque
Pour passer d'un automate non déterministe à un automate non déterministe à transitions spontanées, il suffit de rajouter un nouvel état initial et des transitions spontanées vers les anciens états initiaux.
On a donc également le corollaire suivant en composant les théorèmes précédents.
Corollaire
Les langages reconnus par un automate fini non-déterministe possédant des transitions spontanées sont exactement les langages reconnus par un automate fini déterministe.
Exemple
En fait, il est possible de déterminiser directement un automate avec transitions spontanées.
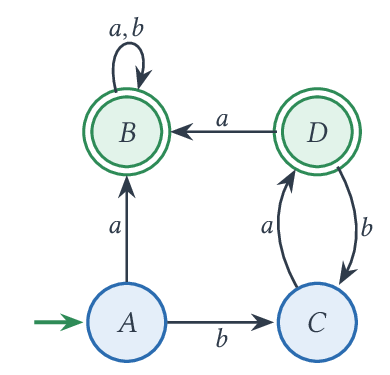
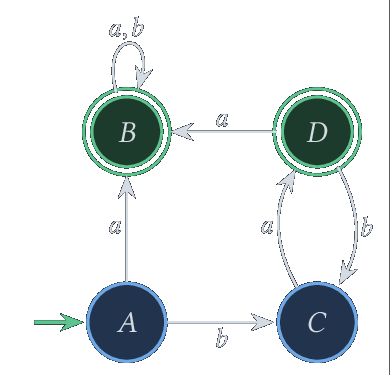
On va déterminiser l'automate présenté au dessus en utilisant là aussi la méthode de la table de transition construite à la volée. Il faut juste bien faire attention à prendre la clôture des états obtenus, en partant de \(\overline{q_0}\). Afin de simplifier la représentation, on a attribué une lettre aux états.
Cet automate peut se représenter graphiquement ainsi :
Théorème de Kleene
Dans cette partie, on va démontrer le théorème de Kleene :
Théorème
(Kleene) Les langages réguliers sont exactement les langages reconnaissables par un automate fini déterministe.
La preuve de ce théorème est suffisamment complexe pour qu'on la sépare en deux résultats. On va montrer ici comment passer d'une expression régulière à un automate, et réciproquement. Dans les deux sens, on dispose de constructions inefficaces, faciles à comprendre, et d'algorithmes efficaces mais plus délicats.
Des expressions régulières aux automates non-déterministes avec transitions spontanées
On commence ici par montrer une construction très simple d'un automate non-déterministe à transitions spontanées associé à une expression régulière par induction sur l'expression.
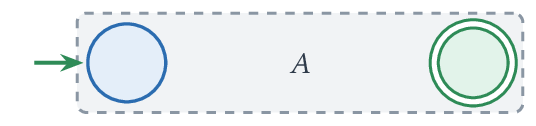
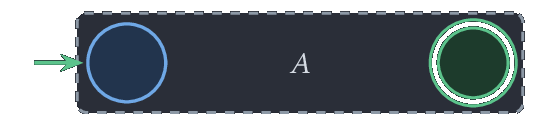
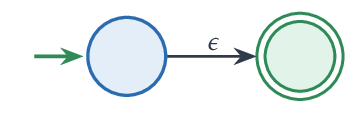
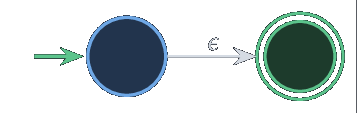
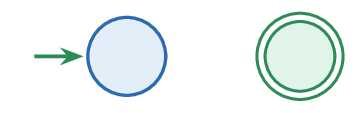
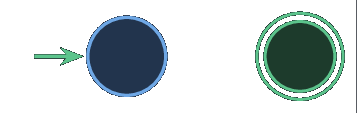
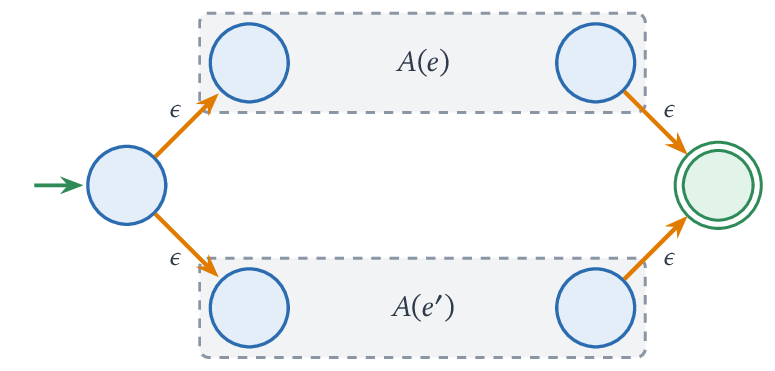
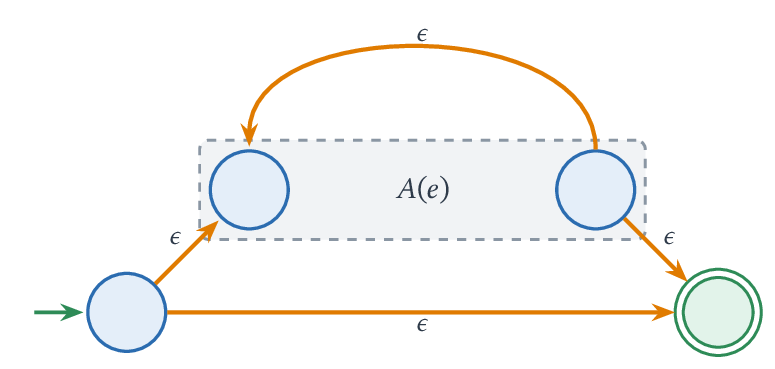
On note \(A(e)\) l'automate de Thompson associé à l'expression \(e\), il va s'agir dans tous les cas d'un automate à un état initial et un état final. Un tel automate aura donc la forme suivante :
- \(A(\epsilon) =\)
- \(A(\emptyset) =\)
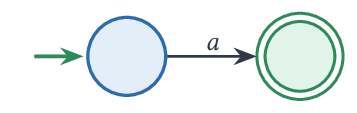
- \(\forall a \in \Sigma, A(a) =\)
- \(A(ee') =\)
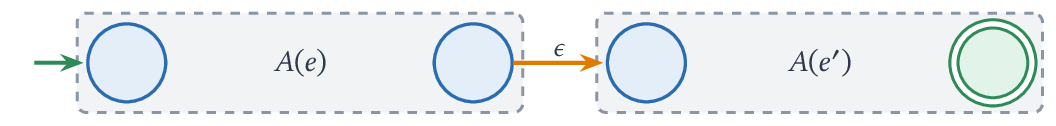
- \(A(e|e') =\)
- \(A(e^*)=\)
On peut alors passer à un automate déterministe avec la méthode de l'automate des parties.
Exemple
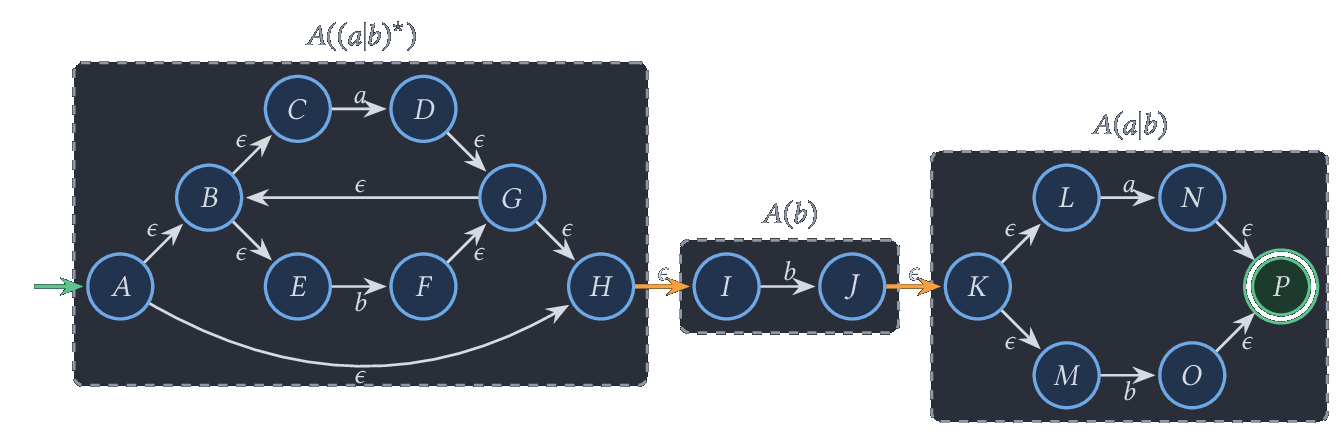
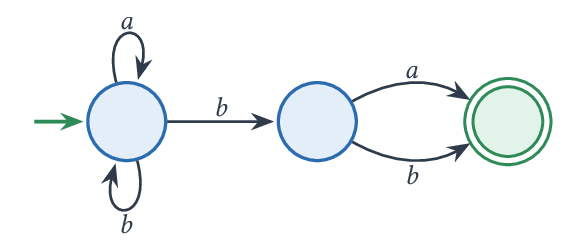
On considère l'expression régulière \((a|b)^*b(a|b)\).
L'automate de Thompson associé est donc :
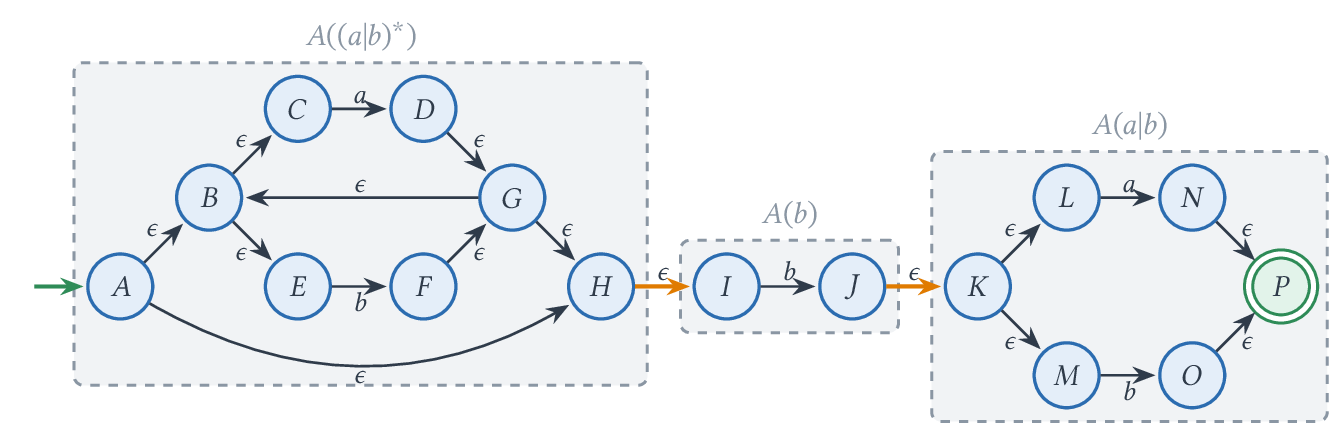
Si on retire les transitions spontanées, on obtient l'automate :
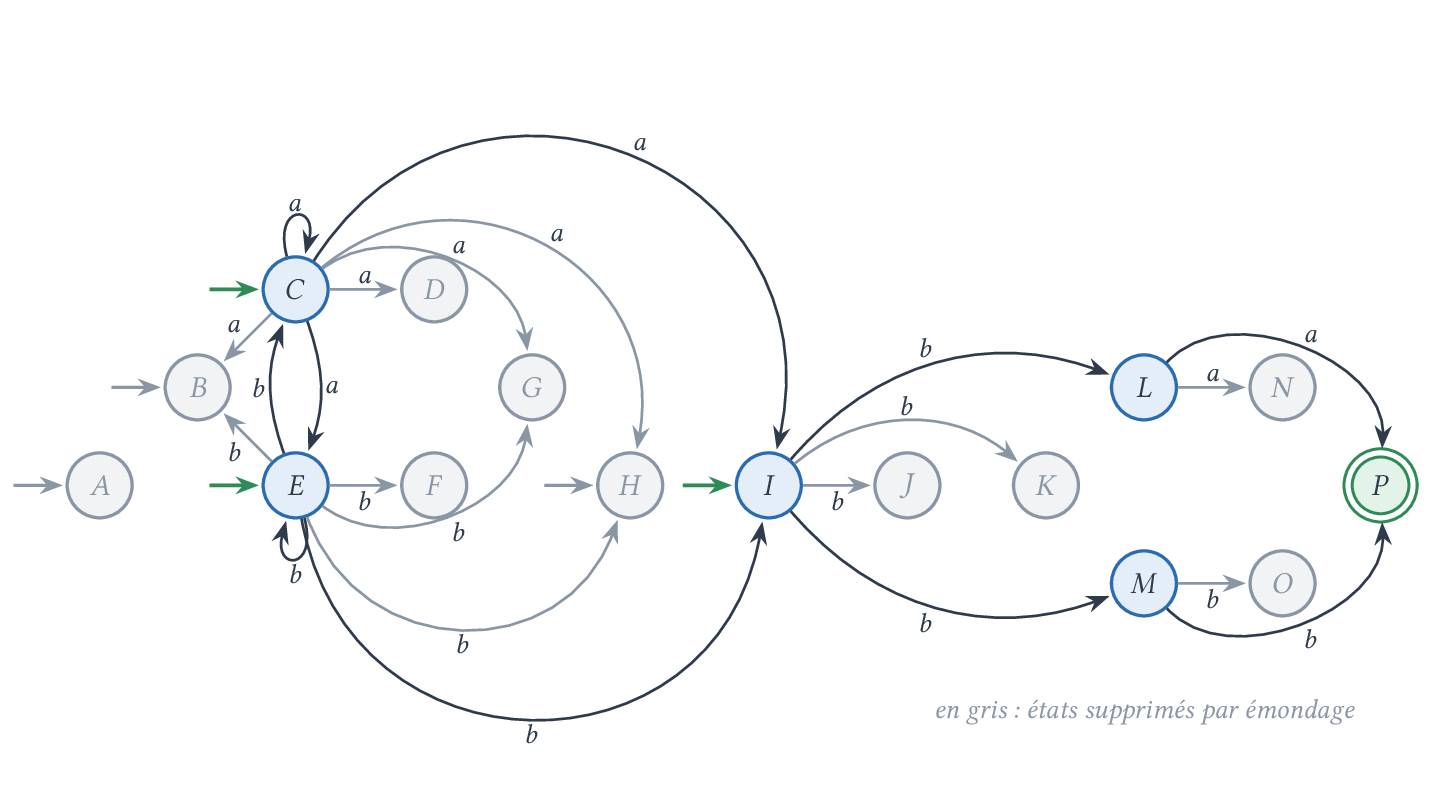
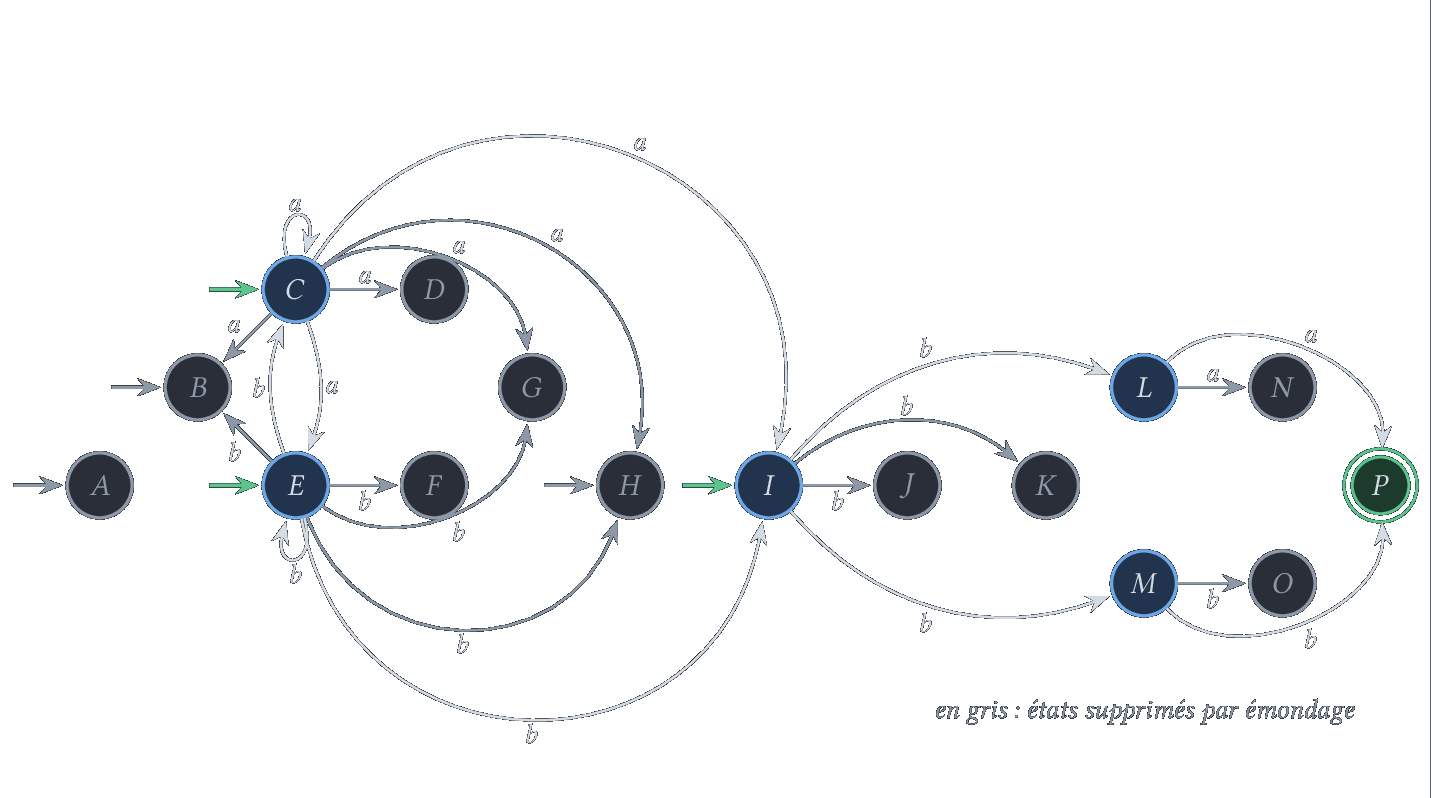
qui en émondant les états qui ne sont pas accessibles ou pas co-accessibles devient :
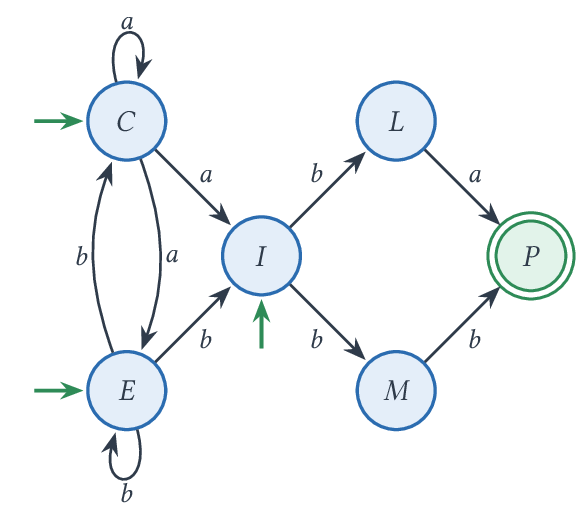
Notons qu'il est possible d'obtenir directement un automate comportant moins
d'états :
On a alors le résultat suivant :
Théorème
Pour toute expression régulière \(e\), on a \(\mathop{lang}(e) =\mathop{lang}(A(e))\).
Preuve
Dans chaque construction, les états ajoutés sont nouveaux, et \(\mathop{lang}(A(e))\) est l'ensemble des étiquettes des chemins de l'état initial \(i\) à l'état final \(f\) de \(A(e)\), les transitions spontanées n'ajoutant rien à l'étiquette. On procède par induction sur \(e\).
- Pour \(\epsilon\), \(\emptyset\) et \(a \in \Sigma\), les seuls chemins de \(i\) à \(f\) sont respectivement d'étiquette \(\epsilon\), inexistants, et d'étiquette \(a\).
- Pour \(ee'\) : il n'y a aucune transition de \(A(e')\) vers \(A(e)\), donc un chemin de l'état initial à l'état final emprunte exactement une fois la transition spontanée qui relie l'état final de \(A(e)\) à l'état initial de \(A(e')\). Il se décompose en un chemin réussi de \(A(e)\) suivi d'un chemin réussi de \(A(e')\), et réciproquement toute telle concaténation est un chemin réussi. Par hypothèse d'induction, le langage reconnu est donc \(\mathop{lang}(e)\mathop{lang}(e')\).
- Pour \(e|e'\) : un chemin réussi commence par une transition spontanée vers l'état initial de \(A(e)\) ou de \(A(e')\), et comme il n'y a aucune transition entre \(A(e)\) et \(A(e')\), il reste dans cet automate jusqu'à son état final, puis rejoint le nouvel état final. Le langage reconnu est donc \(\mathop{lang}(e) \cup \mathop{lang}(e')\).
- Pour \(e^*\) : un chemin réussi est soit la transition spontanée directe entre les deux nouveaux états (étiquette \(\epsilon\)), soit entre dans \(A(e)\) par son état initial et en ressort par son état final. En le coupant à chaque utilisation de la transition spontanée de retour (de l'état final de \(A(e)\) vers son état initial), on obtient \(k \ge 1\) chemins réussis de \(A(e)\). Réciproquement, de tels chemins se recollent grâce à cette transition de retour. Le langage reconnu est donc \(\{\epsilon\} \cup \bigcup_{k \ge 1} \mathop{lang}(e)^k = \mathop{lang}(e)^*\).
Avec l'élimination des transitions spontanées puis la déterminisation par l'automate des parties, on en déduit que tout langage régulier est reconnu par un automate fini déterministe. C'est le premier sens du théorème de Kleene ; le second sens est l'objet du théorème suivant.
Calcul d'une expression régulière depuis un automate - McNaughton et Yamada
Théorème
Soit \(A\) un automate fini déterministe, il existe une expression régulière \(e\) telle que \(\mathop{lang}(A) = \mathop{lang}(e)\).
Remarque
On va s'inspirer de Floyd-Warshall pour définir de manière incrémentale des expressions régulières.
Preuve
On pose \(A = (\range{1}{n}, \Sigma, \delta, 1, F)\) en numérotant les états de \(A\) et en supposant que l'état initial a le numéro 1. On va construire une suite de matrices d'expressions régulières \((R^{(k)})_{k \in \range{0}{n}}\) telle que \(\forall i, j \in \range{1}{n}, R^{(k)}_{i,j}\) soit une expression régulière dénotant exactement l'ensemble des étiquettes des chemins de l'état \(i\) à l'état \(j\) dont les états intermédiaires sont \(\le k\). Les états intermédiaires d'un chemin \(q_0 \rightarrow q_1 \rightarrow \dots \rightarrow q_m\) sont \(q_1, \dots, q_{m-1}\) : on exclut le départ et l'arrivée.
On va construire les \(R^{(k)}\) par récurrence.
Initialisation : pour \(k = 0\), il s'agit des transitions de l'automate. On va noter ici \(\alpha(i,j) = \enscomp{ a \in \Sigma }{ \delta(i,a) = j }\). On pose donc, pour \(i \neq j\),
Quand \(i = j\), il faut également considérer le chemin vide de \(i\) vers \(i\) qui est d'étiquette \(\epsilon\), on a donc :
Hérédité : supposons qu'on ait construit les \(R^{(l)}\) pour \(0 \le l < k\). Un chemin de \(i\) à \(j\) dont les états intermédiaires sont \(\le k\) est de deux sortes :
- Soit \(k\) n'est pas un de ses états intermédiaires : ils sont donc tous \(< k\), et son étiquette est dans le langage dénoté par \(R^{(k-1)}_{ij}\).
-
Soit \(k\) apparaît au moins une fois comme état intermédiaire. En le découpant à chaque passage par \(k\), il a donc la forme :
\[ i \xrightarrow{\phi} k \xrightarrow{\psi_1} k \rightarrow \dots \rightarrow k \xrightarrow{\psi_p} k \xrightarrow{\tau} j \]avec \(p \in \N\) qui correspond au nombre de fois où on revient sur l'état \(k\) dans le chemin, et où les morceaux \(\phi, \psi_1, \dots, \psi_p, \tau\) n'ont que des états intermédiaires \(< k\). L'étiquette de \(\phi\) est donc dans le langage dénoté par \(R^{(k-1)}_{ik}\), celles des \(\psi_l\) dans celui de \(R^{(k-1)}_{kk}\) et celle de \(\tau\) dans celui de \(R^{(k-1)}_{kj}\). Ainsi, le chemin global a une étiquette dans le langage dénoté par
\[ R^{(k-1)}_{ik} \left(R^{(k-1)}_{kk}\right)^* R^{(k-1)}_{kj} \]
Ainsi, on pose
On vient de voir que toute étiquette d'un chemin de \(i\) à \(j\) d'états intermédiaires \(\le k\) est dans le langage dénoté par \(R^{(k)}_{ij}\). Réciproquement, un mot de ce langage est soit l'étiquette d'un chemin d'états intermédiaires \(< k\), soit l'étiquette d'un chemin obtenu en recollant en \(k\) des chemins d'états intermédiaires \(< k\), dont les états intermédiaires sont donc bien \(\le k\). Ces raisonnements restent valables quand \(i = k\) ou \(j = k\), car \(R^{(k-1)}_{kk}\) contient le chemin vide.
On déduit de cette construction la matrice \(R^{(n)}\) et on peut donc poser
où \(F = \{ f_1, \dots, f_p \}\), avec \(e = \emptyset\) si \(F = \emptyset\). Comme \(R^{(n)}_{1f}\) dénote les étiquettes de tous les chemins de \(1\) à \(f\) (il n'y a pas de contrainte sur les états intermédiaires quand \(k = n\)), \(e\) dénote exactement \(\mathop{lang}(A)\).
Exemple
On considère l'automate :
En numérotant dans l'ordre alphabétique \(1 = A, 2 = B, 3 = C\) et \(4 = D\), on a, en simplifiant au fur et à mesure (en utilisant par exemple \(e\emptyset = \emptyset e = \emptyset\), \(e | \emptyset = e\) et \((\epsilon|e)^* = e^*\)), les matrices suivantes. Comme aucune transition n'arrive sur l'état \(1\), on a \(R^{(1)} = R^{(0)}\).
On en déduit donc l'expression régulière associée à l'automate de départ :
On peut voir dans l'exemple précédent que la détermination de cette expression régulière est laborieuse : chaque coefficient de \(R^{(k)}\) fait intervenir quatre coefficients de \(R^{(k-1)}\). Sans simplification, les expressions de la matrice finale peuvent donc être de taille \(O(4^n)\). On va voir une autre méthode permettant de déterminer de manière plus efficace des expressions régulières.
Élimination des états - Brzozowski et McCluskey
On présente ici le principe de l'élimination des états. Il s'agit de construire un automate dont les transitions ne sont plus étiquetées par des lettres mais par des expressions régulières : un mot est alors reconnu s'il s'écrit \(w_1 \dots w_n\) où chaque \(w_k\) est dans le langage dénoté par l'étiquette de la \(k\)-ième transition d'un chemin d'un état initial à un état final. Cette souplesse permet de supprimer des états en gardant le même langage reconnu. On procède donc, étant donné un état final \(q\), par élimination jusqu'à obtenir un automate dont les états sont \(\{ q_i, q\}\) où \(q_i\) est l'état initial. On en déduit simplement une expression régulière équivalente. On conclut alors en faisant cela pour chaque état final et en prenant l'union des expressions régulières.
Exemple
On reprend l'automate précédent :
On commence par retirer les états qui ne sont ni initiaux ni finaux, ce qui permet de repartir de l'automate obtenu pour tous les états finaux. Ici, seul l'état \(C\) est dans ce cas.
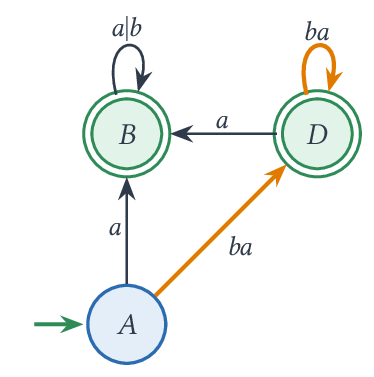
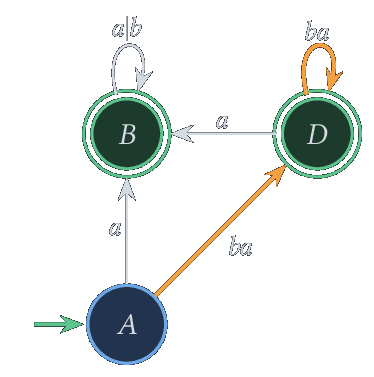
En considérant l'état final \(D\), comme aucun chemin de \(A\) à \(D\) ne passe par l'état \(B\), on peut l'éliminer directement pour obtenir l'automate à deux états suivant :
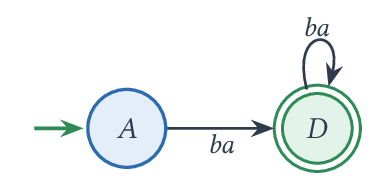
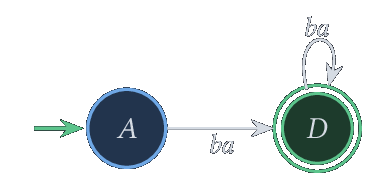
On en déduit directement l'expression régulière \(ba(ba)^*\).
Maintenant, on va considérer l'état final \(B\) et on souhaite éliminer \(D\). On doit prendre en compte le chemin qui va de \(A\) à \(B\) en passant par \(D\), sachant qu'il y a une boucle potentielle sur \(D\) qu'on peut prendre un nombre quelconque de fois. On obtient alors l'automate :
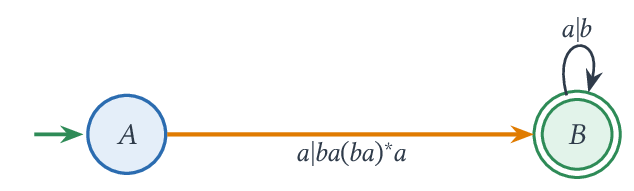
Qui admet \((a |ba (ba)^* a)(a|b)^* = (ba)^* a (a|b)^*\) comme expression régulière.
Au final, on obtient l'expression régulière :
On retrouve donc l'expression régulière obtenue avec la méthode précédente.
Remarque
Quitte à rajouter des transitions spontanées, on peut se ramener à n'avoir qu'un unique état final et donc à ne faire qu'une seule suite d'élimination.
L'automate précédent avec ce nouvel état devient :
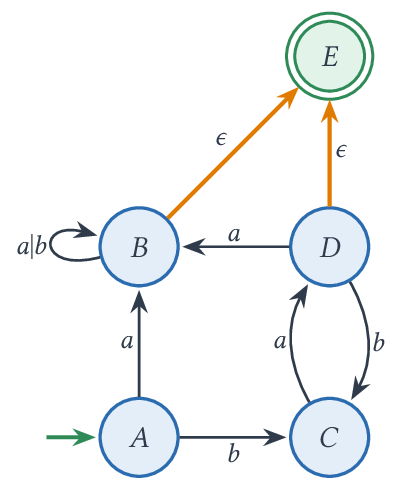
On note que \(\epsilon\) ici désigne une expression régulière, on n'a donc pas à sortir du cadre précédent.
On peut alors éliminer les sommets \(B, C\) et \(D\). On commence par éliminer \(C\) :
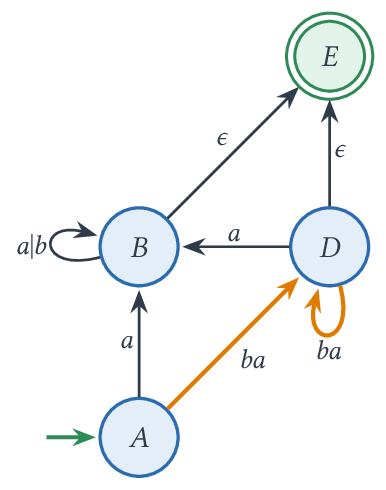
On élimine alors \(D\) :
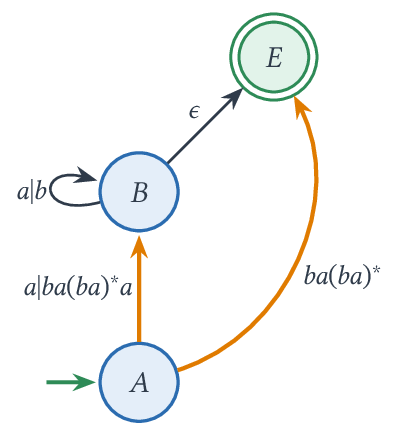
Puis en éliminant \(B\) :
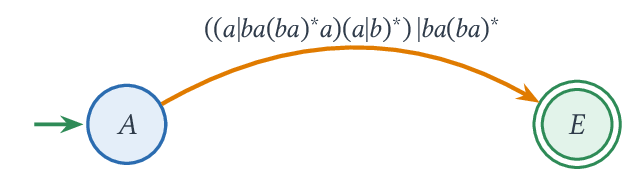
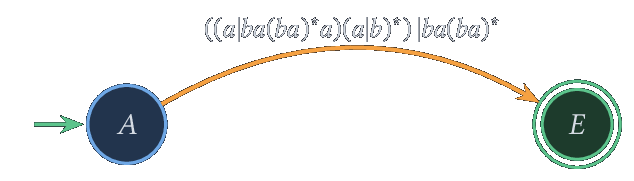
On retrouve ainsi l'expression régulière précédente après simplification.
On remarque que cette méthode n'est pas forcément plus pratique à la main sur des petits automates et qu'on risque de faire apparaître de longues expressions régulières et de faire des erreurs de calcul.
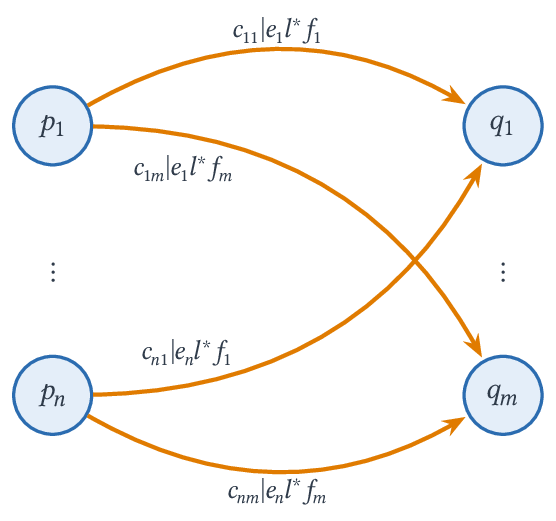
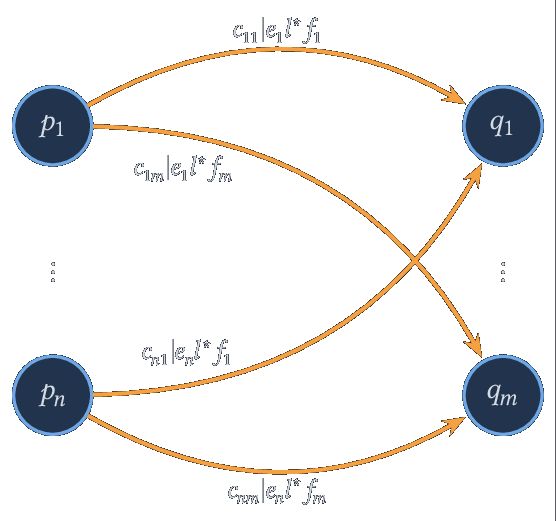
On va formaliser l'élimination. Si un état \(s\) a des prédécesseurs \(p_1, \dots, p_n\) et des successeurs \(q_1, \dots, q_m\), certains pouvant être à la fois successeurs et prédécesseurs, on a la situation locale en \(s\) suivante :
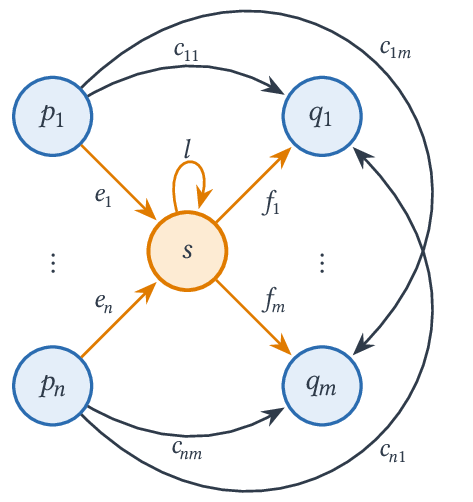
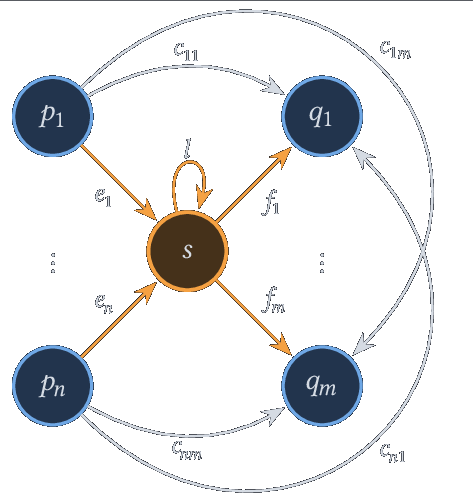
Pour passer de \(p_i\) à \(q_j\) on a donc soit l'expression déjà présente \(c_{ij}\), soit on effectue un chemin en passant par \(s\) donc de la forme
ce qui correspond à l'expression régulière \(e_i l^* f_j\). On peut donc en déduire l'automate suivant avec \(s\) éliminé, qui reconnaît le même langage car tout chemin passant par \(s\) est remplacé par une transition dont l'étiquette dénote exactement les étiquettes de ces passages. Si \(p_i = q_j\), la transition obtenue est une boucle sur \(p_i\).
Après élimination de tous les états sauf l'état initial et un état final, on obtient un automate de la forme :
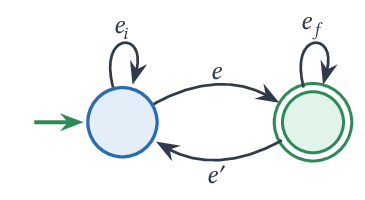
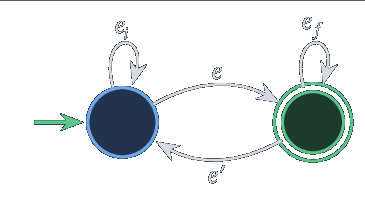
On lui associe alors l'expression régulière
En effet, un chemin de l'état initial à l'état final se découpe selon ses retours sur l'état initial : il est formé d'une suite de boucles sur l'état initial, chacune étant soit la transition \(e_i\), soit un aller-retour \(e e_f^* e'\) par l'état final, puis d'un dernier aller \(e e_f^*\). Une transition absente est étiquetée par \(\emptyset\). Si l'état final considéré est l'état initial lui-même, on élimine tous les autres états et on obtient un unique état portant une boucle \(e_i\), d'expression \(e_i^*\).
Construction de l'automate de Glushkov, algorithme de Berry-Sethi
On présente ici une construction directe d'un automate non déterministe reconnaissant le même langage qu'une expression régulière donnée. La construction qu'on présente ici s'effectue en plusieurs temps :
- définition et reconnaissance des langages locaux par les automates déterministes locaux
- définition d'une expression régulière linéaire et localité de son langage dénoté
- obtention d'un automate non déterministe par linéarisation d'une expression régulière puis oubli du marquage de lettres
Langages locaux
Définition
Soit \(\Sigma\) un alphabet fini et \(L \subset \Sigma^*\) un langage.
On dit que \(L\) est local lorsqu'il existe \(P, S \subset \Sigma\) et \(N \subset \Sigma^2\) tels que les mots non vides de \(L\) sont exactement les mots qui
- commencent par une lettre de \(P\)
- finissent par une lettre de \(S\)
- ne contiennent aucun facteur dans \(N\)
Autrement dit, \(L\) vérifie l'égalité :
Remarque
Pour savoir si un mot est dans un langage local, il suffit donc d'avancer avec une fenêtre de lecture de deux caractères, c'est en ce sens qu'il est local.
Si on sait qu'un langage est local, il est facile de déterminer des ensembles \(P, S\) et \(N\) convenables.
Théorème
Soit \(L\) un langage. On pose
Alors \(L\) est local si et seulement si \(L \backslash \{ \epsilon \} = (P(L) \Sigma^* \cap \Sigma^* S(L)) \backslash \Sigma^* N(L) \Sigma^*\).
Preuve
Notons \(L' = (P(L) \Sigma^* \cap \Sigma^* S(L)) \backslash \Sigma^* N(L) \Sigma^*\). Par définition de ces trois ensembles, on a toujours \(L \backslash \{ \epsilon \} \subset L'\).
Le sens réciproque de l'équivalence est immédiat. Supposons \(L\) local pour des ensembles \(P, S, N\). Tout mot non vide de \(L\) commence par une lettre de \(P\), donc \(P(L) \subset P\). De même \(S(L) \subset S\). Enfin, si \(ab \in N\), \(ab\) n'est facteur d'aucun mot de \(L\), donc \(N \subset N(L)\). Ainsi \(L' \subset (P \Sigma^* \cap \Sigma^* S) \backslash \Sigma^* N \Sigma^* = L \backslash \{ \epsilon \}\), d'où l'égalité.
Exemple
- \(\Sigma^*\) est local avec \(P = S =\Sigma\) et \(N = \emptyset\).
- \(L = a(aa)^*b\) n'est pas local car on aurait alors, d'après le théorème précédent, \(P = \{ a\}\), \(S= \{b\}\) et \(N = \{b a, bb \}\). Or, \((P \Sigma^* \cap \Sigma^* S) \backslash \Sigma^* N \Sigma^*\) contient les mots de la forme \(a^n b\) avec \(n \in \N^*\) et donc contient \(aab\) qui n'est pas dans \(L\), car les mots de \(L\) contiennent un nombre impair de \(a\).
Automates locaux
Définition
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate fini déterministe.
On dit que \(A\) est
- local lorsque \(\forall a \in \Sigma, \left| \enscomp{\delta(q,a)}{q \in Q, \delta(q,a) \text{ défini}} \right| \le 1\)
- standard lorsque \(\forall a \in \Sigma, \forall q \in Q,\delta(q,a) \neq q_i\).
Remarque
Ainsi, un automate est local si toutes les transitions étiquetées par une même lettre arrivent sur le même état, et standard quand on ne peut pas revenir sur l'état initial.
Théorème
Soit \(L\) un langage, les propriétés suivantes sont équivalentes :
- \(L\) est local
- \(L\) est reconnaissable par un automate déterministe local
- \(L\) est reconnaissable par un automate déterministe local et standard
Preuve
On a directement \(3 \Rightarrow 2\). On va montrer deux autres implications pour avoir l'équivalence.
\(\underline{1 \Rightarrow 3}\) Soit \(L\) un langage local et \(S,P, N\) tels que
On définit \(A = (\Sigma \cup \{ \epsilon \}, \Sigma, \delta, \epsilon, S')\) où \(S' =\begin{cases} S & \text{si } \epsilon \not\in L \\ S \cup \{\epsilon\}& \text{sinon} \end{cases}\), \(\forall a \in P, \delta(\epsilon, a) = a\) et \(\forall a, b \in \Sigma, ab \not\in N \Rightarrow \delta(a,b) = b\). Cet automate est déterministe local et standard par définition.
On va montrer que \(\mathop{lang}(A) = L\).
-
\(\mathop{lang}(A) \subset L\). Soit \(w\) reconnu par \(A\). Si \(w = \epsilon\), c'est forcément que \(\epsilon\) est final donc que \(\epsilon \in L\). Sinon \(w = a_1\dots a_n\). On a donc un chemin \(\epsilon \xrightarrow{a_1} a_1 \dots \xrightarrow{a_n} a_n\) or :
- la transition depuis \(\epsilon\) implique \(a_1 \in P\) ;
- \(a_n\) est final, donc nécessairement \(a_n \in S\) ;
- pour \(i \in \range{1}{n-1}\), \(a_i \xrightarrow{a_{i+1}} a_{i+1}\) implique que \(a_i a_{i+1} \not\in N\).
Ainsi, par définition \(w \in L\).
-
\(L \subset \mathop{lang}(A)\). Réciproquement, soit \(w \in L\). Soit \(w = \epsilon\) et alors \(\epsilon\) est initial et final, donc \(\epsilon \in \mathop{lang}(A)\), soit \(w = a_1 \dots a_n\) et, comme \(a_1 \in P\), on a la transition \(\epsilon \xrightarrow{a_1} a_1\). Ensuite, pour chaque \(i \in \range{1}{n-1}\), comme \(a_i a_{i+1} \not\in N\), on a \(a_i \xrightarrow{a_{i+1}} a_{i+1}\). Ainsi, on a donc un chemin de \(\epsilon\) à \(a_n\), or \(a_n \in S\) donc il est final et \(w\) est reconnu.
\(\underline{2 \Rightarrow 1}\). On va définir des ensembles \(P, S, N\) associés à l'automate local \(A = (Q, \Sigma, \delta, q_i, F)\) :
On pose alors \(L' = (P\Sigma^* \cap \Sigma^* S) \backslash \Sigma^* N \Sigma^*\), qui ne contient pas \(\epsilon\), et on va montrer que \(L' = \mathop{lang}(A) \backslash \{ \epsilon \}\), ce qui prouvera que \(\mathop{lang}(A)\) est local.
-
\(L' \subset \mathop{lang}(A)\). Soit \(w = a_1\dots a_n \in L'\). Par définition de \(L'\), on a \(a_1 \in P\) et \(a_n \in S\). On va montrer par récurrence bornée que \(\delta^*(q_i,a_1 \dots a_j)\) est bien défini pour \(j \in \range{1}{n}\).
- Initialisation : on a \(\delta^*(q_i,a_1) = \delta(q_i,a_1)\) défini par définition de \(P\).
- Hérédité : Soit \(j \in \range{1}{n-1}\) tel que \(\delta^*(q_i,a_1\dots a_j)\) est bien défini. On pose \(q' = \delta^*(q_i, a_1\dots a_j)\) : c'est un état sur lequel arrive une transition étiquetée par \(a_j\). Par hypothèse, \(a_j a_{j+1} \not\in N\) donc il existe \(p \xrightarrow{a_j} p' \xrightarrow{a_{j+1}} p''\). Comme l'automate est local, toutes les transitions étiquetées par \(a_j\) arrivent sur le même état, donc \(p' = q'\) et \(\delta^*(q_i,a_1\dots a_{j+1}) = \delta(q', a_{j+1}) = p''\) est bien défini.
Pour \(j = n\), on a \(q = \delta^*(q_i,a_1\dots a_n)\) bien défini. Comme \(a_n \in S\), il existe une transition étiquetée par \(a_n\) arrivant sur un état final, et, par localité, cet état est \(q\). Donc \(q \in F\) et \(w\) est reconnu.
-
\(\mathop{lang}(A)\backslash \{\epsilon \} \subset L'\). Soit \(w = a_1\dots a_n\) un mot non vide reconnu par \(A\). On a donc un chemin
\[ q_i \xrightarrow{a_1} \dots \xrightarrow{a_n} q \in F \]Par définition, on a donc \(a_1 \in P\), \(a_n \in S\) et comme on a pu réaliser les transitions, pour tout \(j \in \range{1}{n-1}\), \(a_j a_{j+1} \not\in N\). Ainsi \(w \in L'\).
On peut déduire de cette caractérisation des propriétés de stabilité des langages locaux.
Théorème
Soit \(L\) un langage local, le langage \(L^*\) est local.
Preuve
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate local et standard pour \(L\), qui existe d'après le théorème précédent.
On pose \(A' = (Q, \Sigma, \delta', q_i, F \cup \{ q_i \})\) avec \(\delta'(q,a) = \delta(q,a)\) pour \((q,a)\) dans le domaine de \(\delta\) et pour toute transition \(\delta(q_i,a) = q\) et \(q' \in F\), on pose \(\delta'(q',a) = q\). Cela ne crée pas de conflit : si \(\delta(q',a)\) était déjà défini, il valait \(q\) par localité. Ces nouvelles transitions arrivent sur l'unique état cible des transitions étiquetées par \(a\), ce qui préserve la localité de l'automate.
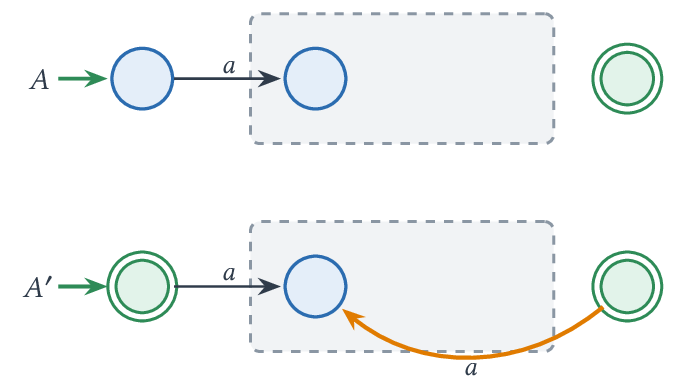
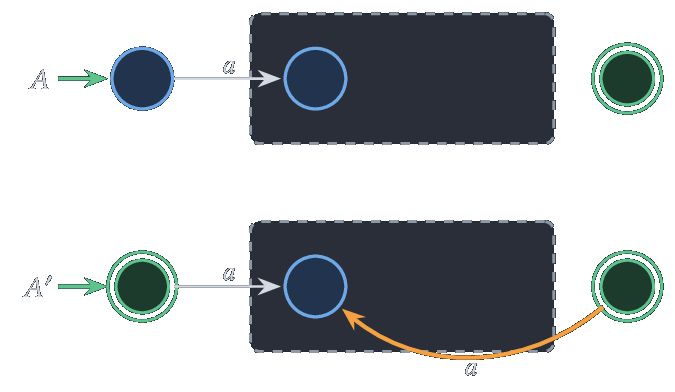
Montrons que \(A'\) reconnaît \(L^*\).
- \(\mathop{lang}(A') \subset L^*\). Les nouvelles transitions arrivent sur des états \(\delta(q_i,a) \neq q_i\) car \(A\) est standard, donc \(A'\) est encore standard : le seul chemin réussi aboutissant en \(q_i\) est le chemin vide, d'étiquette \(\epsilon \in L^*\). Sinon, le chemin aboutit dans \(F\). On le coupe juste avant chaque utilisation d'une nouvelle transition \(q' \xrightarrow{a} q\) (avec \(q' \in F\)). Chaque morceau part de \(q_i\) ou commence par une telle transition, qu'on remplace par \(q_i \xrightarrow{a} q\), et n'utilise ensuite que des transitions de \(A\) jusqu'à un état de \(F\). Chaque morceau est donc l'étiquette d'un chemin réussi de \(A\), et le mot est dans \(L^*\).
- \(L^* \subset \mathop{lang}(A')\). \(\epsilon\) est reconnu car \(q_i\) est final. Soit \(w = u_1 \dots u_k\) avec \(u_1, \dots, u_k \in L \backslash \{\epsilon\}\) et \(k \ge 1\). Le mot \(u_1\) étiquette un chemin de \(q_i\) à un état de \(F\) dans \(A\). Pour \(l \ge 2\), on écrit \(u_l = a v\) ; il existe dans \(A\) un chemin \(q_i \xrightarrow{a} q \xrightarrow{v} f\) avec \(f \in F\), et dans \(A'\) on peut le reprendre depuis l'état final atteint précédemment grâce à la nouvelle transition étiquetée par \(a\) vers \(q\). On recolle ainsi un chemin réussi d'étiquette \(w\).
Théorème
Soient \(L_1, L_2\) des langages locaux sur des alphabets disjoints \(\Sigma_1\) et \(\Sigma_2\) les langages \(L_1 \cup L_2\) et \(L_1 L_2\) sont locaux sur l'alphabet \(\Sigma = \Sigma_1 \cup \Sigma_2\).
Preuve
On va juste donner les constructions correspondantes d'automates locaux.
Soient \(A_1 = (Q_1, \Sigma_1, \delta_1, i_1, F_1)\) et \(A_2 = (Q_2, \Sigma_2, \delta_2, i_2, F_2)\) des automates standards locaux reconnaissant respectivement \(L_1\) et \(L_2\), avec \(Q_1 \cap Q_2 = \emptyset\).
On pose
avec
Comme les automates \(A_1\) et \(A_2\) sont standards, aucune transition n'arrivait sur \(i_1\) ou \(i_2\) : on n'a pas perdu de transitions ici.
\(A_u\) est déterministe car les alphabets sont disjoints. Il est local : une lettre \(a \in \Sigma_1\) ne mène que vers l'unique état cible des transitions étiquetées par \(a\) dans \(A_1\), et de même pour \(\Sigma_2\). Il est standard car aucune transition n'arrive sur \(i\).
Enfin, un chemin non vide partant de \(i\) commence par une lettre de \(\Sigma_1\), et reste alors dans \(Q_1 \backslash \{i_1\}\) car les états de \(Q_1\) n'ont que des transitions vers \(Q_1 \backslash \{i_1\}\), ou par une lettre de \(\Sigma_2\), et reste alors dans \(Q_2 \backslash \{i_2\}\). Les chemins réussis non vides de \(A_u\) correspondent donc exactement à ceux de \(A_1\) et de \(A_2\), en remplaçant \(i\) par \(i_1\) ou \(i_2\), et le mot vide est reconnu si et seulement si \(\epsilon \in L_1 \cup L_2\). Ainsi \(A_u\) reconnaît \(L_1 \cup L_2\).
De même, on pose
où
Les nouvelles transitions partent d'états de \(Q_1\) avec des lettres de \(\Sigma_2\), donc \(A_p\) reste déterministe. Elles arrivent sur l'unique état cible des transitions étiquetées par \(a\) dans \(A_2\), donc \(A_p\) est local, et il est standard car aucune transition n'arrive sur \(i_1\).
Un chemin réussi de \(A_p\) lit d'abord des lettres de \(\Sigma_1\) en restant dans \(Q_1\), puis, s'il lit une lettre de \(\Sigma_2\), passe d'un état \(q \in F_1\) à \(Q_2 \backslash \{i_2\}\) par une nouvelle transition et ne revient plus dans \(Q_1\). S'il ne passe jamais dans \(Q_2\), il finit dans \(F_1\), ce qui n'est possible que si \(\epsilon \in L_2\) : son étiquette est dans \(L_1 \cdot \{\epsilon\} \subset L_1 L_2\). Sinon, son étiquette s'écrit \(u v\) avec \(u\) l'étiquette d'un chemin réussi de \(A_1\) et \(v\) celle d'un chemin réussi de \(A_2\), en remplaçant la nouvelle transition par la transition correspondante partant de \(i_2\). La réciproque se montre en recollant de la même façon un chemin réussi de \(A_1\) et un de \(A_2\). Ainsi \(A_p\) reconnaît \(L_1 L_2\).
Expressions régulières linéaires
Définition
Une expression régulière est dite linéaire si chaque lettre de \(\Sigma\) y apparaît au plus une fois.
Exemple
L'expression régulière \(a(b|c)^*\) est linéaire mais \(a(a|b)^*\) ne l'est pas.
On déduit des deux théorèmes précédents le théorème suivant :
Théorème
Soit \(e\) une expression régulière linéaire, \(\mathop{lang}(e)\) est un langage local.
Preuve
Par induction sur l'expression régulière.
- Cas de base : Si \(e = \emptyset, \epsilon\) ou \(a\) avec \(a \in \Sigma\), c'est direct : par exemple \(\{a\}\) est local avec \(P = S = \{a\}\) et \(N = \Sigma^2\).
- Pour \(e^*, e | e'\) ou \(e e'\), l'hypothèse d'induction et les théorèmes précédents permettent de conclure, en voyant \(\mathop{lang}(e)\) et \(\mathop{lang}(e')\) comme des langages sur les alphabets des lettres apparaissant respectivement dans \(e\) et \(e'\). Ces alphabets sont disjoints par linéarité : une même lettre ne peut pas être présente dans \(e\) et dans \(e'\).
- Enfin, un langage local sur un alphabet \(\Sigma' \subset \Sigma\) est local sur \(\Sigma\) : il suffit de garder les mêmes \(P\) et \(S\), et d'ajouter à \(N\) tous les facteurs de longueur 2 contenant une lettre de \(\Sigma \backslash \Sigma'\).
Remarque
La réciproque est fausse, il existe des langages locaux qui ne sont pas dénotés par des expressions linéaires. Par exemple \((ab)^* a\) est local avec \(P = \{ a \}, S = \{ a \}\) et \(N = \{ aa, bb \}\), mais une expression régulière le dénotant devra forcément contenir au moins deux \(a\) (on l'admet ici).
Corollaire
Pour toute expression régulière linéaire \(e\), il existe un automate local déterministe \(A\) tel que \(\mathop{lang}(e) = \mathop{lang}(A)\).
Pour déterminer cet automate, on a vu une preuve explicite en déterminant les ensembles \(P,S\) et \(N\) pour \(\mathop{lang}(e)\). Pour calculer ces ensembles pour une expression régulière, on peut le faire par induction.
Tout d'abord, comme on a besoin de savoir si l'expression reconnait le mot vide, on peut définir la propriété \(accv(e)\) :
On définit ensuite \(P,S\) et \(N\) directement. On suppose ici que \(e\) ne contient pas \(\emptyset\), ce qui n'est pas restrictif : une expression régulière est équivalente soit à \(\emptyset\), soit à une expression ne contenant pas \(\emptyset\), grâce aux simplifications \(e\emptyset = \emptyset e = \emptyset\), \(e|\emptyset = \emptyset | e = e\) et \(\emptyset^* = \epsilon\). Sans cette hypothèse, la formule donnant \(S(e_1 e_2)\) serait fausse pour \(e_1 = \emptyset\).
Ces formules calculent les ensembles \(P(L)\), \(S(L)\) et \(N(L)\) du théorème de caractérisation pour \(L = \mathop{lang}(e)\). Pour \(N\), il est plus simple de raisonner sur son complémentaire, l'ensemble des facteurs de longueur 2 des mots de \(L\). Par exemple, un facteur de longueur 2 d'un mot \(uv\) avec \(u \in \mathop{lang}(e_1)\) et \(v \in \mathop{lang}(e_2)\) est soit un facteur de \(u\), soit un facteur de \(v\), soit formé de la dernière lettre de \(u\) et de la première de \(v\). L'hypothèse d'absence de \(\emptyset\) garantit que les langages \(\mathop{lang}(e_1)\) et \(\mathop{lang}(e_2)\) sont non vides, ce qui permet d'obtenir tous ces facteurs.
Application aux expressions régulières
Étant donné une expression régulière \(e\), on peut en déduire une expression régulière linéaire en indiçant les occurrences de chaque lettre. Par exemple, \((ab)^* aba\) deviendra \((a_1 b_1)^* a_2 b_2 a_3\).
On peut alors en déduire un automate déterministe local par la méthode précédente. En oubliant les indices sur les transitions de cet automate, on en déduit un automate non déterministe reconnaissant le même langage que l'expression régulière initiale. En effet, si on note \(h\) l'application qui efface les indices d'un mot, on a \(\mathop{lang}(e) = h(\mathop{lang}(e'))\) (par une induction immédiate sur \(e\)), et les chemins réussis de l'automate sans indices sont exactement ceux de l'automate local, avec des étiquettes dont on a effacé les indices.
C'est l'algorithme de Berry-Sethi.
Exemple
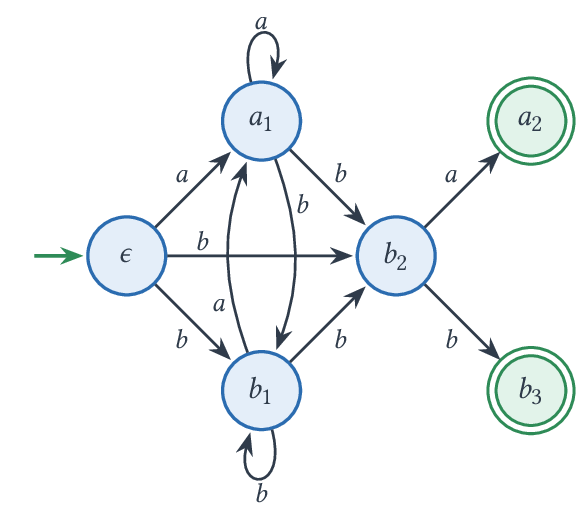
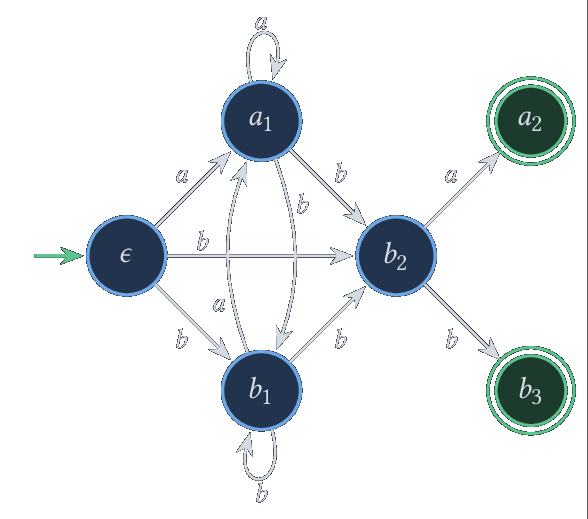
On va considérer l'expression régulière \(e = (a|b)^* b (a|b)\).
On commence par la linéarisation \(e' = (a_1|b_1)^* b_2 (a_2|b_3)\).
On calcule les ensembles \(P, S\) et \(N\) :
Pour \(N\), il est plus rapide de donner son complémentaire :
On en déduit l'automate local :
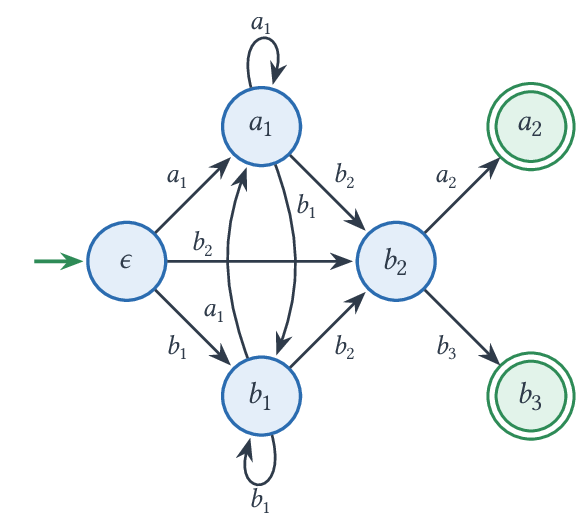
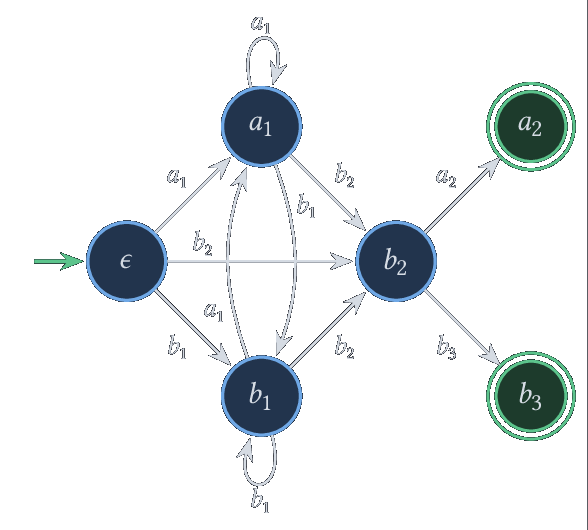
En oubliant les indices, on obtient l'automate :
Conséquences du théorème de Kleene
Stabilité des langages réguliers
Par union finie
Théorème
Soient \(L_1, \dots, L_n\) des langages réguliers sur \(\Sigma\). Le langage \(L_1 \cup \dots \cup L_n\) est régulier.
Preuve
Du théorème de Kleene on déduit des expressions régulières \(e_1, \dots, e_n\) dénotant respectivement \(L_1, \dots, L_n\). Le langage dénoté par \(e_1 |\dots | e_n\) est \(L_1 \cup \dots \cup L_n\) et par le théorème de Kleene, il est régulier.
Par complémentaire
Lemme
Soit \(A = (Q, \Sigma, \delta, q_i, F)\) un automate déterministe complet, l'automate \(A' = (Q, \Sigma, \delta, q_i, Q \backslash F)\) reconnaît \(\Sigma^* \backslash \mathop{lang}(A)\).
Preuve
Comme \(A\) est complet, \(\delta^*(q_i, w)\) est défini pour tout \(w \in \Sigma^*\), et comme il est déterministe, c'est l'unique état atteint en lisant \(w\). Ainsi \(w \in \mathop{lang}(A') \iff \delta^*(q_i,w) \in Q \backslash F \iff \delta^*(q_i,w) \not\in F \iff w \not\in \mathop{lang}(A)\).
Les deux hypothèses sont nécessaires : si \(A\) n'est pas complet, un mot qui bloque n'est reconnu ni par \(A\) ni par \(A'\) ; si \(A\) n'est pas déterministe, un mot peut atteindre à la fois un état de \(F\) et un état de \(Q \backslash F\), et être reconnu par les deux.
Théorème
Les langages réguliers sont stables par complémentaire. Si \(L\) est régulier sur \(\Sigma^*\) alors \(\Sigma^* \backslash L\) est régulier.
Preuve
Comme \(L\) est régulier il est reconnaissable par un automate déterministe qu'on rend complet en rajoutant un état puits. En appliquant le lemme et le théorème de Kleene, on en déduit que \(\Sigma^* \backslash L\) est régulier.
Par intersection finie
Théorème
Soient \(L_1, \dots, L_n\) des langages réguliers sur \(\Sigma\). Le langage \(L_1 \cap \dots \cap L_n\) est régulier.
Preuve
On a \(L_1 \cap \dots \cap L_n = \Sigma^* \backslash \left( (\Sigma^* \backslash L_1) \cup \dots \cup (\Sigma^* \backslash L_n) \right)\). Il s'agit donc d'une conséquence directe des deux théorèmes précédents.
Lemme de l'étoile
Théorème
Lemme de l'étoile Soit \(L\) un langage régulier sur \(\Sigma\). Il existe une constante \(n \in \N^*\) telle que pour tout \(w \in L\), si \(|w|\ge n\) alors il existe \(x,y,z \in \Sigma^*\) tels que \(w = xyz\) et
- \(y \neq \epsilon\)
- \(|xy| \le n\)
- \(x y^* z \subset L\)
Remarque
Cela signifie que pour tout mot suffisamment long, on peut identifier un facteur non vide qui peut être répété autant qu'on le souhaite.
Preuve
Soit \(A= (Q, \Sigma, \delta, q_0, F)\) un automate déterministe reconnaissant \(L\). On pose \(n = |Q|\).
Soit \(w \in L\) tel que \(|w| \ge n\). Comme \(w\) est reconnu, il existe un chemin \(q_0 \rightarrow q_1 \rightarrow \dots \rightarrow q_m \in F\) d'étiquette \(w\). Comme \(m = |w| \ge n = |Q|\), les \(n+1\) états \(q_0, \dots, q_n\) ne peuvent pas être deux à deux distincts : il existe \(0 \le i < j \le n\) tels que \(q_i = q_j\). On pose alors \(x\) l'étiquette de \(q_0 \leadsto q_i\), \(y\) l'étiquette de \(q_i \leadsto q_j\) et \(z\) celle de \(q_j \leadsto q_m\).
On a \(w = xyz\), \(|y| = j-i > 0\) donc \(y \neq \epsilon\) et \(|xy| = j \le n\).
Comme \(q_i = q_j\), le chemin correspondant à \(y\) est une boucle, on peut donc l'emprunter autant qu'on le souhaite et ainsi tous les mots de la forme \(x y^k z\) sont reconnus par \(A\).
Ce lemme est très utile par sa contraposée qui permet d'affirmer que si un langage ne vérifie pas cette propriété, alors il n'est pas régulier :
Corollaire
Soit \(L\) un langage sur \(\Sigma\). Si pour tout \(n \in \N^*\), il existe \(w \in L\) tel que \(|w| \ge n\) et que pour tout \(x, y, z \in \Sigma^*\) tels que \(w = x y z\), \(y \neq \epsilon\) et \(|xy| \le n\) il existe \(k \in \N\) avec \(x y^k z \not\in L\), alors \(L\) n'est pas régulier.
Exemple
Le langage \(L = \enscomp{a^n b^n}{n \in \N}\) n'est pas régulier.
Soit \(n \in \N^*\), on considère \(w = a^n b^n \in L\), qui est bien de longueur \(\ge n\). Soient \(x,y,z\) tels que \(w = x y z\) avec \(y \neq \epsilon\) et \(|xy| \le n\), on a donc \(xy\) préfixe de \(a^n\) : \(x = a^k\) et \(y = a^l\) avec \(k+l \le n\) et \(l > 0\) et ainsi \(z = a^{n-k-l} b^n\).
Le mot \(x z = a^k a^{n-k-l} b^n = a^{n-l} b^n \not\in L\) car \(n - l < n\).
Ainsi, selon le lemme de l'étoile, \(L\) n'est pas régulier.
Remarque
Cet exemple est très important car c'est un cas particulier très simple des expressions bien parenthésées. On sait qu'on peut les reconnaître avec une pile, et on vient de voir que c'est impossible de le faire avec un automate fini.
Remarque
Attention, le lemme de l'étoile n'est pas une équivalence. Un langage peut très bien le satisfaire et être non régulier comme on va le voir dans l'exemple suivant.
Exemple
On considère le langage
On a \(L \cap a b \Sigma^* = \enscomp{a b^n c^n}{n \in \N^*}\), qui n'est pas régulier : c'est, à la lettre \(a\) en préfixe près, le même exemple que le précédent, et la même preuve s'applique. Or, \(a b \Sigma^*\) est régulier donc nécessairement \(L\) n'est pas régulier par clôture des langages réguliers par intersection.
On va montrer que \(L\) vérifie le lemme de l'étoile pour \(n = 2\).
Soit \(w \in L\) tel que \(|w| \ge 2\). On a quatre cas possibles pour \(w\) :
- \(w = a b^n c^n\) pour \(n \in \N^*\), on peut alors poser \(x = \epsilon\), \(y = a\) et \(z = b^n c^n\). On a pour \(k \in \N\), \(xy^k z= a^k b^n c^n\) qui est soit dans \(L_1\) si \(k =1\) ou dans \(L_2\) sinon.
- \(w = a^k v\) avec \(k \ge 2\), \(k\neq 3\) et \(v\in \{b,c\}^*\). On pose \(x = \epsilon\), \(y = aa\) et \(z = a^{k-2} v\). On a \(x y^l z = a^{2l} a^{k-2} v\). Si \(l = 0\), alors \(x y^0 z = a^{k-2} v \in L\) car \(k-2 \neq 1\). Si \(l > 0\), alors \(2l +k - 2 \ge 2l \ge 2\) donc \(x y^l z \in L\).
- \(w = a^3 v\) avec \(v \in \{b,c\}^*\). On pose \(x =\epsilon, y = a\) et \(z = a^2 v\). Ainsi \(x y^l z = a^{l + 2} v \in L\) car \(l + 2 \ge 2\).
- \(w \in \{b,c\}^*\) : on écrit \(w = \ell v\) avec \(\ell \in \{b, c\}\) la première lettre de \(w\) et on pose \(x = \epsilon\), \(y = \ell\) et \(z = v\). On a alors \(x y^k z = \ell^k v \in \{b, c\}^* \subset L\).
Ainsi, on a bien prouvé que \(L\) satisfait le lemme de l'étoile.