Problème qui reprend un sujet de tronc commun de l'X en l'adaptant au C. Donné en DM 1 en MP2I 2021-2022, puis en DM 2 en MP2I 2022-2023.
Remarque
À rendre sur feuille pour la rentrée des vacances de la Noël. Les programmes pourront être donnés sous forme imprimée plutôt qu'écrits à la main. Vous êtes très fortement encouragé à faire un programme complet réalisant le sujet : en testant toutes vos fonctions !
On pourra notamment faire une interface graphique avec raylib.
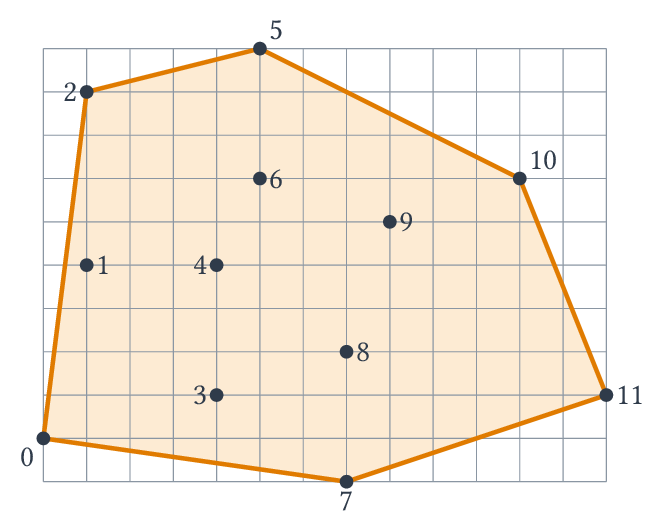
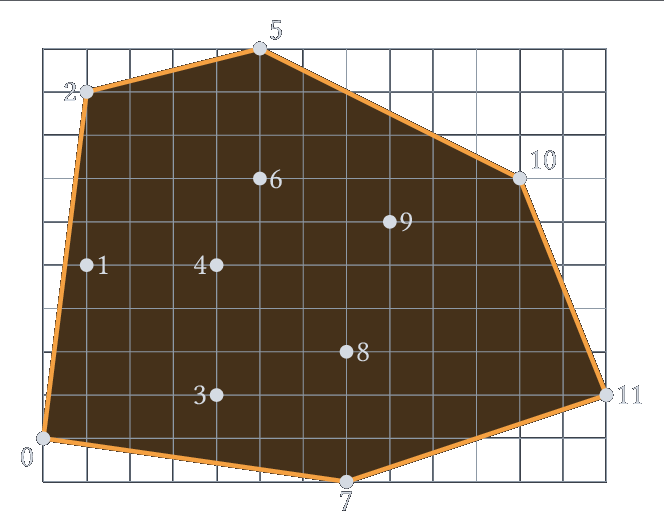
Ce sujet a pour objectif de calculer des enveloppes convexes de nuages de points dans le plan affine, un grand classique en géométrie algorithmique. On dit qu'un ensemble \(C \subset \R^2\) est convexe si et seulement si pour toute paire de points \(p, q \in C\), le segment de droite \([p, q]\) est inclus dans \(C\). L'enveloppe convexe d'un ensemble \(P \subset \R^2\), notée \(Conv(P)\), est le plus petit convexe contenant \(P\). Dans le cas où \(P\) est un ensemble fini (appelé nuage de points), le bord de \(Conv(P)\) est un polygone convexe dont les sommets appartiennent à \(P\), comme illustré dans la figure 1.
Le calcul de l'enveloppe convexe d'un nuage de points est un problème fondamental en informatique, qui trouve des applications dans de nombreux domaines comme :
-
la robotique, par exemple pour l'accélération de la détection de collisions dans le cadre de
-
le traitement d'images et la vision, par exemple pour la détection d'objets convexes (comme des plaques minéralogiques de voiture) dans des scènes 2d,
- l'informatique graphique, par exemple pour l'accélération du rendu de scènes 3d par lancer de rayons,
- la théorie des jeux, par exemple pour déterminer l'existence d'équilibres de Nash,
- la vérification formelle, par exemple pour déterminer si une variable risque de dépasser sa capacité de stockage ou d'atteindre un ensemble de valeurs interdites lors de l'exécution d'une boucle dans un programme, et bien d'autres encore.
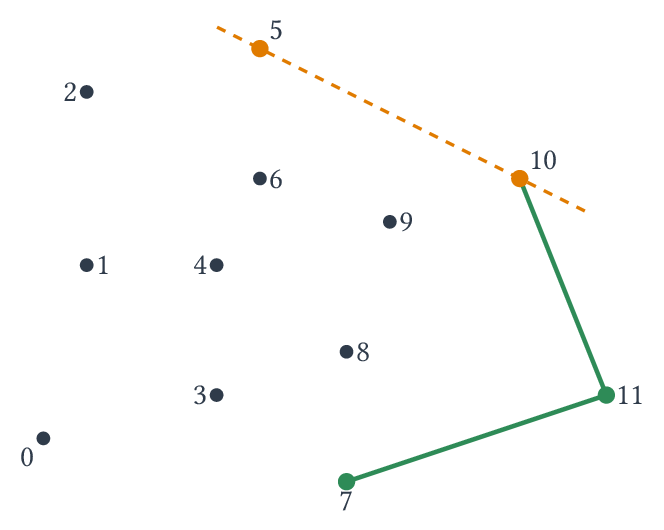
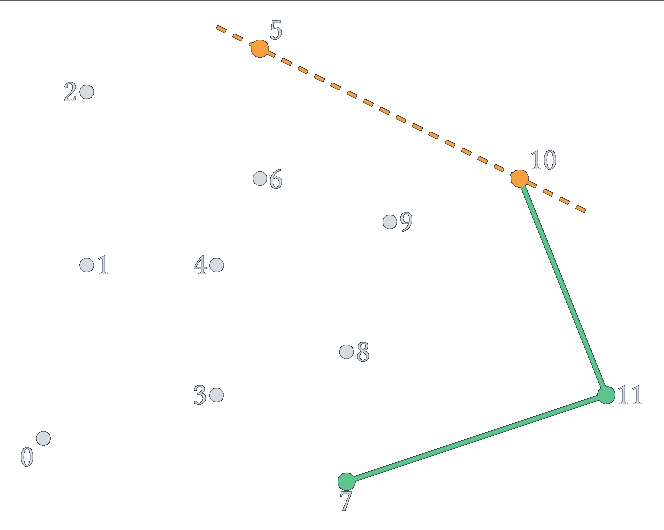
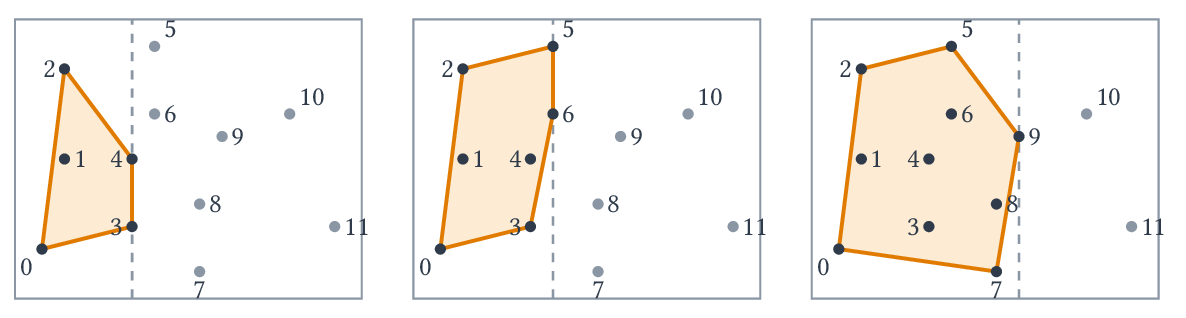
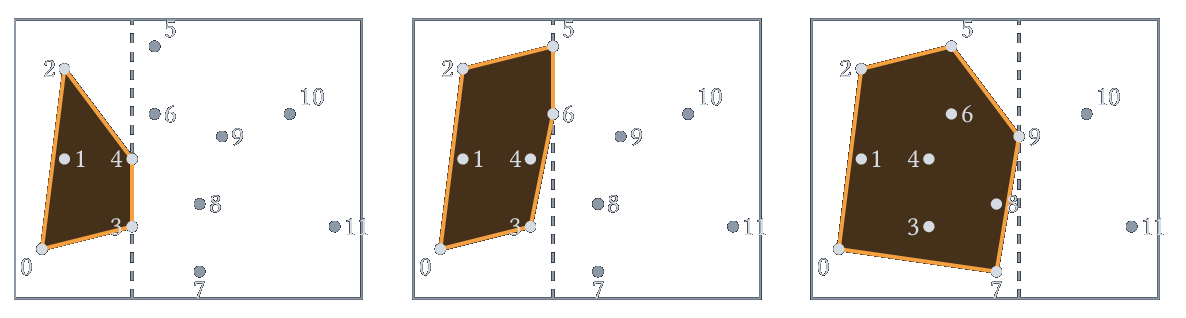
Dans ce sujet nous allons écrire deux algorithmes de calcul du bord de l'enveloppe convexe d'un nuage de points \(P\) dans le plan affine. Le premier, dit algorithme du paquet cadeau, consiste à envelopper le nuage de points \(P\) progressivement en faisant pivoter une droite tout autour. Le deuxième, dit de balayage, consiste à balayer le plan horizontalement avec une droite verticale, tout en maintenant au fur et à mesure l'enveloppe convexe de la partie du nuage située à gauche de cette droite verticale. Les deux algorithmes sont illustrés respectivement dans les figures 3 et 4.
Le temps d'exécution du premier algorithme est majoré par une constante fois \(nm\), celui du deuxième par une constante fois \(n \log n\), où \(n\) désigne le nombre total de points de \(P\) et \(m\) le nombre de points de \(P\) appartenant au bord de \(Conv(P)\). Rappelons que le temps d'exécution d'un programme \(A\) (fonction ou procédure) est le nombre d'opérations élémentaires (comparaisons, additions, soustractions, multiplications, divisions, affectations, etc.) nécessaires à l'exécution de \(A\). Sauf mention contraire dans l'énoncé du sujet, le candidat n'aura pas à justifier des temps de calcul de ses programmes. Toutefois, il devra veiller à ce que ces derniers ne dépassent pas les bornes prescrites.
On va représenter les points par des tableaux de deux entiers { x, y }.
Dans toute la suite on supposera que le nuage de points \(P\) est de taille \(n\ge 3\) et
en position générale, c'est-à-dire qu'il ne contient pas \(3\) points distincts alignés.
Ces hypothèses vont permettre de simplifier les calculs en ignorant les cas pathologiques,
comme par exemple la présence de 3 points alignés sur le bord de l'enveloppe convexe. Nos
programmes prendront en entrée un nuage de points \(P\) dont les coordonnées sont stockées dans
un tableau tab de tableaux de 2 entiers,
comme dans l'exemple ci-dessous qui contient les coordonnées
du nuage de points de la figure 1 :
int tab[][2] = {
    { 0, 0 }, { 1, 4 }, { 1, 8 }, { 4, 1 }, { 4, 4 }, { 5, 9 },
    { 5, 6 }, { 7, -1 }, { 7, 2 }, { 8, 5 }, { 11, 6 }, { 13, 1 }
};
Précisons que les coordonnées, supposées entières, sont données dans une base orthonormée du plan, orientée dans le sens direct.
Préliminaires
Question 1. Écrire une fonction int plus_bas(int tab[][2], int n) qui prend en paramètre le tableau
tab de \(n\) points
et qui renvoie l'indice \(j\) du point le plus bas (c'est-à-dire de plus petite ordonnée) parmi
les points du nuage \(P\). En cas d'égalité, votre fonction devra renvoyer l'indice du point de plus
petite abscisse parmi les points les plus bas.
Corrigé
int plus_bas(int tab[][2], int n)
{
    int i = 0;

    for (int j = 1; j < n; j++)
    {
        if (tab[j][1] < tab[i][1]
            || (tab[j][1] == tab[i][1] && tab[j][0] < tab[i][0]))
            i = j;
    }

    return i;
}
Question 2. Prouver la correction de cette fonction.
Corrigé
On note \(y_i\) l'ordonnée de tab[i] et \(x_i\) son abscisse, et on note \(\le_{lex}\)
l'ordre lexicographique sur les couples \((y, x)\) : le point cherché est l'indice \(i\)
tel que \((y_i, x_i)\) soit minimal pour cet ordre.
On a l'invariant de boucle \(P(i,j)= \forall k \in \range{0}{j-1}, (y_i, x_i) \le_{lex} (y_k, x_k)\).
- Initialisation : en début de boucle, \(j\) vaut 1, \(i\) vaut 0 et \(P(0,1)\) est vérifié directement.
- Hérédité : si l'invariant \(P(i,j)\) est vérifié en début de boucle, alors
- soit \((y_i, x_i) \le_{lex} (y_j, x_j)\), \(i\) ne change pas et on a bien \(P(i, j+1)\) ;
- soit \((y_j, x_j) <_{lex} (y_i, x_i)\) (c'est exactement la condition du
if) et alors on passe à \(P(j,j+1)\) en fin de boucle : pour \(k \in \range{0}{j}\), soit \(k < j\) et ainsi \((y_k, x_k) \ge_{lex} (y_i, x_i) >_{lex} (y_j, x_j)\), soit \(k = j\). Dans tous les cas \((y_k, x_k) \ge_{lex} (y_j, x_j)\).
L'invariant est donc valide et ainsi en sortie de boucle on a
c'est-à-dire que \(p_i\) est le plus bas et, parmi les plus bas, celui de plus petite abscisse.
La terminaison est immédiate (boucle for à \(n-1\) itérations).
Sur le tableau exemple précédent, le résultat de la fonction doit être l'indice 7.
Dans la suite nous aurons besoin d'effectuer un seul type de test géométrique : celui de l'orientation.
Définition 1
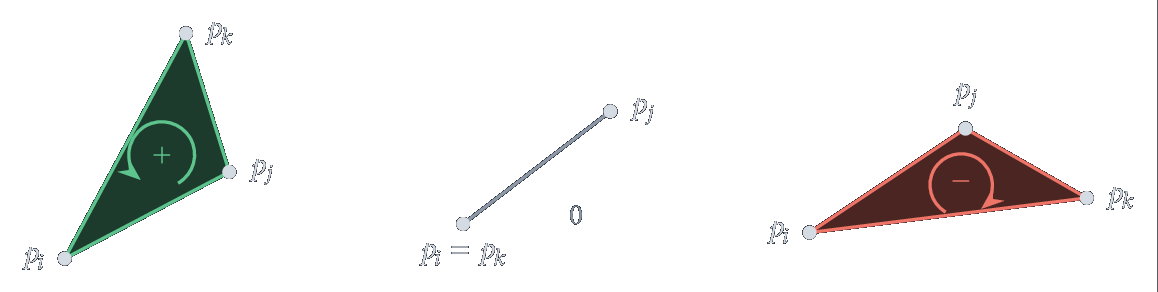
Étant donnés trois points \(p_i, p_j, p_k\) du nuage \(P\), distincts ou non, le test d'orientation renvoie \(+1\) si la séquence \((p_i, p_j, p_k)\) est orientée positivement, \(-1\) si elle est orientée négativement, et 0 si les trois points sont alignés (c'est-à-dire si deux au moins sont égaux, d'après l'hypothèse de position générale).
Pour déterminer l'orientation de \((p_i, p_j, p_k)\), il suffit de calculer l'aire signée du triangle, comme illustré sur la figure 2. Cette aire vaut
où \(p_a\) a pour coordonnées \((x_a, y_a)\). Comme on travaille avec des entiers, on évitera de faire la division par 2 qui peut aboutir à 0 et ne préserve pas le signe strict.
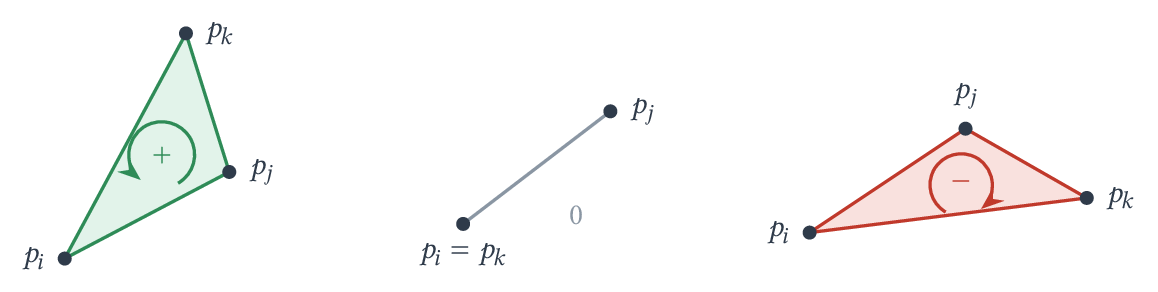
Question 3. Sur le tableau exemple précédent, donner le résultat du test d'orientation pour les choix d'indices suivants :
- \(i = 0\), \(j = 3\), \(k = 4\),
- \(i = 8\), \(j = 9\), \(k = 10\).
Corrigé
- Positif.
- Négatif.
Question 4. Écrire une fonction int orient(int tab[][2], int i, int j, int k)
qui prend en paramètres le tableau tab et
trois indices, potentiellement égaux, et qui renvoie le résultat (\(-1\), \(0\) ou \(+1\)) du test
d'orientation sur la séquence \((p_i, p_j, p_k)\) de points de \(P\).
Corrigé
int orient(int tab[][2], int i, int j, int k)
{
    int a = (tab[k][1]-tab[i][1])*(tab[j][0]-tab[i][0])
          - (tab[k][0]-tab[i][0])*(tab[j][1]-tab[i][1]);

    if (a < 0)
        return -1;
    if (a > 0)
        return 1;
    return 0;
}
Algorithme du paquet cadeau
Cet algorithme a été proposé par R. Jarvis en 1973. Il consiste à envelopper peu à peu le nuage de points \(P\) dans une sorte de paquet cadeau, qui à la fin du processus est exactement le bord de \(Conv(P)\). On commence par insérer le point de plus petite ordonnée (celui d'indice 7 dans l'exemple de la figure 1) dans le paquet cadeau, puis à chaque étape de la procédure on sélectionne le prochain point du nuage \(P\) à insérer.
La procédure de sélection fonctionne comme suit. Soit \(p_i\) le dernier point inséré dans le paquet cadeau à cet instant. Par exemple, \(i = 10\) dans l'exemple de la figure 3.
Considérons la relation binaire \(\preceq\) définie sur l'ensemble \(P \backslash \{p_i\}\) par :
Question 5. Justifier brièvement le fait que \(\preceq\) est une relation d'ordre total sur l'ensemble \(P \backslash \{p_i \}\).
Corrigé
C'est une question de maths ça…
Si \(p,q,r\) sont des points, on note ici \(A(p,q,r)\) l'aire signée du triangle donnée par la formule du sujet. On a \(q \preceq r \iff A(p_i, q, r) \le 0\).
La relation \(\preceq\) est :
- réflexive : soit \(q\) un point, on a directement \(A(p_i,q,q) = 0\) donc \(q \preceq q\).
-
antisymétrique : soit \(q=(x,y), r=(x',y')\) des points tels que \(q \preceq r\) et \(r \preceq q\). On a \(A(p_i,q,r) = \frac{1}{2} ( (y'-y_i)(x-x_i) - (x'-x_i)(y-y_i) ) = - \frac{1}{2} ( (y-y_i)(x'-x_i) - (x-x_i)(y'-y_i) ) = - A(p_i,r,q)\).
Donc \(A(p_i,q,r) \le 0\) car \(q \preceq r\) et \(A(p_i,q,r) = - A(p_i,r,q) \ge 0\) car \(r \preceq q\), donc \(A(p_i,q,r) = 0\). Ainsi le triangle est d'aire nulle, donc il est plat, comme les points ne peuvent être alignés par hypothèse sur \(P\), c'est forcément que \(q = r\).
-
totale : soit \(q,r\) des points, si on n'a pas \(q \preceq r\), on a \(A(p_i,q,r) > 0\) et donc \(A(p_i,r,q) = - A(p_i,q,r) < 0\) donc on a bien \(r \preceq q\). Dans tous les cas, soit \(q \preceq r\), soit \(r \preceq q\) : la relation est bien totale.
-
transitive : assez compliqué en fait. Ici, on peut supposer par construction que \(p_i\) est sur le bord de l'enveloppe convexe de \(P\).
On considère, par l'absurde, trois points \(p_j,p_k,p_l\) de \(P\backslash\{p_i\}\) distincts tels que \(p_j \preceq p_k\), \(p_k \preceq p_l\) et \(p_l \preceq p_j\) (si deux de ces points sont égaux, la transitivité découle de la réflexivité et de l'antisymétrie). Comme les trois points ne sont pas alignés, il est possible d'exprimer \(p_i\) comme un barycentre de ceux-ci : il existe \(a,b,c\) tels que \(a+b+c=1\) et \(x_i = a x_j + b x_k + c x_l\), \(y_i = a y_j + b y_k + c y_l\).
On montre alors par le calcul que \(A(p_i,p_j,p_k) = c A(p_l,p_j,p_k)\), \(A(p_i,p_k,p_l) = a A(p_l,p_j,p_k)\) et \(A(p_i,p_l,p_j) = b A(p_l,p_j,p_k)\). Les trois aires de gauche sont strictement négatives (position générale) et \(A(p_l,p_j,p_k) \neq 0\), donc \(a,b,c\) sont non nuls et de même signe ; comme \(a+b+c=1\), on a \(a,b,c > 0\) et ainsi \(p_i\) est un point strictement intérieur au triangle de sommets \(p_j,p_k,p_l\) : il ne peut appartenir au bord de l'enveloppe convexe. Contradiction.
Ainsi, le prochain point à insérer (le point d'indice 5 dans la figure 3) est l'élément maximum pour la relation d'ordre \(\preceq\). Il peut se calculer en temps linéaire (c'est-à-dire majoré par une constante fois \(n\)) par une simple itération sur les points de \(P \backslash \{p_i\}\).
Question 6. Écrire une réalisation de la procédure. Elle prendra la forme d'une fonction
int prochain_point(int tab[][2], int n, int i);
qui prend en paramètre le
tableau tab de \(n\) points ainsi que
l'indice \(i\) du point inséré en dernier dans le paquet cadeau, et qui renvoie l'indice du prochain
point à insérer. Le temps d'exécution de votre fonction doit être majoré par une constante fois
\(n\), pour tous \(n\) et \(i\). La constante doit être indépendante de \(n\) et \(i\), et on ne demande pas de la
préciser.
Corrigé
int prochain_point(int tab[][2], int n, int i)
{
    int m = 0;

    if (i == 0) m = 1;
    for (int j = 1; j < n; j++)
    {
        if (j != i && orient(tab, i, m, j) <= 0)
            m = j;
    }

    return m;
}
Question 7. Décrire à la main le déroulement de la fonction prochain_point sur l'exemple de la
figure 3. Plus précisément, indiquer la séquence des points de \(P \backslash \{p_{10}\}\)
considérés et la valeur de l'indice du maximum à chaque itération.
Corrigé
- Au départ \(m = 0\).
- Pour \(j = 1\), on a \(orient(10,0,1) \le 0\), donc \(m = j = 1\).
- Pour \(j = 2\), on a \(orient(10,1,2) \le 0\), donc \(m = j = 2\).
- Pour \(j = 3\) et \(4\), le test est \(> 0\) donc rien ne change.
- Pour \(j = 5\), on a \(orient(10,2,5) \le 0\), donc \(m = j = 5\).
- Pour les valeurs suivantes de \(j\) (\(6, 7, 8, 9, 11\) ; \(j=10\) est sauté), le test est \(> 0\) donc rien ne change.
La fonction renvoie donc \(5\).
On peut maintenant combiner la fonction prochain_point avec la fonction
plus_bas de la question 1 pour calculer le bord de l'enveloppe convexe de \(P\).
On commence par insérer le point \(p_i\) d'ordonnée la plus basse, puis on itère le
processus de mise à jour du paquet cadeau jusqu'à ce
que le prochain point à insérer soit de nouveau \(p_i\). À ce moment-là on renvoie le
paquet cadeau comme résultat sans insérer \(p_i\) une seconde fois.
Un détail technique : comme la taille du paquet cadeau augmente peu à peu lors du processus, et qu'à la fin elle peut être petite par rapport au nombre \(n\) de points de \(P\), nous stockerons les indices des points du paquet cadeau dans un tableau de \(n\) entiers en renvoyant le nombre de points de l'enveloppe.
Par exemple, sur le nuage de la figure 1, on placera \(7, 11, 10, 5, 2, 0\) dans les cases 0 à 5 du tableau d'enveloppe, sans toucher aux cases 6 à 11 de ce tableau, et on renverra la valeur 6 correspondant au nombre de points.
Question 8. Écrire une fonction
int conv_jarvis(int tab[][2], int n, int *env);
qui prend en paramètre le tableau tab de
taille \(n\) représentant le nuage \(P\), un tableau de même taille env
et qui place dans env les indices
du bord de l'enveloppe convexe de \(P\), sans doublon, et renvoie le nombre de
points qui le constituent. Le temps d'exécution de votre fonction doit
être majoré par une constante fois \(nm\), où \(m\) est le nombre de points de \(P\) situés sur le bord de
\(Conv(P)\) (c'est la valeur renvoyée par la fonction).
Corrigé
int conv_jarvis(int tab[][2], int n, int *env)
{
    int taille = 1;
    env[0] = plus_bas(tab, n);

    int next = prochain_point(tab, n, env[0]);

    while (next != env[0])
    {
        env[taille] = next;
        taille += 1;
        next = prochain_point(tab, n, next);
    }

    return taille;
}
Question 9. Justifier brièvement le temps d'exécution de l'algorithme du paquet cadeau.
Corrigé
Si l'enveloppe convexe des \(n\) points en contient \(m\), on effectue
\(m\) appels à prochain_point qui fait chacun de l'ordre de \(n\)
opérations élémentaires. Donc le coût de la boucle est de l'ordre de \(mn\).
Le coût de l'initialisation avec plus_bas est de l'ordre de \(n\).
Donc conv_jarvis est de coût temporel de l'ordre de \(mn\), on notera
qu'il est en \(O(mn)\).
Intermède : piles d'entiers
Dans la suite nous aurons besoin d'utiliser des piles d'entiers, dont on donne la définition ci-dessous :
Définition 2
Une pile d'entiers est une structure de données permettant de stocker des entiers et d'effectuer les opérations suivantes en temps constant (indépendant de la taille de la pile) :
- créer une nouvelle pile vide,
- déterminer si la pile est vide,
- insérer un entier au sommet de la pile,
- déterminer la valeur de l'entier au sommet de la pile,
- retirer l'entier au sommet de la pile,
- détruire une pile existante.
Nous supposerons fournies les fonctions suivantes, qui réalisent les opérations ci-dessus et s'exécutent chacune en temps constant :
stack new_stack(void), qui ne prend pas d'argument et renvoie une pile vide,bool is_empty(stack s), qui prend une pilesen argument et renvoie la valeurtrueoufalsesuivant quesest vide ou non,void push(int i, stack s), qui prend un entieriet une pilesen argument, insèreiau sommet des(c'est-à-dire à la fin de la liste), et ne renvoie rien,int top(stack s), qui prend une piles(supposée non vide) en argument et renvoie la valeur de l'entier au sommet des(c'est-à-dire le dernier élément empilé),int pop(stack s), qui prend une piles(supposée non vide) en argument, supprime l'entier au sommet deset renvoie sa valeur,void destroy_stack(stack s), qui libère l'espace utilisé par la piles.
Dans la suite il est demandé aux candidats de manipuler les piles uniquement au travers de ces fonctions, sans aucune hypothèse sur la représentation effective des piles en mémoire.
Si on écrit
stack s = new_stack();
for (int i = 0; i < 3; i++)
{
    push(i, s);
    printf("%d\n", top(s));
}

for (int i = 0; i < 3; i++)
    printf("%d\n", pop(s));
destroy_stack(s);
on va alors afficher 0 1 2 à mesure qu'on empile, puis 2 1 0 en dépilant.
On vous donne ici une implémentation des piles d'entiers en C qui fonctionne
tant qu'on empile moins de N éléments où N est une constante qu'on peut adapter
à la pile considérée (le fameux stack overflow si on la dépasse !).
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h>
#include <assert.h>

int N = 100;
struct stack_t {
    int *elements;
    int size;
};
typedef struct stack_t *stack;

stack new_stack(void)
{
    stack s = malloc(sizeof(struct stack_t));
    s->elements = malloc(sizeof(int)*N);
    s->size = 0;
    return s;
}

bool is_empty(stack s)
{
    return s->size == 0;
}

void push(int i, stack s)
{
    assert(s->size < N);
    s->elements[s->size] = i;
    s->size = s->size+1;
}

int top(stack s)
{
    assert(s->size != 0);
    return s->elements[s->size-1];
}

int pop(stack s)
{
    int i = top(s);
    s->size = s->size - 1;
    return i;
}

void destroy_stack(stack s)
{
    free(s->elements);
    free(s);
}

int main(void)
{
    stack s = new_stack();
    for (int i = 0; i < 3; i++)
    {
        push(i, s);
        printf("%d\n", top(s));
    }

    for (int i = 0; i < 3; i++)
        printf("%d\n", pop(s));

    destroy_stack(s);
}
Algorithme de balayage
Cet algorithme a été proposé par R. Graham en 1972. Nous allons écrire la variante (plus simple) proposée par A. Andrew quelques années plus tard.
La première étape consiste à trier les \(n\) points du nuage \(P\) par ordre croissant d'abscisse, en conservant tous les points de même abscisse dans un ordre arbitraire.
Question 10. Parmi les algorithmes de tri que vous connaissez, mentionnez-en un qui a un temps d'exécution majoré par une constante fois \(n \log n\) sur les entrées de taille \(n\).
Corrigé
Le tri fusion.
À partir de maintenant, on supposera que les points fournis en entrée sont triés
par abscisse croissante, comme c'est le cas dans l'exemple du tableau
tab donné au début du sujet.
L'idée de l'algorithme est de balayer le nuage de points horizontalement de gauche à droite par une droite verticale, tout en mettant à jour l'enveloppe convexe des points de \(P\) situés à gauche de cette droite, comme illustré dans la figure 4.
Plus précisément, l'algorithme visite chaque point de \(P\) une fois, par ordre croissant d'abscisse
(donc par ordre croissant d'indice dans le tableau tab car celui-ci est trié).
À chaque nouveau point \(p_i\) visité, il met à jour le bord de l'enveloppe convexe du sous-nuage
\(\{p_0, \dots, p_i\}\)
situé à gauche de \(p_i\). On remarque que les points \(p_0\) et \(p_i\) sont sur ce bord, et on appelle
enveloppe
supérieure la partie du bord de \(Conv\{p_0, \dots, p_i\}\) située au-dessus de la droite passant par
\(p_0\) et \(p_i\) (\(p_0\) et \(p_i\) compris), et enveloppe inférieure la partie du
bord de \(Conv\{p_0, \dots , p_i\}\) située
au-dessous (\(p_0\) et \(p_i\) compris). Le bord de \(Conv\{p_0, \dots, p_i\}\)
est donc constitué de l'union de ces
deux enveloppes, après suppression des doublons de \(p_0\) et \(p_i\).
Par exemple, dans le cas du nuage \(P\) de la figure 4 gauche, le sous-nuage \(\{p_0, p_1, p_2, p_3, p_4\}\) a pour enveloppe supérieure la séquence \((p_0, p_2, p_4)\) et pour enveloppe inférieure la séquence \((p_0, p_3, p_4)\), le bord de son enveloppe convexe étant donné par la séquence \((p_0, p_3, p_4, p_2)\).
Informatiquement, les indices des sommets des enveloppes inférieure et supérieure seront stockés dans deux piles d'entiers séparées, \(ei\) (pour enveloppe inférieure) et \(es\) (pour enveloppe supérieure).
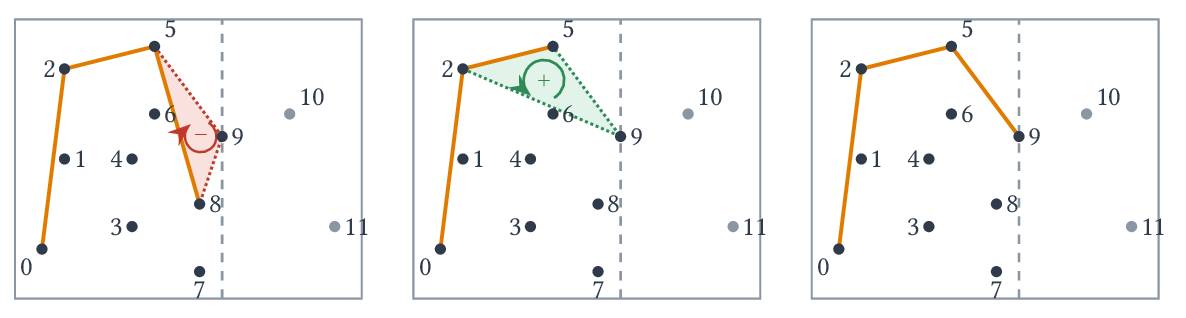
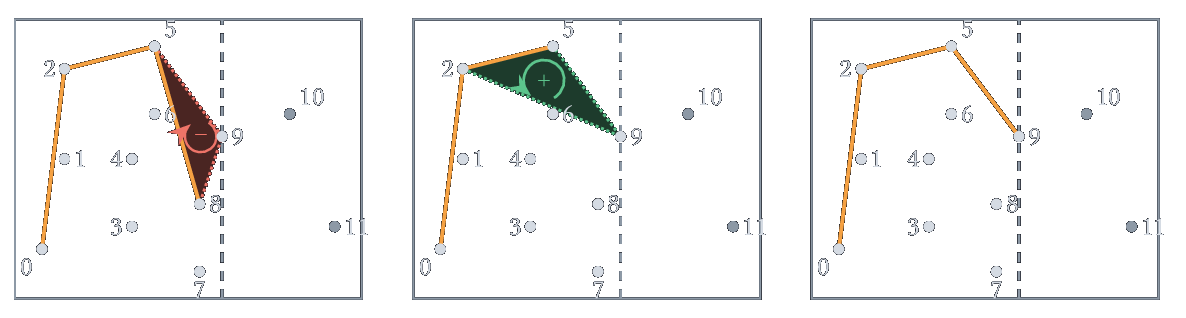
La mise à jour de l'enveloppe supérieure est illustrée dans la figure 5 : tant que le point visité (\(p_9\) dans ce cas) et les deux points dont les indices sont situés au sommet de la pile \(es\) (dans l'ordre : \(p_8\) et \(p_5\)) forment une séquence \((p_9, p_8, p_5)\) d'orientation négative (voir la définition 1 pour rappel de l'orientation), on dépile l'indice situé au sommet de \(es\) (8 dans ce cas). On poursuit ce processus d'élimination jusqu'à ce que l'orientation devienne positive ou qu'il ne reste plus qu'un seul indice dans la pile. L'indice du point visité (\(p_9\) dans ce cas) est alors inséré au sommet de \(es\). La mise à jour de l'enveloppe inférieure s'opère de manière symétrique.
Question 11. Écrire une fonction
void maj_es(int tab[][2], stack es, int i);
qui prend en paramètre le tableau tab ainsi
que la pile es, non vide, et l'indice \(i\) du point à visiter, et qui met à jour
l'enveloppe supérieure du
sous-nuage. Le temps d'exécution de votre fonction doit être majoré par une constante fois \(i\).
Corrigé
void maj_es(int tab[][2], stack es, int i)
{
    int j = pop(es);
    while (!is_empty(es) && orient(tab, i, j, top(es)) <= 0)
    {
        j = pop(es);
    }
    push(j, es);
    push(i, es);
}
Question 12. Écrire une fonction
void maj_ei(int tab[][2], stack ei, int i);
qui effectue la mise à jour de l'enveloppe inférieure, avec le même temps d'exécution.
Corrigé
void maj_ei(int tab[][2], stack ei, int i)
{
    int j = pop(ei);
    while (!is_empty(ei) && orient(tab, i, j, top(ei)) >= 0)
    {
        j = pop(ei);
    }
    push(j, ei);
    push(i, ei);
}
Question 13. Écrire maintenant une fonction
stack conv_graham(int tab[][2], int n);
qui prend en paramètre le tableau tab de
taille \(n\) représentant le nuage \(P\), et qui effectue le balayage des
points de \(P\) comme décrit précédemment. On supposera le tableau tab déjà trié par ordre
croissant d'abscisse. La pile renvoyée devra contenir les indices des sommets du
bord de \(Conv(P)\) triés dans l'ordre positif d'orientation, à commencer par le
point \(p_0\).
Corrigé
stack conv_graham(int tab[][2], int n)
{
    stack es = new_stack();
    stack ei = new_stack();

    push(0, es);
    push(0, ei);

    for (int i = 1; i < n; i++)
    {
        maj_es(tab, es, i);
        maj_ei(tab, ei, i);
    }

    pop(es); // dernier sommet en commun
    while (!is_empty(es))
        push(pop(es), ei);
    pop(ei); // premier sommet en commun

    destroy_stack(es);
    return ei;
}
Par exemple, sur le nuage de la figure 1, le résultat de la fonction
conv_graham doit être la
pile env contenant la suite d'indices 0, 7, 11, 10, 5, 2 dans cet ordre,
l'indice 0 se trouvant au fond de la pile env et l'indice 2 au sommet de
env.
Question 14. Analyser brièvement le temps d'exécution de l'algorithme de balayage décrit précédemment, en supposant une fois encore que les points du nuage fourni en entrée sont déjà triés par abscisse croissante. En déduire que le temps d'exécution total de l'algorithme de Graham-Andrew est bien majoré par une constante fois \(n \log n\).
Corrigé
Les seules opérations significatives ici sont les opérations manipulant les
piles. L'algorithme effectue de l'ordre de \(n\) opérations élémentaires car chaque
point est ajouté et retiré au plus une fois dans chaque pile (chaque tour de la boucle
while de maj_es ou maj_ei dépile un indice qui avait été empilé auparavant).
Si on considère le tri initial, on effectue donc de l'ordre de \(n \log n\) opérations élémentaires. On dira que l'algorithme est en \(O(n \log n)\).
Remarque
Pour un nuage de points proche de son enveloppe convexe, cet algorithme est bien plus efficace que celui de Jarvis. Cas dégénéré pour Jarvis : \(n\) points sur un cercle, donc qui sont tous sur le bord de leur enveloppe convexe. Jarvis sera quadratique (en \(n^2\)) alors que Graham est quasi-linéaire (en \(n \log n\)).