Mines 2023 - Épreuve 2
Sujet
Corrigé partiel (questions 1 à 23 sur 38) de la deuxième épreuve d'informatique de la filière MPI du concours Mines-Ponts 2023, consacrée à la complexité de Kolmogoroff (sujet du Concours commun Mines-Ponts, sous licence CC BY-NC-ND 3.0 FR, propriété du GIP CCMP). L'énoncé n'est pas reproduit ici : seules les réponses figurent, avec les numéros de questions du sujet. Le code est en OCaml.
On rappelle seulement les notations : \(K(y)\) est la longueur de la plus
courte chaîne x dont l'évaluation comme code OCaml renvoie la chaîne y, et
\(y_0\) est l'écriture décimale de \(10^{\left(10^{10}\right)}\), un 1 suivi de
\(10^{10}\) zéros.
Complexité de Kolmogoroff
Un premier exemple
Question 1.
Corrigé
La chaîne \(y_0\) comporte \(10^{10} + 1\) caractères. La description \(x_0\) est le littéral de chaîne correspondant, guillemets compris, donc \(|x_0| = |y_0| + 2\) et on a ainsi \(K(y_0) \le |x_0| = 10^{10} + 3\) (attention à ne pas oublier les guillemets).
Plus généralement, si \(y\) est une chaîne de longueur \(n\) (sans caractère à échapper), on a \(K(y) \le 2+n\).
Question 2.
Corrigé
En notant \(n' = \lfloor n/2 \rfloor\), on a
La question met sur la voie d'une implémentation récursive non terminale, mais
l'absence du rec dans le code fourni par l'énoncé fait douter. Je le fais
ainsi dans la mesure où l'hypothèse de mémoire infinie devrait se transmettre
à la capacité de la pile d'appels. On aurait souhaité que le sujet soit plus
précis ici car c'est un élément important d'OCaml : on pouvait très bien
supposer une mémoire infinie mais une pile bornée.
let rec exp10 n =
  if n = 0
  then 1
  else let x = exp10 (n/2) in
    if n mod 2 = 0 then x * x else 10 * x * x
in string_of_int (exp10 (exp10 10))
Écrit sur une seule ligne et sans espace superflu, ce programme fait 121 caractères :
let rec exp10 n=if n=0 then 1 else let x=exp10(n/2)in if n mod 2=0 then x*x else 10*x*x in string_of_int(exp10(exp10 10))
On peut donc affirmer \(K(y_0) \le 121\), de l'ordre de \(10^2\), ce qui est considérablement mieux que la borne \(10^{10} + 3\) de la question 1.
Question 3.
Corrigé
La récursivité non terminale n'est pas un problème ici : exp10 divise son
argument par deux à chaque appel, la profondeur de récursion est donc
d'environ \(\log_2(10^{10}) \approx 34\). En revanche, l'utilisation des entiers
en OCaml rend ce calcul très vite inexact quand on va dépasser la capacité
maximale d'un entier machine (pas la peine de parler du bit réservé aux
unboxed int) : les calculs se font modulo \(2^{63}\) et, comme \(2^{63}\) divise
\(10^{k}\) dès que \(k \ge 63\), le programme renvoie en pratique la chaîne "0".
Même avec des entiers de taille arbitraire, le résultat comporterait \(10^{10}+1\) chiffres, soit une dizaine de gigaoctets, et son calcul demanderait beaucoup de temps et de mémoire.
Quelques propriétés
Question 4.
Corrigé
On peut identifier un caractère à un chiffre en base 256 ; ainsi, chaque entier non nul sera représenté par son écriture propre en base 256 (chiffre de poids faible en premier). Pour 0, il suffit de le représenter par la chaîne vide. On a naturellement une bijection, par unicité de l'écriture en base 256, avec les écritures propres, c'est-à-dire ne terminant pas par le caractère 0.
Cela pose un problème ici, car on veut toutes les chaînes, même celles finissant par le caractère 0. Pour résoudre cela, en notant \(c_k\) le \(k\)-ième caractère de \(\Sigma\) pour \(k \in \range{0}{255}\), on considère une version modifiée
C'est une bijection : toute chaîne non vide s'écrit de manière unique \(c_a \cdot s\) avec \(a \in \range{0}{255}\) et \(s \in \Sigma^*\), et \(n \mapsto ((n-1) \bmod 256, \lfloor (n-1)/256 \rfloor)\) est une bijection de \(\N^*\) sur \(\range{0}{255} \times \N\). Par récurrence sur la longueur, la réciproque est donnée par \(\varphi^{-1}(\text{""}) = 0\) et \(\varphi^{-1}(c_a \cdot s) = 1 + a + 256\, \varphi^{-1}(s)\).
Le code OCaml correspondant est :
let rec phi n =
  if n = 0
  then ""
  else String.make 1 (Char.chr ((n-1) mod 256)) ^ phi ((n-1) / 256)
Question 5.
Corrigé
Le code est :
let psi m =
  let rec cherche n =
    if kolmogoroff (phi n) >= m
    then n
    else cherche (n+1)
  in cherche 0
La recherche termine : il n'y a qu'un nombre fini de chaînes de longueur \(< m\), donc un nombre fini de chaînes \(y\) telles que \(K(y) < m\), et \(\varphi\) est une bijection.
Question 6.
Corrigé
Soit \(m \in \N\), on a \(\psi(m) \in \enscomp{ n \in \N}{K(\varphi(n)) \ge m}\) donc \(K(\varphi(\psi(m))) \ge m\).
On peut considérer le code
let kolmogoroff y = <code de kolmogoroff> in
let rec phi n = <code de phi> in
let psi m = <code de psi> in
phi (psi <m>)
où <m> est une représentation décimale de \(m\). Ce code est une description
de \(\varphi(\psi(m))\) de longueur \(c + \lfloor \log_{10} m \rfloor + 1\), où la
constante \(c\) ne dépend pas de \(m\) : on a donc
\(K(\varphi(\psi(m))) = O(\log m)\).
Par majoration, on en déduit \(m = O(\log m)\), ce qui est impossible. La seule
hypothèse ayant été l'existence de kolmogoroff, on en déduit qu'une telle
fonction ne peut exister.
Question 7.
Corrigé
Il s'agit d'un compilateur. On parle parfois de transpileur dans ce contexte source vers source.
Remarque
C'est un peu étonnant de ne pas avoir d'hypothèse ici sur l'existence d'une
description. Vu l'énoncé, la fonction let d x = "argh" est un décompresseur
qui n'admet de description que pour une seule chaîne.
Question 8.
Corrigé
On peut considérer le programme suivant :
let decompresseur x = <code du decompresseur>
in decompresseur "<z>"
où <z> est une description minimale de y par rapport à \(D\), en supposant
que cela existe (sinon \(K_D(y) = +\infty\) et il n'y a rien à montrer).
On a alors un code de longueur \(K_D(y) + c_D\) avec \(c_D\) la longueur du reste
du code, guillemets compris, qui ne dépend pas de z, et donc pas de y.
Ainsi, \(K(y) \le K_D(y) + c_D\).
On suppose ici, comme à la question 1, que z s'écrit tel quel entre
guillemets. Si z contient des guillemets ou des \, il faut les échapper
(\" et \\), ce qui peut doubler sa longueur : on obtient seulement
\(K(y) \le 2 K_D(y) + c_D\) dans le pire cas. L'énoncé néglige visiblement ce
point.
Estimation de la complexité grâce au décompresseur de Huffman
Question 9.
Corrigé
On réécrit avec des sauts de ligne et des indentations pour une meilleure lisibilité :
let rec t e =
  if e = 0
  then 1
  else let n = e - 1 in
    10 * t n
in
let n = t 10 in
t n
On remarque tout de suite avec le cas de base que t : int -> int et donc
l'expression t n est de type int.
Question 10.
Corrigé
La fonction t effectue un calcul naïf de \(10^n\), on renvoie donc
\(10^{\left(10^{10}\right)}\).
Question 11.
Corrigé
Impénétrable ? Ça se voit que le rédacteur ne corrige pas souvent des copies d'élèves de prépa, ça me semble très compréhensible.
Pour une réponse sérieuse : la nomenclature des fonctions et variables (noms
d'une lettre, n utilisé pour deux variables différentes), et l'absence de
sauts de ligne et d'indentation.
Question 12.
Corrigé
Le code OCaml :
let count x =
  let occ = Hashtbl.create 256 in
  for i = 0 to String.length x - 1 do
    Hashtbl.add occ x.[i]
      (1 + match Hashtbl.find_opt occ x.[i] with
           | None -> 0
           | Some k -> k)
  done;
  occ
Remarque
Le but ici était d'évaluer votre pratique des tables de hachage, mais avec des caractères, autant faire un tableau de 256 cases.
Par contre, l'usage de add (la seule fonction d'ajout rappelée par
l'énoncé) et non de replace va conserver les associations précédentes :
find_opt renvoie bien la plus récente, donc le bon nombre d'occurrences,
mais la table de hachage sera de taille \(|x|\) et non bornée par 256.
Question 13.
Corrigé
Un arbre est donné ici, je n'ai pas respecté la consigne car je ne l'ai pas fait à la main...
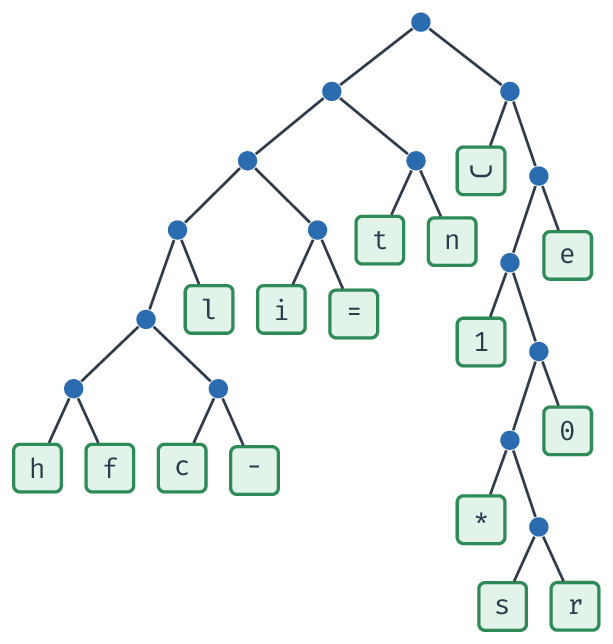
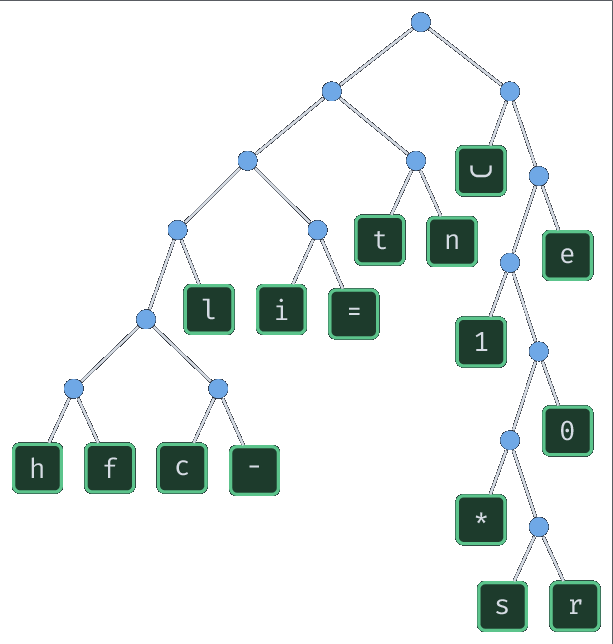
La feuille ␣ correspond au caractère espace. En lisant un 0 pour une branche
gauche et un 1 pour une branche droite, la profondeur d'une feuille est la
longueur du code de son caractère : 2 pour l'espace, 3 pour t, n et e,
4 pour l, i, = et 1, 5 pour 0, 6 pour h, f, c, - et *,
7 pour s et r.
Question 14.
Corrigé
On a \(|z_0| = \sum_{c} |x_0|_c \, \mathrm{prof}(c) = 239\) où \(\mathrm{prof}(c)\) est la profondeur de la feuille \(c\) dans l'arbre : avec les occurrences données par l'énoncé, \(19 \times 2 + (8 + 8 + 10) \times 3 + (4 + 4 + 4 + 4) \times 4 + 3 \times 5 + 5 \times 6 + 2 \times 7 = 239\).
Comme \(H(z_0) = y_0\), on a alors directement \(K_H(y_0) \le 239\) avec cette description, mais c'est un peu étonnant comme choix de placer l'arbre dans \(H\), car \(H\) dépend de \(y_0\).
Interlude
Question 15.
Corrigé
On reproduit le code :
let inc s = s := "a" ^ (!s); !s

let new_string1 =
  let seed1 = ref "#" in
  fun () -> inc seed1

let new_string2 () =
  let seed2 = ref "#" in
  inc seed2

let seed3 = ref "#"
let new_string3 () =
  inc seed3
La portée d'une variable est la partie du programme où son nom est accessible ; il ne faut pas la confondre avec la durée de vie en mémoire de la valeur qu'elle désigne.
La portée de seed1 est la fonction anonyme fun () -> inc seed1 : seed1
est inaccessible ailleurs. Mais la référence reste vivante dans la clôture de
la fonction anonyme, pendant tout le reste du programme : elle est créée une
seule fois, à la définition de new_string1, et partagée par tous les appels.
Dans new_string2, la variable seed2 n'existe que dans le corps de la
fonction et une nouvelle référence est créée à chaque appel : sa portée, comme
sa durée de vie, s'arrête à la fin de l'appel.
Pour seed3, elle est définie globalement et est donc vivante et
accessible tout au long du programme à partir de sa définition.
Question 16.
Corrigé
La fonction new_string2 est constante (elle renvoie toujours "a#") comme
on l'a expliqué précédemment : elle ne respecte pas la spécification. Un test
pourrait être :
let test_non_constante f =
  f () <> f ()
qui renvoie true pour new_string1 et new_string3 et false pour
new_string2.
Question 17.
Corrigé
En exposant la variable seed3, on prend le risque qu'elle soit modifiée en
dehors de new_string3, ce qui pourrait modifier son comportement :
new_string1 est donc préférable.
Par exemple :
let () =
  let x = new_string3 () in
  seed3 := "#";
  let y = new_string3 () in
  (* ici x = y car on a réinitialisé seed3 *)
  assert (x = y)
(si c'est le premier appel à new_string3, sinon x vaut "aa…a#").
Estimation de la complexité grâce au décompresseur de De Bruijn
Construction syntaxique d'un langage
Question 18.
Corrigé
On peut considérer \((a|b)^* \sharp\).
Question 19.
Corrigé
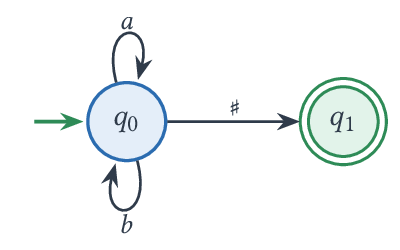
On linéarise l'expression en \((a_1|b_2)^* \sharp_3\). Les premières lettres sont \(a_1\), \(b_2\) et \(\sharp_3\), la seule dernière lettre est \(\sharp_3\), et les facteurs de longueur 2 sont \(a_1a_1\), \(a_1b_2\), \(b_2a_1\), \(b_2b_2\), \(a_1\sharp_3\) et \(b_2\sharp_3\). L'automate de Glushkov a donc quatre états : l'état initial \(0\) et un état par lettre linéarisée, \(\sharp_3\) étant le seul état final.
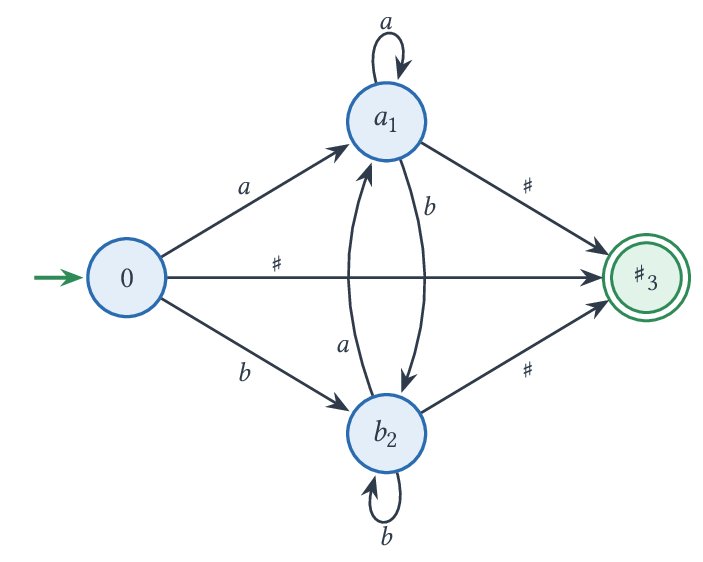
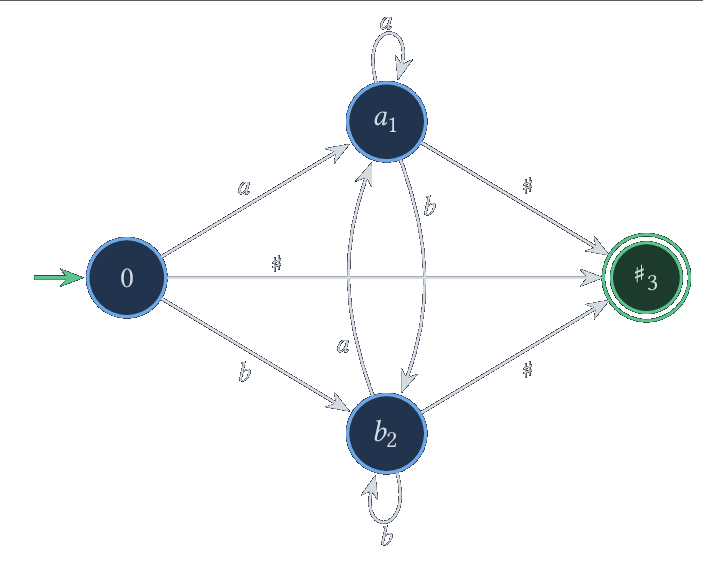
La précision sur Glushkov est un peu étonnante vu l'expression régulière élémentaire : les états \(0\), \(a_1\) et \(b_2\) ont exactement les mêmes transitions sortantes et ne sont pas finaux. En les fusionnant, on obtient l'automate suivant, qui convient aussi :
Question 20.
Corrigé
Le code OCaml :
exception SyntaxError

let rec parseV w =
  match w with
  | 'b' :: q
  | 'a' :: q ->
    let v, s = parseV q in
    (String.make 1 (List.hd w) ^ v, s)
  | '#' :: q -> ("#", q)
  | _ -> raise SyntaxError
Question 21.
Corrigé
L'indication du sujet est étrange, on parle d'induction structurelle sur deux nombres ?
Pour un mot \(u\), notons \(h(u) = |u|_( - |u|_)\) le nombre de parenthèses ouvrantes moins le nombre de parenthèses fermantes.
Lemme. Pour tout \(w \in L(G_1)\), on a \(h(w) = 0\), tout préfixe \(u\) de \(w\) vérifie \(h(u) \ge 0\), et tout préfixe non vide et strict \(u\) de \(w\) vérifie \(h(u) \ge 1\).
On le montre par récurrence forte sur la longueur de $w$ (c'est une induction
structurelle sur la dérivation).

* Si $w = \_$, on a $h(w) = 0$ et $w$ n'a pas de préfixe non vide strict.
* Sinon $w = (w_1 w_2)$ avec $w_1, w_2 \in L(G_1)$ plus courts. On a
    $h(w) = 1 + 0 + 0 - 1 = 0$. Un préfixe non vide strict $u$ de $w$ s'écrit
    $u = (v$ où $v$ est un préfixe de $w_1 w_2$ (le dernier caractère `)` de
    $w$ n'est pas dans $u$). Soit $v$ est un préfixe de $w_1$, et
    $h(v) \ge 0$ par hypothèse de récurrence ; soit $v = w_1 v'$ avec $v'$
    préfixe de $w_2$, et $h(v) = 0 + h(v') \ge 0$. Dans les deux cas,
    $h(u) = 1 + h(v) \ge 1$.

Soient alors $w, w' \in L(G_1)$ non vides avec $w$ préfixe strict de $w'$. Par
le lemme appliqué à $w'$, on aurait $h(w) \ge 1$, alors que $h(w) = 0$ :
c'est absurde. Le langage $L(G_1)$ est donc sans préfixe.
Question 22.
Corrigé
On montre par récurrence forte sur \(|w|\) que tout mot \(w \in L(G_1)\) admet un unique arbre d'analyse.
* Si $w$ commence par `_`, la première règle appliquée ne peut être que
    $T \rightarrow \_$ (l'autre produit un mot commençant par `(`), donc
    $w = \_$ et l'arbre est une feuille.
* Si $w$ commence par `(`, la première règle appliquée est forcément
    $T \rightarrow (TT)$ et $w = (w_1 w_2)$ avec $w_1, w_2 \in L(G_1)$. Cette
    décomposition est unique : si $w_1 w_2 = w_1' w_2'$ avec
    $w_1, w_1', w_2, w_2' \in L(G_1)$, alors l'un des mots $w_1$, $w_1'$ est
    préfixe de l'autre ; ces mots étant non vides, la question 21 impose
    $w_1 = w_1'$, puis $w_2 = w_2'$. Par hypothèse de récurrence, $w_1$ et
    $w_2$ ont un unique arbre d'analyse, donc $w$ aussi.

Attention, `_` est ici un symbole terminal et non le mot vide : avec une
règle $T \rightarrow \varepsilon$, le langage ne serait plus sans préfixe.
Question 23.
Corrigé
Il s'agit de la grammaire du \(\lambda\)-calcul : var->T est une abstraction et
(T T) une application.
Ici var et -> sont des symboles terminaux (de longueur 1). Le langage
\(L(G_2)\) n'est plus sans préfixe (var est préfixe de var->var), il faut
donc adapter l'argument précédent.
*Lemme.* Si $u, u' \in L(G_2)$ et $u$ est un préfixe strict de $u'$, alors le
symbole qui suit $u$ dans $u'$ est `->`.

On reprend la fonction $h$ de la question 21 : comme précédemment, tout mot
de $L(G_2)$ vérifie $h = 0$, ses préfixes vérifient $h \ge 0$, et les
préfixes non vides stricts d'un mot de la forme $(t_1 t_2)$ vérifient
$h \ge 1$ (la règle `var->T` n'ajoute pas de parenthèse). On montre alors le
lemme par récurrence forte sur $|u'|$ :

* si $u' = \texttt{var}$, il n'a pas de préfixe strict non vide, or $u$ est non vide ;
* si $u' = (t_1 t_2)$, alors $h(u) \ge 1$, ce qui contredit $u \in L(G_2)$ :
    ce cas n'arrive pas ;
* si $u' = \texttt{var->}t$, alors $u$ commence par `var` : soit $u = \texttt{var}$,
    suivi de `->` dans $u'$ ; soit $u = \texttt{var->}v$ avec $v \in L(G_2)$
    préfixe strict de $t$ (un mot de $L(G_2)$ ne se termine jamais par `->`,
    donc $u \neq \texttt{var->}$), et par hypothèse de récurrence $v$ est suivi de
    `->` dans $t$, donc $u$ aussi dans $u'$.

*Non-ambiguïté.* On procède par récurrence forte sur la longueur d'un mot
$w \in L(G_2)$.

* Si $w$ commence par `var`, la première règle est $T \rightarrow \texttt{var}$ si
    $w = \texttt{var}$, et $T \rightarrow \texttt{var->}T$ sinon ; dans ce second cas
    $w = \texttt{var->}w'$ avec $w'$ unique, qui a un unique arbre par hypothèse
    de récurrence.
* Si $w$ commence par `(`, la première règle est $T \rightarrow (TT)$ et
    $w = (w_1 w_2)$. Si $w_1 w_2 = w_1' w_2'$ avec $w_1 \neq w_1'$, l'un, par
    exemple $w_1$, est préfixe strict de l'autre, et par le lemme le symbole
    suivant, qui est le premier symbole de $w_2$, est `->`. Or un mot de
    $L(G_2)$ commence par `var` ou `(` : c'est absurde. La décomposition est
    donc unique et on conclut par hypothèse de récurrence.