Structure de données abstraite d'ensembles disjoints
Objectif et définition
On cherche à réaliser une structure permettant de manipuler des ensembles disjoints de manière dynamique, c'est-à-dire en fusionnant des ensembles à la volée.
La structure abstraite union-find est ainsi définie par :
- un type
'a ufpour manipuler la collection d'ensembles dont les éléments sont de type'a. - une opération
makesetqui étant donné un élément \(x\) va rajouter \(\{ x\}\) à la collection. - une opération
findqui associe à chaque élément \(x\), l'ensemble qui le contient dans la collection. - une opération
unionqui fusionne deux ensembles disjoints, le plus souvent donnés par des éléments qu'ils contiennent, donc implicitement en utilisantfind.
Exemple emblématique d'utilisation
On considère le problème déjà vu du calcul des composantes connexes d'un graphe, mais avec le graphe donné à la volée, arête après arête, par exemple lors d'un téléchargement.
La solution qu'on connaît consiste à itérer des parcours quelconques d'un sommet non découvert, à chaque parcours on calcule une nouvelle composante connexe. Cet algorithme est ainsi en \(O(|S|+|A|)\), donc linéaire, ce qui est a priori très satisfaisant.
Cependant, si on rajoute une arête, on change la nature des composantes et il est nécessaire de refaire un parcours.
Avec une structure union-find, on peut procéder ainsi :
- on appelle
makesetpour chaque sommet - pour chaque arête \((x,y)\) où \(find(x) \neq find(y)\), on appelle \(union(x, y)\).
Si jamais une nouvelle arête est à considérer, il suffit d'appeler union.
Pour \(n\) éléments dans tous les ensembles, si on suppose que la complexité
est \(m(n)\) pour makeset, \(u(n)\) pour union et \(f(n)\) pour find, on a
alors une complexité du calcul en \(O(m(|S|)|S|+(f(|S|)+u(|S|))|A|)\).
Pour que cet algorithme soit intéressant, il faut que cette complexité soit proche de la précédente. Cela signifie que les trois fonctions devraient être en \(O(1)\) ou presque.
Classe d'équivalence et représentant
On peut définir une relation d'équivalence sur les éléments en posant :
Les ensembles sont alors des classes d'équivalence dont il suffit de donner un
représentant pour les retrouver. Ainsi, find pourra se contenter de renvoyer
un représentant sous réserve que find(x) et find(y) renvoient le même
quand \(x \sim y\).
Remarque
Comme on l'a vu en mathématiques, on peut toujours représenter une classe de congruence modulo \(p\) avec un représentant dans \(\range{0}{p-1}\).
Implémentation naïve : listes chaînées
Première implémentation
On peut représenter chaque élément par un maillon et chaque ensemble par une liste chaînée. Le dernier maillon de chaque liste correspondra alors à l'élément distingué qui représente l'ensemble.
Plus précisément :
makesetcrée un maillon \(O(1)\)- pour pouvoir manipuler directement des maillons depuis leurs valeurs, il peut être nécessaire de maintenir un dictionnaire permettant d'associer à une valeur son maillon, on peut le faire en \(O(1)\) avec des tables de hachage (en moyenne).
findva descendre le long de la liste correspondant à l'ensemble pour déterminer le maillon final. En pire cas, il faut parcourir toute la liste, c'est donc en \(O(n)\) où \(n\) est le nombre total d'éléments.uniondoit réaliser une concaténation de listes, ce qui est en \(O(n)\) en pire cas.
Quick-find
On peut améliorer les performances de find en rajoutant un pointeur direct
depuis chaque maillon vers le maillon final de la liste qui les contient.
L'opération find est alors en \(O(1)\). Cependant union sera en \(O(n)\), même
en faisant en sorte d'avoir une concaténation rapide comme expliqué dans le
paragraphe suivant, car il faut maintenir les pointeurs vers le maillon final.
Cette implémentation est en général dénommée Quick-find car find est
rapide.
Quick-union
On peut faire en sorte que l'union soit rapide en faisant en sorte que le maillon distingué pointe sur le premier et dernier maillon de chaque liste. Ainsi, pour l'union, il suffit de faire un nombre constant d'opérations.
Attention, cela suppose ici que union ne va pas réaliser des find, qui
eux, resteront coûteux.
Implémentation efficace
Forêt disjointe
On va représenter une structure union-find par une forêt d'arbres dont les étiquettes sont toutes distinctes. Chaque arbre représentera alors l'ensemble des valeurs de ses étiquettes et la forêt sera naturellement une représentation d'une collection d'ensembles disjoints.
On peut alors identifier une valeur au nœud de l'arbre dont c'est l'étiquette et naïvement effectuer les opérations :
makesetcrée un arbre avec une feuille et le rajoute à la forêt, ce qui se fait en temps constant en supposant que la forêt est une liste d'arbresfindva remonter du nœud vers sa racine et renvoyer sa racine, ce qui est en \(O(h)\) où \(h\) est la hauteur de la forêt, c'est-à-dire la plus grande hauteur des arbres qu'elle contient.unionva supprimer deux arbres et les remplacer par un unique arbre ; la racine de l'un devient un enfant de la racine de l'autre. Ci-dessous,union(x, y)où \(x\) et \(y\) sont des racines :
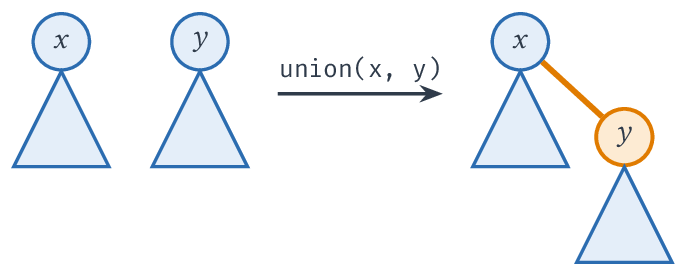
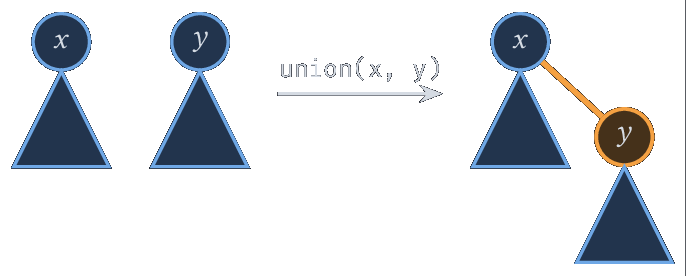
Ainsi, union est naturellement en \(O(1)\) sous réserve de partir des racines.
On retrouve donc la même complexité que Quick-union avec les listes
chaînées pour union, et find est en \(O(h)\).
Cependant, il est possible d'avoir des arbres très profonds et en pire cas,
find est en \(O(n)\) où \(n\) est le nombre d'éléments.
Remarque
Si on considère les entiers de \(0\) à \(n\) et que union(x, y) place la
racine de l'arbre de \(y\) comme enfant de la racine de l'arbre de \(x\) (comme
sur la figure), la suite d'unions \((1,0), (2,0),
\dots, (n, 0)\) va créer un peigne avec \(n\) à la racine et une unique branche
\(0 \to 1 \to \dots \to (n-1) \to n\) (où \(x \to y\) signifie que \(y\) est le
père de \(x\)) donc \(0\) est à profondeur \(n\) et ainsi
\(find(0)\) devra remonter les \(n\) arêtes. Comme chaque union(i, 0) commence
par un find(0) qui remonte \(i - 1\) arêtes, cette suite d'opérations coûte
au total \(\Theta(n^2)\).
Union pondérée
Quand on réalise une union, on a deux choix sur qui sera la racine de l'arbre fusionné. Si on s'assure de toujours faire le choix qui minimise la hauteur, on peut garantir que la forêt soit de hauteur en \(O(\log n)\).
Calculer les tailles ou les hauteurs de chaque arbre n'est pas utile, on peut se contenter de définir le rang d'un arbre noté \(rg(a)\) :
- au départ, chaque feuille est de rang 0
- quand on réalise une union entre deux arbres \(a\) et \(a'\)
- si \(rg(a) > rg(a')\) on n'a pas intérêt à placer \(a\) plus profondément donc on rajoute \(a'\) comme enfant de la racine de \(a\) et on préserve les rangs
- sinon, on fait la fusion dans l'autre sens et dans le cas où les deux rangs étaient égaux, on augmente le rang de \(a'\) de 1.
Ainsi, les rangs indiquent le nombre de fusions successives qui ont augmenté la hauteur : en l'absence d'autre modification des arbres, le rang d'un arbre est exactement sa hauteur (on le vérifie par récurrence sur le nombre d'unions : si \(rg(a) > rg(a')\), la hauteur de l'arbre fusionné est \(\max(h(a), h(a') + 1) = h(a)\) car \(h(a') + 1 \le h(a)\) ; si les rangs sont égaux à \(r\), elle vaut \(r + 1\)).
Théorème
Avec l'union par rang, un arbre de rang \(r\) possède au moins \(2^r\) nœuds.
En conséquence, pour \(n\) éléments, tout arbre est de rang, donc de hauteur,
au plus \(\log_2 n\), et find et union sont en \(O(\log n)\) dans le pire
cas.
Preuve
Par récurrence sur le nombre d'opérations. Au départ, chaque arbre est une feuille de rang \(0\) ayant \(1 = 2^0\) nœud. Lors d'une union de \(a\) et \(a'\) :
- si \(rg(a) \neq rg(a')\), le rang de l'arbre obtenu est \(\max(rg(a), rg(a'))\) et il contient plus de nœuds que l'arbre de plus grand rang, donc au moins \(2^{\max(rg(a), rg(a'))}\) nœuds par hypothèse de récurrence ;
- si \(rg(a) = rg(a') = r\), l'arbre obtenu est de rang \(r + 1\) et contient au moins \(2^r + 2^r = 2^{r+1}\) nœuds.
Les autres arbres ne sont pas modifiés. Comme un arbre a au plus \(n\) nœuds,
on en déduit \(2^r \le n\), soit \(r \le \log_2 n\). Le rang étant égal à la
hauteur, find est en \(O(\log n)\), et union, qui fait deux find puis
un nombre constant d'opérations, aussi.
Compression de chemins
La structure de l'arbre est souvent inintéressante, on peut donc se permettre
de la supprimer et d'aplatir les arbres. Pour cela, si la parenté est déterminée
par un tableau parent avec parent[x] = x à la racine, on peut procéder récursivement pour find :
Calcul de find(x)
- Si
x\(\neq\)parent[x]parent[x] = find(parent[x])
- Renvoyer
parent[x]
Ainsi, après un appel à find(x), chaque nœud du chemin de x à la racine
pointe directement vers la racine. Cela revient à aplatir le chemin parcouru :
tous ses nœuds deviennent des enfants de la racine. On parle de compression de
chemins puisque ces chemins, qui seront de nouveau parcourus lors des appels
suivants, deviennent de longueur \(1\).
La compression de chemins ne modifie pas les rangs : le rang d'un arbre n'est alors plus égal à sa hauteur, mais en reste un majorant, et le théorème précédent reste valable (les nombres de nœuds des arbres ne changent pas).
Théorème (Tarjan, admis)
Avec l'union par rang et la compression de chemins, une suite de \(m\)
opérations makeset, find et union, dont \(n\) opérations makeset,
s'exécute dans le pire cas en \(O(m \, \alpha(n))\), où \(\alpha\) est la
réciproque de la fonction d'Ackermann. Autrement dit, chaque opération est
en \(O(\alpha(n))\) en complexité amortie.
La fonction \(\alpha(n)\) croît tellement lentement que \(\alpha(n) \le
4\) pour \(n \le 10^{80}\) : en pratique, les opérations sont en temps constant
amorti. Il s'agit bien d'une complexité amortie (sur une suite d'opérations dans
le pire cas) et non d'une complexité en moyenne : un find isolé peut coûter
\(\Theta(\log n)\).
Implémentation en C avec un tableau parent
Remarque
Cette implémentation peut également se faire
facilement avec OCaml.
On va considérer que les éléments sont les entiers de \(0\) à \(n-1\) et on va
représenter la forêt par un tableau parent où parent[x] indique le père de
\(x\) si \(x\) n'est pas une racine, et parent[x] = x pour les racines.
Remarque
On peut donc tester si un élément est la racine d'un arbre en \(O(1)\).
On va représenter la forêt par le type suivant :
#include <stdlib.h>
#include <assert.h>

struct union_find {
    int *parent;
    int *rang;
    int nelements;
};
typedef struct union_find union_find;
Pour commencer, on crée une forêt de feuilles qui sont toutes de rang 0.
union_find uf_makesets(int n)
{
    union_find uf;
    uf.parent = malloc(sizeof(int) * n);
    uf.rang = malloc(sizeof(int) * n);
    for(int i = 0; i < n; i++)
    {
        uf.parent[i] = i;
        uf.rang[i] = 0;
    }
    uf.nelements = n;
    return uf;
}
On implémente alors directement find et union, en prenant garde au fait que
union est un mot-clé en C :
int uf_find(union_find uf, int x)
{
    if (uf.parent[x] != x)
        uf.parent[x] = uf_find(uf, uf.parent[x]);
    return uf.parent[x];
}
void uf_union(union_find uf, int x, int y)
{
    int rx = uf_find(uf, x);
    int ry = uf_find(uf, y);
    if (rx == ry)
        return; // x et y sont déjà dans le même ensemble

    if (uf.rang[rx] > uf.rang[ry])
        uf.parent[ry] = rx;
    else {
        uf.parent[rx] = ry;
        if (uf.rang[rx] == uf.rang[ry])
            uf.rang[ry] = uf.rang[ry] + 1;
    }
}
Remarque
Le test rx == ry est indispensable. Si x et y sont déjà dans le même
ensemble, il n'y a rien à fusionner : sans ce test, on exécuterait
uf.parent[rx] = ry, c'est-à-dire uf.parent[rx] = rx, ce qui est sans
effet, mais aussi uf.rang[ry] = uf.rang[ry] + 1 puisque les deux rangs
sont trivialement égaux. Le rang
augmenterait alors sans que l'arbre change, et on perdrait la propriété
« un arbre de rang \(r\) possède au moins \(2^r\) nœuds » sur laquelle repose
la complexité en \(O(\log n)\).
Plutôt que d'interdire cet appel, on le rend inoffensif : l'appelant peut
ainsi appeler uf_union(uf, x, y) pour chaque arête \((x,y)\) sans tester
au préalable si uf_find(uf, x) != uf_find(uf, y).
Comme pour toute structure allouée sur le tas, on fournit une fonction de libération de la mémoire, à appeler une fois la structure devenue inutile.
void uf_detruire(union_find uf)
{
    free(uf.parent);
    free(uf.rang);
}