Algorithmes d'approximation
Source principale de cette partie : Approximation Algorithms de Vijay Vazirani.
Définition
Dans le contexte d'un problème d'optimisation fixé (voir le chapitre Calculabilité pour la définition), on va noter \(OPT(e)\) la valeur de la solution optimale pour l'entrée \(e\). Dans tout ce chapitre, on s'intéresse au cas où le problème de décision à seuil associé est NP-complet. Il est donc illusoire de chercher à calculer \(OPT(e)\) pour des entrées de grande taille. On va plutôt chercher à définir un algorithme calculant non pas \(OPT(e)\) mais une approximation.
Définition
On considère un problème de minimisation défini par :
- les instances \(I\) ;
- les sorties \(S\) ;
- les sorties valides pour une instance, définies par \(v : I \rightarrow \mathcal{P}(S) \setminus \{ \emptyset \}\) ;
- et une fonction de coût \(c : S \rightarrow \R_+\).
On note \(OPT(i) = \min_{s \in v(i)} c(s)\) le coût minimal pour l'instance \(i\), et on suppose \(OPT(i) > 0\).
Étant donné un algorithme qui calcule une fonction \(\phi : I \rightarrow S\) telle que \(\forall i \in I, \phi(i) \in v(i)\), une fonction \(\rho : \N \rightarrow \R\) telle que
est appelée un facteur d'approximation de l'algorithme.
Quand \(\rho\) est une fonction constante \(\lambda\), on dit que l'algorithme est une \(\lambda\)-approximation.
Remarque
- Le fait d'avoir \(\rho(n) \ge\) et pas \(\rho(n) =\) permet de se contenter d'une majoration : on n'a pas besoin de calculer exactement le pire cas.
-
Pour un problème de minimisation, on a forcément \(c(\phi(i)) \ge OPT(i)\) or si \(|i| = n\), on a
\[ \frac{c(\phi(i))}{OPT(i)} \le \rho(n) \iff c(\phi(i)) \le \rho(n) OPT(i) \]Et donc l'encadrement :
\[ OPT(i) \le c(\phi(i)) \le \rho(n) OPT(i) \]Ainsi, \(\rho(n)\) assure un contrôle sur l'approximation qui garantit qu'on est à moins de cette proportion de l'optimal.
-
Il n'y a aucune raison qu'un problème NP-complet possède une \(\lambda\)-approximation (voir le cas du TSP général ci-dessous).
-
On définit naturellement la même notion pour les problèmes de maximisation :
\[ \forall n \in \N, \rho(n) \ge \max_{i \in I, |i| = n} \frac{OPT(i)}{c(\phi(i))} \]on a alors \(c(\phi(i)) \ge \frac{1}{\rho(n)} OPT(i)\).
-
Ainsi, une 2-approximation est au pire :
- 2 fois plus grande pour un problème de minimisation (\(\times 2\)) ;
- 2 fois plus petite pour un problème de maximisation (\(\times 1/2\)).
2-approximation de MinVertexCover
On reprend le problème MinVertexCover du chapitre Calculabilité : étant donné un graphe non orienté \(G = (S, A)\), on cherche une couverture par sommets \(C \subset S\), c'est-à-dire telle que toute arête a au moins une extrémité dans \(C\), de cardinal minimal. Le problème à seuil associé, VertexCover, est NP-complet.
Une idée gloutonne naturelle consiste à prendre une arête non couverte et à mettre ses deux extrémités dans la couverture. On ne sait pas laquelle des deux est utile, alors on prend les deux : c'est ce choix qui coûte un facteur 2.
Algorithme
- \(C \leftarrow \emptyset\)
- Pour chaque arête \(\{x, y\} \in A\) :
- si \(x \not\in C\) et \(y \not\in C\), alors \(C \leftarrow C \cup \{x, y\}\).
- Renvoyer \(C\).
On note \(M\) l'ensemble des arêtes \(\{x,y\}\) qui ont provoqué un ajout dans \(C\).
Théorème
Cet algorithme est une 2-approximation de MinVertexCover, de complexité
\(O(|S| + |A|)\) avec des listes d'adjacence.
Preuve
- \(C\) est une couverture : si une arête \(\{x,y\}\) n'avait aucune extrémité dans \(C\) à la fin, elle n'en avait pas non plus au moment où on l'a examinée (on ne retire jamais de sommet de \(C\)), donc on aurait ajouté \(x\) et \(y\) à ce moment-là.
- \(M\) est un couplage : quand on ajoute \(\{x, y\}\) à \(M\), ni \(x\) ni \(y\) ne sont dans \(C\), donc ils ne sont extrémités d'aucune arête déjà dans \(M\). Ainsi \(|C| = 2|M|\).
- Soit \(C^*\) une couverture optimale. Elle contient au moins une extrémité de chaque arête de \(M\), et ces extrémités sont distinctes car les arêtes de \(M\) sont deux à deux disjointes. Donc \(OPT(G) = |C^*| \ge |M|\).
On en déduit \(|C| = 2 |M| \le 2 OPT(G)\). Si \(G\) n'a pas d'arête, \(C = \emptyset\) est optimale. Chaque arête est examinée un nombre constant de fois avec des opérations en \(O(1)\) d'où la complexité.
Remarque
Le facteur 2 est atteint : pour un graphe réduit à une arête, l'algorithme renvoie les deux sommets alors qu'un seul suffit. Plus généralement, sur un graphe biparti complet \(K_{n,n}\), la couverture renvoyée contient les \(2n\) sommets alors que \(OPT = n\).
La preuve utilise une technique très générale : on ne connaît pas \(OPT\), mais on dispose d'un minorant de \(OPT\) (ici la taille d'un couplage) qu'on sait relier à la valeur de la solution calculée.
Avec la représentation par listes d'adjacence du chapitre sur les graphes, chaque arête est vue deux fois, ce qui ne change rien :
let couverture_2approx (g : int list array) : int list =
  let n = Array.length g in
  let couvert = Array.make n false in
  let c = ref [] in
  for x = 0 to n - 1 do
    List.iter (fun y ->
        if not couvert.(x) && not couvert.(y) then begin
          couvert.(x) <- true;
          couvert.(y) <- true;
          c := x :: y :: !c
        end)
      g.(x)
  done;
  !c
struct graphe {
    int n;         // nombre de sommets
    int *degre;    // degre[x] = nombre de voisins de x
    int **voisins; // voisins[x][0], ..., voisins[x][degre[x] - 1]
};
typedef struct graphe graphe;

/* renvoie un tableau de booléens : dans_c[x] indique si x est dans la couverture */
bool *couverture_2approx(graphe *g)
{
    bool *dans_c = malloc(sizeof(bool) * g->n);
    for (int x = 0; x < g->n; x++)
        dans_c[x] = false;
    for (int x = 0; x < g->n; x++) {
        for (int k = 0; k < g->degre[x]; k++) {
            int y = g->voisins[x][k];
            if (!dans_c[x] && !dans_c[y]) {
                dans_c[x] = true;
                dans_c[y] = true;
            }
        }
    }
    return dans_c;
}
Le TP associé en propose une version sur une liste d'arêtes.
2-approximation de MetricTSP
Problème : MetricTSP
- Entrée : un graphe complet non orienté \(G = (S, A)\) avec \(|S| \ge 2\), et une distance \(d : S^2 \rightarrow \R_+\) symétrique vérifiant l'inégalité triangulaire \(\forall x, y, z \in S, d(x,y) \le d(x,z) + d(z,y)\).
- Sortie : un cycle hamiltonien de \(G\) (passant une et une seule fois par chaque sommet) de longueur minimale.
Ce problème est NP-difficile. On considère l'algorithme suivant :
Algorithme
- On construit un arbre couvrant de poids minimal \(T\) de \(G\) (par exemple avec l'algorithme de Kruskal, voir le chapitre Algorithmique des graphes avancée).
- On choisit une racine \(r\) et on renvoie le cycle qui visite les sommets dans l'ordre préfixe d'un parcours en profondeur de \(T\), puis revient en \(r\).
Théorème
Cet algorithme est une 2-approximation de MetricTSP.
Preuve
Notons \(d(T)\) le poids de l'arbre et \(H^*\) un cycle hamiltonien optimal.
- \(d(T) \le OPT\) : en retirant une arête de \(H^*\), on obtient un chemin hamiltonien, qui est un arbre couvrant de \(G\), de poids \(\le d(H^*) = OPT\) car les distances sont positives. Comme \(T\) est de poids minimal, \(d(T) \le OPT\).
- Le parcours en profondeur complet de \(T\), qui note un sommet à chaque passage (en descendant et en remontant), emprunte chaque arête de \(T\) exactement deux fois : c'est un circuit fermé \(P\) passant par tous les sommets, de longueur \(2 d(T)\).
- Le cycle renvoyé \(H\) s'obtient à partir de \(P\) en sautant les sommets déjà visités : on remplace un morceau \(x, z_1, \dots, z_k, y\) de \(P\) par l'arête \(\{x,y\}\). Par inégalité triangulaire (appliquée \(k\) fois), \(d(x,y) \le d(x, z_1) + \dots + d(z_k, y)\), donc \(d(H) \le d(P) = 2 d(T)\).
Ainsi \(d(H) \le 2 d(T) \le 2 OPT\).
Remarque
- L'hypothèse métrique est indispensable. Sans elle, s'il existait une \(\lambda\)-approximation polynomiale du TSP général, on pourrait décider en temps polynomial si un graphe \(G = (S, A)\) possède un cycle hamiltonien (problème NP-complet) : on complète \(G\) en donnant le poids \(1\) à ses arêtes et le poids \(\lambda |S| + 1\) aux autres. S'il existe un cycle hamiltonien dans \(G\), \(OPT = |S|\) et l'approximation renvoie un cycle de longueur \(\le \lambda |S|\), qui ne peut utiliser que des arêtes de \(G\) ; sinon, tout cycle utilise une arête de poids \(\lambda |S| + 1\). Il suffit donc de comparer la longueur renvoyée à \(\lambda |S|\). Ainsi, sauf si P = NP, le TSP général n'a pas de \(\lambda\)-approximation polynomiale.
- L'algorithme de Christofides (hors programme) améliore ce facteur en
\(\frac{3}{2}\) pour
MetricTSP.
Ce problème est mis en œuvre dans le TP associé.
Sac à dos
Problème : Knapsack
- Entrée : \(n\) objets numérotés de \(1\) à \(n\), l'objet \(i\) ayant un poids \(w_i \in \N^*\) et une valeur \(v_i \in \N^*\), et un poids maximal \(W \in \N\).
- Sortie : \(S \subset \range{1}{n}\) tel que \(w(S) = \sum_{i \in S} w_i \le W\) et de valeur \(v(S) = \sum_{i \in S} v_i\) maximale.
Le TD sur le sac à dos montre que ce problème est NP-complet, que sa variante fractionnaire est résolue optimalement par un algorithme glouton, et construit un schéma d'approximation : pour tout \(\epsilon > 0\), un algorithme de complexité \(O(n^3 / \epsilon)\) qui renvoie une solution de valeur \(\ge (1 - \epsilon) OPT\).
On présente ici une approximation plus simple. Quitte à les éliminer, on suppose que chaque objet rentre seul dans le sac : \(w_i \le W\).
Le glouton par efficacité \(v_i / w_i\) décroissante seul peut être arbitrairement mauvais : avec \(W = M\), un objet de poids \(1\) et de valeur \(2\) et un objet de poids \(M\) et de valeur \(M\), il prend le premier objet, ne peut plus prendre le second, et renvoie \(2\) au lieu de \(M\). On corrige cela en comparant au meilleur objet pris seul.
Algorithme
- Trier les objets par efficacité \(v_i / w_i\) décroissante et les ajouter dans cet ordre dès qu'ils rentrent dans le sac : on obtient \(S_g\).
- Soit \(i_0\) un objet de valeur maximale.
- Renvoyer la meilleure des deux solutions \(S_g\) et \(\{ i_0 \}\).
Théorème
Cet algorithme est une 2-approximation de Knapsack, de complexité
\(O(n \log n)\).
Preuve
On numérote les objets par efficacité décroissante. Si tous les objets rentrent ensemble, \(S_g\) est l'ensemble des objets, qui est optimal. Sinon, soit \(j\) le premier objet tel que \(w_1 + \dots + w_j > W\). Les objets \(1, \dots, j-1\) ont tous été pris par le glouton, donc \(v(S_g) \ge v_1 + \dots + v_{j-1}\).
Soit \(S^*\) optimal. On a, en notant \(e = v_j / w_j\) :
car \(v_i \le e w_i\) pour \(i > j\), \(v_i \ge e w_i\) pour \(i \le j\), et \(w(S^*) \le W < \sum_{i=1}^j w_i\). Ainsi
La complexité est dominée par le tri.
L'implémentation compare les efficacités sans flottants : \(v_i / w_i < v_j / w_j \iff v_i w_j < v_j w_i\).
let sac_glouton (w : int array) (v : int array) (cap : int) : int list =
  let n = Array.length w in
  let ordre = Array.init n (fun i -> i) in
  (* tri par efficacité v.(i) / w.(i) décroissante *)
  Array.sort (fun i j -> compare (v.(j) * w.(i)) (v.(i) * w.(j))) ordre;
  let reste = ref cap in
  let pris = ref [] in
  let valeur = ref 0 in
  Array.iter (fun i ->
      if w.(i) <= !reste then begin
        reste := !reste - w.(i);
        valeur := !valeur + v.(i);
        pris := i :: !pris
      end)
    ordre;
  (* meilleur objet seul *)
  let meilleur = ref (-1) in
  for i = 0 to n - 1 do
    if w.(i) <= cap && (!meilleur = -1 || v.(i) > v.(!meilleur)) then
      meilleur := i
  done;
  if !meilleur <> -1 && v.(!meilleur) > !valeur then [!meilleur] else !pris
Remarque
La boucle gloutonne ne s'arrête pas au premier objet qui ne rentre pas : cela ne peut qu'améliorer la solution, et la preuve reste valable. La fonction ignore d'elle-même les objets trop lourds.
Algorithmes probabilistes
Source principale de cette partie : Randomized Algorithms de Rajeev Motwani et Prabhakar Raghavan.
Las Vegas et Monte-Carlo
On va considérer dans ce paragraphe des algorithmes ayant accès à une forme parfaite de hasard. On ne soulève pas de difficulté sur cette définition, et ce hasard pourra, selon les cas, se matérialiser par le fait de pouvoir choisir uniformément et aléatoirement dans un ensemble de valeurs :
- le cas le plus simple est celui du bit aléatoire : une valeur aléatoire \(0\) ou \(1\). Ici, il est crucial que tous les tirages soient indépendants, cela permet naturellement de construire des valeurs mémoires aléatoires sur \(n\) bits : entiers, flottants...
- un cas usuel dans les algorithmes est celui du choix d'un élément dans un tableau ou dans une liste.
On considère le plus souvent que le tirage s'effectue en temps et en espace constant. Cela suffit pour la plupart des analyses.
En pratique, les ordinateurs utilisent des générateurs pseudo-aléatoires :
des suites déterministes qui semblent aléatoires (voir le
TP). En OCaml, Random.int n
renvoie un entier uniforme dans \(\range{0}{n-1}\) ; en C, on utilise rand().
Pour une entrée \(e\) fixée, l'exécution d'un tel algorithme dépend des tirages effectués : son résultat et sa durée \(T(e)\) sont donc des variables aléatoires. On distingue deux grandes familles d'algorithmes probabilistes selon que c'est la durée ou la correction qui est aléatoire.
Définition
Un algorithme probabiliste résolvant un problème est dit :
- de Las Vegas lorsque, pour toute entrée \(e\), il termine avec probabilité 1 et que le résultat renvoyé est toujours correct. Seule sa durée \(T(e)\) est aléatoire : on mesure alors sa complexité par l'espérance \(E(T(e))\), et on parle de complexité en moyenne dans le pire cas pour \(\max_{|e| = n} E(T(e))\).
- de Monte-Carlo lorsqu'il existe une fonction \(t\) telle que, pour toute entrée \(e\), il termine toujours en au plus \(t(|e|)\) étapes, mais que le résultat peut être faux. On impose alors une majoration de la probabilité d'erreur : il existe \(\epsilon < 1\) tel que pour toute entrée \(e\), la probabilité que le résultat soit incorrect est au plus \(\epsilon\).
Pour un problème de décision, un algorithme de Monte-Carlo est dit à erreur unilatérale lorsqu'une des deux réponses est toujours correcte (par exemple : s'il répond « non », la bonne réponse est « non » ; s'il répond « oui », il peut se tromper avec probabilité \(\le \epsilon\)), et à erreur bilatérale sinon, avec alors \(\epsilon < \frac{1}{2}\).
Remarque
Attention à ne pas confondre l'espérance d'un algorithme de Las Vegas avec la complexité en moyenne d'un algorithme déterministe : ici, l'espérance porte sur les tirages de l'algorithme, l'entrée étant fixée et pouvant être la pire possible. Aucune hypothèse n'est faite sur la répartition des entrées.
Pour mémoriser : à Las Vegas, on joue jusqu'à gagner, mais on ne sait pas combien de temps cela va prendre ; à Monte-Carlo, on joue un temps fixé, sans garantie de gagner.
On peut passer d'une famille à l'autre, et réduire la probabilité d'erreur en répétant l'algorithme.
Propriété
- Amplification : si un algorithme de Monte-Carlo à erreur unilatérale (réponse « non » toujours correcte) a une probabilité d'erreur \(\le \epsilon\), l'algorithme qui l'exécute \(k\) fois de manière indépendante et répond « oui » si et seulement si toutes les exécutions ont répondu « oui » a une probabilité d'erreur \(\le \epsilon^k\).
- De Monte-Carlo à Las Vegas : si un algorithme de Monte-Carlo renvoie une réponse correcte avec probabilité \(\ge p > 0\) et qu'on sait vérifier une réponse, l'algorithme qui le répète jusqu'à obtenir une réponse vérifiée est de Las Vegas, et le nombre moyen de répétitions est au plus \(\frac{1}{p}\).
- De Las Vegas à Monte-Carlo : si un algorithme de Las Vegas vérifie \(E(T(e)) \le t(|e|)\), l'algorithme qui l'interrompt après \(2 t(|e|)\) étapes en répondant « échec » termine en temps borné et échoue avec probabilité \(\le \frac{1}{2}\).
Preuve
- Si la bonne réponse est « non », chaque exécution répond « non » donc l'algorithme répété aussi. Si la bonne réponse est « oui », il se trompe si et seulement si les \(k\) exécutions indépendantes se trompent, ce qui arrive avec probabilité \(\le \epsilon^k\).
-
Comme chaque réponse renvoyée est vérifiée, elle est correcte. Notons \(q \in [0, 1-p]\) la probabilité qu'une exécution échoue et \(N\) le nombre d'exécutions. Par indépendance, \(P(N = k) = q^{k-1}(1-q)\) : \(N\) suit une loi géométrique. En particulier \(P(N > k) = q^k \to 0\) donc l'algorithme termine avec probabilité 1, et
\[ E(N) = \sum_{k=1}^{+\infty} k (1-q) q^{k-1} = \frac{1-q}{(1-q)^2} = \frac{1}{1-q} \le \frac{1}{p} \] -
C'est l'inégalité de Markov : pour une variable aléatoire \(X\) à valeurs dans \(\N\) et \(a > 0\), \(E(X) = \sum_k k P(X = k) \ge \sum_{k \ge a} a P(X = k) = a P(X \ge a)\). Avec \(X = T(e)\) et \(a = 2t(|e|)\), on obtient \(P(T(e) \ge 2t(|e|)) \le \frac{E(T(e))}{2t(|e|)} \le \frac{1}{2}\).
Remarque
- Dans le point 3, en relançant \(k\) fois l'algorithme interrompu, on obtient une probabilité d'échec \(\le 2^{-k}\) en temps \(2 k t(|e|)\).
- Pour une erreur bilatérale \(\epsilon < \frac{1}{2}\), on amplifie en répondant la réponse majoritaire de \(2k+1\) exécutions indépendantes : la probabilité d'erreur décroît alors exponentiellement avec \(k\) (admis ; cela découle d'inégalités de concentration hors programme).
- L'exemple classique d'algorithme de Monte-Carlo à erreur unilatérale est l'algorithme de Freivalds qui vérifie si \(AB = C\) pour des matrices \(A, B, C\) en temps \(O(n^2)\) en testant \(A(Bx) = Cx\) pour un vecteur \(x\) aléatoire.
Problème des \(N\) reines pour \(N\) grand
On cherche à placer \(N\) reines sur un échiquier \(N \times N\) sans que deux reines soient sur la même ligne, la même colonne ou la même diagonale. Le retour sur trace résout ce problème, mais explore beaucoup de positions quand \(N\) grandit. On sait par ailleurs qu'il existe des solutions pour tout \(N \ge 4\) (admis), et qu'il n'y en a pas pour \(N \in \{2, 3\}\).
Une idée probabiliste très simple : on place une reine par ligne, dans une colonne choisie uniformément parmi celles qui ne sont pas attaquées par les reines précédentes. Si aucune colonne n'est disponible, on recommence tout.
(* tente de placer une reine par ligne dans une colonne libre tirée
   au hasard ; renvoie None en cas d'impasse *)
let essai_reines n =
  let col = Array.make n (-1) in
  let compatible l c =
    let ok = ref true in
    for l' = 0 to l - 1 do
      if col.(l') = c || abs (col.(l') - c) = l - l' then ok := false
    done;
    !ok
  in
  let rec place l =
    if l = n then Some col
    else begin
      let possibles = List.filter (compatible l) (List.init n (fun c -> c)) in
      match possibles with
      | [] -> None
      | _ ->
        col.(l) <- List.nth possibles (Random.int (List.length possibles));
        place (l + 1)
    end
  in
  place 0

let rec reines_las_vegas n =
  match essai_reines n with
  | Some col -> col
  | None -> reines_las_vegas n
essai_reines est un algorithme de Monte-Carlo : il termine en \(O(N^3)\) avec
cette implémentation naïve, mais peut échouer. Comme une solution renvoyée est
toujours correcte, reines_las_vegas est un algorithme de Las Vegas pour
\(N = 1\) ou \(N \ge 4\) : la probabilité \(p_N\) qu'un essai réussisse est
strictement positive, puisqu'il existe une solution et que chacun de ses choix
a une probabilité non nulle d'être tiré. D'après la propriété précédente, le
nombre moyen d'essais est \(\frac{1}{p_N}\). Pour \(N \in \{2, 3\}\), la fonction
ne termine pas.
Des mesures sur \(20\,000\) essais donnent :
| \(N\) | 4 | 5 | 8 | 10 | 20 | 30 |
|---|---|---|---|---|---|---|
| \(p_N\) estimée | \(0{,}50\) | \(0{,}76\) | \(0{,}13\) | \(0{,}06\) | \(0{,}022\) | \(0{,}012\) |
Remarque
Pour \(N = 8\), il faut donc environ 8 essais en moyenne. La probabilité de succès diminue avec \(N\) : en pratique, on combine les deux approches en plaçant aléatoirement les reines des premières lignes puis en complétant par retour sur trace, ce qui est beaucoup plus efficace que chacune des deux méthodes seule pour \(N\) grand.
Algorithme de Karger
Définition
Soit \(G = (S,A)\) un graphe non orienté avec \(|S| \ge 2\), on dit que \(\Gamma \subset A\) est une coupure de \(G\) lorsque le graphe \((S, A \setminus \Gamma)\) n'est pas connexe.
Remarque
Cette définition n'a donc de pertinence que pour un graphe connexe. Voire, pour un graphe très connexe, c'est-à-dire un graphe pour lequel il faut supprimer beaucoup d'arêtes pour le déconnecter.
Pour une partie \(X \neq \emptyset, S\), l'ensemble des arêtes reliant \(X\) à \(S \setminus X\) est une coupure. Réciproquement, si \(\Gamma\) est une coupure et \(X\) une composante connexe de \((S, A \setminus \Gamma)\), les arêtes reliant \(X\) à \(S \setminus X\) sont toutes dans \(\Gamma\) : une coupure de cardinal minimal est donc de cette forme.
Lemme
Si la plus petite coupure, en cardinal, de \(G\) a \(k\) arêtes, alors
Preuve
Si \(G\) admet un sommet de degré \(< k\), alors il suffit de supprimer toutes ses arêtes incidentes pour l'isoler. On obtient ainsi une coupure de taille strictement plus petite que \(k\), ce qui est impossible par hypothèse. Tous les sommets sont donc de degré \(\ge k\).
On sait que \(\sum_{x \in S} d(x) = 2 |A|\) et on a donc \(2 |A| \ge |S| k\).
Cette remarque, qui ici nous permet de constater qu'il faut un nombre conséquent d'arêtes pour ne pas avoir de coupures trop petites, sera cruciale dans la suite. Elle reste valable, avec la même preuve, pour les multigraphes définis ci-dessous.
On cherche à résoudre le problème :
Problème : MinCut
- Entrée : \(G = (S,A)\) un graphe non orienté connexe avec \(|S| \ge 2\).
- Sortie : \(\Gamma \subset A\) coupure de cardinal minimal.
Il existe des algorithmes déterministes et polynomiaux pour résoudre ce problème, ils reposent sur des graphes de flot et rappellent l'algorithme vu pour un couplage maximum d'un graphe biparti.
On va présenter ici un algorithme de Monte-Carlo très facile à mettre en œuvre : l'algorithme de Karger. Il repose sur la notion de multigraphes : des graphes où plusieurs arêtes peuvent relier une paire de sommets.
Définition
Soit \(G = (S, A)\) un multigraphe sans boucle et \(a \in A\) une arête reliant \(x\) et \(y\). La contraction de \(G\) par \(a\) est le multigraphe \(G/a = (S \setminus \{ y \}, A')\) obtenu en fusionnant \(y\) dans \(x\) :
- les arêtes reliant \(x\) et \(y\) (dont \(a\)) sont supprimées ;
- chaque arête reliant \(y\) à un sommet \(z \neq x\) est remplacée par une arête reliant \(x\) et \(z\) ;
- les autres arêtes sont conservées.
Les arêtes multiples sont conservées : \(G/a\) a exactement \(|S| - 1\) sommets et \(|A| - m\) arêtes, où \(m\) est le nombre d'arêtes entre \(x\) et \(y\).
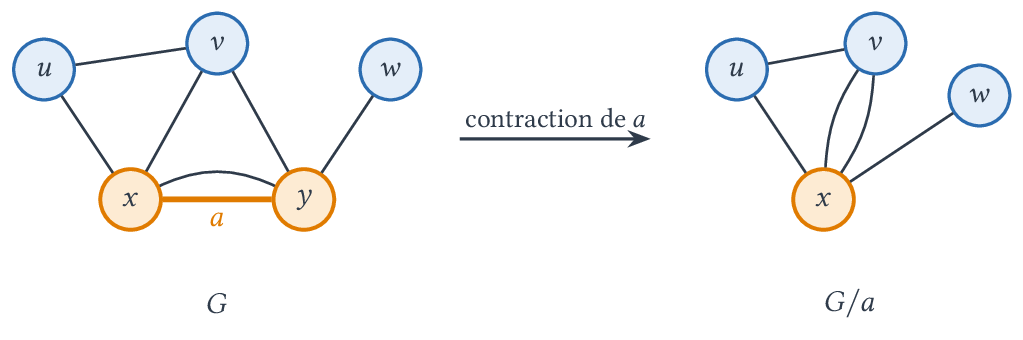
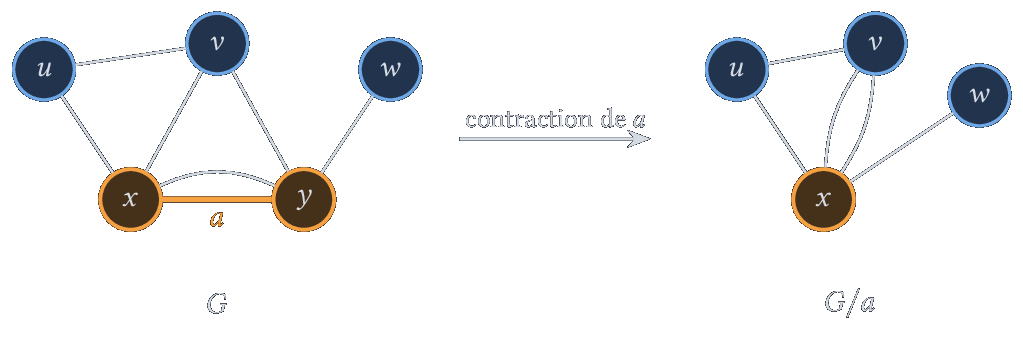
Les arêtes de \(G/a\) correspondent à des arêtes de \(G\) : on identifie chaque arête à l'arête de \(G\) dont elle provient. Une coupure de \(G/a\) est alors une coupure de \(G\) (les sommets fusionnés restant du même côté), donc la plus petite coupure de \(G/a\) est de taille au moins celle de \(G\).
L'algorithme de Karger est alors très simple :
Algorithme de Karger
- Tant que le multigraphe a plus de deux sommets :
- choisir une arête \(a\) uniformément parmi les arêtes ;
- remplacer le multigraphe par sa contraction par \(a\).
- Renvoyer l'ensemble des arêtes (de \(G\)) reliant les deux sommets restants.
Chaque sommet restant représente un ensemble de sommets \(X\) et \(S \setminus X\) de \(G\) ; les arêtes restantes sont exactement les arêtes de \(G\) entre \(X\) et \(S \setminus X\) : c'est une coupure de \(G\). Comme le graphe est connexe, il reste toujours au moins une arête tant qu'il y a au moins deux sommets.
Théorème
Soit \(G\) un graphe connexe à \(n \ge 2\) sommets et \(\Gamma\) une coupure minimale de \(G\). L'algorithme de Karger renvoie \(\Gamma\) avec une probabilité au moins \(\frac{2}{n(n-1)}\).
Preuve
Soit \(k = |\Gamma|\). L'algorithme renvoie \(\Gamma\) si et seulement si aucune arête de \(\Gamma\) n'est contractée au cours des \(n - 2\) étapes : en effet, \(\Gamma\) est l'ensemble des arêtes entre une partie \(X\) et \(S \setminus X\) (voir la remarque ci-dessus) et, si aucune de ces arêtes n'est contractée, les sommets de \(X\) et ceux de \(S \setminus X\) ne sont jamais fusionnés ensemble, et il reste à la fin les deux sommets \(X\) et \(S \setminus X\).
Notons \(E_i\) l'événement « aucune arête de \(\Gamma\) n'est contractée lors des \(i\) premières étapes ». Si \(E_{i}\) est réalisé, le multigraphe courant a \(n - i\) sommets, contient toutes les arêtes de \(\Gamma\), et sa coupure minimale est de taille \(\ge k\) (c'est aussi une coupure de \(G\)) et \(\le k\) (\(\Gamma\) en est une). Par le lemme, il a au moins \(k \frac{n-i}{2}\) arêtes. La probabilité de choisir une arête de \(\Gamma\) à l'étape \(i+1\) est donc au plus \(\frac{k}{k(n-i)/2} = \frac{2}{n-i}\), d'où
En enchaînant les probabilités conditionnelles :
après simplification télescopique. Pour \(n = 2\), il n'y a aucune contraction et le résultat est direct.
Corollaire
En répétant l'algorithme \(L = \frac{n(n-1)}{2} \ln n\) fois de manière indépendante et en gardant la plus petite coupure obtenue, on obtient une coupure minimale avec probabilité au moins \(1 - \frac{1}{n}\).
Preuve
On échoue si et seulement si aucune des \(L\) exécutions ne renvoie \(\Gamma\) (ou une autre coupure minimale). Par indépendance et avec \(1 - x \le e^{-x}\) :
Remarque
C'est un algorithme de Monte-Carlo : il termine toujours, mais peut renvoyer une coupure qui n'est pas minimale, et on ne sait pas vérifier efficacement qu'une coupure est minimale. Corollaire amusant de la preuve : comme les événements « renvoyer \(\Gamma\) » sont disjoints pour des coupures minimales \(\Gamma\) distinctes, un graphe a au plus \(\frac{n(n-1)}{2}\) coupures minimales.
Pour l'implémentation, choisir une arête uniforme puis contracter revient à parcourir les arêtes dans un ordre aléatoire uniforme en ignorant celles qui sont devenues des boucles (leurs extrémités sont déjà fusionnées) : à chaque étape, la première arête non boucle restante est uniforme parmi les arêtes non boucles. On retrouve l'algorithme de Kruskal avec un ordre aléatoire, arrêté à deux composantes, et on gère les fusions avec une structure Union-Find :
(* union-find minimal avec compression de chemin *)
let rec trouve parent x =
  if parent.(x) = x then x
  else begin
    let r = trouve parent parent.(x) in
    parent.(x) <- r;
    r
  end

let echange t i j =
  let x = t.(i) in
  t.(i) <- t.(j);
  t.(j) <- x

(* mélange de Fisher-Yates : permutation uniforme *)
let melange t =
  for i = Array.length t - 1 downto 1 do
    echange t i (Random.int (i + 1))
  done

(* graphe connexe de sommets 0, ..., n - 1 donné par ses arêtes *)
let karger n (aretes : (int * int) array) : (int * int) list =
  let parent = Array.init n (fun x -> x) in
  let a = Array.copy aretes in
  melange a;
  let nb_sommets = ref n in
  Array.iter (fun (x, y) ->
      let rx = trouve parent x and ry = trouve parent y in
      if !nb_sommets > 2 && rx <> ry then begin
        parent.(ry) <- rx; (* contraction de l'arête *)
        decr nb_sommets
      end)
    a;
  List.filter (fun (x, y) -> trouve parent x <> trouve parent y)
    (Array.to_list aretes)
Sur deux graphes complets \(K_5\) reliés par deux arêtes (\(n = 10\), coupure minimale de taille 2), on obtient expérimentalement la coupure minimale dans environ 26 % des exécutions, bien au-dessus de la borne \(\frac{2}{90} \approx 2{,}2\,\%\). Le TP en propose une implémentation en C qui réalise réellement les contractions.
Quicksort avec pivot aléatoire
Le tri rapide avec le premier élément comme pivot est en \(O(n^2)\) dans le pire cas, par exemple sur un tableau déjà trié. En choisissant le pivot uniformément au hasard, on obtient un algorithme de Las Vegas : le tableau renvoyé est toujours trié, seule la durée est aléatoire, et son espérance est en \(O(n \log n)\) pour toute entrée.
let echange t i j =
  let x = t.(i) in
  t.(i) <- t.(j);
  t.(j) <- x

(* trie t.(d), ..., t.(f - 1) *)
let rec tri_rapide t d f =
  if f - d > 1 then begin
    echange t d (d + Random.int (f - d)); (* pivot aléatoire placé en tête *)
    let pivot = t.(d) in
    let m = ref d in
    (* invariant : t.(d+1..!m) < pivot <= t.(!m+1..i-1) *)
    for i = d + 1 to f - 1 do
      if t.(i) < pivot then begin
        incr m;
        echange t !m i
      end
    done;
    echange t d !m;
    tri_rapide t d !m;
    tri_rapide t (!m + 1) f
  end

let tri t = tri_rapide t 0 (Array.length t)
void echange(int *t, int i, int j)
{
    int x = t[i];
    t[i] = t[j];
    t[j] = x;
}

/* trie t[d], ..., t[f - 1] */
void tri_rapide(int *t, int d, int f)
{
    if (f - d <= 1)
        return;
    echange(t, d, d + rand() % (f - d)); // pivot aléatoire placé en tête
    int pivot = t[d];
    int m = d;
    // invariant : t[d+1..m] < pivot <= t[m+1..i-1]
    for (int i = d + 1; i < f; i++) {
        if (t[i] < pivot) {
            m++;
            echange(t, m, i);
        }
    }
    echange(t, d, m);
    tri_rapide(t, d, m);
    tri_rapide(t, m + 1, f);
}
Théorème
Pour un tableau de \(n\) éléments distincts, l'espérance du nombre de comparaisons effectuées par le tri rapide à pivot aléatoire est au plus \(2 n \ln n\) (pour \(n \ge 1\)).
Preuve
Notons \(z_1 < z_2 < \dots < z_n\) les éléments du tableau dans l'ordre croissant. Deux éléments ne sont comparés que si l'un des deux est le pivot, et un pivot n'est plus jamais comparé après son placement : \(z_i\) et \(z_j\) sont donc comparés au plus une fois. Soit \(X_{ij}\) la variable aléatoire valant \(1\) s'ils sont comparés, \(0\) sinon. Le nombre de comparaisons est \(X = \sum_{i < j} X_{ij}\).
Pour \(i < j\), considérons \(Z_{ij} = \{ z_i, \dots, z_j \}\). Tant qu'aucun élément de \(Z_{ij}\) n'a été choisi comme pivot, tous les éléments de \(Z_{ij}\) sont dans le même sous-tableau. Au moment où un premier élément de \(Z_{ij}\) est choisi comme pivot :
- si c'est \(z_i\) ou \(z_j\), ils sont comparés ;
- sinon, c'est un \(z_k\) avec \(i < k < j\), et \(z_i\) et \(z_j\) sont envoyés dans des sous-tableaux différents : ils ne seront jamais comparés.
Comme le pivot est uniforme dans son sous-tableau, qui contient \(Z_{ij}\), chaque élément de \(Z_{ij}\) a la même probabilité d'être ce premier pivot, donc \(P(X_{ij} = 1) = \frac{2}{j - i + 1}\). Par linéarité de l'espérance :
car \(\sum_{k=2}^n \frac{1}{k} \le \int_1^n \frac{dt}{t} = \ln n\).
Remarque
- La complexité totale est proportionnelle au nombre de comparaisons, elle est donc en \(O(n \log n)\) en espérance. Il s'agit bien d'une espérance sur les tirages pour une entrée fixée quelconque, et non d'une moyenne sur les entrées : aucun tableau particulier n'est mauvais.
- Avec des éléments répétés, la partition ci-dessus peut se dégrader (un tableau constant donne un temps quadratique) : on utilise alors une partition en trois zones \(<\), \(=\), \(>\).
- En C,
rand() % kn'est pas exactement uniforme quand \(k\) ne divise pasRAND_MAX + 1, ce qui est sans importance ici.
Travaux dirigés et pratiques
- TD : problème du sac à dos (glouton fractionnaire, programmation dynamique pseudo-polynomiale, schéma d'approximation, NP-complétude).
- TP : couverture par sommets et TSP métrique (OCaml).
- TP : sac à dos, générateur aléatoire et algorithme de Karger (C).
- DS 4 (MPI 2022-2023) : 3-coloration par marche aléatoire, partition approchée.