Remarque
Ce chapitre présente les trois grands principes qui nous serviront de guide pour analyser les algorithmes et les programmes :
- La terminaison : l'algorithme termine-t-il au bout d'un nombre fini d'étapes quelle que soit l'entrée ?
- La correction : le résultat rendu est-il celui qui était attendu ?
- La complexité : combien de temps prend le programme selon la taille de l'entrée ? Combien d'espace mémoire occupe-t-il ?
Savoir répondre à ces questions, c'est pouvoir prédire, avant d'avoir écrit la moindre ligne de code, ce qui va se passer.
Les notions de variant et d'invariant de boucle ont déjà été rencontrées dans le chapitre Introduction à la programmation, et la terminaison et la correction des fonctions récursives dans le chapitre Récursivité. On les reprend ici de manière plus systématique.
État d'un programme
Avant de commencer à raisonner sur les algorithmes, il est nécessaire de préciser la notion d'état qui correspond à un instantané de l'environnement d'exécution d'un programme lorsque son exécution est interrompue. Bien entendu, la description complète d'un tel état ne serait pas forcément pertinente, car cela prendrait en compte l'ensemble de la mémoire. Le plus souvent, on considère uniquement ce qui est important pour ce qu'on étudie.
Ainsi, si on considère le programme suivant :
int a = 3;
int b = 2;

a = b;
L'état du programme juste avant l'instruction a = b; (ligne 4) est
| variable | valeur |
|---|---|
| a | 3 |
| b | 2 |
et l'état juste après cette instruction est
| variable | valeur |
|---|---|
| a | 2 |
| b | 2 |
Parfois, on aura besoin de plus d'information dans l'état comme la position en mémoire de certaines données. Mais assez souvent, pour les algorithmes qui nous intéressent, on pourra adopter un point de vue assez abstrait de l'état d'un algorithme comme étant une fonction partielle des noms vers les valeurs.
Pour la terminaison et la correction, on va considérer des propriétés logiques dépendant de l'état. Par exemple \(a \ge 0 \wedge b \ge a\).
Terminaison
Définition
On dit qu'un algorithme termine quand il n'exécute qu'un nombre fini d'étapes sur toute entrée.
Remarque
Cela n'empêche pas que ce nombre d'étapes puisse être arbitrairement grand en fonction des entrées.
Un algorithme qui n'utilise ni boucles conditionnelles (boucles while) ni
récursivité termine toujours. Ainsi, la question de la terminaison n'est à
considérer que dans ces deux cas.
Considérons par exemple l'algorithme suivant qui, étant donné un entier naturel \(n\) strictement positif, inférieur à \(2^{30}\), détermine le plus petit entier \(k\) tel que \(n \le 2^k\) :
let plus_petite_puissance2 n =
    let k = ref 0 in
    let p = ref 1 in
    while !p < n do
        k := !k + 1;
        p := !p * 2
    done;
    !k
int plus_petite_puissance2(int n)
{
    int k = 0;
    int p = 1;

    while (p < n)
    {
        k = k+1;
        p = p*2;
    }

    return k;
}
def plus_petite_puissance2(n):
    k = 0
    p = 1

    while p < n:
        k = k+1
        p = p*2

    return k
On remarque que p prend successivement pour valeurs toutes les puissances de
2 jusqu'à une éventuelle sortie de boucle. Or, il existe une puissance de 2
supérieure ou égale à n, donc, une fois atteinte, la condition de la boucle
while n'est plus remplie et l'algorithme termine.
Remarque
Prouver la terminaison n'est pas une question facile, elle peut même être insoluble. Par exemple, si on considère le programme suivant :
def temps_de_vol(a):
    u = a
    n = 0
    while u != 1:
        if u % 2 == 0:
            u = u // 2
        else:
            u = 3*u + 1
        n = n+1
    return n
être capable de prouver sa terminaison pour tout entier \(a \ge 1\) revient à prouver la conjecture de Collatz (encore dite de Syracuse).
On peut aussi considérer le tri suivant :
def bogo(t):
    while not est_trie(t):
        melange(t)
Il semble très improbable que cet algorithme ne termine pas, d'ailleurs on peut prouver qu'il termine avec probabilité \(1\), mais on ne peut pas exclure le cas où il mélange indéfiniment.
Variant de boucle
Pour prouver la terminaison d'une boucle conditionnelle, on utilise un variant de boucle.
Définition
Un variant de boucle est une quantité entière, dépendant de l'état, qui est positive à l'entrée de chaque itération de la boucle et qui diminue strictement à chaque itération.
Dans l'exemple précédent, la quantité \(n-p\) est un variant de boucle :
- Comme il s'agit d'une différence de deux entiers, c'est un entier. Et tant que la condition de boucle est vérifiée, \(p < n\) donc \(n-p > 0\).
- Lorsqu'on passe d'une itération à la suivante, la quantité passe de \(n-p\) à \(n-2p\) or \((n-p) - (n-2p) = p > 0\) car \(p \ge 1\). Il y a bien une stricte diminution.
Remarque
Ici, en sortie de boucle, \(n-p \le 0\). On fait donc bien attention de préciser que la quantité est positive tant que la condition de boucle est vérifiée.
Si on a un variant de boucle qui vaut initialement \(N\) avant d'entrer dans la boucle, celle-ci effectue au plus \(N\) itérations, car le variant diminue au moins de 1 à chaque itération tout en restant positif à l'entrée de chacune.
Théorème
Si une boucle admet un variant de boucle, elle termine.
Preuve
Si la boucle effectuait une infinité d'itérations, les valeurs successives du variant à l'entrée de chaque itération formeraient une suite infinie strictement décroissante d'entiers naturels, ce qui est impossible.
Exemple de la recherche dichotomique
On considère ici la recherche dichotomique dans un tableau trié d'entiers. Étant donné un tableau \(t\) de taille \(n\) et un entier \(x\) dont on cherche à déterminer la présence dans le tableau entre les indices \(i\) et \(j\), on considère l'algorithme suivant :
- Si \(i>j\), alors il n'y a pas de sous-tableau et on renvoie
false. - Sinon, soit \(m\) l'élément d'indice \(p = \left\lfloor \frac{i+j}{2} \right\rfloor\).
- Si \(x = m\), on renvoie
true. - Si \(x < m\), on continue la recherche dans le sous-tableau des indices \(i\) à \(p-1\).
- Si \(x > m\), on continue la recherche dans le sous-tableau des indices \(p+1\) à \(j\).
- Si \(x = m\), on renvoie
Les programmes suivants présentent une implémentation de cet algorithme qui renvoie un indice de \(x\) plutôt qu'un booléen.
exception Trouve of int

let rech_dicho t x =
    let i = ref 0 in
    let j = ref (Array.length t - 1) in
    try
        while !i <= !j do
            let p = (!i + !j)/2 in
            let m = t.(p) in
            if m = x
            then raise (Trouve p)
            else if x < m
            then j := p-1
            else i := p+1
        done;
        None
    with Trouve p -> Some p
int rech_dicho(int *t, size_t n, int x)
{
    /* renvoie un indice de x
      si x est dans le tableau et -1 sinon */
    int i = 0;
    int j = (int) n - 1;

    while (i <= j)
    {
        int p = (i+j)/2;
        int m = t[p];

        if (x == m)
        {
            return p;
        }
        else if (x < m)
        {
            j = p-1;
        }
        else
        {
            i = p+1;
        }
    }

    return -1;
}
def rech_dicho(t, x):
    i = 0
    j = len(t) - 1

    while i <= j:
        p = (i+j)//2
        m = t[p]
        if x == m:
            return p
        elif x < m:
            j = p-1
        else:
            i = p+1

    return None
Remarque
On aurait pu écrire i+(j-i)/2 et non (i+j)/2 afin d'éviter des erreurs de
dépassement dans le calcul de i+j.
Ici, la terminaison n'est pas immédiate, on va la prouver à l'aide d'un variant de boucle. On considère ainsi la quantité \(d(i,j) = j-i\).
- C'est un entier, et la condition de boucle est équivalente à \(d(i,j) \ge 0\), donc cette quantité est bien entière et positive à l'entrée de chaque itération.
-
Quand on passe à l'itération suivante, on passe
- soit de \(d(i,j)\) à \(d(i,p-1)\). Or \(d(i,p-1) = p-1-i = \left\lfloor \frac{i+j}{2} \right\rfloor -1 -i < \frac{i+j}{2} - i = \frac{j-i}{2} \le j - i = d(i,j)\).
- soit de \(d(i,j)\) à \(d(p+1,j)\). Or \(d(p+1,j) = j-p-1 = j-\left\lfloor \frac{i+j}{2} \right\rfloor -1 < j - \frac{i+j}{2} = \frac{j-i}{2} \le j - i = d(i,j)\), car \(\lfloor y \rfloor > y - 1\) pour tout réel \(y\).
Dans tous les cas, \(d(i,j)\) diminue strictement.
Ainsi, il s'agit d'un variant de boucle et l'algorithme termine.
Remarque
On remarque que le programme récursif suivant réalise également cet algorithme.
(* rech_dicho : int array -> int -> int -> int
    -> int option *)
let rec rech_dicho t i j x =
    if i <= j
    then let p = (i+j)/2 in
         let m = t.(p) in
         if x = m
         then Some p
         else if x < m
         then rech_dicho t i (p-1) x
         else rech_dicho t (p+1) j x
    else None
int rech_dicho(int *t, int i, int j, int x)
{
    if (i <= j)
    {
        int p = (i+j)/2;
        int m = t[p];
        if (x == m)
            return p;
        else if (x < m)
            return rech_dicho(t, i, p-1, x);
        else
            return rech_dicho(t, p+1, j, x);
    }

    return -1;
}
def rech_dicho(t, i, j, x):
    if i <= j:
        p = (i+j)//2
        m = t[p]
        if x == m:
            return p
        elif x < m:
            return rech_dicho(t, i, p-1, x)
        else:
            return rech_dicho(t, p+1, j, x)
    else:
        return None
Il suffit alors d'appeler rech_dicho sur la plage maximale d'indices
(de \(0\) à \(n-1\)) pour faire une recherche sur tout le tableau.
Ici, il n'y a pas explicitement de boucle, mais le même principe peut être mis en place pour prouver que le nombre d'appels récursifs est majoré, et donc que toute exécution termine. En effet, la quantité \(d(i,j) = j-i\) diminue pour les mêmes raisons à chaque appel récursif et reste entière positive tant qu'on effectue un nouvel appel (voir aussi la partie Terminaison du chapitre sur la récursivité).
Exemple du tri à bulles
On considère le tri à bulles dans une implémentation naïve. On effectue ainsi une série de balayages d'un tableau : on parcourt le tableau de gauche à droite et si deux éléments consécutifs sont dans le désordre, on les permute. À l'issue d'un tel balayage, si on a effectué au moins un échange, on recommence, sinon on s'arrête, car c'est le signe que le tableau est trié, comme on le prouvera à la fin de ce paragraphe.
On obtient alors le code suivant :
let swap t i j =
    let temp = t.(i) in
    t.(i) <- t.(j);
    t.(j) <- temp

let tri_bulles t =
    let echange = ref true in
    while !echange do
        echange := false;
        for i = 0 to Array.length t - 2 do
            if t.(i) > t.(i+1)
            then begin
                swap t i (i+1);
                echange := true
            end
        done
    done
void swap(int t[], int i, int j)
{
    int temp = t[i];
    t[i] = t[j];
    t[j] = temp;
}

void tri_bulles(int t[], int nb)
{
    bool echange = true;
    while (echange)
    {
        echange = false;
        for (int i = 0; i < nb-1; i++)
        {
            if (t[i] > t[i+1])
            {
                echange = true;
                swap(t, i, i+1);
            }
        }
    }
}
def swap(t, i, j):
    temp = t[i]
    t[i] = t[j]
    t[j] = temp

def tri_bulles(t):
    echange = True
    while echange:
        echange = False
        for i in range(len(t)-1):
            if t[i] > t[i+1]:
                echange = True
                swap(t, i, i+1)
Si la question de la terminaison de la boucle for ne se pose pas, celle de la
boucle while mérite qu'on s'y attarde pour deux raisons :
- premièrement pour la terminaison elle-même ;
- deuxièmement pour savoir si on peut majorer le nombre d'itérations, une question qu'on reverra avec la question de la complexité.
On va prouver la terminaison pour un type d'algorithme de tri qui généralise le tri à bulles. Pour cela, on commence par définir la notion d'inversion pour un tableau \(t\) de \(|t|\) éléments :
Définition
On dit qu'un couple \((i,j) \in \range{0}{|t|-1}^2\) est une inversion pour \(t\) si \(i < j\) et \(t[i] > t[j]\).
On note \(Inv(t)\) l'ensemble des inversions de \(t\) et \(inv(t) = |Inv(t)|\) le nombre d'inversions.
On dira qu'une inversion de la forme \((i,i+1)\) est une inversion directe.
On considère donc un algorithme qui résout une inversion directe tant qu'il y en a au moins une.
def tri(t):
    while existe_inversion_directe(t):
        i = debut_d_une_inversion_directe(t)
        echange(t, i, i+1)
Le tri à bulles est alors une manière de réaliser l'algorithme précédent en résolvant les inversions directes rencontrées alors qu'on avance dans le tableau.
Rappelons que \(t\) est trié dans l'ordre croissant lorsque pour tous indices \(i < j\), on a \(t[i] \le t[j]\).
Théorème
Pour un tableau \(t\) les propositions suivantes sont équivalentes :
- \(t\) est trié dans l'ordre croissant ;
- \(t\) n'a pas d'inversions ;
- \(t\) n'a pas d'inversions directes.
Preuve
-
\(1) \Rightarrow 3)\) naturellement, si \(t\) est trié dans l'ordre croissant, \(i < i+1\) entraîne \(t[i] \le t[i+1]\), donc il ne peut pas y avoir d'inversions directes.
-
\(3) \Rightarrow 2)\) on a \(t[i] \le t[i+1]\) pour tout \(i < |t|-1\). Soit \(i < j\), on va raisonner par récurrence sur \(j-i \ge 1\) pour montrer que \(t[i] \le t[j]\).
- si \(j-i=1\), comme \((i, i+1)\) n'est pas une inversion directe, \(t[i] \le t[j]\).
- si \(j-i > 1\), l'hypothèse de récurrence appliquée au couple \((i, j-1)\), qui vérifie \(1 \le (j-1)-i < j-i\), donne \(t[i] \le t[j-1]\), et \(t[j-1] \le t[j]\) car \((j-1,j)\) n'est pas une inversion directe. Donc \(t[i] \le t[j]\).
Ainsi, dans tous les cas on a bien \(t[i] \le t[j]\), et \((i,j)\) n'est pas une inversion.
-
\(2) \Rightarrow 1)\) si \(i < j\), comme \(t\) n'a pas d'inversions, on a \(t[i] \not> t[j]\), c'est-à-dire \(t[i] \le t[j]\). Ainsi, le tableau est bien trié dans l'ordre croissant.
On peut alors démontrer le lemme suivant :
Lemme
Si \(t\) est un tableau présentant une inversion directe \((i, i+1)\) et \(t'\) est le tableau qui s'en déduit en échangant les éléments d'indices \(i\) et \(i+1\), alors \(inv(t') = inv(t) - 1\).
Preuve
Notons \(\sigma\) la permutation des indices qui échange \(i\) et \(i+1\) et laisse les autres indices fixes, de sorte que \(t'[k] = t[\sigma(k)]\) pour tout \(k\).
- \((i,i+1)\) est une inversion de \(t\) mais pas de \(t'\), car \(t'[i] = t[i+1] < t[i] = t'[i+1]\).
- Soit \((a,b)\) un couple avec \(a < b\) et \((a,b) \neq (i,i+1)\). Comme \(a\) et \(b\) ne sont pas égaux à \(i\) et \(i+1\) simultanément, on a encore \(\sigma(a) < \sigma(b)\) ; de plus \(t'[a] > t'[b] \iff t[\sigma(a)] > t[\sigma(b)]\). Ainsi, \((a,b) \mapsto (\sigma(a),\sigma(b))\) est une bijection de \(Inv(t') \setminus \{(i,i+1)\} = Inv(t')\) sur \(Inv(t) \setminus \{(i,i+1)\}\) (c'est une involution).
On a donc \(inv(t') = inv(t) - 1\).
Remarque
Le nombre d'inversions directes, lui, ne diminue pas forcément : en échangeant les deux derniers éléments de \([2, 3, 1]\), qui a une seule inversion directe, on obtient \([2, 1, 3]\) qui en a encore une. C'est pour cela qu'on raisonne sur l'ensemble de toutes les inversions.
On en déduit alors :
Théorème
L'algorithme tri et le tri à bulles terminent et le tableau obtenu est trié.
De plus, tri effectue exactement \(inv(t)\) échanges et la boucle while du
tri à bulles effectue au plus \(inv(t)+1 \le \frac{n(n-1)}{2} + 1\)
itérations, où \(t\) est le tableau initial et \(n = |t|\).
Preuve
Dans les deux cas, le tableau n'est modifié que par des échanges d'éléments formant une inversion directe : d'après le lemme, chacun de ces échanges fait diminuer \(inv\) de exactement 1.
- Pour
tri, la quantité \(inv(t)\) est un entier positif qui diminue de 1 à chaque itération : c'est un variant, l'algorithme termine après exactement \(inv(t)\) itérations (initialement), et en sortie de boucle il n'y a plus d'inversion directe, donc le tableau est trié d'après le théorème précédent. -
Pour le tri à bulles, chaque itération de la boucle
whilesauf la dernière effectue au moins un échange. La quantité \(inv(t) + [\texttt{echange}]\), où \([\texttt{echange}]\) vaut 1 siechangeest vrai et 0 sinon, est donc un variant : à l'entrée d'une itération elle vaut \(inv(t) + 1 \ge 1\), et à la fin de l'itération soit au moins un échange a eu lieu et \(inv(t)\) a diminué d'au moins 1 alors queechangeest encore vrai, soit aucun échange n'a eu lieu etechangeest passé à faux. Comme elle vaut au plus \(inv(t_0)+1\) initialement, il y a au plus \(inv(t_0) + 1\) itérations.En sortie de boucle,
echangeest faux : le dernier balayage n'a effectué aucun échange, donc n'a pas modifié le tableau, et il a vérifié \(t[i] \le t[i+1]\) pour tout \(i\). Le tableau n'a pas d'inversion directe, il est donc trié.
Enfin, \(inv(t)\) est majoré par le nombre de couples \((i,j)\) avec \(i<j\), c'est-à-dire \(\binom{n}{2} = \frac{n(n-1)}{2}\).
Correction
Pour parler de correction d'un algorithme, il est nécessaire d'identifier précisément ce qui doit être calculé par l'algorithme. Pour cela, on considère ici informellement des spécifications dépendant des entrées et du résultat de l'algorithme. On verra dans le chapitre sur la logique qu'il s'agit ici de prédicats logiques.
Voici des exemples de spécifications :
- le tableau \(t\) en sortie est trié dans l'ordre croissant et contient les mêmes éléments qu'en entrée ;
- la valeur renvoyée est le plus petit indice de \(x\) dans le tableau ou \(-1\) s'il ne le contient pas.
Définition
Un algorithme est correct vis-à-vis d'une spécification lorsque, quelle que soit l'entrée,
- il termine ;
- le résultat renvoyé vérifie la spécification.
On considère également la correction partielle, qui ne demande rien quand l'algorithme ne termine pas :
Définition
Un algorithme est partiellement correct vis-à-vis d'une spécification lorsque, pour toute entrée sur laquelle il termine, le résultat renvoyé vérifie la spécification.
Ainsi, un algorithme est correct si et seulement s'il termine et est partiellement correct.
Invariant de boucle
Définition
On considère ici une boucle (conditionnelle ou non).
Un prédicat est appelé un invariant de boucle lorsque
- il est vérifié avant d'entrer dans la boucle ;
- s'il est vérifié en entrée d'une itération, il est vérifié en sortie de celle-ci.
Quand la boucle termine, on déduit alors, par récurrence sur le nombre d'itérations, que l'invariant est vérifié en sortie de boucle. On cherche donc un invariant qui permette de garantir la spécification en sortie de boucle.
Remarque
Pour les boucles inconditionnelles, il y a une gestion implicite de l'indice de boucle qui va se retrouver dans l'invariant. On peut alors considérer que la sortie de boucle s'effectue après être passé à l'indice suivant.
Dans le cas d'une boucle conditionnelle portant sur la condition \(P\) et ayant un invariant de boucle \(I\), en sortie le prédicat \(\neg P \wedge I\) (non \(P\) et \(I\)) sera vérifié.
On peut illustrer cela en reprenant la fonction
plus_petite_puissance2 vue à la partie Terminaison.
On considère ici le prédicat \(I(k,p) := 2^{k-1} < n \text{ et } p = 2^k\).
- En entrée de boucle, \(k = 0\) et \(p = 1 = 2^0\), et on a bien \(2^{-1} < n\) car \(n \ge 1\).
- Si le prédicat est vérifié en entrée d'itération, on a \(p = 2^k\) et, comme on est entré dans cette itération, \(p = 2^k < n\). Donc en sortie d'itération on aura bien \(I(k+1,2p)\), car \(2p = 2^{k+1}\) et \(2^{(k+1)-1} < n\).
Ainsi, ce prédicat est bien un invariant et en sortie de boucle (ce qui arrive nécessairement, car l'algorithme termine), on a le prédicat \(I(k,p)\), qui signifie que \(2^{k-1} < n\) et \(p = 2^k\), et la condition de sortie de boucle \(p \ge n\), c'est-à-dire \(n \le 2^k\).
La valeur renvoyée est bien l'entier \(k\) tel que \(2^{k-1} < n \le 2^k\), c'est-à-dire le plus petit entier \(k\) tel que \(n \le 2^k\), ce qui était la spécification annoncée du programme.
Exemple
Prouvons la correction de la recherche dichotomique (version itérative) vue
dans la partie Exemple de la recherche dichotomique :
si \(t\) est trié dans l'ordre croissant, la fonction renvoie un indice \(p\) tel
que \(t[p] = x\) si \(x\) apparaît dans \(t\), et -1 (ou None) sinon.
On considère l'invariant \(I(i,j) :=\) « si \(x\) apparaît dans \(t\), alors il apparaît dans \(t[i..j]\) », où \(t[i..j]\) désigne le sous-tableau des indices \(i\) à \(j\) (vide si \(i > j\)).
- Initialisation : avec \(i = 0\) et \(j = n-1\), \(t[i..j]\) est le tableau entier.
- Hérédité : si l'itération ne renvoie pas de valeur, alors \(x \neq m = t[p]\). Si \(x < m\), comme \(t\) est trié, pour tout \(k \ge p\) on a \(t[k] \ge m > x\) ; donc si \(x\) apparaît dans \(t[i..j]\), il apparaît dans \(t[i..p-1]\), et on a \(I(i, p-1)\). Le cas \(x > m\) est symétrique et donne \(I(p+1, j)\).
Si la fonction renvoie \(p\) au cours d'une itération, c'est que \(t[p] = x\).
Sinon, en sortie de boucle on a \(i > j\) : le sous-tableau \(t[i..j]\) est vide
et l'invariant assure que \(x\) n'apparaît pas dans \(t\), donc renvoyer -1 est
correct. Avec la terminaison déjà prouvée, la fonction est correcte.
Exemple du tri par sélection
Le programme suivant présente un algorithme de tri, appelé le tri par sélection, dont on va analyser la correction puis la complexité. Il s'agit d'un tri qui repose sur un principe simple : on va chercher le plus petit élément du tableau restant à trier et le placer à la position courante. On définit ainsi trois fonctions :
echange(ouswap) réalise l'échange de valeurs entre deux cases du tableau ;indice_minimumrenvoie l'indice de la plus petite valeur entre deux indices donnés ;tri_par_selectionréalise le tri en parcourant le tableau du premier au dernier indice et en plaçant à la position courante le minimum restant.
let swap t i j =
    let temp = t.(i) in
    t.(i) <- t.(j);
    t.(j) <- temp

let indice_minimum t min_indice max_indice =
    let i = ref min_indice in
    for j = min_indice + 1 to max_indice do
        if t.(j) < t.(!i)
        then i := j
    done;
    !i

let tri_par_selection t =
    let n = Array.length t in
    for i = 0 to n - 1 do
        swap t i (indice_minimum t i (n-1))
    done
void echange(int *tableau, int i, int j)
{
    int temp = tableau[i];
    tableau[i] = tableau[j];
    tableau[j] = temp;
}

int indice_minimum(int *tableau,
      int min_indice, int max_indice)
{
    int i = min_indice;

    for (int j = min_indice + 1;
         j <= max_indice; j++)
    {
        if (tableau[j] < tableau[i])
            i = j;
    }

    return i;
}

void tri_par_selection(int *tableau, int taille)
{
    for (int i = 0; i < taille; i++)
    {
        echange(tableau, i,
          indice_minimum(tableau, i, taille-1));
    }
}
def swap(t, i, j):
    temp = t[i]
    t[i] = t[j]
    t[j] = temp

def indice_minimum(t, min_indice, max_indice):
    i = min_indice
    for j in range(min_indice+1, max_indice+1):
        if t[j] < t[i]:
            i = j
    return i

def tri_par_selection(t):
    for i in range(0, len(t)-1):
        j = indice_minimum(t, i, len(t)-1)
        swap(t, i, j)
Il n'y a pas de problèmes de terminaison ici, car toutes les boucles sont inconditionnelles. Pour prouver sa correction, on va considérer séparément les deux boucles.
-
Boucle dans
indice_minimum: on va valider l'invariant \(I(i,j) := \text{min_indice} \le i < j \text{ et } \forall k \in \range{\text{min_indice}}{j-1}, \text{tableau}[i] \le \text{tableau}[k]\), où \(j\) est l'indice de l'itération qui commence.- En entrée de boucle, on a \(I(\text{min_indice},\text{min_indice}+1)\) vérifié directement.
- Si en entrée d'itération, \(I(i,j)\) est vérifié, ce qui signifie que
\(\text{tableau}[i]\) est plus petit que les valeurs comprises entre les indices
\(\text{min_indice}\) et \(j-1\), alors on distingue deux cas :
- soit \(\text{tableau}[j] < \text{tableau}[i]\) et alors en sortie \(i\) devient \(i' = j\). On a alors \(\text{tableau}[i'] = \text{tableau}[j] < \text{tableau}[i] \le \text{tableau}[k]\) pour \(k \in \range{\text{min_indice}}{j-1}\). Donc \(I(i',j+1)\) est vérifié.
- soit \(\text{tableau}[i] \le \text{tableau}[j]\) et ainsi on a pu prolonger le prédicat à \(I(i,j+1)\).
Ce prédicat est bien un invariant. Ainsi, en sortie de boucle, et donc avant de renvoyer sa valeur, on a bien \(I(i,\text{max_indice}+1)\), donc \(\text{tableau}[i]\) est la plus petite valeur du sous-tableau des indices \(\text{min_indice}\) à \(\text{max_indice}\). C'est encore vrai si \(\text{min_indice} = \text{max_indice}\), la boucle n'effectuant alors aucune itération. * Boucle dans
tri_par_selection: on va valider l'invariant \(T(i) :=\) le sous-tableautableau[0..i-1]des indices 0 à \(i-1\) est trié et ne contient que des valeurs plus petites que celles du sous-tableautableau[i..taille-1]. * En entrée de boucle, le sous-tableau est vide donc \(T(0)\) est vérifié. * Si en entrée d'itération, le prédicat est vérifié, on récupère l'indice \(j\) du minimum du sous-tableautableau[i..taille-1]à l'aide de la fonctionindice_minimum. Par hypothèse,tableau[j]est alors supérieur ou égal à chaque élément detableau[0..i-1]; en le plaçant à l'indice \(i\), on a bientableau[0..i]qui est trié et, par construction, la valeur detableau[i]est inférieure à toutes celles detableau[i+1..taille-1]. On a ainsi \(T(i+1)\) vérifié en sortie d'itération.Ce prédicat est bien un invariant. Ainsi, en sortie de boucle, \(T(\text{taille})\) est vérifié : le tableau est trié. Comme il n'a été modifié que par des échanges, il contient les mêmes éléments qu'au départ.
Remarque
La version Python s'arrête à l'indice \(n-2\) : en sortie de boucle on a alors
\(T(n-1)\), ce qui suffit puisque le dernier élément est supérieur ou égal à
tous ceux de t[0..n-2], qui est trié.
Complexité
Complexité dans le pire des cas
Considérons un algorithme pour lequel on peut associer à chaque entrée une notion de taille (par exemple le nombre d'éléments d'un tableau). Pour \(n \in \N\), on note ainsi \(I_n\) l'ensemble des entrées de taille \(n\) pour cet algorithme. Pour une entrée \(e\), on note \(t(e)\) le temps pris, par exemple en secondes, par l'algorithme sur l'entrée \(e\). De même, on note \(s(e)\) l'espace mémoire maximal, par exemple en octets, occupé par l'algorithme au cours de cette exécution sans compter la taille des entrées.
Définition
On appelle :
- complexité temporelle dans le pire des cas, la suite \((C^t_n)_{n \in \N}\) telle que pour tout \(n \in \N\), \(C^t_n = \max_{e \in I_n} t(e)\) ;
- complexité spatiale dans le pire des cas, la suite \((C^s_n)_{n \in \N}\) telle que pour tout \(n \in \N\), \(C^s_n = \max_{e \in I_n} s(e)\).
Si \(I_n\) est infini, on remplace le maximum par une borne supérieure.
Comme on va le voir, calculer explicitement ces suites n'a pas beaucoup d'intérêt tant elles sont dépendantes de la manière dont on mesure le temps et l'espace. Ce qui compte ici, c'est de connaître l'ordre de grandeur de ces complexités en fonction de \(n\).
Considérons par exemple la fonction suivante qui renvoie le maximum d'un tableau non vide.
let maximum t =
    let m = ref t.(0) in
    for i = 1 to Array.length t - 1 do
        if !m < t.(i)
        then m := t.(i)
    done;
    !m
int maximum(int *tableau, int taille)
{
    int M = INT_MIN; /* nécessite limits.h */

    for (int i = 0; i < taille; i++)
    {
        if (M < tableau[i])
            M = tableau[i];
    }

    return M;
}
def maximum(t):
    m = t[0]
    for i in range(1, len(t)):
        if m < t[i]:
            m = t[i]
    return m
Pour un tableau de taille \(n\), ce programme va effectuer \(n\) itérations (ou \(n-1\) selon la version) et sa complexité est ainsi de l'ordre de \(n\). Il est possible d'être très précis en considérant les temps pris
- pour mettre en place l'appel de fonction et le passage des arguments ;
- par la gestion de l'indice de la boucle
for; - pour la comparaison, puis pour l'affectation éventuelle ;
- pour mettre en place la valeur de retour afin que le résultat soit lu.
On peut remarquer que la notion de pire cas dépend de la précision à laquelle on se place. Ici, si on ne s'intéresse qu'à l'ordre de grandeur, tous les tableaux de taille \(n\) sont équivalents. Par contre, si on cherche avec précision le pire cas, il est atteint avec un tableau trié par ordre strictement croissant, car c'est le cas qui effectue une affectation à chaque itération.
Comparer des complexités
Avant de pouvoir comparer les complexités des algorithmes ou des programmes, il est nécessaire de mettre en place des outils pour en parler à la fois avec précision mais également sans rentrer dans des détails d'implémentation non pertinents.
En effet, comparons les deux fonctions suivantes permettant de chercher un élément dans un tableau.
A - Sortie prématurée
let recherche t elem =
    let ind = ref None in
    let i = ref 0 in
    let n = Array.length t in
    while !ind = None && !i < n do
        if t.(!i) = elem
        then ind := Some !i;
        incr i
    done;
    !ind
int recherche(int *tab, size_t nb, int elem)
{
    for (size_t i = 0; i < nb; i++)
    {
        if (elem == tab[i])
            return i;
    }

    return -1;
}
def recherche(t, elem):
    for i in range(len(t)):
        if t[i] == elem:
            return i
    return None
B - Parcours complet
let recherche t elem =
    let ind = ref None in
    for i = 0 to Array.length t - 1 do
        if !ind = None && t.(i) = elem
        then ind := Some i
    done;
    !ind
int recherche(int *tab, size_t nb, int elem)
{
    int ind = -1;

    for (size_t i = 0; i < nb; i++)
    {
        if (ind == -1 && elem == tab[i])
            ind = i;
    }

    return ind;
}
def recherche(t, elem):
    ind = None
    for i in range(len(t)):
        if ind is None and t[i] == elem:
            ind = i
    return ind
La fonction B semble moins efficace que la fonction A, car la fonction
A sort tout de suite dès qu'on a trouvé l'élément alors que la
seconde continue à parcourir t.
Mais on doit se poser la question de la pertinence de cette optimisation selon
le pire des cas. Ici, le pire des cas correspond à ne pas avoir elem dans le
tableau, et à ce moment-là les deux fonctions fonctionnent de la même manière.
Remarque
En fait, la fonction A sera souvent à privilégier, car il est
souvent plus facile d'interrompre le flot que de faire en sorte de préserver
l'état à la place du return pour pouvoir renvoyer la bonne valeur à la fin de
la fonction.
De la même manière, il faut déterminer ce que l'on souhaite compter précisément :
- si on s'intéresse au temps mis, certaines opérations prennent moins de temps que d'autres (par exemple une addition par rapport à une multiplication) mais est-ce vraiment important à l'échelle considérée ?
- si on s'intéresse à l'espace mémoire, doit-on considérer la taille précise en octets ou se contenter d'une estimation plus grossière ?
Mis à part dans certains cadres assez spécifiques, on se contente le plus souvent d'un ordre de grandeur pour ces complexités. Pour cela, on utilise des relations de comparaison de suites et une échelle de grandeur usuelle pour les comparer.
La notation grand O
Définition
Soit \((u_n)_{n\in\N}\) et \((v_n)_{n \in \N}\) deux suites de nombres réels, la suite \((v_n)_n\) étant à termes non nuls. On dit que la suite \((u_n)_n\) est dominée par \((v_n)_n\) lorsque la suite quotient \(\left( \frac{u_n}{v_n} \right)_n\) est bornée.
On note alors \(u_n = O(v_n)\).
Cette dernière notation se lit \(u_n\) est un grand O de \(v_n\).
Remarque
C'est bien cette locution qu'il faut avoir en tête quand on pense aux grands O et il faut faire attention de ne pas considérer l'égalité en tant que telle sans s'assurer que ce que l'on fait est licite. Quand on écrira par la suite \(O(v_n)\) on signifiera n'importe quelle suite qui soit un \(O(v_n)\).
Si \(u_n = O(v_n)\), cela signifie qu'il existe un facteur \(M > 0\) tel que pour tout entier \(n\), on ait \(- M |v_n| \le u_n \le M |v_n|\). Les variations de la suite \((u_n)_n\) sont ainsi entièrement contrôlées par les variations de \((v_n)_n\).
En informatique, on ne considère pour la complexité que des suites positives, ce qui permet de simplifier la relation : si \((u_n)_n\) est une suite de réels positifs et \((v_n)_n\) une suite de réels strictement positifs, alors \(u_n = O(v_n) \iff \exists M > 0, \forall n\in\N, u_n \le M v_n\). C'est le cadre dans lequel on se place implicitement dans la suite de ce document.
Remarque
Des suites comme \((n \log_2 n)_n\) s'annulent ou ne sont pas définies pour les petites valeurs de \(n\) (ici \(n = 0\) et \(n = 1\)). On ne les considère alors qu'à partir d'un certain rang, ce qui ne change rien puisque, comme on va le voir, la notion est asymptotique.
On peut visualiser graphiquement cette relation :

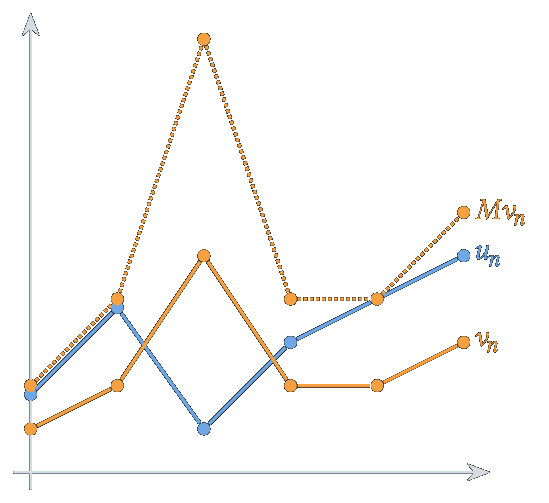
On a \(u_n = O(v_n)\) si et seulement s'il est possible de multiplier les ordonnées de chaque point \((n,v_n)\) par une même constante afin que ces nouveaux points soient tous au-dessus des points \((n,u_n)\). On peut voir que la courbe déduite des \(v_n\) enveloppe, à un facteur près, celle des \(u_n\).
On a relié ici les valeurs des suites pour mieux mettre en valeur cette notion d'enveloppe.
Cette relation est une notion asymptotique : elle n'a d'intérêt que lorsqu'on considère des rangs au voisinage de l'infini. En effet, pour un nombre fini de termes, il est toujours possible de trouver un tel \(M\), mais pour un nombre infini, ce n'est pas le cas.

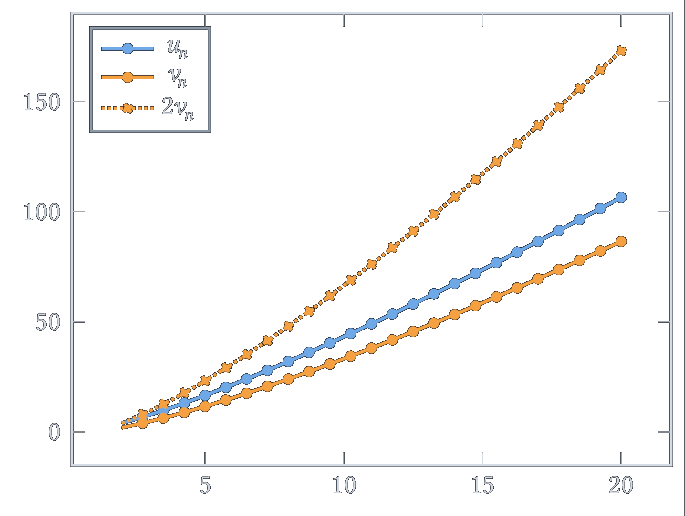
Ici, on compare asymptotiquement les suites \((u_n)_n\) et \((v_n)_n\) où pour \(n \ge 2\), \(u_n = n + n \log_2 n\) et \(v_n = n \log_2 n\). Pour simplifier la visualisation, on a tracé les fonctions correspondantes. On remarque qu'on a bien \(n + n \log_2 n = O(n \log_2 n)\) : pour \(n \ge 2\), \(\log_2 n \ge 1\) donc \(u_n \le 2 v_n\).

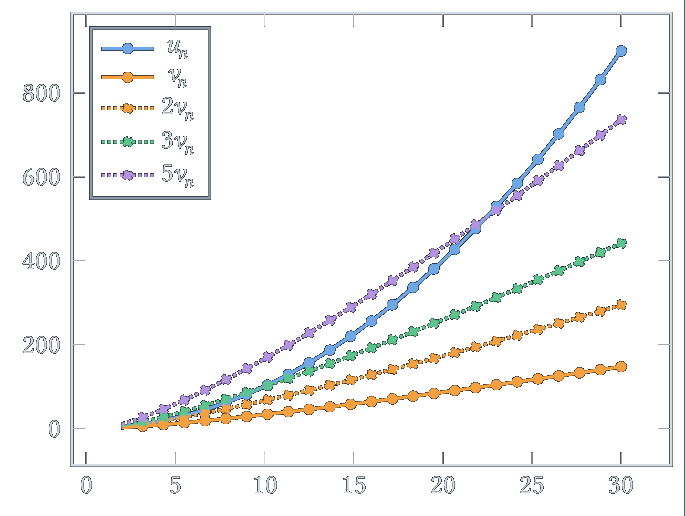
Par contre, si on compare les suites \((u_n)_n\) et \((v_n)_n\) où pour \(n \ge 2\), \(u_n = n^2\) et \(v_n = n \log_2 n\), on remarque que quelle que soit la valeur choisie pour \(M\), il y aura un rang à partir duquel \(u_n > M v_n\) : en effet \(\frac{u_n}{v_n} = \frac{n}{\log_2 n} \rightarrow +\infty\).
Ici, \(n^2 \neq O(n \log_2 n)\).
Remarque
On a ici utilisé le logarithme en base 2, noté \(\log_2\), qui est essentiel en informatique : si \(x = \log_2(n)\) alors \(n = 2^x\) où \(x\) est un réel. On considère aussi \(p = \lceil \log_2(n) \rceil\) qui est le plus petit entier égal ou supérieur à \(\log_2(n)\). On parle de partie entière supérieure et on a alors \(2^{p-1} < n \le 2^p\). Le nombre de chiffres nécessaires pour écrire \(n \ge 1\) en binaire est \(\lfloor \log_2(n) \rfloor + 1\), qui vaut \(p\) ou \(p+1\). On a \(\lceil \log_2(n) \rceil = O(\log_2(n))\) et ainsi, le plus souvent, on ne considère pas la partie entière explicitement. De la même manière, \(\log_2(n) = \frac{\ln n}{\ln 2} = O(\ln n)\).
Un cas important de grand O est celui des \(O(1)\). Si \(u_n = O(1)\), cela signifie que \((u_n)_{n\in\N}\) est une suite bornée.
Échelle de comparaison
On rappelle les limites obtenues en mathématiques que l'on nomme croissances comparées :
Or, si \(\frac{u_n}{v_n} \xrightarrow[n \to +\infty]{} 0\), a fortiori le quotient est borné et \(u_n = O(v_n)\). Ainsi, on a les relations suivantes :
De plus, si \(\alpha \ge \beta > 0\), \(n^\beta = O(n^\alpha)\), \((\log_2 n)^\beta = O((\log_2 n)^\alpha)\) et \(\beta^n = O(\alpha^n)\).
On se ramène souvent à des complexités qui sont des grands O de produits de ces suites.
Ordre de grandeur et relation \(\Theta\)
On vient de voir que \(\log_2 n = O(n)\), mais on a également \(\log_2 n = O(n^2)\). Quand on cherche à caractériser la complexité par un grand O, on va souvent chercher le grand O le plus proche de la suite.
Il est possible de définir cela précisément en considérant des suites qui sont chacune des grands O l'une de l'autre.
Par exemple, on a vu que \(n \log_2 n + n = O(n \log_2 n)\), mais on a également \(n \log_2 n = O(n + n \log_2 n)\).
Quand \(u_n = O(v_n)\) et \(v_n = O(u_n)\), on note \(u_n = \Theta(v_n)\), qui est une relation symétrique qui correspond à la notion avoir le même ordre de grandeur. Très souvent, lorsque l'on parle de complexité, on utilise des grands O quand, en fait, on exprime des \(\Theta\). Par exemple, l'accès à un élément dans un tableau est en \(O(1)\) et il ne serait pas précis de dire que c'est en \(O(n)\) même si c'est parfaitement correct.
On peut visualiser cette relation \(\Theta\) en considérant qu'il existe ainsi \(M,M' > 0\) tels que \(u_n \le M v_n\) et \(v_n \le M' u_n\). Mais on a alors
Ainsi, \(u_n = \Theta(v_n)\) signifie qu'on peut encadrer \((u_n)_n\) entre deux multiples de \((v_n)_n\).

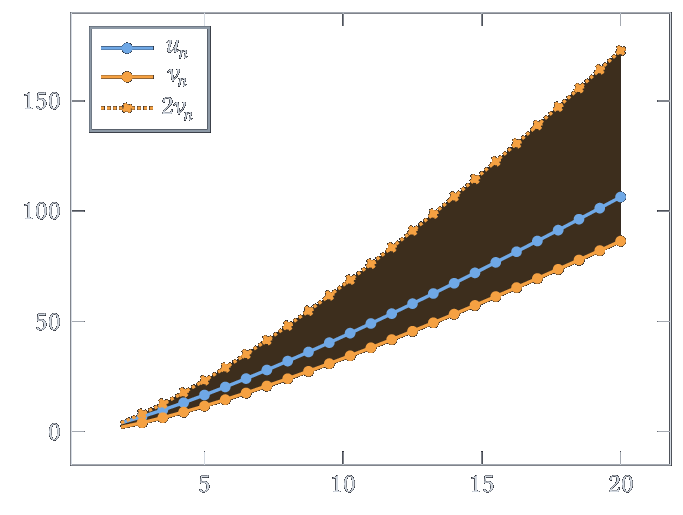
En reprenant la figure précédente, on observe visuellement, pour \(n \ge 2\),
Avoir \(u_n = \Theta(v_n)\) signifie donc que \(u_n\) évolue entre deux guides suivant les variations de \(v_n\).
Définition
Pour des suites strictement positives, on note \(u_n = \Omega(v_n)\) lorsque \(v_n = O(u_n)\), c'est-à-dire lorsqu'il existe \(m > 0\) tel que pour tout \(n \in \N\), \(u_n \ge m v_n\).
Ainsi, \(u_n = \Theta(v_n)\) si et seulement si \(u_n = O(v_n)\) et \(u_n = \Omega(v_n)\). Un grand O exprime une majoration de la complexité, un \(\Omega\) une minoration : par exemple, la recherche d'un élément dans un tableau de taille \(n\) par la fonction A ci-dessus a une complexité dans le pire des cas en \(\Omega(n)\), car il faut parcourir tout le tableau quand l'élément est absent.
Opérations sur les grands O
Si \(u_n = O(w_n)\) et \(v_n = O(w_n)\) alors \(u_n + v_n = O(w_n)\). Ainsi, des grands O de même ordre s'ajoutent.
Remarque
Comme on l'a vu précédemment, un grand O n'est pas très précis, et il est possible que par ajout on puisse obtenir un meilleur grand O. Par exemple : \(n = O(n)\) et \(\log_2 n - n = O(n)\) mais \(n + \log_2 n - n = \log_2 n\), qui est un \(O(\log_2 n)\). Comme on ne considère ici que des suites positives, ce phénomène de compensation n'aura pas lieu.
Si \(u_n = O(v_n)\) et \(w_n\) est une autre suite de réels strictement positifs, alors \(u_n w_n = O(v_n w_n)\). On en déduit ainsi un principe qui nous sera utile par la suite : \(n O(1) = O(n)\).
Complexités en temps classiques
On parle ici de complexité par raccourci pour parler de complexité dans le pire des cas en temps.
Complexité constante
On dit qu'un algorithme a une complexité constante quand \(C^t_n = O(1)\). Il existe ainsi une constante \(M\) telle que le temps pris par l'algorithme sur une entrée quelconque soit inférieur à \(M\).
De nombreuses opérations sont en temps constant sur les structures de données usuelles. Parmi celles-ci, citons-en deux essentielles :
- accéder à une case d'indice quelconque dans un tableau ;
- accéder à la tête ou à la queue (la liste privée de son premier élément) d'une liste chaînée.
Les algorithmes ou opérations en temps constant jouent un rôle primordial dans l'analyse de la complexité d'algorithmes, comme on le verra dans la partie suivante, car elles permettent de se concentrer sur les répétitions de ces opérations pour déterminer la complexité : une boucle qui se répète \(n\) fois et n'effectue que des opérations en temps constant dans son corps sera de complexité \(n O(1) = O(n)\).
Complexité linéaire
On dit qu'un algorithme a une complexité linéaire quand \(C^t_n = O(n)\).
Cette complexité correspond à un traitement de temps constant sur chaque élément d'une entrée de taille \(n\). C'est le cas de la recherche d'un élément dans un tableau ou de la recherche de son maximum.
Pour la recherche linéaire d'un élément, correspondant par exemple au programme
ci-dessous, le pire cas correspond à ne pas avoir x dans tableau, ce qui
oblige à effectuer toutes les itérations. On a bien une complexité temporelle
en pire cas de \(O(n)\).
let recherche t x =
    let n = Array.length t in
    let i = ref 0 in
    while !i < n && t.(!i) <> x do
        incr i
    done;
    if !i < n then Some !i else None
int recherche(int *tableau, size_t taille, int x)
{
    /* renvoie le plus petit indice i tel que
       tableau[i] = x ou -1 si x n'est pas dans
       le tableau */
    for (size_t i = 0; i < taille; i++)
    {
        if (tableau[i] == x)
            return i;
    }

    return -1;
}
def recherche(t, x):
    for i in range(len(t)):
        if t[i] == x:
            return i
    return None
Complexité quadratique, polynomiale
On dit qu'un algorithme a une complexité quadratique quand \(C^t_n = O(n^2)\). Par extension, on dit qu'il a une complexité polynomiale quand il existe \(k \in \N\) tel que \(C^t_n = O(n^k)\). On parle parfois aussi de complexité polynomiale pour des complexités plus précises en \(O(n^\alpha)\) où \(\alpha\) est un réel strictement positif.
L'exemple classique d'un algorithme quadratique est celui dû à un double parcours d'un tableau. On reprend ici l'algorithme de tri par sélection vu dans la partie Exemple du tri par sélection.
Afin d'analyser sa complexité, on procède fonction par fonction pour un tableau de taille \(n\) :
echangeest en temps constant : \(O(1)\).indice_minimumréalise un parcours d'une partie du tableau et effectue des opérations en temps constant à chaque étape. La complexité est donc linéaire : \(O(n)\).tri_par_selectionréalise également un parcours du tableau mais à chaque étape, on appelleindice_minimumqui est en \(O(n)\), la complexité est donc en \(n O(n) = O(n^2)\) : elle est quadratique.
Plus précisément, l'appel indice_minimum t i (n-1) effectue \(n-1-i\)
itérations, donc le tri effectue \(\sum_{i=0}^{n-1} (n-1-i) = \frac{n(n-1)}{2}\)
comparaisons entre éléments du tableau, quelle que soit l'entrée : la complexité
est en \(\Theta(n^2)\).
Complexité logarithmique
On dit qu'un algorithme a une complexité logarithmique quand \(C_n^t = O(\log_2 n)\).
Pour illustrer cette complexité, on reprend l'algorithme de recherche dichotomique vu dans la partie Exemple de la recherche dichotomique.
Chaque opération effectuée dans le corps de la boucle étant en temps constant, la complexité de cet algorithme est proportionnelle au nombre d'itérations, soit, pour la version récursive, au nombre d'appels récursifs.
Si on considère un sous-tableau de \(n = j-i+1 \ge 1\) éléments au début d'une itération, l'itération suivante éventuelle porte sur un sous-tableau de \(p - i = \left\lfloor \frac{n-1}{2} \right\rfloor\) ou de \(j - p = \left\lceil \frac{n-1}{2} \right\rceil = \left\lfloor \frac{n}{2} \right\rfloor\) éléments, donc d'au plus \(\lfloor n/2 \rfloor\) éléments.
Montrons par récurrence sur \(k \in \N\) que si \(n < 2^k\), l'algorithme effectue au plus \(k\) itérations sur un sous-tableau de \(n\) éléments. Pour \(k = 0\), on a \(n = 0\) et aucune itération n'a lieu. Si \(n < 2^{k+1}\), après une première itération, il reste un sous-tableau d'au plus \(\lfloor n/2 \rfloor < 2^k\) éléments, donc au plus \(k\) itérations par hypothèse de récurrence, soit au plus \(k+1\) en tout.
Pour \(n \ge 1\), en prenant \(k = \lfloor \log_2 n \rfloor + 1\), qui vérifie bien \(n < 2^k\), on obtient au plus \(\lfloor \log_2 n \rfloor + 1\) itérations. Donc le nombre d'itérations est en \(O(\log_2 n)\) et c'est ainsi la complexité de l'algorithme.
Complexité quasi-linéaire
On dit qu'un algorithme a une complexité quasi-linéaire quand \(C^t_n = O(n \log_2 n)\). C'est le cas de la plupart des algorithmes efficaces de tri de \(n\) éléments. On peut même montrer qu'il s'agit de la complexité optimale pour les tris qui ne procèdent que par comparaisons entre éléments.
Comme de nombreux algorithmes commencent par effectuer un tri avant d'effectuer un traitement linéaire, on retrouve des algorithmes quasi-linéaires par simple utilisation de ce tri.
Complexité exponentielle
On dit qu'un algorithme a une complexité exponentielle quand \(C^t_n = O(a^n)\) pour un réel \(a > 1\) (et qu'il n'est pas de complexité polynomiale).
Un exemple fondamental d'un tel algorithme est celui de l'énumération de données, par exemple pour chercher une solution par force brute. En effet, il y a \(2^n\) entrées codées sur \(n\) bits et un algorithme cherchant une solution ainsi parmi ces entrées aura une complexité en \(O(2^n)\) si le traitement de chaque entrée est en temps constant.
Estimation de l'impact des complexités sur le temps
Afin de mesurer l'impact d'une complexité, on va considérer un algorithme qui s'exécute en 1 seconde sur une entrée de taille \(n\), et on va calculer combien de temps prendrait ce même algorithme sur une entrée de taille \(10 n\) ou \(100 n\).
Pour simplifier, on considère à chaque fois que \(C^t_n\) correspond exactement à l'ordre du grand O.
| Complexité | Temps pour \(10n\) | Temps pour \(100n\) |
|---|---|---|
| \(1\) | 1 s | 1 s |
| \(\log_2 n\) | 1,003 s | 1,007 s |
| \(n\) | 10 s | 1 min 40 s |
| \(n \log_2 n\) | 14,7 s | 3 min 13 s |
| \(n^2\) | 1 min 40 s | 2 h 46 min 40 s |
| \(2^n\) | \(3 \cdot 10^{19}\) années | \(3 \cdot 10^{289}\) années |
Remarque
Pour déterminer ces valeurs, on a pris la milliseconde comme unité, de sorte que \(C^t_n = 1000\), afin d'en déduire une valeur de \(n\).
Ainsi, si \(\log_2 n = 1000\) on a \(n = 2^{1000}\) et \(\log_2(10n) = 1000 + \log_2 10 \approx 1003{,}3\). Bien sûr, ici, ce nombre \(2^{1000}\) n'est pas réaliste. Dans un contexte de mémoire finie, une complexité logarithmique est identifiable à une complexité constante. Cela justifie la terminologie quasi-linéaire.
Si \(n \log_2 n = 1000\) alors \(n \approx 140{,}2\). Or, \(1402 \log_2 1402 \approx 14\,700\) ms.
Si \(2^n = 1000\), alors \(n \approx 10\). Or \(2^{100}\) ms \(\approx 10^{30}\) ms, soit environ \(3 \cdot 10^{19}\) années.
Calculer des complexités
Deux principes fondamentaux pour calculer des complexités :
- Si on effectue deux passes successives chacune en \(O(u_n)\) alors la complexité globale est en \(O(u_n)\). Il ne s'agit que de reformuler l'addition des grands O. Quand on a deux passes de complexités différentes, il suffit d'utiliser la plus grande complexité. Par exemple, un algorithme qui commence par un tri en \(O(n \log_2 n)\) et qui effectue ensuite un traitement en \(O(n)\) sera de complexité globale \(O(n \log_2 n)\) car le traitement est également en \(O(n \log_2 n)\).
- Si on effectue \(u_n\) itérations et que chaque itération est en \(O(v_n)\) alors l'algorithme a une complexité de \(O(u_n v_n)\). Cela permet de compter le nombre de boucles imbriquées et de se contenter de regarder ce qui se passe dans le corps des boucles.
Complexité à plusieurs paramètres
Jusqu'ici on a considéré des entrées dépendant d'un unique paramètre \(n\), mais il est possible d'avoir des données dépendant de plusieurs paramètres.
On adapte directement la notation des grands O : si \((u_{n,p})\) et \((v_{n,p})\) sont deux suites de réels dépendant de deux paramètres, la seconde étant à termes non nuls, on note toujours \(u_{n,p} = O(v_{n,p})\) quand le quotient est borné.
Données multidimensionnelles
Le cas le plus usuel de complexité dépendant de plusieurs paramètres est celui des données multidimensionnelles comme une image.
Si on considère une opération effectuant un traitement en temps constant sur chaque pixel d'une image de \(w \times h\) pixels, cette opération aura une complexité en \(O(w h)\). On ne peut plus parler de complexité linéaire ou quadratique ici car cela dépend d'une éventuelle relation entre \(w\) et \(h\) : si on ne travaille que sur des images de taille \(1 \times h\) alors la complexité est \(O(h)\), mais si on ne travaille que sur des images carrées, donc pour lesquelles \(w = h\), la complexité est \(O(h^2)\).
Plus généralement, si on considère des données organisées dans des tableaux imbriqués, on effectuera un traitement sur chaque donnée à l'aide de boucles imbriquées non conditionnelles. La complexité sera alors celle du corps de boucles multipliée par le produit du nombre d'itérations de chaque boucle.
Compromis entre paramètres
Dans certains cas, en particulier pour les graphes, on peut effectuer des traitements successifs dont la complexité ne s'exprime pas en fonction du même paramètre. Imaginons par exemple un programme ayant la structure suivante :
for i = 0 to n-1 do
    (* corps de boucle en O(1) *)
done;

for j = 0 to p-1 do
    (* corps de boucle en O(1) *)
done
for (int i = 0; i < n; i++)
{
    /* corps de boucle en O(1) */
}

for (int j = 0; j < p; j++)
{
    /* corps de boucle en O(1) */
}
for i in range(n):
    # corps de boucle en O(1)

for j in range(p):
    # corps de boucle en O(1)
La complexité de la première boucle est en \(O(n)\) et celle de la deuxième en \(O(p)\). La complexité globale est en \(O(n+p)\) car \(n \le n+p\) et \(p \le n+p\).
Complexité en moyenne
On reprend ici les notations de la partie Complexité dans le pire des cas.
Définition
Lorsque pour tout \(n \in \N\), \(I_n\) est fini et non vide, on appelle :
- complexité temporelle en moyenne la suite \((C^{t,m}_n)_n\) définie par \(C^{t,m}_n = \frac{1}{|I_n|} \sum_{e\in I_n} t(e)\) ;
- complexité spatiale en moyenne la suite \((C^{s,m}_n)_n\) définie par \(C^{s,m}_n = \frac{1}{|I_n|} \sum_{e\in I_n} s(e)\).
On peut étendre cette définition à un cadre infini en considérant une distribution de probabilité sur \(I_n\) et \(T_n\) la variable aléatoire associée à \(t\) sur \(I_n\). Si \(T_n\) est d'espérance finie, on pourra parler de complexité en moyenne pour la suite des \(E(T_n)\). Concrètement, pour \(I_n\) dénombrable, on considère alors une fonction \(p_n : I_n \rightarrow [0,1]\) telle que \(\sum_{e \in I_n} p_n(e) = 1\) et, lorsque la somme converge, on note ainsi
Un exemple usuel de calcul de complexité en moyenne est celui des tris. En effet, même si les entrées de taille \(n\) sont en nombre infini, on peut considérer qu'un tableau de valeurs deux à deux distinctes est l'image par une permutation du tableau trié. Si le tableau est de taille \(n\), on aura ainsi \(n!\) permutations ce qui permet, du moment que le comportement de l'algorithme de tri considéré ne dépend que de cette permutation, de calculer la complexité en moyenne sur l'ensemble des permutations, supposées équiprobables.
Remarque
Les permutations d'un ensemble sont les applications bijectives de cet ensemble dans lui-même. Si l'ensemble contient \(n\) éléments, il y a \(n!\) permutations.
Par exemple, les six permutations sur l'ensemble \(\{1,2,3\}\) correspondent aux diagrammes sagittaux suivants :
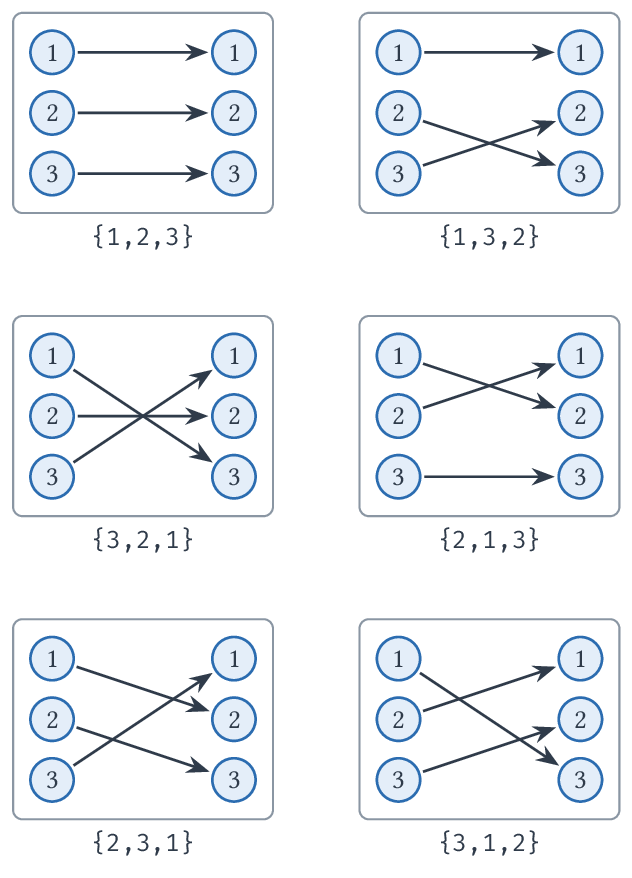
Ces six permutations correspondent elles-mêmes, de gauche à droite et de haut
en bas, aux tableaux {1,2,3}, {1,3,2}, {3,2,1}, {2,1,3}, {2,3,1} et
{3,1,2}.
Exemple de calcul de complexité temporelle en moyenne
On considère la recherche linéaire vue dans la partie Complexité linéaire. L'ensemble des entrées est ici infini, on va donc supposer pour faire le calcul qu'on ne considère que des tableaux de valeurs deux à deux distinctes et qu'on recherche un élément présent dans le tableau, chaque élément étant équiprobable.
Si on recherche le \(i\)-ème élément du tableau, l'algorithme effectue \(i\) itérations avant d'y accéder et de renvoyer son indice. Ainsi, le temps pour cette entrée est de \(i C\) où \(C\) est le coût d'une itération (en négligeant les opérations effectuées hors de la boucle).
La complexité temporelle en moyenne est alors \(C^{t,m}_n = \sum_{i=1}^{n} \frac{1}{n} i C = \frac{(n+1)C}{2} = \Theta(n)\). On retrouve ici le même ordre de grandeur que la complexité dans le pire des cas. La sortie prématurée de la boucle divise en moyenne le temps par deux environ, mais n'a donc aucune influence sur l'ordre de grandeur de la complexité.
Complexité amortie
Dans le cadre de l'étude des structures de données, il est fréquent de considérer non pas la complexité dans le pire des cas d'une opération mais celle d'une succession d'opérations divisée par le nombre d'opérations effectuées. Ainsi, on peut très bien avoir une opération ponctuellement plus coûteuse que les autres, mais en procédant ainsi on lisse le surcoût sur l'ensemble des opérations. On parle alors de complexité amortie.
L'étude de la complexité amortie est traitée dans le chapitre Complexité amortie.
Pertinence de la complexité spatiale
Même si la complexité temporelle est le plus souvent celle qui est importante à calculer, certains algorithmes ont une complexité temporelle faible mais en contrepartie une complexité spatiale élevée. On parle alors de compromis temps-mémoire.
Un exemple classique d'un tel compromis est celui de la programmation dynamique où on passe d'une complexité temporelle exponentielle à une complexité temporelle polynomiale en stockant des valeurs intermédiaires pour ne pas les recalculer. En procédant ainsi, on utilise de la mémoire supplémentaire pour stocker ces valeurs, souvent dans un tableau de taille polynomiale.
Cela est illustré dans le programme suivant qui permet de déterminer le \(n\)-ième terme de la suite de Fibonacci, ce qui n'a pas d'intérêt informatique mais est caractéristique des récurrences que l'on résoudra par la programmation dynamique. Le nombre d'appels de la version exponentielle est calculé dans la partie Complexité en nombre d'appels du chapitre sur la récursivité.
(* Fibonacci exponentiel *)
let rec fibo n =
    if n = 0
    then 0
    else if n = 1
    then 1
    else fibo (n-1) + fibo (n-2)

(* Fibonacci linéaire *)
let fibo n =
    (* n+2 cases pour que prec.(1) existe même si n = 0 *)
    let prec = Array.make (n+2) 0 in
    prec.(1) <- 1;
    for i = 2 to n do
        prec.(i) <- prec.(i-1) + prec.(i-2)
    done;
    prec.(n)
/* Fibonacci exponentiel */
int fibo_exp(int n)
{
    if (n == 0)
        return 0;
    else if (n == 1)
        return 1;
    else
        return fibo_exp(n-1) + fibo_exp(n-2);
}

/* Fibonacci linéaire */
int fibo(int n)
{
    /* n+2 cases pour que prec[1] existe même si n = 0 */
    int *prec = malloc((n+2) * sizeof(int));
    prec[0] = 0;
    prec[1] = 1;
    for (int i = 2; i <= n; i++)
        prec[i] = prec[i-1] + prec[i-2];
    int res = prec[n];
    free(prec);
    return res;
}
# Fibonacci exponentiel
def fibo(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1
    else:
        return fibo(n-1) + fibo(n-2)

# Fibonacci linéaire
def fibo(n):
    # n+2 cases pour que prec[1] existe même si n = 0
    prec = [0] * (n+2)
    prec[1] = 1
    for i in range(2, n+1):
        prec[i] = prec[i-1] + prec[i-2]
    return prec[n]
Remarque
Sur cet exemple, la version exponentielle n'est pas pour autant économe en mémoire : la profondeur maximale des appels récursifs est \(n\), donc sa complexité spatiale est déjà en \(\Theta(n)\) à cause de la pile d'appels (voir le chapitre Récursivité). La version linéaire utilise un tableau de taille \(n+2\), donc aussi un espace en \(\Theta(n)\) ; on pourrait même se contenter de conserver les deux derniers termes calculés pour obtenir une complexité spatiale constante. Le compromis temps-mémoire apparaît vraiment quand le tableau des valeurs intermédiaires est plus grand que la profondeur de récursion, ce qui sera fréquent en programmation dynamique.
Exercices
Exercice
On considère le programme suivant :
let multiplication x y c =
    let m = ref 0 in
    let vy = ref y in
    let vx = ref x in
    while !vy <> 0 do
        m := !m + !vx * (!vy mod c);
        vx := !vx * c;
        vy := !vy / c
    done;
    !m
int multiplication(int x, int y, int c)
{
    int m = 0;
    while (y != 0)
    {
        m = m + x * (y % c);
        x = x * c;
        y = y / c;
    }
    return m;
}
def multiplication(x, y, c):
    m = 0
    while y != 0:
        m = m + x * (y % c)
        x = x * c
        y = y // c
    return m
On suppose que \(c \ge 2\) et que \(x, y \in \N\).
- Montrer que cet algorithme termine.
- Montrer qu'il renvoie le produit \(xy\).
- Réécrire ce programme en récursif. Peut-on déduire des preuves précédentes que l'algorithme termine et qu'il est correct ?
Corrigé
- La quantité \(y\) est un entier naturel, et tant que la condition de boucle est vérifiée, \(y > 0\) ; comme \(c \ge 2\), on a alors \(\lfloor y / c \rfloor \le y/2 < y\). Ainsi \(y\) est un variant de boucle.
-
On va commencer par noter \(x_0\) et \(y_0\) les valeurs initiales respectives de \(x\) et de \(y\). On va également tenir compte du nombre d'itérations, ce qui revient à rajouter un compteur \(i\) au programme. On va également noter \(y_0 = \sum_{j=0}^{d} a_j c^j\) l'écriture de \(y_0\) en base \(c\), avec \(a_j \in \range{0}{c-1}\) et \(a_d \neq 0\) si \(y_0 \neq 0\).
- \(y = \left\lfloor \frac{y_0}{c^i} \right\rfloor = \sum_{j=i}^d a_j c^{j-i}\) et \(x = x_0 c^i\) sont des invariants directement validés. En particulier, au début de l'itération \(i\), \(y \bmod c = a_i\), et la boucle s'arrête quand \(y = 0\), c'est-à-dire après \(d+1\) itérations (aucune si \(y_0 = 0\)).
- On va maintenant prouver l'invariant \(I(i,m) := m = x_0 \sum_{j=0}^{i-1} a_j c^j\).
- Initialisation : avant la première itération, on a \(I(0,0)\) qui est vérifié car la somme est vide.
- Hérédité : si l'invariant est vérifié au début de l'itération \(i\), on a \(m + x (y \bmod c) = x_0 \sum_{j=0}^{i-1} a_j c^j + x_0 c^i a_i = x_0 \sum_{j=0}^i a_j c^j\), donc \(I(i+1,m+x(y \bmod c))\) est vérifié en fin d'itération.
Ainsi, en sortie de boucle, on a \(m = x_0 \sum_{j=0}^{d} a_j c^j = x_0 y_0\) (et \(m = 0 = x_0 y_0\) si \(y_0 = 0\)).
Remarque : on peut aussi utiliser l'invariant plus simple \(m + xy = x_0 y_0\). En effet, en notant \(y = cq + r\) la division euclidienne, \(m + xr + (xc)q = m + x(cq + r) = m + xy\). En sortie de boucle \(y = 0\), donc \(m = x_0 y_0\).
3. Une version récursive :

    === "ocaml"

        ```ocaml
        let rec multiplication x y c =
            if y = 0
            then 0
            else x * (y mod c) + multiplication (x*c) (y/c) c
        ```

    === "c"

        ```c
        int multiplication(int x, int y, int c)
        {
            if (y == 0)
                return 0;
            return x * (y % c) + multiplication(x * c, y / c, c);
        }
        ```

    === "python"

        ```python
        def multiplication(x, y, c):
            if y == 0:
                return 0
            return x * (y % c) + multiplication(x * c, y // c, c)
        ```

    !!! claude-modifie "✎ Modifié par Claude — remarque de l'auteur développée en preuve par récurrence forte"

        Les idées des preuves précédentes s'adaptent directement, mais il faut
        les présenter différemment, sans invariant de boucle. La terminaison
        vient de ce que le paramètre $y$ est un entier naturel qui diminue
        strictement à chaque appel récursif. Pour la correction, on montre par
        récurrence forte sur $y \in \N$ que `multiplication x y c` renvoie $xy$
        pour tout $x$ : c'est vrai pour $y = 0$ et, si $y > 0$, en écrivant
        $y = cq + r$ avec $q = \lfloor y/c \rfloor < y$, l'hypothèse de
        récurrence donne le résultat $xr + (xc)q = x(cq+r) = xy$.
Exercice
On considère un polynôme \(P=\sum_{i=0}^n c_i X^i\) représenté comme un tableau de \(n+1\) coefficients tel que pour tout \(i \in \range{0}{n}, P[i] = c_i\).
On veut calculer \(P(a)\) pour une valeur \(a\). Pour simplifier, on va considérer ici que les valeurs sont toutes entières.
let horner p a =
    let v = ref 0 in
    for i = Array.length p - 1 downto 0 do
        v := a * !v + p.(i)
    done;
    !v
int horner(const int *P, int n, int a) { int v = 0; for (int i = n; i >= 0; i--) { v = a * v + P[i]; } return v; }def horner(P, a): v = 0 # rappel : reversed(P) parcourt P # en sens inverse for c in reversed(P): v = a * v + c return v- Montrer que ce programme est correct.
- Combien effectue-t-il de multiplications et d'additions ?
- Comparer avec l'algorithme obtenu en ajoutant chaque \(c_i a^i\) pour \(i\) croissant et en maintenant une variable pour \(a^i\).
Corrigé
-
On considère l'invariant \(I(v,i) := v = c_{i+1} + c_{i+2} a + \dots + c_{n} a^{n-i-1}\), où \(i\) est l'indice de l'itération qui commence.
- Initialisation : avant la première itération on a \(I(0,n)\) vérifié car \(v = 0\) et la somme est vide.
- Hérédité : si l'invariant est vérifié en début d'itération, on passe à \(I(a v + c_i, i-1)\) en fin d'itération. Or, si \(v = c_{i+1} + \dots + c_n a^{n-i-1}\), on a bien \(a v + c_i = c_i + c_{i+1} a + \dots + c_n a^{n-i}\) et donc l'invariant est vérifié en fin d'itération.
En sortie de boucle, on a alors \(I(v, -1)\) donc \(v = c_0 + c_1 a + \dots + c_n a^n = P(a)\).
-
On effectue \(n+1\) itérations et à chaque itération une multiplication et une addition, donc \(n+1\) multiplications et \(n+1\) additions (la première itération calcule \(a \times 0 + c_n\) : on pourrait économiser une multiplication et une addition en initialisant \(v\) à \(c_n\)).
- Pour cet algorithme, on devrait faire une multiplication de plus à chaque itération pour maintenir \(a^i\) : il effectue de l'ordre de \(2n\) multiplications au lieu de \(n\), pour le même nombre d'additions.
Exercice
On considère le problème du drapeau hollandais : étant donné un tableau \(t\) et un indice \(i\), on note
p=t[i], on cherche à permuter les éléments detde sorte qu'il y ait trois zones dans le tableau : les éléments \(< p\), les éléments \(= p\) puis les éléments \(> p\).Ainsi, si on considère
t = [5, 2, 3, 5, 1, 4]etp=t[2]=3on pourra obtenir[2, 1, 3, 5, 5, 4]à l'issue de cet algorithme.- Écrire un programme résolvant ce problème en temps linéaire.
- Prouver sa correction.
Corrigé
Le programme :
void echange(int *t, int i, int j)
{
    int temp = t[i];
    t[i] = t[j];
    t[j] = temp;
}

void drapeau(int *t, int nb, int i)
{
    int v = t[i];
    int l = 0;
    int c = nb-1;
    int r = nb-1;

    while (l <= c)
    {
        int w = t[l];
        if (w < v)
        {
            l = l+1;
        }
        else if (w == v)
        {
            echange(t, l, c);
            c = c-1;
        }
        else
        {
            echange(t, l, c);
            echange(t, c, r);
            c = c-1;
            r = r-1;
        }
    }
}
Sur l'exemple de l'énoncé, ce programme produit
[1, 2, 3, 5, 4, 5], qui convient aussi : la solution n'est pas unique.L'idée de cet algorithme est d'avoir trois indices \(l, c\) et \(r\) (pour left, center et right) qui délimitent quatre zones :
- celle des indices \(0\) à \(l-1\) qui contient des valeurs \(< v\) ;
- celle des indices \(l\) à \(c\) qui contient les valeurs pas encore traitées ;
- celle des indices \(c+1\) à \(r\) qui contient des valeurs égales à \(v\) ;
- celle des indices \(r+1\) à \(nb-1\) qui contient des valeurs \(> v\).
Au départ, les trois zones de valeurs traitées sont vides et au fur et à mesure de l'algorithme, elles augmentent jusqu'à couvrir l'ensemble du tableau. Comme, à chaque itération, soit \(l\) croît de 1, soit \(c\) décroît de 1, la quantité \(c - l\), positive tant qu'on entre dans la boucle, est un variant de boucle qui diminue d'exactement 1 à chaque itération : on effectue exactement \(nb\) itérations, chacune en temps constant, et la complexité est linéaire.
On va montrer que le découpage des zones est effectivement un invariant (la zone des valeurs non traitées n'étant soumise à aucune condition) :
- Initialisation : au départ, comme on l'a vu, les trois zones de valeurs traitées sont vides donc l'invariant est trivialement vérifié.
-
Hérédité : si l'invariant est vrai au début d'une itération, on va faire trois cas selon la position de
w = t[l]par rapport àv:- Si
w < valors, après incrémentation de \(l\), la zone des indices de \(0\) à \(l-1\) contient toujours des valeurs \(< v\) et les autres zones n'ont pas bougé, l'invariant est encore vérifié. - Si
w = valors on place cette valeurwà l'indice \(c\), au début de la zone centrale une fois \(c\) décrémenté, et la valeur non traitée qui était à l'indice \(c\) passe à l'indice \(l\). Les autres zones ne sont pas touchées, donc l'invariant est encore vérifié. -
Si
w > v, le premier échange placewà l'indice \(c\) et la valeur non traitée d'indice \(c\) à l'indice \(l\). Le second échange distingue deux cas :- si \(c < r\), la zone centrale est non vide et
t[r]vaut \(v\) : l'échange place \(v\) à l'indice \(c\) etwà l'indice \(r\). Après décrémentation de \(c\) et \(r\), la zone centrale est formée des indices \(c+1\) (ancien \(c\), qui contient \(v\)) à \(r\) (ancien \(r-1\)), qui contiennent tous \(v\), et la zone de droite commence à l'ancien indice \(r\), qui contientw\(> v\) ; - si \(c = r\), la zone centrale est vide, le second échange ne fait
rien, et après décrémentation la zone de droite commence à l'ancien
indice \(c = r\) qui contient
w\(> v\), la zone centrale restant vide.
Dans les deux cas, la première zone n'a pas bougé et l'invariant est vérifié.
- si \(c < r\), la zone centrale est non vide et
- Si
On a donc validé l'invariant. En sortie de boucle, on a \(l = c+1\) : la zone des valeurs non traitées est vide, donc les trois autres zones couvrent l'intégralité du tableau, ce qui est le résultat voulu. Enfin, le tableau n'ayant été modifié que par des échanges, il contient les mêmes éléments qu'au départ.