Dans ce chapitre, on étudie des algorithmes ayant la particularité de reposer sur une division d'un problème en plusieurs sous-problèmes :
- soit pour les résoudre récursivement, on parle alors de la méthode diviser pour régner ;
- soit pour résoudre ces sous-problèmes, peut-être d'une manière différente, afin d'obtenir une solution plus efficace au problème principal, on parle de rencontre au milieu (ou meet in the middle).
Diviser pour régner
Principe
Le principe des algorithmes de type diviser pour régner est de décomposer un problème en plusieurs sous-problèmes disjoints et de déduire des solutions de ces sous-problèmes une solution au problème de départ.
Le point clé pour ce principe est de pouvoir fusionner les solutions de sous-problèmes pour en faire une solution, et de pouvoir le faire dans un temps/espace raisonnable. On procède alors par récursivité en appliquant ce principe pour résoudre les sous-problèmes eux-mêmes jusqu'à tomber sur des sous-problèmes très simples.
Ainsi, si on a une entrée \(E\), on va en déduire des entrées \(E_1, \dots, E_k\) pour des sous-problèmes telles que \(|E_i| \le \left \lceil \frac{|E|}{p} \right\rceil\), où \(p \ge 2\) et \(k \ge 1\) sont indépendants de \(E\). Une fois les solutions \(S_1, \dots, S_k\) à ces sous-problèmes obtenues par des appels récursifs, on va en déduire par une fusion des solutions la solution \(S\) au problème initial.
En termes de complexité temporelle, si \(T(n)\) est la complexité de résolution pour une entrée de taille \(n\), on aura pour \(n \ge 2\) :
où \(f(n)\) est le coût de la division et de la fusion, et en supposant, ce qui est très raisonnable, que \(T\) est croissante.
Remarque
La croissance de \(T\) est naturellement déduite du fait que le problème sur une entrée de taille \(n\) est plus facile que le problème sur une entrée de taille \(m \ge n\). On peut ainsi penser au tri d'un tableau où il suffit de rajouter des éléments factices au début ou à la fin pour se ramener à un problème sur une entrée de taille plus grande.
On commence par faire des preuves dans des cas particuliers, puis on énoncera un théorème général dans la partie Principe général d'analyse des récurrences.
Somme d'éléments dans un tableau
On considère un tableau \(t\) de \(n\) nombres dont on cherche à calculer la somme \(S(t) = \sum_{i=0}^{n-1} t[i]\). Il est possible de faire ce calcul très aisément avec une simple boucle :
let somme t =
    let s = ref 0 in
    for i = 0 to Array.length t - 1 do
        s := !s + t.(i)
    done;
    !s
int somme(int *t, size_t nb)
{
    int s = 0;
    for (size_t i = 0; i < nb; i++)
    {
        s = s + t[i];
    }
    return s;
}
def somme(t):
    s = 0
    for x in t:
        s = s + x
    return s
Il est possible, bien que cela ne soit pas naturel, de traiter ce problème avec un algorithme diviser pour régner. En effet, on peut couper le tableau en deux, calculer les deux sous-sommes \(S_1\) et \(S_2\), puis les fusionner de manière triviale en calculant la somme \(S = S_1+S_2\).
let rec somme_div t i j =
    if i > j
    then 0
    else if i = j
    then t.(i)
    else
        let m = i + (j-i)/2 in
        let s1 = somme_div t i m in
        let s2 = somme_div t (m+1) j in
        s1 + s2

let somme t = somme_div t 0 (Array.length t - 1)
Le cas i > j ne sert que pour le tableau vide : les appels récursifs se font
toujours sur des sous-tableaux non vides.
Si \(T(n)\) est le coût d'une somme d'un tableau à \(n\) éléments, on a donc \(T(1) = 1\) et
Remarque
On constate ici qu'on utilise \(\lceil x \rceil\) la partie entière supérieure liée à une majoration. En effet, si on coupe l'entrée en deux et qu'elle est de taille impaire \(2 q+1\), une des deux moitiés sera de longueur \(q + 1\) qui est la partie entière supérieure.
On aura alors \(T(n) = T(q) + T(q+1) + O(1) \le 2 T(q+1) + O(1)\) par croissance de \(T\).
Les résolutions de récurrence vont se faire en deux temps : un cas où toutes les divisions tombent juste, c'est-à-dire ici une puissance de deux, et un théorème où on s'y ramène pour un entier quelconque par encadrement et croissance de \(T\).
Lemme
\(\forall n \in \N, T(2^n) = O(2^n)\)
Preuve
On commence par expliciter le \(O(1)\) présent dans la récurrence : il existe \(M \ge 1\) tel que \(\forall n \ge 2, T(n) \le 2 T(\lceil n/2 \rceil) + M\).
Montrons par récurrence que \(\forall n \in \N, T(2^n) \le M (2^{n+1} - 1)\).
- On a \(T(2^0) = 1 \le M = M(2^1 - 1)\).
- Si \(T(2^n) \le M (2^{n+1} - 1)\) alors \(T(2^{n+1}) \le 2 T(2^n) + M \le 2M(2^{n+1} - 1) + M = M (2^{n+2} - 1)\).
On a ainsi \(T(2^n) \le 2M \cdot 2^n\), donc \(T(2^n) = O(2^n)\).
Théorème
\(T(n) = O(n)\).
Preuve
Soit \(n \in \N^*\), il existe \(q \in \N\) tel que \(2^q \le n < 2^{q+1}\). Par croissance de \(T\), on a \(T(n) \le T(2^{q+1})\). Or, d'après le lemme, il existe \(M'\) tel que \(\forall k, T(2^k) \le M' 2^k\). Donc \(T(n) \le M' 2^{q+1} \le 2 M' n\).
Donc, \(T(n) = O(n)\).
Tri fusion
L'algorithme du tri fusion est un des exemples les plus importants d'algorithmes diviser pour régner :
- Étant donnée une liste \(l\) de taille \(n \ge 2\), on va considérer les sous-listes \(l_1\) des valeurs d'indice pair et \(l_2\) des valeurs d'indice impair.
- On trie ensuite \(l_1\) et \(l_2\) pour obtenir \(l'_1\) et \(l'_2\).
- On fusionne ces deux listes pour obtenir \(l' = \text{fusion}(l'_1,l'_2)\), liste triée déduite de \(l\).
Comme expliqué dans le paragraphe précédent, les tris de \(l_1\) et \(l_2\) s'effectuent eux aussi à l'aide d'un tri fusion.
Voici une implémentation en OCaml de cet algorithme :
let rec separe_en_deux l =
    match l with
    | [] -> ([], [])
    | [x] -> ([x], [])
    | x::y::q -> let l1, l2 = separe_en_deux q in
        (x::l1, y::l2)

let rec fusionne l1 l2 =
    match l1, l2 with
    | [], _ -> l2
    | _, [] -> l1
    | x::q1, y::q2 ->
        if x < y
        then x :: (fusionne q1 l2)
        else y :: (fusionne l1 q2)

let rec tri_fusion l =
    match l with
    | [] -> []
    | [x] -> [x]
    | _ ->
        let l1, l2 = separe_en_deux l in
        let l1p = tri_fusion l1 in
        let l2p = tri_fusion l2 in
        fusionne l1p l2p
Propriété
Pour toute liste l, tri_fusion l termine et renvoie une liste triée
dans l'ordre croissant contenant les mêmes éléments que l, avec les mêmes
multiplicités.
Preuve
separe_en_deux lrenvoie deux listes de longueurs \(\lceil n/2 \rceil\) et \(\lfloor n/2 \rfloor\) dont la concaténation est une permutation del(récurrence immédiate de deux en deux sur \(n = |l|\)).fusionne l1 l2termine car \(|l_1| + |l_2|\) décroît strictement à chaque appel. Montrons par récurrence sur \(|l_1| + |l_2|\) que si \(l_1\) et \(l_2\) sont triées,fusionne l1 l2est triée et contient exactement les éléments de \(l_1\) et de \(l_2\). C'est clair si une des listes est vide. Sinon, si \(x < y\), par hypothèse de récurrencefusionne q1 l2est une liste triée formée des éléments de \(q_1\) et \(l_2\) ; tous sont \(\ge x\) car \(l_1\) est triée et \(x < y \le\) tout élément de \(l_2\). Doncx :: fusionne q1 l2est triée. Le cas \(x \ge y\) est symétrique.- Pour
tri_fusion, on raisonne par récurrence forte sur \(n = |l|\). Les cas \(n \le 1\) sont immédiats. Si \(n \ge 2\), on a \(\lceil n/2 \rceil < n\) et \(\lfloor n/2 \rfloor < n\), donc par hypothèse de récurrence les deux appels récursifs terminent et renvoient des listes triées formées des éléments de \(l_1\) et \(l_2\). Le point précédent permet de conclure.
On se concentre maintenant sur le calcul de la complexité temporelle :
separe_en_deuxconsiste en un parcours linéaire de la listeldonc \(O(|l|)\).fusionnesupprime un élément d'une des deux listes à chaque appel récursif, donc une complexité en \(O(|l_1|+|l_2|)\).- Pour
tri_fusionla situation est plus complexe en raison du double appel récursif. On va d'abord traiter le cas des listes contenant \(2^k\) éléments.
Notons \(t_n\) la complexité temporelle pour \(|l|=n\).
Lemme
\(t_{2^n} = O(2^n \log_2 2^n)\)
Preuve
Par l'analyse de complexité des deux fonctions auxiliaires, on a pour \(n \in \N\)
où on peut supposer, quitte à l'augmenter, que \(M \ge 1\) et \(M \ge t_1\).
On va montrer par récurrence sur \(n \in \N^*\) que \(t_{2^n} \le 2 M n 2^n\).
- Initialisation : \(t_{2^1} \le 2 t_1 + M \le 3 M \le 4 M = 2 M \times 1 \times 2^1\).
- Hérédité : si \(n \in \N^*\) et l'hypothèse est vérifiée pour \(t_{2^n}\), alors \(t_{2^{n+1}} \le 4 n 2^n M + M 2^n = (4n +1) M 2^n \le 4 (n+1) M 2^n = 2 M (n+1) 2^{n+1}\).
Ainsi \(t_{2^n} = O(n 2^n)\).
Théorème
\(t_n = O(n \log_2 n)\)
Preuve
Le lemme assure qu'il existe \(M'\) tel que \(\forall q \in \N^*, t_{2^q} \le M' q 2^q\).
Soit \(n \ge 2\), on sait qu'il existe \(q \in \N^*\) tel que \(2^{q-1} \le n < 2^{q}\) et donc \(q - 1 \le \log_2 n < q\). Par croissance de \(t\) (direct car on a plus d'éléments à trier) on a \(t_n \le t_{2^q} \le M' q 2^q \le 2 M' (1 + \log_2 n) n \le 4 M' n \log_2 n\) car \(1 \le \log_2 n\).
Ainsi, \(t_n = O(n \log_2 n)\).
Remarque
On a utilisé implicitement la croissance de \(t_n\) ici : plus la liste est longue, plus on effectue d'opérations.
Le programme suivant présente une implémentation du tri fusion reposant sur des tableaux. Les sous-tableaux sont manipulés à l'aide de leurs indices de début et de fin comme pour la recherche dichotomique.
let fusionne t1 t2 =
    let n1 = Array.length t1 in
    let n2 = Array.length t2 in
    let i1 = ref 0 in
    let i2 = ref 0 in
    let i = ref 0 in
    let t = Array.make (n1+n2) t1.(0) in (* t1 est supposé non vide *)
    while !i1 < n1 || !i2 < n2 do
        if !i1 = n1 || (!i2 < n2 && t1.(!i1) > t2.(!i2))
        then begin
            t.(!i) <- t2.(!i2);
            incr i2
        end else begin
            t.(!i) <- t1.(!i1);
            incr i1
        end;
        incr i
    done;
    t

let rec tri_fusion_aux t i j =
    let n = j - i in
    if n >= 1
    then begin
        let m = i + n / 2 in
        let t1 = tri_fusion_aux t i m in
        let t2 = tri_fusion_aux t (m+1) j in
        fusionne t1 t2
    end
    else if n = 0
    then [|t.(i)|]
    else [||]

let tri_fusion t =
    let n = Array.length t in
    tri_fusion_aux t 0 (n-1)
Recherche dichotomique
On a déjà vu la recherche dichotomique : on coupe le tableau en deux mais on n'effectue qu'un seul appel récursif, la récurrence est donc
et on obtient facilement \(T(n) = O(\log_2 n)\).
Principe général d'analyse des récurrences
On remarque ici qu'on retombe souvent sur la même méthode pour analyser des récurrences de la forme
Comme on ne considère que des suites positives et croissantes, on peut se ramener à une égalité par majoration. En effet, si \(S\) vérifie \(S(1) = T(1)\) et \(\forall n \ge 2, S(n) = k S\left( \left\lceil \frac{n}{p} \right\rceil \right) + f(n)\) alors on a \(\forall n \in \N^*, T(n) \le S(n)\) par une récurrence forte immédiate (car \(\lceil n/p \rceil < n\) pour \(n \ge 2\)) et d'une majoration de \(S(n)\) on en déduira directement une majoration pour \(T(n)\).
Cette remarque peut donc se résumer ainsi :
Remarque
Il est toujours possible de se ramener à une relation de récurrence avec une égalité.
Que signifie cette relation de récurrence ? Que pour résoudre l'instance de taille \(n\) on va faire \(k\) appels récursifs à des instances de taille au plus \(\lceil n/p \rceil\) et que le coût de la fusion des résultats sera \(f(n)\).
On peut ainsi représenter les coûts de fusion cumulés qui sont associés à chaque niveau de l'arbre d'appels récursifs. Pour simplifier, on considère que \(n = p^l\) ce qui permet de n'avoir que des divisions entières tout au long de l'arbre. On remarque qu'on peut s'y ramener par croissance en majorant \(n\) par une puissance de \(p\) et qu'on a alors \(l = O(\log_p n)\).
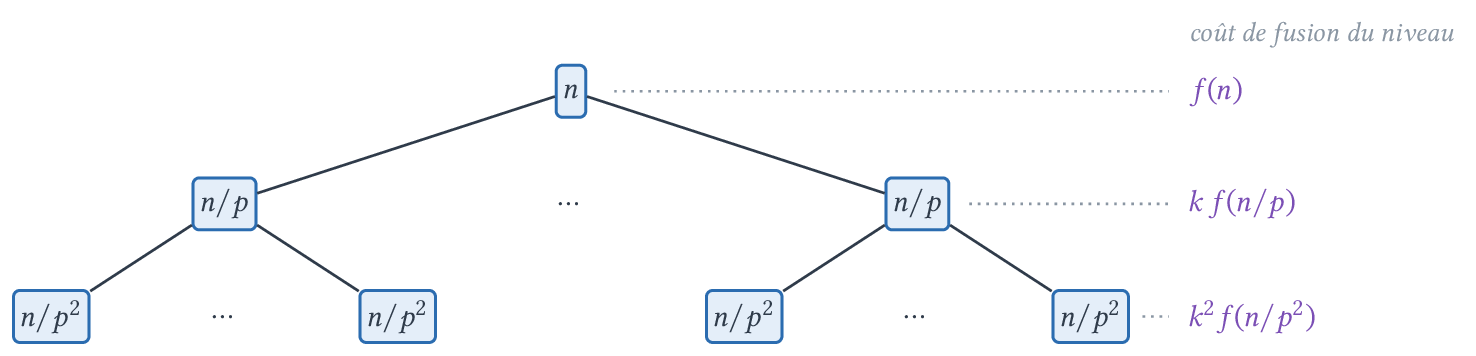
On a alors, en notant \(f(1) = T(1)\) le coût d'une feuille, les coûts de fusion
On a trois cas standard pour cette somme :
- Poids sur la racine, c'est \(f(n)\) qui l'emporte sur les coûts et le reste de l'arbre n'a pas d'influence sur la complexité. Ici \(T(n) = O(f(n))\).
- Poids sur les feuilles, le coût de fusion n'est pas important et c'est le nombre de feuilles qui compte, on a alors \(T(n) = O(k^l f(1)) = O(k^l) = O(k^{\log_p n}) = O(n^{\log_p k})\).
- Poids réparti uniformément, on a chaque \(k^i f(n/p^i) = O(f(n))\) et donc \(T(n) = O(f(n) \log n)\).
Exemple
- Dans le cas de la multiplication de Karatsuba (voir le problème en fin de chapitre) on a \(T(n) = 3 T(\lceil n/2 \rceil) + O(n)\) donc les niveaux sont de plus en plus peuplés, on est dans le deuxième cas et le niveau final va l'emporter. Ainsi, \(T(n) = O(n^{\log_2 3})\).
- Dans le cas du tri fusion \(T(n) = 2 T(\lceil n/2 \rceil) + O(n)\) on a un équilibre du travail total de fusion qui reste linéaire pour chaque niveau. Donc, on est dans le troisième cas et \(T(n) = O(n \log n)\).
Quand le coût de fusion est polynomial, on peut rendre précise cette discussion. C'est le théorème suivant, souvent appelé théorème maître.
Théorème (théorème maître)
Soient \(k \ge 1\) un réel, \(p \ge 2\) un entier, \(\alpha \ge 0\) et \(C > 0\) des réels. Soit \(T : \N^* \rightarrow \R_+\) une fonction croissante telle que
On pose \(\beta = \log_p k\), de sorte que \(k = p^\beta\). Alors :
- si \(\alpha < \beta\), \(T(n) = O(n^\beta)\) (poids sur les feuilles) ;
- si \(\alpha = \beta\), \(T(n) = O(n^\alpha \log n)\) (poids réparti) ;
- si \(\alpha > \beta\), \(T(n) = O(n^\alpha)\) (poids sur la racine).
Preuve
Cas des puissances de \(p\). Montrons par récurrence sur \(l \in \N\) que
Pour \(l = 0\), la somme est vide. Si c'est vrai pour \(l\), comme \(p^{l+1} \ge 2\) et \(\lceil p^{l+1}/p \rceil = p^l\), on a \(T(p^{l+1}) \le k T(p^l) + C p^{(l+1)\alpha} \le k^{l+1} T(1) + C \sum_{i=0}^{l-1} k^{i+1} p^{(l-i)\alpha} + C p^{(l+1)\alpha}\), ce qui est la formule au rang \(l+1\) après le changement d'indice \(i \leftarrow i+1\).
On pose \(q = k / p^\alpha\), de sorte que \(\sum_{i=0}^{l-1} k^i p^{(l-i)\alpha} = p^{l\alpha} \sum_{i=0}^{l-1} q^i\). On remarque que \(q < 1 \iff \alpha > \beta\), que \(q = 1 \iff \alpha = \beta\) et que \(k^l = p^{l\beta}\).
- Si \(\alpha > \beta\) : \(\sum_{i=0}^{l-1} q^i \le \frac{1}{1-q}\) et \(p^{l\beta} \le p^{l\alpha}\), donc \(T(p^l) \le A p^{l\alpha}\) avec \(A = T(1) + \frac{C}{1-q}\).
- Si \(\alpha = \beta\) : la somme vaut \(l\) et \(T(p^l) \le (T(1) + C l) p^{l\alpha}\).
- Si \(\alpha < \beta\) : \(\sum_{i=0}^{l-1} q^i = \frac{q^l - 1}{q - 1} \le \frac{q^l}{q-1}\) et \(p^{l\alpha} q^l = k^l\), donc \(T(p^l) \le A' k^l = A' p^{l\beta}\) avec \(A' = T(1) + \frac{C}{q-1}\).
Cas général. Soit \(n \ge 2\) et \(l = \lceil \log_p n \rceil \ge 1\), de sorte que \(p^{l-1} < n \le p^l\) et donc \(p^l < p n\). Par croissance de \(T\), \(T(n) \le T(p^l)\). Ainsi :
- si \(\alpha > \beta\), \(T(n) \le A (pn)^\alpha = A p^\alpha n^\alpha\) ;
- si \(\alpha = \beta\), comme \(l < 1 + \log_p n \le \log_2 n + \log_2 n\) (car \(n \ge 2\) et \(p \ge 2\)), \(T(n) \le (T(1) + 2 C \log_2 n) p^\alpha n^\alpha = O(n^\alpha \log n)\) ;
- si \(\alpha < \beta\), \(T(n) \le A' (pn)^\beta = A' k n^\beta\).
Remarque
- L'hypothèse de croissance est essentielle pour passer des puissances de \(p\) au cas général. On peut également remplacer \(\lceil n/p \rceil\) par \(\lfloor n/p \rfloor\) : la croissance donne la même majoration.
- Si on a en plus une minoration \(T(n) \ge k T(\lceil n/p \rceil) + c n^\alpha\) avec \(c > 0\), on obtient de même les ordres de grandeur exacts (\(\Theta\) au lieu de \(O\), admis).
- Le théorème ne s'applique pas directement quand \(f\) n'est pas de la forme \(O(n^\alpha)\) avec le bon exposant : par exemple, pour \(f(n) = n \log n\) et \(k = p = 2\), il donne seulement \(O(n^{1+\varepsilon})\) pour tout \(\varepsilon > 0\). On revient alors à la somme par niveaux.
Exemple
- Somme d'un tableau : \(k = p = 2\), \(\alpha = 0 < 1 = \beta\), donc \(T(n) = O(n)\).
- Tri fusion : \(k = p = 2\), \(\alpha = 1 = \beta\), donc \(T(n) = O(n \log n)\).
- Recherche dichotomique : \(k = 1\), \(p = 2\), \(\alpha = 0 = \beta\), donc \(T(n) = O(\log n)\).
- Karatsuba : \(k = 3\), \(p = 2\), \(\alpha = 1 < \log_2 3 = \beta\), donc \(T(n) = O(n^{\log_2 3})\).
Remarque
Pour retrouver des expressions rapidement, on peut étudier \(u_n = \frac{T(p^n)}{k^n}\).
En effet, de la récurrence \(T(p^n) = k T(p^{n-1}) + f(p^n)\) on déduit \(u_n = u_{n-1} + \frac{f(p^n)}{k^n}\) et donc \(u_n = \sum_{i=0}^n \frac{f(p^i)}{k^i} = O(g(n))\) qui se simplifie en général (avec toujours la convention \(f(1) = T(1)\)). On obtient ensuite \(T(p^n) = k^n u_n = O(k^n g(n))\) puis, par croissance de \(T\) et pourvu que \(g\) soit croissante avec \(g(n+1) = O(g(n))\), \(T(n) = O(n^{\log_p k} g(\log_p n))\).
Par exemple, pour \(T(n) = 2 T(\lceil n/2 \rceil) + O(n)\) on a \(u_n = T(2^n)/2^n = \sum_{i=0}^n \frac{O(2^i)}{2^i} = O(n)\) donc \(T(2^n) = 2^n O(n) = O(n 2^n)\) puis \(T(n) = O(n \log n)\).
Autre exemple, pour \(T(n) = 2 T(\lceil n/2 \rceil) + O(1)\), on a \(u_n = \sum_{i=0}^n 2^{-i} O(1) = O(1) \frac{1 - \frac{1}{2^{n+1}}} {1 - \frac{1}{2}} = O(1)\) car \(\frac{1}{2^{n+1}} = o(1)\). Ainsi \(T(2^n) = O(2^n)\) puis \(T(n) = O(n)\).
Nombre d'inversions
Définition
Soit \(t\) une structure séquentielle (tableau, liste, ...) contenant des valeurs comparables \(a_0, ..., a_{n-1}\) et énumérées dans cet ordre au sein de \(t\).
Une paire \((i,j) \in \range{0}{n-1}^2\) où \(i < j\) est appelée une inversion de \(t\) lorsque \(a_i > a_j\).
On note \(I(t)\) le nombre d'inversions de \(t\).
Remarque
- Le nombre d'inversions permet de mesurer à quel point \(t\) est non triée dans l'ordre croissant : \(I(t) = 0\) si et seulement si \(t\) est triée, et \(I(t) \le \frac{n(n-1)}{2}\) avec égalité pour une suite strictement décroissante.
- Ce concept d'inversion est exactement celui utilisé pour les permutations en mathématiques : si \(\sigma \in \mathfrak{S}_n\), il suffit de considérer \((\sigma(1),\dots, \sigma(n))\).
On cherche dans ce paragraphe à calculer \(I(t)\) efficacement. Remarquons tout d'abord qu'un algorithme naïf est en \(O(n^2)\) où \(|t|=n\) en explorant toutes les paires :
size_t inversions(int *t, size_t taille)
{
    size_t inv = 0;
    for (size_t i = 0; i < taille; i++)
    {
        for (size_t j = i+1; j < taille; j++)
        {
            if (t[i] > t[j]) inv++;
        }
    }

    return inv;
}
On va maintenant donner un algorithme de type diviser pour régner :
- On sépare \(t\) en deux moitiés \(t_1\) et \(t_2\).
- On calcule \(I(t_1)\) et \(I(t_2)\) par des appels récursifs.
-
On compte les inversions entre des éléments de \(t_1\) et des éléments de \(t_2\) :
- Cela ne dépend pas de leur position dans \(t_1\) ou dans \(t_2\).
- On peut donc trier \(t_1\) en \(t'_1\) et \(t_2\) en \(t'_2\).
- On compte \(N(t_1,t_2) = N(t'_1,t'_2)\) le nombre d'inversions entre \(t'_1\) et \(t'_2\) en \(O(n)\) par l'algorithme ci-dessous.
-
On en déduit que \(I(t) = I(t_1) + I(t_2) + N(t_1,t_2)\).
Ici, \(N(t_1, t_2)\) est le nombre de couples \((x, y)\), \(x\) élément de \(t_1\) et \(y\) élément de \(t_2\), tels que \(x > y\) : comme tous les éléments de \(t_1\) précèdent ceux de \(t_2\) dans \(t\), ce sont exactement les inversions de \(t\) à cheval sur les deux moitiés, d'où la formule.
Remarque
Pour calculer le nombre d'inversions entre deux tableaux triés \(t'_1\) et \(t'_2\), on remarque que si \(t'_1[i] > t'_2[j]\) alors \(t'_1[i+1] \ge t'_1[i] > t'_2[j]\). Cela signifie qu'on peut compter les inversions de manière cumulative en avançant dans les deux tableaux en même temps :
let inversions_croisees t1 t2 =
    let i = ref 0 in
    let j = ref 0 in
    let n1 = Array.length t1 in
    let n2 = Array.length t2 in
    let inv = ref 0 in
    let cumul = ref 0 in
    while !i < n1 && !j < n2 do
        if t1.(!i) > t2.(!j)
        then ( incr j; incr inv; incr cumul )
        else ( incr i; inv := !inv + !cumul )
    done;
    !inv + (!cumul * (n1 - !i - 1))
Ici, !cumul est toujours égal à !j, le nombre d'éléments de t2
déjà dépassés, qui sont tous strictement inférieurs à t1.(!i). Quand on
avance i, on compte d'avance ces !j inversions pour le nouvel élément
t1.(!i). En sortie de boucle :
- si
!j = n2, l'élément courantt1.(!i)a déjà été compté avec lesn2éléments det2, et chacun desn1 - !i - 1éléments restants formen2 = !cumulinversions ; - si
!i = n1, le dernier passage dans la brancheelsea compté!cumulinversions pour un élémentt1.(n1)qui n'existe pas : le terme!cumul * (n1 - !i - 1) = - !cumulcorrige exactement cet excès.
Pour que cet algorithme fonctionne, il est nécessaire de trier à chaque étape les sous-tableaux, on obtient alors naïvement une récurrence en
qui se résout en \(T(n) = O(n (\log n)^2)\) : pour \(n = 2^l\), le niveau \(i\) de l'arbre d'appels coûte \(2^i O\left(\frac{n}{2^i} \log \frac{n}{2^i}\right) = O(n \log n)\) et il y a \(l + 1 = O(\log n)\) niveaux. Il est possible de faire mieux en remarquant qu'on peut calculer le nombre d'inversions en décorant le tri fusion car celui-ci fait naturellement calculer les sous-tableaux triés. On a donc une récurrence en
qui se résout en \(T(n) = O(n \log n)\).
Exercice
Écrire le programme réalisant cet algorithme.
Corrigé
let inversions_croisees t1 t2 =
    let i = ref 0 in
    let j = ref 0 in
    let n1 = Array.length t1 in
    let n2 = Array.length t2 in
    let inv = ref 0 in
    let cumul = ref 0 in
    while !i < n1 && !j < n2 do
        if t1.(!i) > t2.(!j)
        then ( incr j; incr inv; incr cumul )
        else ( incr i; inv := !inv + !cumul )
    done;
    !inv + (!cumul * (n1 - !i - 1))

let split t =
    let n = Array.length t in
    let m = n/2 in
    Array.sub t 0 m, Array.sub t m (n-m)

let fusion t1 t2 =
    let n1 = Array.length t1 in
    let n2 = Array.length t2 in
    let t = Array.make (n1+n2) (t1.(0)) in
    let i = ref 0 in let j = ref 0 in
    for k = 0 to n1+n2-1 do
        if !j = n2 || (!i < n1 &&  t1.(!i) < t2.(!j))
        then ( t.(k) <- t1.(!i); incr i )
        else ( t.(k) <- t2.(!j); incr j )
    done;
    t

(* renvoie la version triée de t et son nombre d'inversions *)
let rec inversions_div t =
    let n = Array.length t in
    if n <= 1
    then t, 0
    else let t1, t2 = split t in
        let t1', n1 = inversions_div t1 in
        let t2', n2 = inversions_div t2 in
        let n12 = inversions_croisees t1' t2' in
        fusion t1' t2', n1+n2+n12
Le cas de base n <= 1 traite aussi le tableau vide. Pour \(n \ge 2\), les
deux moitiés sont non vides, ce qui justifie l'accès à t1.(0) dans
fusion. Ce programme a été testé contre l'algorithme naïf sur des
dizaines de milliers de tableaux aléatoires, avec de nombreuses valeurs
égales.
Points les plus proches
On considère le problème
Problème : PlusProchePaire
- Entrée : un ensemble \(P\) de \(n \ge 2\) points dans le plan.
- Sortie : une paire \(\{p,p'\}\) de points de \(P\) telle que \(\mathrm{dist}(p,p') = \|\overrightarrow{pp'}\|\) soit minimale.
Ce problème a déjà été étudié dans le chapitre Recherche par force brute où l'algorithme naïf en \(O(n^2)\) a été amélioré en un algorithme en \(O(n \log n)\).
On présente ici un algorithme diviser pour régner.
Si \(n > 3\), l'idée est de séparer les points en fonction de la médiane des abscisses. On trie les points par abscisse croissante et on note \(S_1\) les \(\lceil n / 2 \rceil\) premiers points et \(S_2\) les \(\lfloor n/2 \rfloor\) autres. Si \(x\) est l'abscisse du dernier point de \(S_1\), les points de \(S_1\) sont d'abscisses \(\le x\) et ceux de \(S_2\) d'abscisses \(\ge x\) (quand les abscisses sont distinctes, on peut aussi prendre pour \(x\) la moitié entre l'abscisse médiane et l'abscisse suivante). Ensuite, on applique l'algorithme récursivement pour obtenir \(d_1\) la plus petite distance dans \(S_1\) et \(d_2\) la plus petite distance dans \(S_2\). On pose \(d = \min(d_1,d_2)\) et la question qui se pose est celle de calculer \(d' = \min\{ \mathrm{dist}(p_1,p_2) ~|~ p_1 \in S_1, p_2 \in S_2 \}\).
Comme on a déjà déterminé \(d\), on peut se contenter de chercher à déterminer s'il existe \(d' < d\). Pour cela, on peut se contenter de ne considérer dans \(S_1\) que les points d'abscisse dans \(]x-d;x]\) et pour \(S_2\) dans \([x;x+d[\). On a ainsi une bande à étudier. Comme il n'est pas possible d'exclure qu'un nombre important de points soit dans cette bande, on a a priori une fusion en \(O(n)\).
On va considérer les points de bas en haut dans la bande, par exemple avec un tri initial selon les ordonnées. Ainsi, il sera inutile, quand on considère un point \(p\) d'ordonnée \(y\), de considérer des points d'ordonnées \(< y\) (la paire aura déjà été examinée depuis l'autre point). D'un autre côté, comme on cherche l'existence d'une distance \(< d\), il est inutile de considérer des points d'ordonnée \(> y+d\).
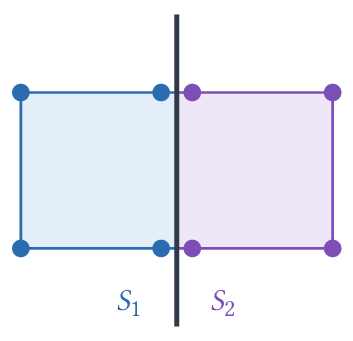
On se retrouve alors à comparer les points présents dans l'union de deux carrés de côté \(d\) de part et d'autre de la séparation :
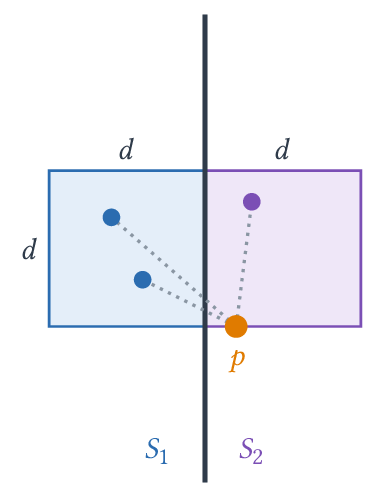
Cependant, on sait que les points de \(S_1\) de la bande sont dans le carré gauche, ceux de \(S_2\) dans le carré droit, et que deux points d'un même \(S_i\) sont à distance \(\ge d_i \ge d\). Il n'est pas possible de placer plus que quatre points dans un carré de côté \(d\) de sorte qu'aucune paire ne soit à distance \(< d\) : en découpant le carré en quatre carrés de côté \(d/2\), dont la diagonale mesure \(\frac{d}{\sqrt 2} < d\), chacun contient au plus un point. La configuration extrémale correspond ainsi à placer les points aux sommets.
On en déduit donc qu'il y a au maximum quatre points dans le carré gauche et quatre points dans le carré droit, dont le point \(p\) considéré : il n'est pas nécessaire d'explorer plus que les sept points suivants.
Sur le schéma suivant, on a volontairement séparé les points autour de la frontière pour marquer cette différence.
Remarque
Cette analyse est très naïve, on peut démontrer qu'il suffit d'observer cinq autres points (admis).
Dans les programmes suivants, les points sont triés une fois pour toutes par
abscisse dans p_x et l'ordre selon les ordonnées est maintenu sous la forme
d'une liste p_y d'indices dans p_x. Séparer p_y selon l'indice (et
non selon l'abscisse) garantit que chaque appel récursif travaille exactement
sur les points d'indices entre i et j, même si plusieurs points ont la
même abscisse.
let distance (x1,y1) (x2,y2) =
    let v = (x1-.x2)*.(x1-.x2)
        +.(y1-.y2)*.(y1-.y2) in
    sqrt v

let closest_brute points i j =
    let d = ref (distance points.(i) points.(i+1)) in
    for k = i to j do
        for l = k+1 to j do
            let dist_kl =
                distance points.(k) points.(l) in
            if !d > dist_kl
            then d := dist_kl
        done
    done;
    !d

(* p_x : points triés par abscisse croissante
   p_y : indices dans p_x des points d'indice entre i et j,
         triés par ordonnée croissante *)
let rec closest_rec p_x p_y i j =
    if j-i+1 <= 3
    then closest_brute p_x i j
    else begin
        let m = (i+j)/2 in
        let mx = fst p_x.(m) in
        let p_y_l, p_y_r =
            List.partition (fun k -> k <= m) p_y in
        let d1 = closest_rec p_x p_y_l i m in
        let d2 = closest_rec p_x p_y_r (m+1) j in
        let d = min d1 d2 in
        let bande =
           Array.of_list
            (List.filter
              (fun k -> abs_float (fst p_x.(k) -. mx) < d) p_y) in
        let m_d = ref d in
        for k = 0 to Array.length bande - 1 do
            for l = k+1
                to min (k+7) (Array.length bande - 1) do
                let d_kl = distance p_x.(bande.(k)) p_x.(bande.(l)) in
                if d_kl < !m_d
                then m_d := d_kl
            done
        done;
        !m_d
    end

let closest points =
    let n = Array.length points in
    let p_x = Array.copy points in
    Array.sort (fun (x1,_) (x2,_) -> Stdlib.compare x1 x2) p_x;
    let p_y = List.sort
        (fun k1 k2 -> Stdlib.compare (snd p_x.(k1)) (snd p_x.(k2)))
        (List.init n (fun k -> k)) in
    closest_rec p_x p_y 0 (n - 1)
from math import sqrt


def distance(p1, p2):
    x1, y1 = p1
    x2, y2 = p2
    return sqrt((x1 - x2)**2 + (y1 - y2)**2)


def closest_brute(points, i, j):
    m = distance(points[i], points[i+1])
    for k in range(i, j+1):
        for l in range(k+1, j+1):
            d = distance(points[k], points[l])
            if d < m:
                m = d
    return m


def closest_rec(points_x, points_y, i, j):
    # points_y : indices dans points_x des points d'indice entre i et j,
    # triés par ordonnée croissante
    if j-i+1 <= 3:
        return closest_brute(points_x, i, j)
    m = (i+j)//2
    mx = points_x[m][0]
    points_y_l = [k for k in points_y if k <= m]
    points_y_r = [k for k in points_y if k > m]
    d1 = closest_rec(points_x, points_y_l, i, m)
    d2 = closest_rec(points_x, points_y_r, m+1, j)
    d = min(d1, d2)
    bande = [points_x[k] for k in points_y if abs(points_x[k][0] - mx) < d]
    for k in range(len(bande)):
        for l in range(1, 8):
            if k+l >= len(bande):
                break
            d_kl = distance(bande[k], bande[k+l])
            if d_kl < d:
                d = d_kl
    return d


def closest(points):
    n = len(points)
    points_x = sorted(points, key=lambda p: p[0])
    points_y = sorted(range(n), key=lambda k: points_x[k][1])
    return closest_rec(points_x, points_y, 0, n-1)
Chaque appel sur \(n\) points effectue, en plus des deux appels récursifs, un
travail en \(O(n)\) (séparation de p_y, construction de la bande, au plus 7
distances par point de la bande). On a donc \(T(n) \le 2 T(\lceil n/2 \rceil) +
O(n)\), soit \(T(n) = O(n \log n)\) d'après le théorème maître, auquel s'ajoutent
les deux tris initiaux en \(O(n \log n)\). Ces programmes ont été testés contre la
recherche exhaustive sur des milliers d'ensembles aléatoires, y compris avec de
nombreuses abscisses ou ordonnées égales et des points confondus.
Dichotomie pour passer de décision à optimisation
Couverture par des segments égaux
On considère ici \(n\) points sur la droite réelle. Le \(i\)-ème point est identifié par sa coordonnée \(x_i\). On se pose alors, dans un premier temps, la question de savoir si on peut trouver \(k\) segments de longueur \(l\) tels que chaque point appartienne à au moins un de ces segments. Dans un second temps, on se posera la question de la longueur \(l\) minimale de ces segments.
Couverture par des segments de longueur donnée
On va ici résoudre le premier problème :
Problème : ExistenceCouvertureSegment
-
Entrées :
- \(n\) points sur la droite réelle \(x_1, ..., x_n\)
- un entier \(k \ge 1\)
- un réel \(l \ge 0\)
-
Sortie : existe-t-il \(k\) segments \(S_1, \dots, S_k\) de longueur \(l\) tels que \(\forall i \in \range{1}{n}, \exists j \in \range{1}{k}, x_i \in S_j\) ?
On remarque qu'un segment de longueur \(l\) est uniquement caractérisé par son extrémité gauche \(a\) : c'est \([a, a+l]\), et il contient \(x_i\) si et seulement si \(a \in I_i = [x_i-l,x_i]\). Pour chaque \(x_i\), il doit ainsi exister une extrémité gauche dans le segment \(I_i\). On peut ainsi renverser le problème et en faire un problème de couverture de segments par des points : on cherche \(k\) points tels que chaque segment \(I_i\) contienne au moins un de ces points.
Problème : EnsembleIntersectantLigne
-
Entrées :
- \(n\) segments \(I_i = [a_i,b_i]\)
- un entier \(k \ge 1\)
-
Sortie : un ensemble \(P\) d'au plus \(k\) points tel que \(\forall i \in \range{1}{n}, \exists p \in P, p \in I_i\) en cas de succès, un échec sinon.
Ce problème peut se résoudre par un algorithme glouton :
- on commence avec \(P = \emptyset\)
- on trie les segments par \(b_i\) croissant
- pour chaque segment \(I_i = [a_i,b_i]\), s'il ne contient aucun élément de \(P\), on rajoute \(b_i\) à \(P\).
- on répond avec un succès si \(|P|\le k\) (on peut alors compléter avec des points quelconques pour avoir exactement \(k\) points).
Comme les points sont ajoutés dans l'ordre croissant et sont tous \(\le b_i\) au moment où on traite \(I_i\), ce segment contient un élément de \(P\) si et seulement si le dernier point ajouté est \(\ge a_i\) : chaque test est en \(O(1)\). Cet algorithme est donc en \(O(n \log n)\) en raison du tri initial.
Propriété
L'ensemble \(P\) construit par l'algorithme glouton intersecte tous les segments et est de cardinal minimal parmi les ensembles ayant cette propriété. En particulier, l'algorithme répond correctement.
Preuve
Par construction, à l'issue du traitement de \(I_i\), ce segment contient un élément de \(P\), et \(P\) ne fait que croître.
Notons \(I_{i_1}, \dots, I_{i_m}\) les segments ayant provoqué un ajout, dans l'ordre de traitement, de sorte que \(P = \{ b_{i_1}, \dots, b_{i_m} \}\) avec \(b_{i_1} \le \dots \le b_{i_m}\). Pour \(s < t\), au moment de traiter \(I_{i_t}\), le point \(b_{i_s} \le b_{i_t}\) n'est pas dans \(I_{i_t}\), donc \(b_{i_s} < a_{i_t}\) : le segment \(I_{i_t}\) est entièrement à droite de \(I_{i_s}\). Ces \(m\) segments sont donc deux à deux disjoints et tout ensemble de points intersectant tous les segments en contient au moins \(m\). Ainsi \(|P| = m\) est minimal, et il existe une solution à au plus \(k\) points si et seulement si \(m \le k\).
Longueur minimale
On considère maintenant le problème suivant :
Problème : CouvertureSegmentsMinimale
-
Entrées :
- \(n \ge 1\) points à coordonnées entières sur la droite réelle \(x_1, ..., x_n\)
- un entier \(k \ge 1\)
-
Sortie : la longueur \(l\) minimale pour laquelle il existe une couverture des points par \(k\) segments de longueur \(l\).
Deux remarques permettent de se ramener à une recherche parmi un nombre fini d'entiers :
- si une couverture par des segments de longueur \(l\) existe, il en existe une pour toute longueur \(l' \ge l\) (on allonge les segments) ;
- si une couverture par \(k\) segments de longueur \(l\) existe, en regroupant les points couverts par un même segment, on obtient au plus \(k\) groupes dont l'étendue (plus grande moins plus petite coordonnée) est un entier \(\le l\), donc il existe aussi une couverture de longueur \(\lfloor l \rfloor\). La longueur minimale est donc un entier.
On peut alors résoudre ce problème par dichotomie à l'aide de l'algorithme précédent :
- on considère \(L = \left\lceil \frac{\max_{1 \le i < j \le n} |x_j-x_i|}{k} \right\rceil = \left\lceil \frac{D}{k} \right\rceil\) où le diamètre \(D\) se calcule en \(O(n)\). Cela correspond à répartir de manière uniforme les segments pour couvrir les points : une telle couverture existe toujours.
- on peut considérer, sans avoir besoin de le calculer au préalable, le tableau \(V\) de booléens de longueur \(L+1\) tel que \(V[l]\) indique s'il est possible de couvrir les points par \(k\) segments de longueur \(l\). Pour obtenir la valeur \(V[l]\) il suffit d'appliquer l'algorithme précédent. D'après la première remarque, \(V\) est croissant : de la forme \([\text{faux}, \dots, \text{faux}, \text{vrai}, \dots, \text{vrai}]\).
- on effectue alors une recherche dichotomique du plus petit indice \(l\) tel que \(V[l]\) soit vrai.
On obtient ainsi un algorithme en \(O\left( n \log n \log \frac{D}{k} \right)\) qu'on peut considérer comme étant en \(O(n \log n)\) en supposant que \(D\) est une constante.
Remarque
En triant les points une seule fois au début, les segments \(I_i = [x_i - l, x_i]\) sont déjà triés par extrémité droite pour toute valeur de \(l\) : chaque test est alors en \(O(n)\) et on obtient \(O\left(n \log n + n \log \frac{D}{k}\right)\).
Cette dichotomie est en fait une instance d'un principe fondamental permettant de transformer un problème de décision (existe-t-il ?) en un problème d'optimisation (quelle est la valeur minimale/maximale ?).
Implémentation
La fonction couvrable applique l'algorithme glouton aux segments
\(I_i = [x_i - l, x_i]\), les points étant déjà triés : dernier est le
dernier point ajouté à \(P\), c'est-à-dire l'extrémité gauche du dernier segment
de longueur \(l\) placé.
(* xs est trié par ordre croissant *)
let couvrable xs k l =
    let nb = ref 0 in
    let dernier = ref min_int in
    Array.iter (fun x ->
        if !dernier < x - l
        then begin
            dernier := x;
            incr nb
        end) xs;
    !nb <= k

let longueur_minimale points k =
    let xs = Array.copy points in
    Array.sort compare xs;
    let n = Array.length xs in
    let bas = ref 0 in
    let haut = ref ((xs.(n-1) - xs.(0) + k - 1) / k) in
    (* invariant : couvrable xs k !haut
       et non couvrable pour toute longueur < !bas *)
    while !bas < !haut do
        let m = (!bas + !haut) / 2 in
        if couvrable xs k m
        then haut := m
        else bas := m + 1
    done;
    !bas
Cette fonction a été testée contre une recherche exhaustive (découpage des points triés en au plus \(k\) groupes consécutifs) sur des milliers d'exemples aléatoires, y compris avec des points confondus et \(k \ge n\).
Problèmes
Multiplication d'entiers
On considère ici le problème de la multiplication de deux entiers donnés en précision arbitraire par le tableau de leurs chiffres.
Ainsi, l'entier \(123 = 1 \times 10^2 + 2 \times 10^1 + 3 \times 10^0\)
sera représenté par le tableau [|3;2;1|] de telle sorte que le nombre
représenté par t soit \(\sum_{k=0}^{n-1} t[k] 10^k\) où \(n = |t|\) la taille de
\(t\). On suppose que t ne finit pas par des 0. Autrement dit : soit t est
vide, soit la dernière valeur de t est non nulle.
On se convaincra aisément que les entiers naturels sont en bijection avec de telles représentations.
Question 1. Écrire une fonction simpl : int array -> int array qui
renvoie un nouveau tableau obtenu en supprimant tous les 0
en fin de tableau : simpl [|1;2;3;0;0|] = [|1;2;3|].
Question 2. Écrire une fonction add : int array -> int array -> int array qui
calcule la somme de deux entiers en temps linéaire.
On va étudier ici plusieurs techniques de multiplication.
Multiplication naïve
On considère la multiplication posée comme étudiée à l'école primaire :
Plus précisément, si \(y = \sum_{j=0}^m y_j 10^j\), on a
Question 3. Écrire une fonction mult_digit : int -> int array -> int array
telle que mult_digit a x renvoie \(a \times x\) où a
est un chiffre et x un nombre.
Question 4. Écrire une fonction mult_dec : int -> int array -> int array
telle que mult_dec p x renvoie \(x 10^p\) où \(p\) est un entier
et x un nombre.
Question 5. Écrire une fonction mult_naive : int array -> int array -> int array
réalisant cette multiplication.
Question 6. Quelle est la complexité de cette méthode en fonction de la longueur des entrées ?
Première approche diviser pour régner
On remarque que pour \(0 \le a,b,c,d < 10^m\) :
On peut alors calculer récursivement les quatre produits \(ac, ad, bc\) et \(bd\).
On en déduit donc une solution de type diviser pour régner de la multiplication :
- \(mul(x,y,1) = x \times y\)
- pour \(n \ge 2\), \(mul(x,y,n) = 10^{2m} mul(a, c, m) + 10^m (mul(a,d,m) + mul(b,c,m)) + mul(b,d,m)\) où \(x = a 10^m + b\), \(y = c 10^m + d\) et \(m = \lceil n / 2 \rceil\).
où \(0 \le x, y < 10^n\).
Question 7. Déterminer avec précision la complexité \(T(n)\) de \(mul(x,y,n)\).
Que peut-on en conclure ?
Algorithme de Karatsuba
Face à ce problème, Karatsuba, alors âgé de 23 ans, est parti de la remarque suivante :
qui permet de voir qu'en calculant \(ac\), \(bd\) et le produit \((a-b)(c-d)\) on peut en déduire le coefficient \(ad + bc\) de \(10^m\), et ainsi économiser une multiplication.
On en déduit ainsi une nouvelle solution pour la multiplication :
- \(kar(x,y,1) = x \times y\)
- pour \(n \ge 2\), \(kar(x,y,n) = 10^{2m} X + 10^m (X+Y-Z) + Y\) où \(x = a 10^m + b\), \(y = c 10^m + d\), \(m = \lceil n / 2 \rceil\), \(X = kar(a,c,m)\), \(Y = kar(b,d,m)\) et \(Z = kar(a-b,c-d,m)\).
La présence de nombres négatifs ne complique pas la complexité car il suffit de rajouter un booléen indiquant le signe à côté du tableau des chiffres d'un nombre.
Question 8. Déterminer avec précision la complexité \(K(n)\) de \(kar(x,y,n)\).