On présente ici des algorithmes qui complètent les notions vues en première année dans le chapitre Graphes :
- le calcul d'un arbre couvrant de poids minimal dans un graphe pondéré ;
- le calcul des composantes fortement connexes dans un graphe orienté ;
- le calcul d'un couplage maximal dans un graphe biparti, qui est un cas particulier d'un problème plus général de flot maximal.
Arbre couvrant minimal
Présentation du problème
Description informelle : on a un ensemble de maisons reliées par des routes, on cherche à poser des câbles le long des routes pour que toute paire de maisons soit connectée. Quelle est la longueur minimale de câble à utiliser ?
On comprend assez vite qu'il faut que les câbles forment un graphe connexe et que, pour des questions de réduction de coût, on peut supposer que ce graphe est acyclique. On cherche donc un arbre qui couvre chaque maison et dont la somme des poids des arêtes, les longueurs des câbles, est minimale.
Définition
Soit \(G = (S, A)\) un graphe non orienté connexe. On dit que \(T \subset A\) est un arbre couvrant de \(G\) lorsque :
- \(\forall x \in S, \exists a \in T, x \in a\) : chaque sommet appartient à au moins une arête de \(T\) ;
- \((S, T)\) est un arbre, c'est-à-dire un graphe acyclique et connexe.
On notera ici \(\mathcal{T}(G)\) l'ensemble des arbres couvrants de \(G\).
Remarque
Comme \((S, T)\) a pour sommets tous les sommets de \(G\), la seconde condition entraîne la première dès que \(|S| \ge 2\) : un sommet d'un graphe connexe ayant au moins deux sommets appartient à une arête. Pour \(|S| = 1\), l'unique arbre couvrant est \(T = \emptyset\) et on ignore la première condition. Un arbre couvrant possède toujours exactement \(|S| - 1\) arêtes (voir les exercices sur les graphes).
Exemple
Dans le graphe pondéré suivant, les arêtes en trait épais forment un arbre couvrant, de poids \(1 + 2 + 5 + 2 + 3 = 13\). On verra qu'il est de poids minimal.
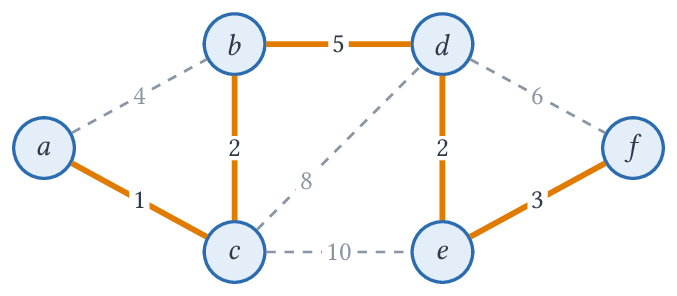
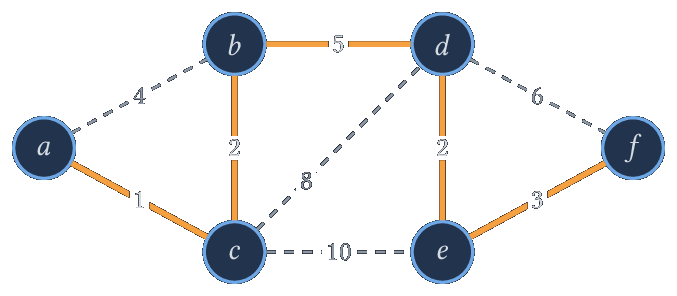
En remplaçant l'arête \(b \smile d\) par l'arête \(c \smile d\), on obtient un autre arbre couvrant, de poids \(16\). En revanche, les arêtes \(a \smile b\), \(a \smile c\) et \(b \smile c\) ne peuvent pas être toutes les trois dans un arbre couvrant car elles forment un cycle.
Une manière naturelle d'obtenir un arbre couvrant est de faire un parcours quelconque ou de calculer les composantes connexes avec une structure union-find. Dans ce dernier cas, comme le graphe est connexe, on obtiendra directement un unique arbre dans la forêt, qui est un arbre couvrant. C'est l'ordre de traitement des arêtes qui va aiguiller vers un arbre de \(\mathcal{T}(G)\) ou un autre.
Définition
Soit \(G = (S, A, w)\) un graphe non orienté connexe et pondéré par \(w : A \rightarrow \R\). On note \(w(T) = \sum_{a \in T} w(a)\) le poids d'un arbre couvrant \(T\) de \(G\).
Comme \(\mathcal{T}(G)\) est fini et non vide (voir ci-dessus), il existe, au moins, un arbre \(T_0\) tel que
On dit que \(T_0\) est un arbre couvrant de poids minimal.
Remarque
En anglais, on parle de minimum spanning tree. Les poids peuvent être négatifs : comme tous les arbres couvrants ont le même nombre d'arêtes, ajouter une même constante à tous les poids ne change pas les arbres couvrants de poids minimal.
Algorithme de Kruskal
Pour calculer un arbre couvrant de poids minimal, on va considérer le calcul des composantes connexes avec une structure union-find mais en traitant les arêtes dans l'ordre croissant de leurs poids : c'est l'algorithme de Kruskal.
Algorithme : Kruskal
Entrée : un graphe non orienté pondéré connexe \(G = (S, A, w)\).
Déroulement :
- Pour chaque \(x \in S\)
makeset(x)
- On trie \(A\) par ordre croissant de poids.
- \(T \leftarrow \emptyset\)
- Pour chaque \(\{x, y\} \in A\) dans cet ordre
- Si
find(x)\(\neq\)find(y)union(x,y)- \(T \leftarrow T \cup \{ \{x, y\} \}\)
- Si
- On renvoie \(T\), l'unique arbre de la forêt.
Exemple
Sur le graphe de l'exemple précédent, les arêtes triées par poids croissant sont \(a \smile c\) (1), \(b \smile c\) (2), \(d \smile e\) (2), \(e \smile f\) (3), \(a \smile b\) (4), \(b \smile d\) (5), \(d \smile f\) (6), \(c \smile d\) (8) et \(c \smile e\) (10).
- On ajoute \(a \smile c\), \(b \smile c\), \(d \smile e\) et \(e \smile f\) : la forêt a alors deux arbres, \(\{a, b, c\}\) et \(\{d, e, f\}\).
- \(a \smile b\) est rejetée car \(a\) et \(b\) sont déjà dans le même arbre.
- On ajoute \(b \smile d\) qui relie les deux arbres.
- Les arêtes suivantes sont toutes rejetées.
On obtient l'arbre en trait épais de la figure, de poids 13.
Correction de l'algorithme de Kruskal
On va montrer la correction d'une famille d'algorithmes à laquelle Kruskal appartient.
Définition
On dit que \(T \subset A\) est une forêt minimale de \(G\) s'il existe \(T'\) arbre couvrant de poids minimal de \(G\) tel que \(T \subset T'\).
Remarque
\(\emptyset\) est ainsi une forêt minimale. Une forêt minimale est acyclique puisqu'elle est incluse dans un arbre.
Définition
Soit \(T\) une forêt minimale et \(a \in A \setminus T\). On dit que \(a\) est une arête sûre pour \(T\) si \(T \cup \{ a\}\) est encore une forêt minimale.
Lemme
Soit \(T\) une forêt minimale qui n'est pas un arbre couvrant. Il existe une arête sûre pour \(T\).
Preuve
Comme \(T\) est une forêt minimale, il existe \(T'\) arbre couvrant de poids minimal tel que \(T\subset T'\). Comme \(T\) lui-même n'est pas un arbre couvrant, \(T \neq T'\) et il existe \(a \in T' \setminus T\). On a alors \(T \cup \{ a\} \subset T'\) donc \(a\) est une arête sûre.
On en déduit un proto-algorithme de calcul d'un arbre couvrant de poids minimal :
Algorithme : ArbreMinQuelconque
Entrée : un graphe non orienté pondéré connexe \(G = (S, A, w)\).
Déroulement :
- On pose \(T = \emptyset\)
- Tant que \(T\) n'est pas un arbre couvrant
- Déterminer une arête sûre \(a \in A\) pour \(T\)
- \(T \leftarrow T \cup \{ a\}\)
- Renvoyer \(T\)
Théorème
Cet algorithme renvoie un arbre couvrant de poids minimal.
Preuve
Cet algorithme vérifie directement l'invariant suivant : \(T\) est une forêt minimale. En effet, c'est vrai au départ et le choix d'une arête sûre, qui existe d'après le lemme, permet de prolonger l'invariant.
Cet algorithme termine car \(T\) gagne une arête à chaque itération et reste inclus dans un arbre couvrant, qui possède \(|S| - 1\) arêtes : il y a donc au plus \(|S| - 1\) itérations.
En sortie de boucle, \(T\) est un arbre couvrant et une forêt minimale : il est inclus dans un arbre couvrant de poids minimal \(T'\) ayant le même nombre d'arêtes, donc \(T = T'\).
Remarque
Il s'agit d'un proto-algorithme car la partie critique est de déterminer une arête sûre et c'est la partie qui n'est pas explicitée pour le moment.
L'outil principal pour exhiber des arêtes sûres est la notion de coupure.
Définition
Une coupure de \(G = (S, A)\) est une partition \(S = X \cup (S \setminus X)\) avec \(X \neq \emptyset\) et \(X \neq S\). On dit qu'une arête \(\{x, y\}\) traverse la coupure si elle a une extrémité dans \(X\) et l'autre dans \(S \setminus X\), et qu'une partie \(T \subset A\) respecte la coupure si aucune arête de \(T\) ne la traverse.
Théorème (propriété de coupure)
Soit \(F\) une forêt minimale et \((X, S \setminus X)\) une coupure que \(F\) respecte. Si \(e\) est une arête de poids minimal parmi les arêtes qui traversent la coupure, alors \(e\) est sûre pour \(F\).
Preuve
Comme \(F\) est une forêt minimale, il existe \(T\) arbre couvrant de poids minimal tel que \(F \subset T\).
Si \(e \in T\), alors \(F \cup \{ e\} \subset T\) est encore une forêt minimale.
Sinon, notons \(e = \{x, y\}\) avec \(x \in X\) et \(y \notin X\). Comme \(T\) est un arbre, il existe un unique chemin élémentaire \(\varphi\) de \(x\) à \(y\) dans \(T\) et \(e \notin \varphi\). Ce chemin part de \(X\) et arrive dans \(S \setminus X\) : il possède donc une arête \(e'\) qui traverse la coupure. Comme \(F\) respecte la coupure, \(e' \in T \setminus F\), et par minimalité de \(e\), \(w(e) \le w(e')\).
On pose \(T' = (T \setminus \{ e'\})\cup \{ e\}\). Retirer \(e'\) de \(T\) déconnecte l'arbre en exactement deux composantes connexes, l'une contenant \(x\) et l'autre \(y\) puisque \(e'\) est sur l'unique chemin de \(x\) à \(y\). L'arête \(e\) reconnecte ces deux composantes : \((S, T')\) est connexe et possède \(|S| - 1\) arêtes, c'est donc un arbre couvrant (voir les exercices). Autrement dit, on a cassé l'unique cycle de \(T \cup \{ e\}\), formé de \(\varphi\) et de \(e\), en enlevant \(e'\).
Reste que \(w(T') = w(T) - w(e') + w(e) \le w(T)\), donc \(T'\) est un arbre couvrant de poids minimal.
Ainsi \(F \cup \{ e \} \subset T'\) car \(e' \notin F\) : c'est une forêt minimale et \(e\) est sûre.
On en déduit le critère utilisé par Kruskal.
Théorème
Si \(F\) est une forêt minimale non couvrante et \(e\) une arête de plus petit poids reliant deux arbres distincts de \(F\), alors \(e\) est sûre pour \(F\).
Preuve
Notons \(C\) l'ensemble des sommets de l'arbre de \(F\) contenant l'une des extrémités de \(e\). Toute arête traversant la coupure \((C, S \setminus C)\) relie deux arbres distincts de \(F\) et \(F\) respecte cette coupure. L'arête \(e\) est donc de poids minimal parmi les arêtes traversant la coupure et la propriété de coupure permet de conclure.
Corollaire
Kruskal renvoie un arbre couvrant de poids minimal.
Preuve
On montre que l'ensemble \(T\) des arêtes ajoutées est toujours une forêt minimale, les arbres de la forêt union-find ayant pour sommets ceux des arbres de \(T\). Au départ, \(T = \emptyset\) est une forêt minimale.
Quand l'algorithme ajoute l'arête \(e = \{x, y\}\), \(x\) et \(y\) sont dans deux arbres distincts de \(T\). Toute arête \(e'\) de poids strictement inférieur à celui de \(e\) a déjà été examinée : soit elle a été ajoutée, soit ses extrémités étaient déjà dans le même arbre. Dans les deux cas, ses extrémités sont dans le même arbre de \(T\) au moment où on examine \(e\), car les arbres ne font que grossir. Ainsi \(e\) est une arête de plus petit poids reliant deux arbres distincts de \(T\) et elle est sûre d'après le théorème précédent.
À la fin, \(T\) est une forêt minimale. Si elle n'était pas couvrante, comme \(G\) est connexe, une arête de \(G\) relierait deux arbres distincts de \(T\) : elle aurait été ajoutée lors de son examen, puisque ses extrémités étaient alors dans des arbres distincts. Donc \(T\) est un arbre couvrant de poids minimal.
Complexité de l'algorithme de Kruskal
On peut décomposer l'algorithme :
- La création avec
makesetest en \(O(|S|)\). - Le tri des arêtes est en \(O(|A| \log |A|)\).
- La boucle est en \(O(|A| \alpha(|S|))\) avec \(\alpha(|S|) = o(\log |A|)\), en utilisant une structure union-find avec union par rang et compression de chemins.
Comme \(G\) est connexe, on a \(|A| \ge |S|-1\) et ainsi \(|S| = O(|A|)\). La complexité globale est donc en \(O(|A|\log |A|)\), c'est-à-dire en \(O(|A| \log |S|)\) car \(|A| \le |S|^2\).
Remarque
Kruskal fait partie de ces algorithmes qui sont linéaires, ou presque, après avoir fait un tri. C'est un cas que l'on a déjà vu avec les algorithmes gloutons. D'ailleurs, on peut dire que Kruskal est un choix glouton d'arête sûre.
Implémentation de Kruskal
On reprend la structure union-find du chapitre
Union-Find. En OCaml, le graphe est
donné par la liste de ses arêtes sous la forme de triplets (x, y, poids) ;
en C, par un tableau de structures.
let rec find parent x =
    if parent.(x) = x
    then x
    else begin
        let r = find parent parent.(x) in
        parent.(x) <- r; (* compression de chemins *)
        r
    end

(* aretes : liste de triplets (x, y, poids) d'un graphe
   non orienté connexe dont les sommets sont 0, ..., n-1 *)
let kruskal n aretes =
    let parent = Array.init n (fun x -> x) in
    let rang = Array.make n 0 in
    let triees =
        List.sort (fun (_, _, p1) (_, _, p2) -> compare p1 p2) aretes in
    let arbre = ref [] in
    List.iter (fun (x, y, p) ->
        let rx = find parent x in
        let ry = find parent y in
        if rx <> ry
        then begin
            arbre := (x, y, p) :: !arbre;
            (* union par rang *)
            if rang.(rx) < rang.(ry) then parent.(rx) <- ry
            else if rang.(rx) > rang.(ry) then parent.(ry) <- rx
            else begin
                parent.(ry) <- rx;
                rang.(rx) <- rang.(rx) + 1
            end
        end
    ) triees;
    !arbre
#include <stdlib.h>
#include <assert.h>

// union_find, uf_makesets, uf_find, uf_union et uf_detruire
// sont ceux du chapitre Union-Find

struct arete_ponderee {
    int x;
    int y;
    int poids;
};
typedef struct arete_ponderee arete_ponderee;

int compare_aretes(const void *a1, const void *a2) {
    int p1 = ((const arete_ponderee *)a1)->poids;
    int p2 = ((const arete_ponderee *)a2)->poids;
    return (p1 > p2) - (p1 < p2);
}

// Trie le tableau aretes (de taille m) d'un graphe connexe à n sommets
// et renvoie un tableau des n-1 arêtes d'un arbre couvrant de poids minimal
arete_ponderee *kruskal(int n, arete_ponderee *aretes, int m) {
    qsort(aretes, m, sizeof(arete_ponderee), compare_aretes);
    arete_ponderee *arbre = malloc((n > 1 ? n - 1 : 1) * sizeof(arete_ponderee));
    int taille = 0;
    union_find uf = uf_makesets(n);
    for (int i = 0; i < m && taille < n - 1; i++) {
        if (uf_find(uf, aretes[i].x) != uf_find(uf, aretes[i].y)) {
            uf_union(uf, aretes[i].x, aretes[i].y);
            arbre[taille++] = aretes[i];
        }
    }
    assert(taille == n - 1); // sinon le graphe n'est pas connexe
    uf_detruire(uf);
    return arbre;
}
En C, on peut s'arrêter dès que \(|S| - 1\) arêtes ont été ajoutées. Le
comparateur renvoie le signe de p1 - p2 sans calculer cette différence, qui
pourrait dépasser la capacité d'un int.
Algorithme de Prim
La propriété de coupure permet de justifier un autre algorithme : au lieu de faire grossir une forêt, on fait grossir un seul arbre à partir d'un sommet de départ, en lui ajoutant à chaque étape l'arête la plus légère qui le relie à un sommet extérieur.
Algorithme : Prim
Entrée : un graphe non orienté pondéré connexe \(G = (S, A, w)\) et un sommet \(r \in S\).
Déroulement :
- \(X \leftarrow \{ r \}\) et \(T \leftarrow \emptyset\)
- Tant que \(X \neq S\)
- Choisir une arête \(\{x, y\}\) de poids minimal parmi celles qui vérifient \(x \in X\) et \(y \notin X\)
- \(X \leftarrow X \cup \{ y \}\) et \(T \leftarrow T \cup \{ \{x, y\} \}\)
- Renvoyer \(T\)
Théorème
L'algorithme de Prim renvoie un arbre couvrant de poids minimal.
Preuve
On montre l'invariant : \(T\) est une forêt minimale dont les arêtes ont leurs deux extrémités dans \(X\), et \((X, T)\) est un arbre.
C'est vrai au départ. Si \(X \neq S\), \((X, S \setminus X)\) est une coupure, traversée par au moins une arête car \(G\) est connexe, et \(T\) la respecte puisque ses arêtes ont leurs deux extrémités dans \(X\). L'arête choisie est de poids minimal parmi celles qui traversent la coupure : elle est sûre d'après la propriété de coupure. De plus, ajouter à l'arbre \((X, T)\) un nouveau sommet \(y\) et une arête le reliant à \(X\) donne encore un arbre.
Chaque itération ajoute un sommet à \(X\) : l'algorithme termine après \(|S| - 1\) itérations avec \(X = S\). Alors \(T\) est un arbre couvrant et une forêt minimale, donc un arbre couvrant de poids minimal comme dans la preuve de ArbreMinQuelconque.
Exemple
Sur le graphe de l'exemple, en partant de \(a\), on ajoute successivement \(a \smile c\) (1), \(c \smile b\) (2), \(b \smile d\) (5), \(d \smile e\) (2) et \(e \smile f\) (3). On retrouve le même arbre qu'avec Kruskal. On remarque que les poids des arêtes ne sont pas ajoutés dans l'ordre croissant.
Pour réaliser efficacement le choix de l'arête, on procède comme pour l'algorithme de Dijkstra du chapitre Graphes : on maintient pour chaque sommet \(y \notin X\) la valeur \(d(y)\), poids de l'arête la plus légère connue reliant \(y\) à \(X\), et le sommet \(parent(y) \in X\) correspondant. Quand on ajoute un sommet \(x\) à \(X\), on met à jour \(d(y)\) pour ses voisins \(y\). La seule différence avec Dijkstra est la mise à jour : \(d(y) \leftarrow \min(d(y), w(x, y))\) au lieu de \(d(y) \leftarrow \min(d(y), d(x) + w(x,y))\).
(* g : listes d'adjacence (voisin, poids) d'un graphe non orienté connexe *)
let prim g =
    let n = Array.length g in
    (* d.(y) : poids de la plus légère arête connue reliant y à l'arbre *)
    let d = Array.make n max_int in
    let parent = Array.make n (-1) in
    let dans_arbre = Array.make n false in
    let arbre = ref [] in
    if n > 0 then d.(0) <- 0;
    for _ = 1 to n do
        (* sommet x hors de l'arbre avec d.(x) minimal *)
        let x = ref (-1) in
        for y = 0 to n - 1 do
            if not dans_arbre.(y) && (!x < 0 || d.(y) < d.(!x))
            then x := y
        done;
        let x = !x in
        dans_arbre.(x) <- true;
        if parent.(x) >= 0
        then arbre := (parent.(x), x, d.(x)) :: !arbre;
        List.iter (fun (y, p) ->
            if not dans_arbre.(y) && p < d.(y)
            then begin
                d.(y) <- p;
                parent.(y) <- x
            end
        ) g.(x)
    done;
    !arbre
#include <stdlib.h>
#include <stdbool.h>
#include <limits.h>

// arete et graphe_pondere sont ceux de l'algorithme de Dijkstra
// (chapitre Graphes)

// g est non orienté (chaque arête apparaît dans les deux sens) et connexe.
// Renvoie le tableau parent de l'arbre obtenu, enraciné en 0 :
// les arêtes de l'arbre sont les parent[y] -- y pour y != 0.
int *prim(graphe_pondere g) {
    int *d = malloc(g.n * sizeof(int));
    int *parent = malloc(g.n * sizeof(int));
    bool *dans_arbre = malloc(g.n * sizeof(bool));
    for (int y = 0; y < g.n; y++) {
        d[y] = INT_MAX;
        parent[y] = -1;
        dans_arbre[y] = false;
    }
    if (g.n > 0) d[0] = 0;
    for (int k = 0; k < g.n; k++) {
        // sommet x hors de l'arbre avec d[x] minimal
        int x = -1;
        for (int y = 0; y < g.n; y++) {
            if (!dans_arbre[y] && (x < 0 || d[y] < d[x])) {
                x = y;
            }
        }
        dans_arbre[x] = true;
        for (int i = 0; i < g.degre[x]; i++) {
            int y = g.voisins[x][i].but;
            int p = g.voisins[x][i].poids;
            if (!dans_arbre[y] && p < d[y]) {
                d[y] = p;
                parent[y] = x;
            }
        }
    }
    free(d);
    free(dans_arbre);
    return parent;
}
Ici, on part du sommet \(0\) et la recherche du minimum est linéaire : chaque itération coûte \(O(|S|)\) plus le parcours des voisins de \(x\), d'où une complexité en \(O(|S|^2 + |A|) = O(|S|^2)\), intéressante pour un graphe dense. Avec une file de priorité, comme pour Dijkstra, on obtient \(O((|S| + |A|) \log |S|)\), soit la même complexité que Kruskal.
Remarque
Ces programmes ont été testés en comparant le poids de l'arbre obtenu avec celui d'un arbre de poids minimal obtenu par énumération de toutes les parties à \(|S| - 1\) arêtes, sur des milliers de petits graphes aléatoires (avec des poids égaux ou négatifs).
Kosaraju et composantes fortement connexes
Rappel des définitions
Soit \(G = (S,A)\) un graphe orienté. On note, pour \(x, y \in S\), \(x\leadsto y\) quand il existe un chemin dans \(G\) reliant \(x\) à \(y\). On dit que \(y\) est accessible depuis \(x\).
On note \(x \leftrightarrow y \iff x\leadsto y \wedge y \leadsto x\). C'est la restriction symétrique de \(\leadsto\). Comme \(\leadsto\) est réflexive et transitive, \(\leftrightarrow\) est une relation d'équivalence. Les classes d'équivalence pour \(\leftrightarrow\) sont appelées les composantes fortement connexes de \(G\) (voir le chapitre Graphes). On note leur ensemble \(CFC(G) = S / \leftrightarrow\).
Par exemple, sur le graphe :
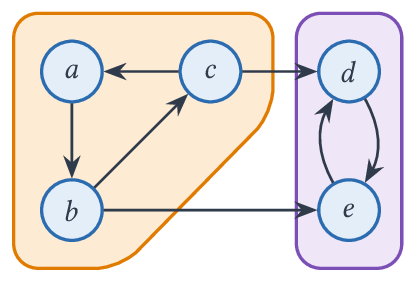
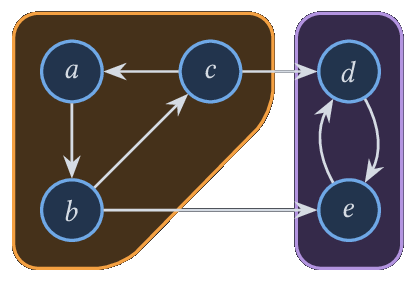
on a les deux composantes fortement connexes \(\{a,b,c\}\) et \(\{d,e\}\).
On remarque une différence fondamentale avec les composantes connexes : il peut y avoir des arêtes entre deux composantes fortement connexes distinctes, mais seulement dans un sens. Ici, \(c \rightarrow d\) et \(b \rightarrow e\) vont de la première composante vers la seconde, et il ne peut pas y avoir d'arête de la seconde vers la première sans fusionner les deux composantes.
On cherche ici à déterminer un algorithme pour calculer les composantes fortement connexes d'un graphe.
Exemple
On considère le graphe orienté suivant, qu'on retrouvera dans les exercices et en TP :
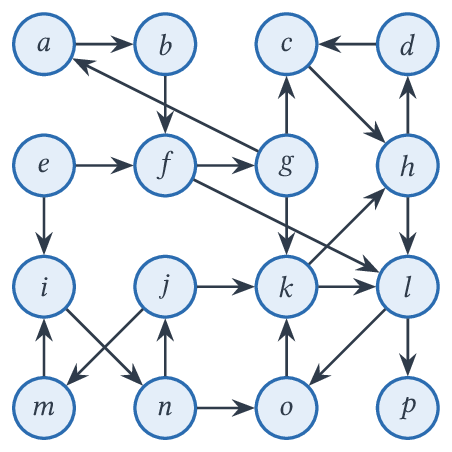
Ses composantes fortement connexes sont \(\{a, b, f, g\}\), \(\{c, d, h, k, l, o\}\), \(\{e\}\), \(\{i, j, m, n\}\) et \(\{p\}\). Par exemple, \(f \rightarrow l\) mais on ne peut pas revenir de \(l\) vers \(f\) : depuis \(\{c, d, h, k, l, o\}\), on ne peut atteindre que \(p\).
Si on considère chaque composante comme un seul sommet, on obtient un graphe appelé graphe des composantes ; il est acyclique car un cycle entre composantes les fusionnerait. Ici, ses arêtes sont \(\{e\} \rightarrow \{a, b, f, g\}\), \(\{e\} \rightarrow \{i, j, m, n\}\), \(\{a, b, f, g\} \rightarrow \{c, d, h, k, l, o\}\), \(\{i, j, m, n\} \rightarrow \{c, d, h, k, l, o\}\) et \(\{c, d, h, k, l, o\} \rightarrow \{p\}\).
On va voir que les temps de sortie d'un parcours en profondeur permettent de retrouver un ordre topologique de ce graphe des composantes, et ainsi de calculer les composantes.
Rappels sur le parcours en profondeur
Le parcours en profondeur et ses temps d'entrée et de sortie sont très
importants ici. On reprend le parcours complet de la partie
Temps d'entrée et de sortie
du chapitre Graphes, avec ses notations : un sommet est inconnu,
découvert ou traité ; l'appel parcours sur \(x\) marque \(x\) comme
découvert, note son temps d'entrée \(t_e(x)\), relance le parcours sur ses
voisins inconnus, puis marque \(x\) comme traité et note son temps de sortie
\(t_s(x)\).
Définition
On considère un parcours complet d'un graphe \(G = (S,A)\) et \(x \in S\).
Soit \(y \in S\). On dit que \(y\) est accessible par un chemin inconnu depuis \(x\) s'il existe un chemin de \(x\) à \(y\) ne passant que par des sommets inconnus au moment où on lance l'appel sur \(x\) (y compris \(x\) lui-même, qui n'est pas encore marqué). On note \(x \leadsto_I y\).
Théorème (chemin inconnu)
\(x \leadsto_I y\) si et seulement si \(y\) est découvert pendant l'appel sur \(x\), c'est-à-dire entre le début et la fin de cet appel.
Preuve
-
\(\Rightarrow\)) Soit \(x = u_0 \rightarrow u_1 \rightarrow \dots \rightarrow u_k = y\) un chemin dont tous les sommets sont inconnus au début de l'appel sur \(x\). Supposons par l'absurde que l'un des \(u_i\) ne soit pas découvert pendant cet appel, et prenons \(i\) minimal. On a \(i \ge 1\) car \(x\) est découvert au début de son appel. Le sommet \(u_{i-1}\) est découvert pendant l'appel sur \(x\), donc son propre appel se déroule pendant celui de \(x\) (voir le lemme du chapitre Graphes sur la pile d'appels). Lors de cet appel, l'arête \(u_{i-1} \rightarrow u_i\) est examinée : soit \(u_i\) est encore inconnu et il est découvert à ce moment, soit il ne l'est plus et, comme il était inconnu au début de l'appel sur \(x\), il a été découvert entre-temps. Dans les deux cas, \(u_i\) est découvert pendant l'appel sur \(x\) : c'est absurde.
-
\(\Leftarrow\)) Si \(y\) est découvert pendant l'appel sur \(x\), on considère la chaîne des appels en cours au moment de sa découverte, de \(x\) à \(y\) : chaque appel a été lancé par le précédent sur un voisin, qui était alors inconnu, et qui l'était donc aussi au début de l'appel sur \(x\). Ces sommets forment un chemin de \(x\) à \(y\), qui est donc un chemin inconnu.
Théorème
Soient \(x, y \in S\) tels que \(t_e(x) < t_e(y)\).
- Si \(x \leadsto_I y\), alors \(t_s(y) < t_s(x)\).
- Sinon, \(t_s(x) < t_e(y)\).
Autrement dit, soit \([t_e(y);t_s(y)] \subset [t_e(x);t_s(x)]\), soit \([t_e(y);t_s(y)] \cap [t_e(x);t_s(x)] = \emptyset\).
On dit que les temps sont bien parenthésés. En effet, si on considère le mot sur \(S\) avec les lettres \((_x\) et \()_x\) pour chaque sommet \(x\) et tel qu'on écrive la lettre \((_x\) quand on note le temps d'entrée et \()_x\) quand on note le temps de sortie, alors ce mot est bien parenthésé. C'est le théorème des parenthèses du chapitre Graphes, vu ici sous l'angle des chemins inconnus.
Exemple
Sur le graphe \(\{a, b, c, d, e\}\) du début de cette partie, en lançant le parcours depuis \(a\) et en examinant les voisins dans l'ordre alphabétique, on obtient le mot \((_a(_b(_c(_d(_e)_e)_d)_c)_b)_a\).
Preuve
Comme \(t_e(x) < t_e(y)\), on a commencé l'appel sur \(x\) avant de découvrir \(y\). Si \(x \leadsto_I y\), alors par le théorème précédent, \(y\) est découvert pendant l'appel sur \(x\) : l'appel sur \(y\) se déroule pendant celui sur \(x\) et termine donc avant lui. Ainsi \(t_s(y) < t_s(x)\).
Sinon, toujours par le théorème précédent, \(y\) n'est pas découvert pendant l'appel sur \(x\), et comme il est découvert après le début de cet appel, il l'est après sa fin. Donc \(t_s(x) < t_e(y)\).
Définition
Soit \(C \in CFC(G)\). On note
On a alors une propriété des temps de sortie sur les composantes fortement connexes elles-mêmes.
Théorème
Soient \(C, C' \in CFC(G)\) distinctes.
S'il existe \(x \in C, y \in C'\) avec \(x \rightarrow y\), alors \(t_s(C') < t_s(C)\).
Preuve
On suppose qu'il existe \(x \in C, y \in C'\) avec \(x \rightarrow y\).
Premier cas, \(t_e(C) < t_e(C')\). On considère \(u \in C\) tel que \(t_e(C) = t_e(u)\) : c'est le premier sommet de \(C \cup C'\) découvert, donc tous les sommets de \(C \cup C'\) sont inconnus au début de l'appel sur \(u\). Or tout sommet \(v \in C \cup C'\) est accessible depuis \(u\) en restant dans \(C \cup C'\) : directement si \(v \in C\), en passant par \(x \rightarrow y\) si \(v \in C'\). On a donc \(u \leadsto_I v\) et, par le théorème précédent, \(t_s(v) < t_s(u)\) pour tout \(v \neq u\). Ainsi \(t_s(C) = t_s(u) > t_s(C')\).
Second cas, \(t_e(C') < t_e(C)\). Soit \(u \in C'\) tel que \(t_e(u) = t_e(C')\). Comme précédemment, tous les sommets de \(C'\) sont découverts pendant l'appel sur \(u\), donc \(t_s(u) = t_s(C')\). En revanche, aucun sommet de \(C\) n'est accessible depuis \(u\) : sinon, avec \(x \rightarrow y\), on aurait \(u \leadsto x \leadsto u\) et \(C = C'\). Par le théorème du chemin inconnu, aucun sommet de \(C\) n'est découvert pendant l'appel sur \(u\) ; comme ils sont tous inconnus au début de cet appel, ils sont découverts après sa fin. On a bien \(t_s(C) > t_e(C) > t_s(u) = t_s(C')\).
Remarque
En particulier, en triant les composantes par temps de sortie décroissant, on obtient un tri topologique du graphe des composantes. Dans l'exemple précédent, en lançant les parcours depuis \(a\) puis \(e\) et en examinant les voisins dans l'ordre alphabétique, on obtient \(t_s(\{e\}) = 32\), \(t_s(\{i, j, m, n\}) = 31\), \(t_s(\{a, b, f, g\}) = 22\), \(t_s(\{c, d, h, k, l, o\}) = 18\) et \(t_s(\{p\}) = 15\).
Graphe miroir
Définition
Soit \(G = (S,A)\) un graphe orienté. On appelle graphe miroir de \(G\) le graphe \(G^R = (S,A^R)\) où
Cela revient à renverser toutes les flèches du graphe \(G\).
Théorème
\(CFC(G) = CFC(G^R)\)
Preuve
Un chemin de \(x\) à \(y\) dans \(G\) donne, en le parcourant à l'envers, un chemin de \(y\) à \(x\) dans \(G^R\), et réciproquement. Ainsi \(x \leadsto_G y \iff y \leadsto_{G^R} x\), donc \(x \leftrightarrow_G y \iff x \leftrightarrow_{G^R} y\). Les deux relations sont égales et ont donc les mêmes classes d'équivalence.
Algorithme de Kosaraju
Algorithme : Kosaraju
Entrée : un graphe orienté \(G = (S,A)\).
Déroulement :
- On effectue un parcours complet de \(G\) : tant qu'il y a des sommets inconnus, on lance un parcours depuis un sommet inconnu.
- On trie \(S\) par ordre décroissant de temps de sortie.
- On initialise l'état d'un parcours pour \(G^R\).
- \(Comp \leftarrow \emptyset\)
- Pour chaque sommet \(x\) dans cet ordre, s'il est inconnu (dans \(G^R\))
- On lance un parcours dans \(G^R\) à partir de \(x\) en notant les sommets découverts dans la liste \(C\).
- \(Comp \leftarrow Comp \cup \{ C \}\)
- On renvoie \(Comp\).
Exemple
Sur l'exemple précédent, l'ordre décroissant des temps de sortie est \(e, i, n, j, m, a, b, f, g, c, h, l, p, o, k, d\). Dans \(G^R\) :
- le parcours depuis \(e\) ne découvre que \(e\), qui n'a pas d'arête entrante dans \(G\) ;
- le parcours depuis \(i\) découvre \(\{i, m, j, n\}\) (l'arête \(i \rightarrow e\) de \(G^R\) mène à un sommet déjà traité) ;
- celui depuis \(a\) découvre \(\{a, g, f, b\}\) ;
- celui depuis \(c\) découvre \(\{c, d, h, k, o, l\}\) ;
- celui depuis \(p\) découvre \(\{p\}\).
On retrouve bien les cinq composantes fortement connexes.
Théorème
\(Comp = CFC(G)\).
Preuve
On montre l'invariant suivant pour la dernière boucle : \(Comp \subset CFC(G)\) et les sommets déjà découverts dans \(G^R\) sont exactement les éléments des composantes de \(Comp\). Au départ, comme \(Comp = \emptyset\), il est trivialement vérifié et à la fin, comme tous les sommets auront été découverts, on aura nécessairement \(Comp = CFC(G)\).
Supposons donc l'invariant vérifié et qu'on lance un parcours dans \(G^R\) à partir d'un sommet inconnu \(x\). Notons \(\overline{x}\) la composante contenant \(x\). D'après l'invariant, aucun sommet de \(\overline{x}\) n'est découvert. De plus, comme on traite les sommets par temps de sortie décroissant, tous les sommets de temps de sortie supérieur à \(t_s(x)\) sont déjà découverts. Ainsi \(t_s(x) = t_s(\overline{x})\) et \(t_s(\overline{x}) > t_s(C')\) pour toute composante \(C'\) non encore découverte.
Comme \(\overline{x}\) est fortement connexe dans \(G^R\) et que tous ses sommets sont inconnus, le théorème du chemin inconnu assure que le parcours depuis \(x\) découvre tout \(\overline{x}\) : \(\overline{x} \subset C\).
Si, par l'absurde, \(C\) contient un sommet hors de \(\overline{x}\), le chemin inconnu de \(x\) à ce sommet dans \(G^R\) sort de \(\overline{x}\) par une arête \(u \rightarrow v\) de \(G^R\) avec \(u \in \overline{x}\), \(v \notin \overline{x}\) et \(v\) inconnu. Dans \(G\), c'est une arête \(v \rightarrow u\) de la composante \(\overline{v}\) vers \(\overline{x}\), donc \(t_s(\overline{v}) > t_s(\overline{x})\) par le théorème précédent. Mais \(v\) est inconnu, donc \(\overline{v}\) n'est pas encore découverte d'après l'invariant, et \(t_s(\overline{v}) < t_s(\overline{x})\) : contradiction.
Ainsi \(C = \overline{x}\) et l'invariant est préservé.
Remarque
La complexité de cet algorithme est dominée par les deux parcours complets et le calcul de \(G^R\), on est donc en \(O(|S|+|A|)\). Il n'est pas nécessaire de trier : il suffit d'ajouter chaque sommet en tête d'une liste au moment où il devient traité, cette liste est alors dans l'ordre décroissant des temps de sortie. C'est ce qui est fait dans le TP Kosaraju et 2-SAT.
Remarque
Une application importante est la résolution de 2-SAT en temps linéaire, évoquée dans le chapitre Calcul propositionnel : une formule dont les clauses ont deux littéraux est satisfiable si et seulement si aucune variable n'est dans la même composante fortement connexe que sa négation dans le graphe d'implication. La preuve et la construction d'une valuation sont l'objet du TP.
Couplage maximal dans un graphe biparti
Problème
Définition
Soit \(G= (S,A)\) un graphe non orienté. On appelle couplage de \(G\) une partie \(C \subset A\) telle que \(\forall e, e' \in C, e \neq e' \Rightarrow e \cap e' = \emptyset\) : deux arêtes distinctes du couplage n'ont pas d'extrémité commune.
On dit qu'un couplage est maximal pour \(G\) quand il est de cardinal maximal.
Remarque
Attention, dans de nombreux ouvrages, on parle de couplage maximum pour un couplage de cardinal maximal, et de couplage maximal pour un couplage maximal pour l'inclusion, c'est-à-dire auquel on ne peut pas ajouter d'arête. Un couplage de cardinal maximal est maximal pour l'inclusion, mais la réciproque est fausse : dans le chemin \(a \smile b \smile c \smile d\), le couplage \(\{\{b, c\}\}\) est maximal pour l'inclusion mais \(\{\{a,b\}, \{c,d\}\}\) est de cardinal plus grand. Ici, maximal signifie toujours de cardinal maximal.
Rappel (voir le chapitre Graphes) :
Définition
Soit \(G= (S,A)\) un graphe non orienté. On dit que \(G\) est biparti lorsqu'il existe \(S_1, S_2 \subset S\) avec \(S_1 \cup S_2 = S\) et \(S_1 \cap S_2 = \emptyset\) et toutes les arêtes relient un sommet de \(S_1\) et un sommet de \(S_2\).
On se pose alors la question de déterminer un couplage maximal dans un graphe biparti. C'est un problème classique d'appariement. On peut ainsi citer le cas où on a des élèves et des écoles. On met une arête entre un élève et une école quand les deux veulent de l'autre. Un couplage maximal est alors une manière de placer le maximum d'élèves dans une école (en supposant que chaque école n'a qu'une place).
Chemin augmentant
Définition
Soit \(C\) un couplage d'un graphe et \(x\) un sommet. On dit que \(x\) est libre vis-à-vis de \(C\) si \(x\) n'appartient à aucune arête de \(C\).
Définition
Soit \(C \subset A\) un couplage d'un graphe.
Un chemin élémentaire de \(x\) à \(y\) composé des arêtes \((e_1,\dots,e_{2n+1})\), avec \(n \in \N\), est dit augmentant si les arêtes de rang pair sont dans le couplage (\(e_{2i} \in C\)), les arêtes de rang impair n'y sont pas (\(e_{2i+1} \not\in C\)), et si \(x\) et \(y\) sont libres pour \(C\).
Exemple
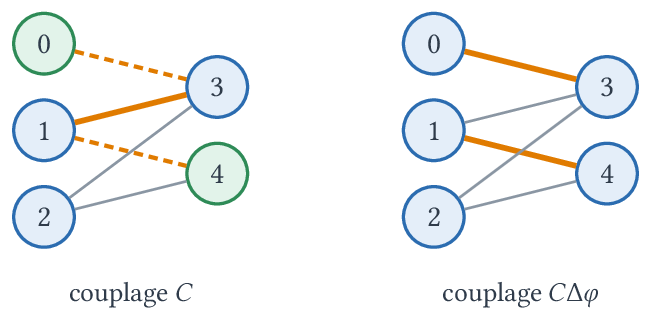
Dans le graphe biparti suivant, avec \(S_1 = \{0, 1, 2\}\) et \(S_2 = \{3, 4\}\), le couplage \(C = \{\{1, 3\}\}\) est représenté à gauche en trait épais. Le chemin \(\varphi = 0 \smile 3 \smile 1 \smile 4\), dont les arêtes hors de \(C\) sont en pointillés, est augmentant : \(0\) et \(4\) sont libres et les arêtes alternent hors de \(C\), dans \(C\), hors de \(C\). En échangeant le statut des arêtes de \(\varphi\), on obtient le couplage de droite, qui a une arête de plus. Il est maximal puisque chaque arête contient un sommet de \(S_2\), qui n'a que deux sommets.
Lemme
Soit \(C, C'\) des couplages de \(G = (S,A)\). On considère \(G' = (S, C \Delta C')\), où \(C \Delta C' = (C \setminus C') \cup (C' \setminus C)\) est la différence symétrique.
Les composantes connexes de \(G'\) sont :
- soit des sommets isolés ;
- soit des cycles de longueur paire alternant entre arêtes de \(C\) et de \(C'\) ;
- soit des chemins élémentaires alternant entre arêtes de \(C\) et de \(C'\) ayant des extrémités distinctes.
Preuve
Les sommets de \(G'\) sont de degré au plus 2 car ils sont de degré au plus 1 dans \((S,C)\) et dans \((S,C')\). Or une composante connexe d'un graphe dont les sommets sont de degré au plus 2 est un sommet isolé, un chemin élémentaire ou un cycle : on part d'un sommet de degré 1 s'il y en a un, sinon de n'importe quel sommet, et on avance d'arête en arête sans jamais pouvoir bifurquer.
De plus, deux arêtes de \(C\) (ou deux arêtes de \(C'\)) ne peuvent avoir une extrémité en commun : un chemin de \(G'\) alterne donc forcément entre arêtes de \(C\) et de \(C'\). Les cycles sont ainsi nécessairement de longueur paire.
Théorème (Berge, 1957)
\(C\) n'a pas de chemin augmentant si et seulement si \(C\) est un couplage maximal.
Preuve
On va montrer la contraposée : \(C\) non maximal si et seulement si \(C\) a un chemin augmentant.
\(\Leftarrow\)) Supposons que \(G\) dispose d'un chemin augmentant \(\varphi\). On considère \(C'\) la différence symétrique de \(C\) et de l'ensemble des arêtes de \(\varphi\). Ainsi, \(C'\) est obtenu en retirant de \(C\) les \(n\) arêtes de \(\varphi\) qui sont dans \(C\) et en ajoutant les \(n + 1\) arêtes de \(\varphi\) qui n'y sont pas : \(C'\) a une arête de plus que \(C\).
De plus, \(C'\) est un couplage. En effet, comme \(\varphi\) est élémentaire, chaque sommet intérieur de \(\varphi\) appartenait à exactement une arête de \(C\), qui était dans \(\varphi\) et a été retirée, et appartient à exactement une arête ajoutée. Les deux extrémités de \(\varphi\) étaient libres et appartiennent à exactement une arête ajoutée. Les autres sommets ne sont pas concernés. Ainsi \(C\) n'est pas maximal.
\(\Rightarrow\)) Supposons que \(C\) n'est pas maximal : il existe un couplage \(C'\) tel que \(|C'|>|C|\). Le graphe \(G' = (S, C \Delta C')\) contient plus d'arêtes de \(C'\) que de \(C\), il a donc une composante qui contient plus d'arêtes de \(C'\) que de \(C\). D'après le lemme, ce ne peut pas être un cycle : c'est un chemin élémentaire alternant, qui commence et finit par une arête de \(C' \setminus C\). Ses extrémités sont libres pour \(C\) : si une extrémité \(u\) appartenait à une arête \(e \in C\), on aurait \(e \notin C'\) puisque \(u\) appartient déjà à une arête de \(C'\) distincte de \(e\) (celle du chemin, qui n'est pas dans \(C\)). On aurait alors \(e \in C \Delta C'\) et \(u\) serait de degré 2 dans \(G'\), ce qui est impossible pour une extrémité. Ce chemin est donc augmentant pour \(C\).
Remarque
Ce théorème et sa preuve sont valables dans tout graphe, biparti ou non. C'est la recherche d'un chemin augmentant qui est plus simple dans le cas biparti : dans un graphe quelconque, il faut un algorithme plus subtil (algorithme d'Edmonds, hors programme).
Déterminer un chemin augmentant dans un graphe biparti
On considère ici un graphe biparti avec \(S = S_1 \cup S_2\) et un couplage \(C\).
Pour déterminer un chemin augmentant pour \(C\), on oriente les arêtes \(\{x,y\}\), avec \(x \in S_1\) et \(y \in S_2\), ainsi :
- \(y \rightarrow x\) si \(\{x,y\} \in C\) ;
- \(x \rightarrow y\) sinon.
On rajoute également deux sommets :
- un sommet source noté \(s\) avec \(s \rightarrow x\) pour tout sommet libre \(x\) de \(S_1\) ;
- un sommet but noté \(t\) avec \(y \rightarrow t\) pour tout sommet libre \(y\) de \(S_2\).
On appelle ce graphe orienté le graphe résiduel associé à \(C\), comme dans le TP. On remarque qu'un sommet non libre \(y\) de \(S_2\) est nécessairement de degré sortant 1 : son unique arête sortante est \(y \rightarrow x\) où \(\{x,y\} \in C\).
S'il existe un chemin de \(s\) à \(t\) dans ce graphe orienté, alors il existe un chemin élémentaire de \(s\) à \(t\) (on peut supprimer les portions entre deux passages par un même sommet ; le chemin donné par l'arbre d'un parcours est d'ailleurs directement élémentaire). Un tel chemin est de la forme :
avec :
- \(x_1\) libre dans \(S_1\), car l'arête \(s \rightarrow x_1\) n'existe que dans ce cas ;
- \(y_n\) libre dans \(S_2\), pour la même raison ;
- tous les autres \(x_i\) et \(y_j\) non libres : un \(y_j\) libre n'a pas d'arête sortante vers \(S_1\) et un \(x_i\) libre n'a pas d'arête entrante depuis \(S_2\) ;
- \(\{x_i,y_i\}\not \in C\), car ces arêtes vont de \(S_1\) vers \(S_2\) ;
- \(\{y_i,x_{i+1}\} \in C\), car ces arêtes vont de \(S_2\) vers \(S_1\) ;
- les \(x_i\) et \(y_j\) deux à deux distincts, car le chemin est élémentaire.
Le chemin \(x_1 \smile y_1 \smile \dots \smile y_n\) est donc augmentant. Réciproquement, un chemin augmentant, parcouru depuis son extrémité dans \(S_1\), donne un chemin de \(s\) à \(t\) dans le graphe résiduel.
Théorème
\(C\) admet un chemin augmentant si et seulement si \(t\) est accessible depuis \(s\) dans le graphe résiduel associé à \(C\). On peut donc en trouver un, ou déterminer qu'il n'en existe pas, en \(O(|S|+|A|)\) par un parcours.
On en déduit un algorithme de calcul d'un couplage maximal : on part du couplage vide et, tant qu'on trouve un chemin augmentant, on échange le statut de ses arêtes. Chaque augmentation fait grossir le couplage d'une arête et un couplage a au plus \(\min(|S_1|, |S_2|)\) arêtes : on fait au plus \(|S|/2\) augmentations, d'où une complexité en \(O(|S|(|S|+|A|))\). D'après le théorème de Berge, le couplage obtenu est maximal.
En pratique, comme dans le TP Couplage, on cherche successivement un chemin augmentant depuis chaque sommet libre de \(S_1\), une seule fois chacun. C'est justifié par la propriété suivante.
Propriété
Soit \(u \in S_1\) un sommet libre pour \(C\) duquel ne part aucun chemin augmentant. Si \(C'\) est obtenu à partir de \(C\) en échangeant le statut des arêtes d'un chemin augmentant \(\varphi\), alors aucun chemin augmentant pour \(C'\) ne part de \(u\).
Preuve
On travaille dans le graphe résiduel sans \(s\) ni \(t\). Un chemin augmentant pour \(C\) partant de \(u\) correspond à un chemin dans ce graphe de \(u\) vers un sommet libre de \(S_2\). Soit \(R\) l'ensemble des sommets accessibles depuis \(u\) dans le graphe résiduel associé à \(C\) : par hypothèse, \(R\) ne contient aucun sommet libre de \(S_2\) et, par définition, aucune arête de ce graphe ne sort de \(R\).
Le chemin \(\varphi\) correspond à un chemin du graphe résiduel allant d'un sommet libre de \(S_1\) à un sommet libre \(v\) de \(S_2\). Il ne passe par aucun sommet de \(R\) : sinon \(v\) serait accessible depuis ce sommet, donc depuis \(u\), et serait dans \(R\).
Le graphe résiduel associé à \(C'\) s'obtient en renversant les arêtes de \(\varphi\), dont aucune extrémité n'est dans \(R\). Aucune arête ne sort donc de \(R\) dans ce nouveau graphe : les sommets accessibles depuis \(u\) sont encore dans \(R\). Enfin, un sommet de \(S_2\) libre pour \(C'\) l'était pour \(C\), donc \(R\) ne contient toujours aucun sommet libre de \(S_2\), et \(u\) est toujours libre car \(u \notin \varphi\).
Remarque
En cherchant un plus court chemin augmentant par un parcours en largeur, et en augmentant plusieurs chemins disjoints à chaque phase, on obtient l'algorithme de Hopcroft-Karp en \(O(\sqrt{|S|}\,|A|)\), hors programme.
Exercices
Exercice
On considère un chemin entre deux sommets \(x\) et \(y\) dans un graphe non orienté pondéré. La largeur de ce chemin est le plus petit poids des arêtes présentes dans ce chemin. Le chemin vide de \(x\) à \(x\) est de largeur \(+\infty\).
La distance de goulot d'étranglement entre \(x\) et \(y\) est la largeur maximale d'un chemin de \(x\) à \(y\). S'il n'en existe pas, cette distance est \(-\infty\).
- Prouver qu'un arbre couvrant de poids maximal d'un graphe connexe contient un chemin le plus large entre toute paire de sommets.
- Décrire un algorithme pour résoudre en temps \(O(|S|+|A|)\) le problème suivant : étant donné un graphe non orienté pondéré \(G = (S,A)\), \(x, y \in S\) et \(W \in \R\), est-ce que la distance de goulot d'étranglement entre \(x\) et \(y\) est inférieure ou égale à \(W\) ?
- On suppose que la distance de goulot d'étranglement entre \(x \neq y\) est
\(B \in \R\).
- Prouver que la suppression d'une arête de poids strictement inférieur à \(B\) ne change pas cette distance.
- Prouver que la contraction d'une arête de poids strictement supérieur à \(B\) ne change pas cette distance. La contraction d'une arête \(\{u,v\}\) revient à identifier \(u\) et \(v\) ; si cette contraction crée des arêtes parallèles, on ne conservera que l'arête de plus grand poids.
Corrigé
-
On considère un arbre couvrant de poids maximal \(T\) et deux sommets distincts \(x,y\). Supposons par l'absurde que l'unique chemin de \(x\) à \(y\) dans \(T\) ne soit pas un chemin le plus large : sa largeur est strictement inférieure à la distance de goulot d'étranglement \(B\). Son arête de plus petit poids \(e\) vérifie donc \(w(e) < B\). On considère \(T' = T \setminus\{e\}\), qui a exactement deux composantes connexes, l'une contenant \(x\) et l'autre \(y\). Un chemin le plus large de \(x\) à \(y\), de largeur \(B\), contient forcément une arête \(e'\) reliant ces deux composantes, avec \(e' \notin T\) et \(w(e') \ge B > w(e)\). Alors \(T'' = T' \cup \{e'\}\) est connexe à \(|S| - 1\) arêtes, c'est un arbre couvrant avec \(w(T'') = w(T) + w(e') - w(e) > w(T)\). Contradiction.
-
La distance est strictement supérieure à \(W\) si et seulement s'il existe un chemin de \(x\) à \(y\) dont toutes les arêtes sont de poids strictement supérieur à \(W\) (pour \(x = y\), le chemin vide convient et la distance vaut \(+\infty\)). On effectue donc un parcours depuis \(x\) en ignorant les arêtes de poids inférieur ou égal à \(W\), et on répond « oui » si et seulement si \(y\) n'est pas atteint. C'est un parcours, en \(O(|S| + |A|)\).
-
Pour les deux sous-questions :
- 3.1. Supprimer une arête ne fait que retirer des chemins, donc la distance ne peut que diminuer. Mais un chemin de largeur \(B\) ne contient aucune arête de poids strictement inférieur à \(B\) : il existe encore après la suppression, et la distance reste \(B\).
- 3.2. L'arête contractée \(e = \{u, v\}\) ne relie pas \(x\) et \(y\) : sinon on aurait \(B \ge w(e) > B\). Tout chemin de \(G\) donne un chemin du graphe contracté passant par des arêtes de poids au moins aussi grand (seule \(e\) disparaît, et on garde le plus grand poids parmi les arêtes parallèles), donc de largeur au moins égale : la distance ne diminue pas. Réciproquement, un chemin du graphe contracté se relève en un chemin de \(G\) en insérant éventuellement l'arête \(e\) là où il passe par le sommet fusionné. Sa largeur est au moins le minimum de la largeur initiale et de \(w(e) > B\). Si le chemin contracté avait une largeur strictement supérieure à \(B\), on obtiendrait dans \(G\) un chemin de largeur strictement supérieure à \(B\) : c'est impossible. La distance reste donc \(B\).