Structure abstraite séquence ou liste
La structure abstraite liste, ou également séquence dans des contextes,
comme en OCaml, où le terme liste fait référence aux listes chaînées, est
la structure la plus simple pour stocker des données.
Une séquence d'éléments de type t est un type S(t) dont les éléments
représentent des valeurs du type t rangées séquentiellement dans un ordre,
de la première à la dernière valeur. La vision logique la plus proche de cela
est d'imaginer des cases ayant un indice, en commençant en général à l'indice
0, et contenant des valeurs.
On renvoie au chapitre Structures de données abstraites et implémentations pour les notions générales d'interface, d'implémentation et de structure mutable ou immuable.
Implémentations concrètes des listes chaînées
En C
Représentation et type
Il existe de nombreuses possibilités d'implémentation des listes chaînées en
C. On présente ici les opérations autour d'une implémentation et on discutera
ensuite des alternatives.
Dans les limites du programme, on ne présente que des listes permettant de contenir un même type, ici des entiers.
Une liste est ainsi un pointeur sur un maillon et un maillon est un couple
(valeur, suivant) représenté dans une struct où suivant pointe vers le
prochain maillon de la chaîne. Le pointeur nul, de valeur NULL, permet ainsi
de représenter la liste vide.
struct maillon {
    int valeur;
    struct maillon *suivant;
};
typedef struct maillon maillon;
typedef maillon *liste;
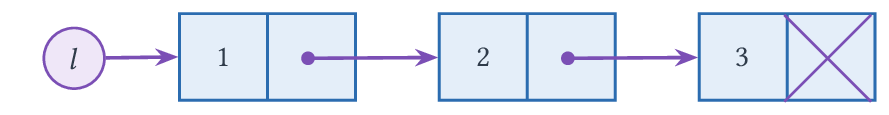
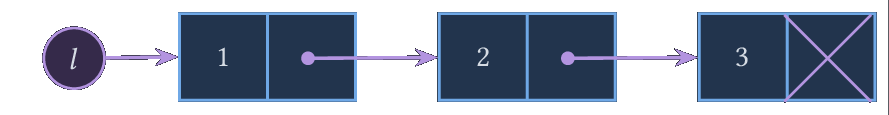
On représentera graphiquement le pointeur nul par une croix et les maillons par
des blocs contenant une valeur et un pointeur. Ainsi, le dernier maillon de la
liste contient une croix. La liste l correspondant à la valeur qu'on pourrait
noter [1,2,3] sera représentée ainsi :
Constructeur
On parle de constructeur pour des fonctions qui permettent d'allouer et
d'initialiser une valeur d'une structure de données. Ici, comme les listes sont
des pointeurs sur des maillons, il s'agit uniquement de créer un
maillon. Pour cela, on va utiliser malloc pour allouer dynamiquement un
nouveau maillon.
maillon *maillon_creer(int valeur, maillon *suivant)
{
    maillon *m = malloc(sizeof(maillon));
    m->valeur = valeur;
    m->suivant = suivant;
    return m;
}
En fait, ce constructeur pourrait être découpé en deux parties : l'allocation qui va se charger de récupérer un emplacement mémoire pour le maillon et l'initialisation qui va attribuer des valeurs.
maillon *maillon_allouer(void)
{
    return malloc(sizeof(maillon));
}

void maillon_initialiser(maillon *m, int valeur, maillon *suivant)
{
    m->valeur = valeur;
    m->suivant = suivant;
}

maillon *maillon_creer(int valeur, maillon *suivant)
{
    maillon *m = maillon_allouer();
    maillon_initialiser(m, valeur, suivant);
    return m;
}
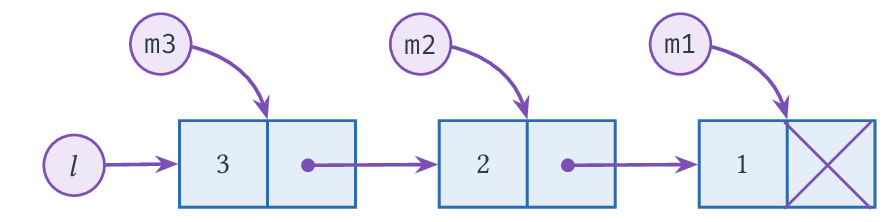
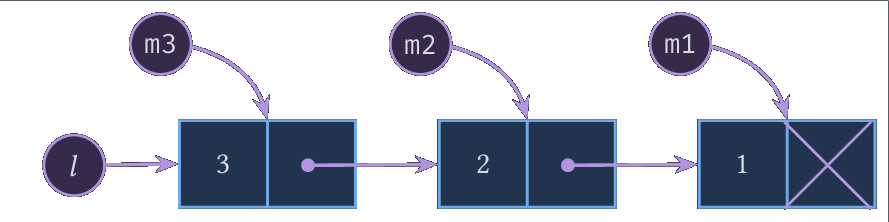
On peut alors commencer à créer des listes en enchaînant les maillons :
maillon *m1 = maillon_creer(1, NULL); // pas de suivant, c'est le dernier maillon
maillon *m2 = maillon_creer(2, m1);
maillon *m3 = maillon_creer(3, m2);
liste l = m3; // la liste pointe sur le premier maillon
Comme le pointeur sur le premier maillon suffit ici, on aurait pu directement écrire :
liste l = maillon_creer(3,
            maillon_creer(2,
                maillon_creer(1, NULL)));
Destructeur
Pour détruire un maillon, il suffit de libérer l'espace qu'on lui a attribué.
void maillon_detruire(maillon *m)
{
    free(m);
}
Pour détruire une liste, on va par contre avoir besoin de parcourir l'ensemble des maillons qui la constituent. Comme pour les autres parcours, on a alors deux choix :
-
parcours récursif : on a un cas de base quand la liste est vide et dans le cas général, un éventuel appel récursif sur le pointeur
suivant.void liste_detruire(liste l) { if (l != NULL) { liste_detruire(l->suivant); maillon_detruire(l); // Attention à l'ordre pour l->suivant } } -
parcours impératif : on boucle tant que la liste est non nulle. On fait ici attention à ne pas accéder à
->suivantaprès avoir libéré le maillon.void liste_detruire(liste l) { while (l != NULL) { liste suivante = l->suivant; maillon_detruire(l); l = suivante; } }
Ajout et suppression en tête
Pour ajouter ou supprimer un maillon en tête de la liste, on va avoir besoin de modifier le pointeur vers le premier maillon. Pour cela, on a deux approches possibles :
-
passer un pointeur vers la liste elle-même, c'est-à-dire un pointeur sur un pointeur sur un maillon, ce qui en
Caura le typemaillon **, qui s'écrit aussiliste *. On aura alors le prototype :void liste_ajout_en_tete(liste *l, int valeur); -
renvoyer un pointeur vers le nouveau premier maillon. On aura alors le prototype :
liste liste_ajout_en_tete(liste l, int valeur);
On présente ici les versions renvoyant une nouvelle liste :
liste liste_ajout_en_tete(liste l, int valeur)
{
    maillon *m = maillon_creer(valeur, l);
    return m;
}
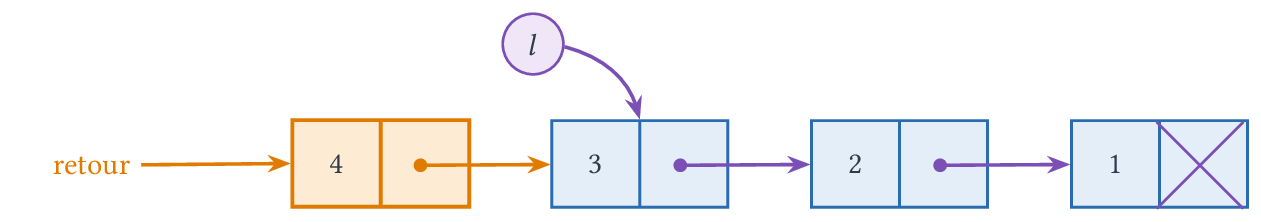
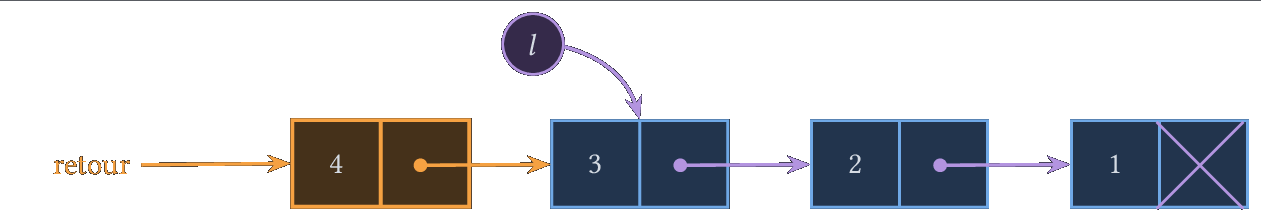
Si l est la liste précédente contenant 3,2,1 et qu'on ajoute 4 en tête,
on va donc directement créer un nouveau maillon et renvoyer un pointeur
vers celui-ci.
liste liste_suppr_en_tete(liste l)
{
    assert(l != NULL);
    liste queue = l->suivant;
    maillon_detruire(l); // Attention, on détruit juste le maillon, pas la liste
    return queue;
}
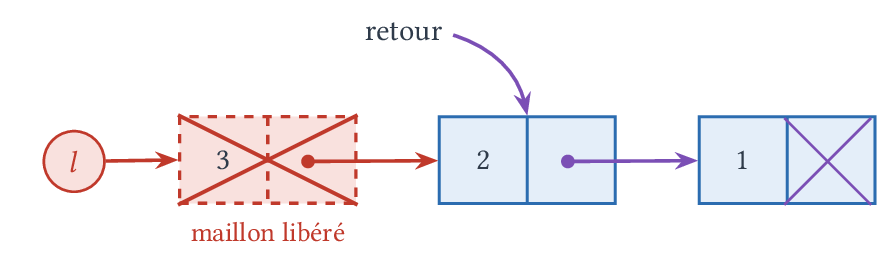
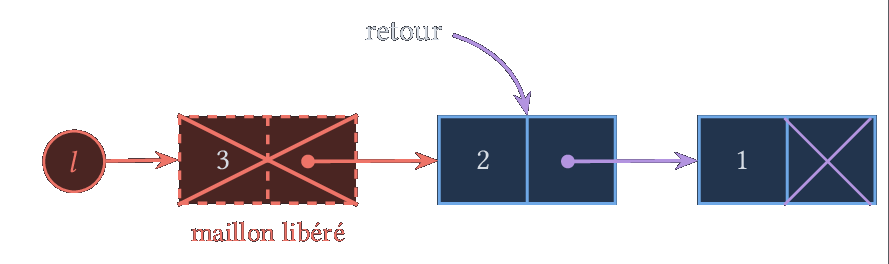
Si l est la liste précédente contenant 3,2,1 et qu'on supprime le maillon
de tête, on va renvoyer un pointeur sur le second maillon. Attention, ici
le pointeur initial l est devenu invalide.
Longueur de la liste
On présente ici le calcul de la longueur comme exemple de parcours de la liste. C'est encore très proche du parcours effectué dans le destructeur.
int liste_longueur(liste l)
{
    int longueur = 0;
    while(l != NULL)
    {
        longueur = longueur + 1;
        l = l->suivant;
    }
    return longueur;
}
Accès au n-ième maillon de la liste
On effectue un parcours similaire pour accéder au n-ième maillon (les indices commençant à 0).
maillon *liste_nieme(liste l, int n)
{
    while(n > 0)
    {
        assert(l != NULL);
        l = l->suivant;
        n = n-1;
    }
    assert(l != NULL);
    return l;
}
Toujours avec un programme similaire, on peut chercher un maillon avec sa valeur :
maillon *liste_recherche(liste l, int x)
{
    while(l != NULL && l->valeur != x)
    {
        l = l->suivant;
    }
    return l;
}
Ici, pas besoin d'assert : en cas d'échec de la recherche, on renvoie un
pointeur nul.
Ajout/suppression ailleurs qu'en tête
Pour ajouter ou supprimer ailleurs qu'en tête, il est nécessaire de pouvoir repérer précisément un maillon. Pour cela, on peut le faire :
- par son indice, celui utilisé dans
liste_nieme; - par sa valeur, avec une recherche ;
- ou encore directement par un pointeur sur le maillon.
Une fois le maillon repéré, on peut procéder comme pour un ajout/suppression
en tête, cependant il va falloir reconnecter le pointeur suivant du maillon
précédent. Pour cela deux choix :
- soit on considère qu'on ajoute après, auquel cas on dispose du précédent ;
- soit on considère qu'on ajoute avant ou qu'on supprime, et pour cela on effectue une boucle pour déterminer le maillon précédent.
void liste_ajout_apres(liste l, maillon *m, int x)
{
    m->suivant = liste_ajout_en_tete(m->suivant, x);
}

void liste_ajout_avant(liste l, maillon *m, int x)
{
    liste prec = NULL;
    while(l != m)
    {
        assert(l != NULL);
        prec = l;
        l = l->suivant;
    }
    assert(prec != NULL); // m n'est pas le premier maillon
    prec->suivant = liste_ajout_en_tete(m, x);
}
Remarque
La fonction liste_ajout_avant ne peut pas ajouter avant le premier
maillon : il faudrait pour cela modifier la liste l elle-même, ce qui
n'est pas possible avec ce prototype. Dans ce cas, on utilise
liste_ajout_en_tete. Le paramètre l de liste_ajout_apres n'est pas
utilisé : il n'est là que pour garder la même interface.
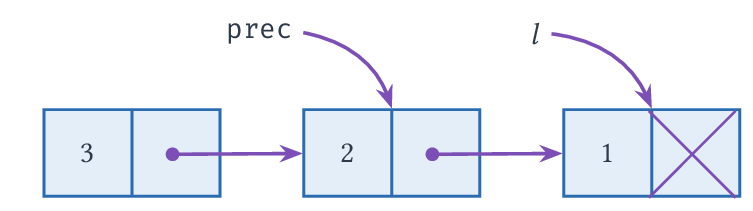
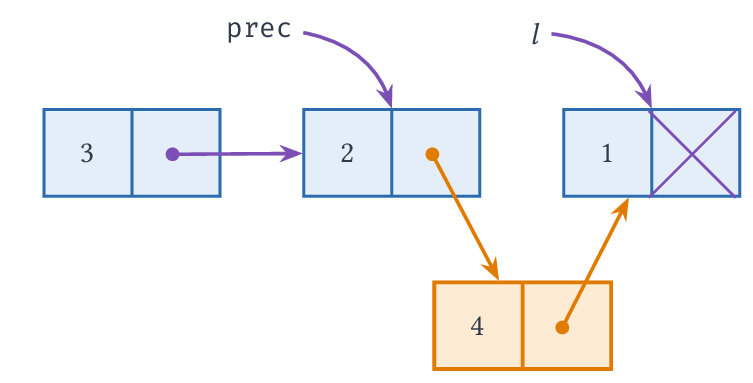
Si on reprend la liste l contenant 3,2,1 et qu'on souhaite insérer la
valeur 4 avant la valeur 1, on va passer un pointeur m vers le
maillon contenant 1 et effectuer un parcours jusqu'à avoir prec et l
dans la configuration :
On dispose alors des pointeurs permettant de réaliser l'ajout :
De même pour la suppression d'un maillon qui n'est pas en tête :
void liste_suppr_non_en_tete(liste l, maillon *m)
{
    liste prec = NULL;
    while(l != m)
    {
        assert(l != NULL);
        prec = l;
        l = l->suivant;
    }
    assert(prec != NULL); // m n'est pas le premier maillon
    prec->suivant = liste_suppr_en_tete(m);
}
En fait, lorsqu'on regarde le parcours précédent, on remarque deux points :
- comme on a donné le maillon concerné, le parcours a uniquement pour but de repérer le maillon qui le précède ;
- on pourrait se contenter d'utiliser uniquement un pointeur sur le maillon
précédent lors du parcours car le maillon qui le suit est accessible avec
->suivant.
Autres implémentations
Une autre implémentation standard consiste à cacher le pointeur sur le premier maillon, ce qui permet de donner également un pointeur sur le dernier maillon. En effet, le pointeur sur le dernier maillon permet de réaliser un ajout en fin de liste en \(O(1)\) car il n'y a pas besoin de parcourir la liste pour faire cet ajout.
On obtient alors un type comme :
struct maillon {
    int valeur;
    struct maillon *suivant;
};
typedef struct maillon maillon;

struct liste {
    maillon *premier;
    maillon *dernier;
};
typedef struct liste liste;
Cette implémentation est l'occasion de se poser la question sur la répartition entre pile et tas pour les données. On peut légitimement penser que les listes ici ne sont que des couples de pointeurs, et qu'ainsi les passer par copie est léger comparativement à la complexité induite par une allocation sur le tas.
En OCaml
Cas des 'a list
Tout d'abord, il faut se rendre compte que le type par défaut
type 'a list = [] | (::) of 'a * 'a list
fait intervenir des maillons et des pointeurs. La différence principale avec
C est qu'on ne peut pas changer la valeur des pointeurs.
Type des listes chaînées
Pour retrouver la richesse du type précédent, on peut définir un type comme :
type 'a maillon = {
    mutable valeur : 'a;
    mutable suivant : 'a liste
} and 'a liste = Vide | Lien of 'a maillon
Ici, le type est une traduction directe du type précédent. On remarque que les
types sont mutuellement récursifs car un maillon contient une liste. Le type
somme 'a liste ressemble fortement à un pointeur qui peut être nul ou pointer
sur un maillon. On remarque qu'on aurait pu aussi se contenter d'écrire le type
suivant :
type 'a maillon = {
    mutable valeur : 'a;
    mutable suivant : 'a maillon option
}

type 'a liste = 'a maillon option
Mais on va préférer le premier type qui a l'avantage de permettre de bien faire apparaître la structure.
Ajout et suppression en tête
Pour rajouter un maillon en tête, on peut écrire :
let cons x l = Lien { valeur = x; suivant = l}
On remarque que la fonction est beaucoup plus simple que celle en C car
l'allocation est automatique et l'initialisation se fait naturellement dans la
syntaxe. Cette fonction renvoie une nouvelle liste, on aurait pu aussi
rajouter une référence pour les listes afin de permettre de les rendre
modifiables, c'est la même discussion que dans la partie précédente.
La suppression en tête revient à renvoyer la queue de la liste, comme le
fait List.tl :
let tl l  = match l with
    | Vide -> failwith "Liste vide"
    | Lien { valeur = _; suivant = q} -> q
On remarque le filtrage imbriqué | Lien { valeur = t; suivant = q } qui
correspond au filtrage | t :: q du type 'a list.
Exemple de parcours sans modification : calcul de la longueur
Vu les remarques précédentes, il n'est pas étonnant que le parcours d'une liste de manière récursive soit très proche de ce qu'on a déjà pu voir avec les listes de base.
let rec longueur l = match l with
    | Vide -> 0
    | Lien { valeur = _; suivant = q } -> 1 + longueur q
On en déduit de même une fonction renvoyant un maillon par son indice :
let rec nieme l n = match l with
    | Vide -> failwith "Liste vide"
    | Lien m -> if n = 0 then m else nieme m.suivant (n-1)
Remarque
Il est possible de réécrire la fonction précédente en permettant à la fois de
donner un nom, ici m, au maillon et de faire un filtrage sur ce qu'il
contient. Pour cela, on utilise le mot clé as en OCaml :
let rec nieme l n = match l with
    | Vide -> failwith "Liste vide"
    | Lien ({ valeur=_; suivant = q} as m) ->
            if n = 0 then m else nieme q (n-1)
Exemple de parcours avec modification : ajout d'un maillon en fin de liste
On va montrer un exemple de modification de liste en rajoutant un maillon en fin d'une liste non vide. Ici, on effectue un parcours jusqu'à tomber sur le dernier maillon auquel on rajoute le nouveau à la suite.
let rec ajout_fin l x =
    match l with
    | Vide -> failwith "Liste vide"
    | Lien m ->
        if m.suivant = Vide
        then m.suivant <- Lien { valeur = x; suivant = Vide }
        else ajout_fin m.suivant x
Raffinement pour permettre l'ajout à la fin en temps constant
Le programme précédent est à comparer au programme suivant :
let rec ajout_fin l x =
    match l with
    | [] -> [x]
    | t::q -> t :: ajout_fin q x
On n'a pas l'impression d'avoir vraiment gagné en expressivité ou en efficacité.
Cependant, on peut se dire qu'en changeant le type 'a liste on peut tirer
parti des maillons pour obtenir un ajout en fin de liste en temps constant.
Le programme suivant présente une interface permettant de le faire.
type 'a maillon = {
    mutable valeur : 'a;
    mutable suivant : 'a maillon_ptr
  }
and 'a maillon_ptr = 'a maillon option
and 'a liste = {
      mutable premier : 'a maillon_ptr;
      mutable dernier : 'a maillon_ptr
  }

let liste_vide () = { premier = None; dernier = None }

let ajout_debut l x =
    l.premier <- Some { valeur = x; suivant = l.premier };
    if l.dernier = None
    then l.dernier <- l.premier

let suppr_debut l =
    match l.premier with
    | None -> failwith "Liste vide"
    | Some { valeur = _; suivant = l' } ->
            l.premier <- l';
            if l' = None
            then l.dernier <- None

let ajout_fin l x =
    let m = { valeur = x; suivant = None } in
    (match l.dernier with
    | Some m' -> m'.suivant <- Some m
    | None -> () );
    l.dernier <- Some m;
    if l.premier = None
    then l.premier <- l.dernier
Quelques remarques sur ce programme :
- comme on change directement
premieretdernier, il est nécessaire de générer une nouvelle liste vide, ce qui est assuré ici par le paramètre(); - les pointeurs sont représentés par des options dans des champs mutables ;
- afin de préserver l'intégrité des deux pointeurs, on est obligé de gérer les
cas où il n'y a qu'un seul maillon : quand on ajoute dans une liste vide, ou
quand on supprime l'unique maillon,
premieretdernierdoivent être mis à jour ensemble ; - attention à la priorité du cas de filtrage sur
;qui oblige à mettre des parenthèses dansajout_fin.
Cette structure réalise une file : on ajoute avec ajout_fin et on retire avec
suppr_debut, chaque opération étant en temps constant (voir le chapitre
Piles et files).
Structure de la mémoire
En mémoire, les maillons d'une liste chaînée, comme celle vue en C, sont sur
le tas et de manière désorganisée. Cela signifie qu'il n'y a aucune raison que
deux maillons proches dans une liste soient proches en mémoire.
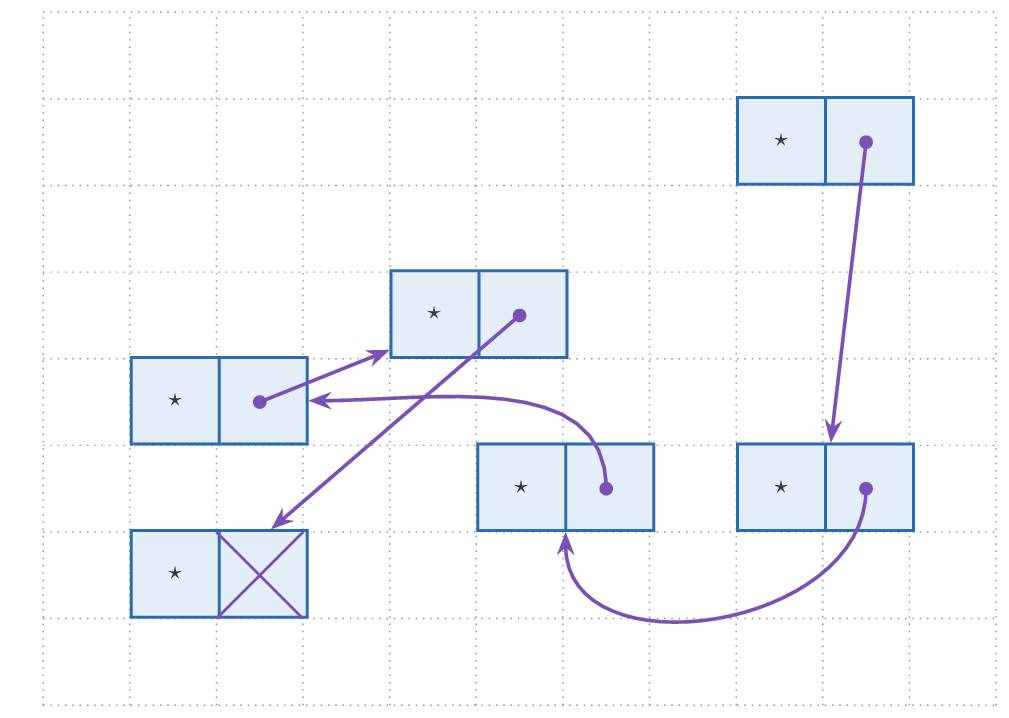
Or, les processeurs optimisent la gestion de la mémoire à l'aide d'un cache qui, au lieu de n'accéder qu'à une seule valeur située à une adresse, va charger une zone mémoire autour de cette adresse. Ceci encourage une cohérence spatiale dans l'organisation de la mémoire afin de profiter au maximum de cette mise en cache.
Une stratégie pour réaliser des listes chaînées efficacement peut consister à allouer un tableau de maillons et à gérer ensuite les allocations parmi cette réserve.
Travaux pratiques
On présente ici un énoncé de travaux pratiques en C en lien avec ce
chapitre.
Tableaux non statiques et tableaux dynamiques
On va définir ici une structure de données pour gérer des tableaux dont la
taille ne sera connue qu'à l'exécution. Pour simplifier, ce seront des tableaux
d'entiers int mais la méthode s'adapte naturellement pour des tableaux de
n'importe quoi.
Type array
On définit le type suivant :
struct array {
    int *elements;
    unsigned int size;
};
typedef struct array array;
Un array est donc une structure qui contient :
- un pointeur vers un tableau
elementsd'entiers ; - un entier indiquant la taille de ce tableau.
Remarque importante : quand on copie un pointeur, on copie uniquement un
entier qui est l'adresse pointée. Ainsi, quand on copie un array, ce n'est
finalement qu'un couple d'entiers qu'on copie. C'est pourquoi, dans la suite,
on passe tous les array par valeur. C'est-à-dire que pour définir une
fonction de recherche d'un élément dans un array on va écrire :
int search(array t, int x)
{
    for(int i = 0; i < t.size; i++)
    {
        if(t.elements[i] == x)
        {
            return i;
        }
    }

    return -1;
}
Quand on va appeler la fonction, on va avoir une copie de l'argument,
c'est-à-dire du array, mais le tableau elements lui sera toujours à
la même place. L'alternative serait de passer les valeurs array par
pointeurs comme dans la variante suivante :
int search(array *t, int x)
{
    for(int i = 0; i < t->size; i++)
    {
        if(t->elements[i] == x)
        {
            return i;
        }
    }

    return -1;
}
On n'a rien à gagner au surplus de complexité induit par cela. L'unique avantage serait de permettre de modifier les paramètres de la structure passée en argument, mais on réservera ça aux fonctions qui le nécessitent.
Allocation, initialisation, libération
Pour les fonctions suivantes, on fera usage de malloc et free.
Question 1
Écrire une fonction de prototype array array_alloc(unsigned int size)
qui alloue un tableau de size entiers avec malloc et renvoie le array
pointant dessus.
Conformément à ce qui est écrit au-dessus, on peut créer un array en
variable locale et le renvoyer avec return, ce qui compte c'est la mémoire
pointée.
Corrigé
array array_alloc(unsigned int size)
{
    array a;
    a.elements = (int *)malloc(sizeof(int) * size);
    a.size = size;
    return a;
}
Question 2
Écrire une fonction de prototype void array_free(array t) qui libère le
tableau pointé par t avec free. À partir de ce moment, on ne peut plus
utiliser cette adresse sans faire d'erreurs.
Corrigé
void array_free(array a)
{
    free(a.elements);
}
Question 3
Le tableau alloué n'est pas initialisé, écrire une fonction de prototype
array array_make(unsigned int size, int def) qui alloue un tableau et
initialise toutes les valeurs de celui-ci à def.
Corrigé
array array_make(unsigned int size, int def)
{
    array a = array_alloc(size);
    for(int i = 0; i < size; i++)
    {
        a.elements[i] = def;
    }
    return a;
}
Question 4
Il est possible de mesurer le temps pris par un programme à l'aide de la
commande time :
$> time ./main
./main  0.38s user 0.00s system 99% cpu 0.379 total
Comparer le temps d'exécution d'un programme qui
- alloue puis libère 100 fois un tableau d'un million d'entiers ;
- alloue en initialisant à 0 avec
array_makepuis libère 100 fois un tableau d'un million d'entiers.
Que peut-on en conclure ?
Corrigé
On se rend compte que l'allocation est presque instantanée alors que l'initialisation prend un temps linéaire en la taille des données. Ceci est cohérent avec le fait que la mémoire est allouée de manière paresseuse. On s'en rend d'autant plus compte en examinant l'empreinte mémoire des programmes.
Remarque
Il existe d'autres fonctions que malloc comme
void *calloc(size_t nmemb, size_t size);
void *realloc(void *ptr, size_t size);
qui permettent :
- pour
callocd'allouer un tableau denmembmembres qui sont chacun de taillesizeet d'initialiser les octets à 0 ; - pour
reallocde déplacer en mémoire un tableau en changeant sa taille (en plus ou en moins). Si jamais il y a de la place on ne bouge pas le tableau. C'est donc en général plus efficace que de le faire à la main.
Ces deux fonctions sont hors programme !
Affichage, copie
Question 5
Écrire une fonction void array_print(array a) qui affiche [a1,a2,...,an]
si a contient les éléments de a1 à an.
Remarque : cette fonction vous sera utile pour tester ce que vous avez fait dans la suite.
Corrigé
void array_print(array a)
{
    printf("[");
    for(int i = 0; i < a.size; i++)
    {
        printf("%d", a.elements[i]);
        if(i < a.size - 1)
            printf(",");
    }
    printf("]\n");
}
Question 6
Écrire une fonction de prototype
void array_blit(array src, int src_start,
    array dst, int dst_start, int len)
qui copie len éléments depuis le tableau src à partir de l'indice
src_start dans le tableau dst à partir de l'indice dst_start.
Remarque : on a déjà écrit cette fonction en OCaml, vous pouvez vous en
inspirer.
Corrigé
void array_blit(array src, int src_start,
            array dst, int dst_start, int len)
{
    for(int i = 0; i < len; i++)
        dst.elements[i + dst_start] =
            src.elements[i + src_start];
}
Implémentation d'une pile non bornée
Question 7
Écrire une fonction de prototype void array_push(array *a, int x)
qui rajoute x à la fin du array a, c'est-à-dire :
- on va allouer un nouveau
arraybdont le tableau contienta->size+1éléments ; - on va copier les anciennes valeurs de
*adansb; - écrire
x; - libérer
*a; - remplacer avec
*a = b.
Remarque : on peut tout à fait écrire *a = b pour que a ait les mêmes
valeurs que b en dehors de la fonction.
Rappel : pour une struct passée par pointeur, on utilise -> pour
accéder aux champs. Donc a->elements et a->size ici.
Remarque : faites des tests, par exemple en créant un tableau de taille 0,
en empilant les entiers de 1 à 10 et en affichant le résultat. Faites les
tests avec -fsanitize=address.
Corrigé
void array_push(array *a, int x)
{
    array b = array_alloc(a->size+1);
    array_blit(*a, 0, b, 0, a->size);
    b.elements[a->size] = x;
    array_free(*a);
    *a = b;
}

// Note qu'on aurait pu proposer une interface persistante pour push/pop ainsi
// pas de pointeurs mais on renvoie le nouveau array
array array_push_2(array a, int x)
{
    array b = array_alloc(a.size+1);
    array_blit(a, 0, b, 0, a.size);
    b.elements[a.size] = x;
    // pas de raison de faire de free ici de a, c'est
    // a l'appelant de gérer.
    return b;
}
Question 8
Écrire une fonction int array_pop(array *a) qui retire le dernier élément du
tableau a, supposé non vide, et renvoie sa valeur. Il faudra donc :
- allouer un nouveau
arraybdont le tableau contienta->size-1éléments ; - copier les anciennes valeurs sauf une ;
- récupérer dans une variable
xla valeur de la dernière case dea(parce qu'il n'est pas possible d'y accéder après l'étape suivante) ; - libérer l'ancien tableau ;
- remplacer avec
*a = b.
Corrigé
int array_pop(array *a)
{
    assert(a->size > 0); // nécessite #include <assert.h>
    array b = array_alloc(a->size-1);
    array_blit(*a, 0, b, 0, a->size-1);
    int x = a->elements[a->size-1];
    array_free(*a);
    *a = b;
    return x;
}
Remarque
Avec cette implémentation, chaque array_push et chaque array_pop recopie
tout le tableau : il coûte \(O(n)\) où \(n\) est la taille courante. Empiler \(n\)
éléments à partir d'un tableau vide coûte donc
\(O(1 + 2 + \dots + n) = O(n^2)\). C'est ce qui motive les tableaux
dynamiques de la partie suivante.
Tableaux dynamiques
Reprendre toutes les questions précédentes en changeant la structure de données
pour permettre de faire des tableaux dynamiques. Il faudra ainsi avoir deux
entiers : p_size qui contiendra la taille physique en mémoire et l_size
qui contiendra la taille logique, c'est-à-dire le nombre d'éléments
signifiants stockés.
Quand on a besoin de réallouer la mémoire, on choisira de doubler la taille
physique (en passant à une taille 1 si elle était nulle). Le pop ne libérera
jamais de taille physique.
Corrigé
#include <stdio.h>
#include <stdlib.h>
#include <assert.h>

struct array {
    int *elements;
    unsigned int p_size;
    unsigned int l_size;
};

typedef struct array array;

array array_alloc(unsigned int size)
{
    array a;
    a.elements = (int *)malloc(sizeof(int) * size);
    a.p_size = size;
    a.l_size = 0;
    return a;
}

void array_free(array a)
{
    free(a.elements);
}

array array_make(unsigned int size, int def)
{
    array a = array_alloc(size);
    for(int i = 0; i < size; i++)
    {
        a.elements[i] = def;
    }
    a.l_size = size;
    return a;
}

void array_print(array a)
{
    printf("[");
    for(int i = 0; i < a.l_size; i++)
    {
        printf("%d", a.elements[i]);
        if(i < a.l_size - 1)
            printf(",");
    }
    printf("]\n");
}

void array_blit(array src, int src_start,
            array dst, int dst_start, int len)
{
    for(int i = 0; i < len; i++)
        dst.elements[i + dst_start] =
            src.elements[i + src_start];
}

void array_push(array *a, int x)
{
    if (a->l_size < a->p_size)
    {
        a->elements[a->l_size] = x;
        a->l_size += 1;
    }
    else
    {
        // si le tableau est vide, on passe à une taille physique de 1
        array b = array_alloc(a->p_size == 0 ? 1 : 2*a->p_size);
        array_blit(*a, 0, b, 0, a->l_size);
        b.elements[a->l_size] = x;
        b.l_size = a->l_size + 1;
        array_free(*a);
        *a = b;
    }
}

int array_pop(array *a)
{
    assert(a->l_size > 0);
    a->l_size -= 1;
    return a->elements[a->l_size];
}

int main(void)
{
    array a = array_alloc(0);
    for(int i = 0; i < 10; i++)
        array_push(&a, i);
    for(int i = 0; i < 3; i++)
        printf("Pop %d\n", array_pop(&a));
    array_print(a);
    array_free(a);
}
Remarque
Un array_push qui provoque un redoublement coûte toujours \(O(n)\), mais
ces redoublements sont rares : pour \(n\) ajouts successifs à partir d'un
tableau vide, les recopies portent sur \(1 + 2 + 4 + \dots + 2^k < 2n\)
éléments (où \(2^k < n\) est la dernière taille physique pleine). Le coût
total est donc en \(O(n)\), soit \(O(1)\) amorti par ajout. C'est le même
argument que pour le redimensionnement des tables de
hachage ; la notion de complexité
amortie est développée dans le chapitre Complexité
amortie.